Command Palette
Search for a command to run...
LimiX-2:面向通用结构化数据智能的上下文机制网络
LimiX-2:面向通用结构化数据智能的上下文机制网络
摘要
我们推出了 LimiX-2,这是 LimiX 系列中的新模型,通过基于我们先前建立的扩展定律进行模型和数据扩展而开发。LimiX-2 采用上下文机制网络(CMNs)范式,并使用上下文条件掩码建模(CCMM)进行预训练。CMNs 将上下文学习(in-context learning)的组织原则从以目标为中心的预测转向以机制为导向的联合建模。它不是将网络围绕传统表格型 PFN 的 p(y | x, Dcontext) 目标来构建,而是围绕学习 p(x, y | Dcontext) 来设计,即数据生成底层联合结构的上下文相关表示。预训练使用由结构因果模型(SCMs)生成的合成数据集,这些数据集涵盖多种图结构、功能机制和观测过程。在 TabArena、TALENT 和 BCCO 上的评估表明,LimiX-2 优于当前特定于数据集的模型和表格基础模型。除了预测性能外,CMN 范式还促进了 LimiX-2 中的因果意识:其特征注意力编码了直接因果关系,能够实现准确的因果骨架恢复。
一句话总结
来自Stable AI和清华大学的研究者提出了LimiX-2,这是一个基于Contextual Mechanism Network的模型,通过Context-Conditional Masked Modeling进行预训练,将其组织原则从p(y∣x,Dcontext)转变为p(x,y∣Dcontext),利用SCM-generated合成数据进行联合建模,在TabArena、TALENT和BCCO上超越了特定数据集模型和表格基础模型,同时实现了因果骨架恢复。
核心贡献
- 提出了上下文机制网络(CMNs),这一范式将表格学习从以目标为中心的预测转变为对联合依赖结构p(x, y | D_context)的建模,并在LimiX-2中实例化该范式。LimiX-2是一个基于Transformer的表格基础模型,通过上下文条件掩码建模(CCMM)进行预训练,在单一模型中统一了监督预测、缺失值插补和因果发现。
- LimiX-2仅使用来自扩展结构因果模型(SCM)生成引擎的合成数据进行预训练,该引擎覆盖了比前代更广泛的图结构、函数机制和观测过程,使模型能够处理多样化的表格场景而无需针对特定任务更新参数。
- 在TabArena、TALENT和BCCO上的评估表明,LimiX-2优于现有特定数据集模型和表格基础模型,包括在参数规模小4倍的情况下超越TabFM;因果骨架恢复实验还表明,其特征注意力编码了直接因果关系,性能优于专用因果发现方法和基于树的特征重要性基线。
引言
结构化数据支撑着医疗、金融和科学发现等领域的预测和决策。尽管梯度提升树、深度神经网络和自动化集成方法在特定任务上表现强劲,但这些方法需要对每个数据集进行单独训练和模型选择,限制了跨任务的知识复用。现有的表格基础模型,例如基于先验数据拟合网络(PFNs)的模型,支持上下文学习,但仅限于预测单个指定目标列,这限制了它们对所有变量联合分布进行推理以及处理多样化数据推理任务的能力。
作者引入了上下文机制网络(CMNs),这是一种新范式,将建模重点从单一目标转移到变量间预测依赖的系统。通过在同一数据集上学习多个条件预测任务,CMNs显式建模联合依赖结构,并将监督预测视为更广泛推理的特例。作者在LimiX-2中实例化了这一范式,这是一个基于Transformer的表格基础模型,使用来自扩展结构因果模型(SCM)引擎的合成数据,通过上下文条件掩码建模(CCMM)进行预训练。无需针对特定任务的参数更新,单个LimiX-2模型即可支持分类、回归、缺失值插补和因果发现。在TabArena、TALENT和BCCO上的评估表明,LimiX-2优于当前表格基础模型和特定数据集模型,并且在参数规模小四倍的情况下超越了TabFM。
数据集
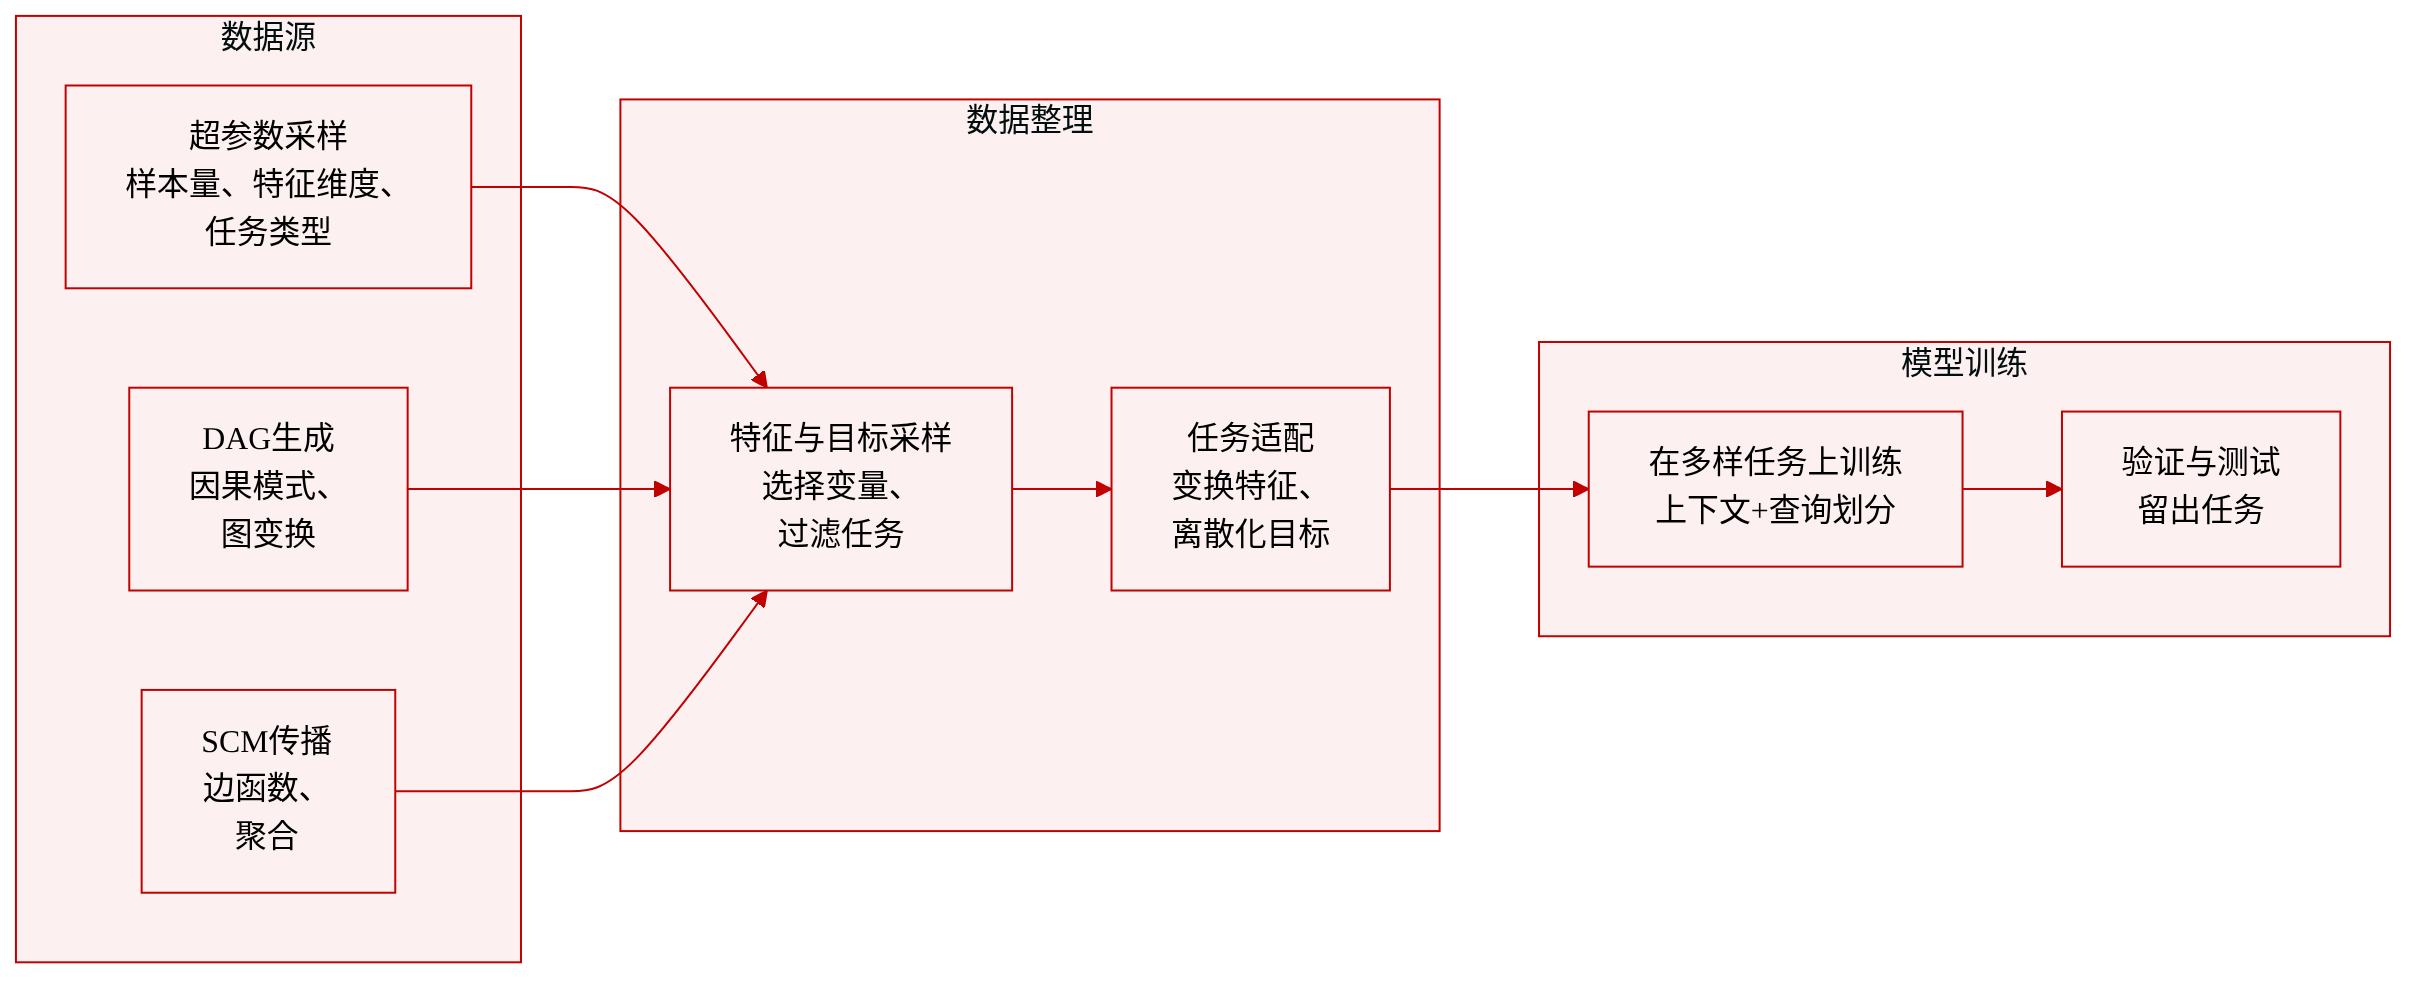
作者使用结构因果模型(SCM)框架构建大规模预训练数据。该流程包含五个阶段:超参数采样、有向无环图(DAG)生成、SCM传播、数据采样和任务适配。以下列表详细说明了数据集的构成、来源、处理方式和使用方式。
-
数据集构成与来源:数据完全为合成数据。通过在SCM流程的每个阶段变化组件来生成具有不同变量依赖、特征分布和任务属性的多样化数据集。与前代版本LimiX相比,该流程扩展了图结构、函数机制和变量观测过程的空间。
-
超参数采样:对于每个生成的数据集,作者采样全局属性,包括样本量、特征维度(分为连续特征和类别特征数量)以及任务类型(分类或回归)。此外,还随机抽取一个评估位置,将每个数据集划分为上下文部分和查询部分。每个超参数的采样分布从正态分布、均匀分布或Beta分布等分布族中随机选择。
-
DAG生成:变量间的结构依赖通过由多个局部因果结构(称为因果基序)组成的DAG表示。这些基序编码了链式、混淆和碰撞结构等有向依赖关系。DAG通过在多粒度上递归扩展这些基序构建,捕捉宏观和微观层面的依赖。在保持无环性的前提下,随机应用受拓扑约束的图变换,包括边重定向、局部路径替换和节点级结构变化,从而产生多样化的连接模式和信息传播路径。
-
SCM的函数机制:对于每个DAG,根节点值从具有随机类型和参数的分布中采样。其余节点值通过沿拓扑顺序传播函数计算得到。节点的值是映射后的父节点值、边函数、聚合函数和随机噪声的函数。作者保留了前代版本中的边函数,包括MLP、CNN和决策树,并新增了线性映射、核函数、分段函数、周期函数和乘法交互。这些基础函数可以组合以建模复杂关系。对于具有多个父节点的节点,聚合策略包括简单平均、加权聚合和神经聚合。
-
特征与目标采样:完整的SCM定义了所有变量的联合状态,但实践中只有部分子集可观测。作者将变量采样表述为多属性选择问题。每个数据集通过基于指定的子图结构和特征冗余性设计,检索变量的子集作为特征和预测目标来构建。候选任务通过多目标选择机制进行筛选,以确保它们在图结构上存在差异,并覆盖具有多样化统计特性的预测问题,从而拓宽预训练任务的覆盖范围。
-
任务适配:作者对特征和目标变量应用随机观测变换。这些变换包括线性缩放、单调非线性变换、对数变换、指数变换以及多个算子的随机组合。对于分类任务,初始连续目标通过随机离散化转换为类别目标,该过程将目标值空间随机划分为区间,并变化类别频率和离散化参数。这产生了具有不同类别数量和类别不平衡程度的分类任务。对于回归任务,目标经历随机尺度变换以及偏度和尾部行为的调整,覆盖具有多样化函数关系的连续预测任务。
-
数据使用方式:生成的数据集作为模型的预训练数据。每个数据集根据采样的评估位置划分为上下文部分和查询部分。模型在这些多样化任务上进行训练,这些任务旨在覆盖广泛的结构复杂性和统计特性。
方法
作者利用LimiX-2的单元格级设计,将每个单元格编码为独立的表示,以保留细粒度的表格结构并支持跨变量的条件推理。对于具有N行和F列的表,原始单元格xi,jR被映射到特征表示空间xi,j∈Rd,扩展嵌入维度为d=256。缺失单元格共享一个可学习的嵌入Emiss,而观测到的单元格通过带有RMSNorm和GELU的两层MLP处理。为了区分可能具有相似边缘分布的列,模型引入了判别性特征编码。每列被分配一个s维码,映射到嵌入空间,提供明确的列标识而不编码序列邻近性。
目标变量被编码为K=4个任务嵌入槽位,每个维度为d。数值回归目标使用编码器,而类别目标使用正交初始化的嵌入表。每个槽位添加一个任务类型嵌入。
模型主干由M=24个双轴Transformer块堆叠而成。与前代版本不同,LimiX-2将特征和任务表示的计算路径分离。
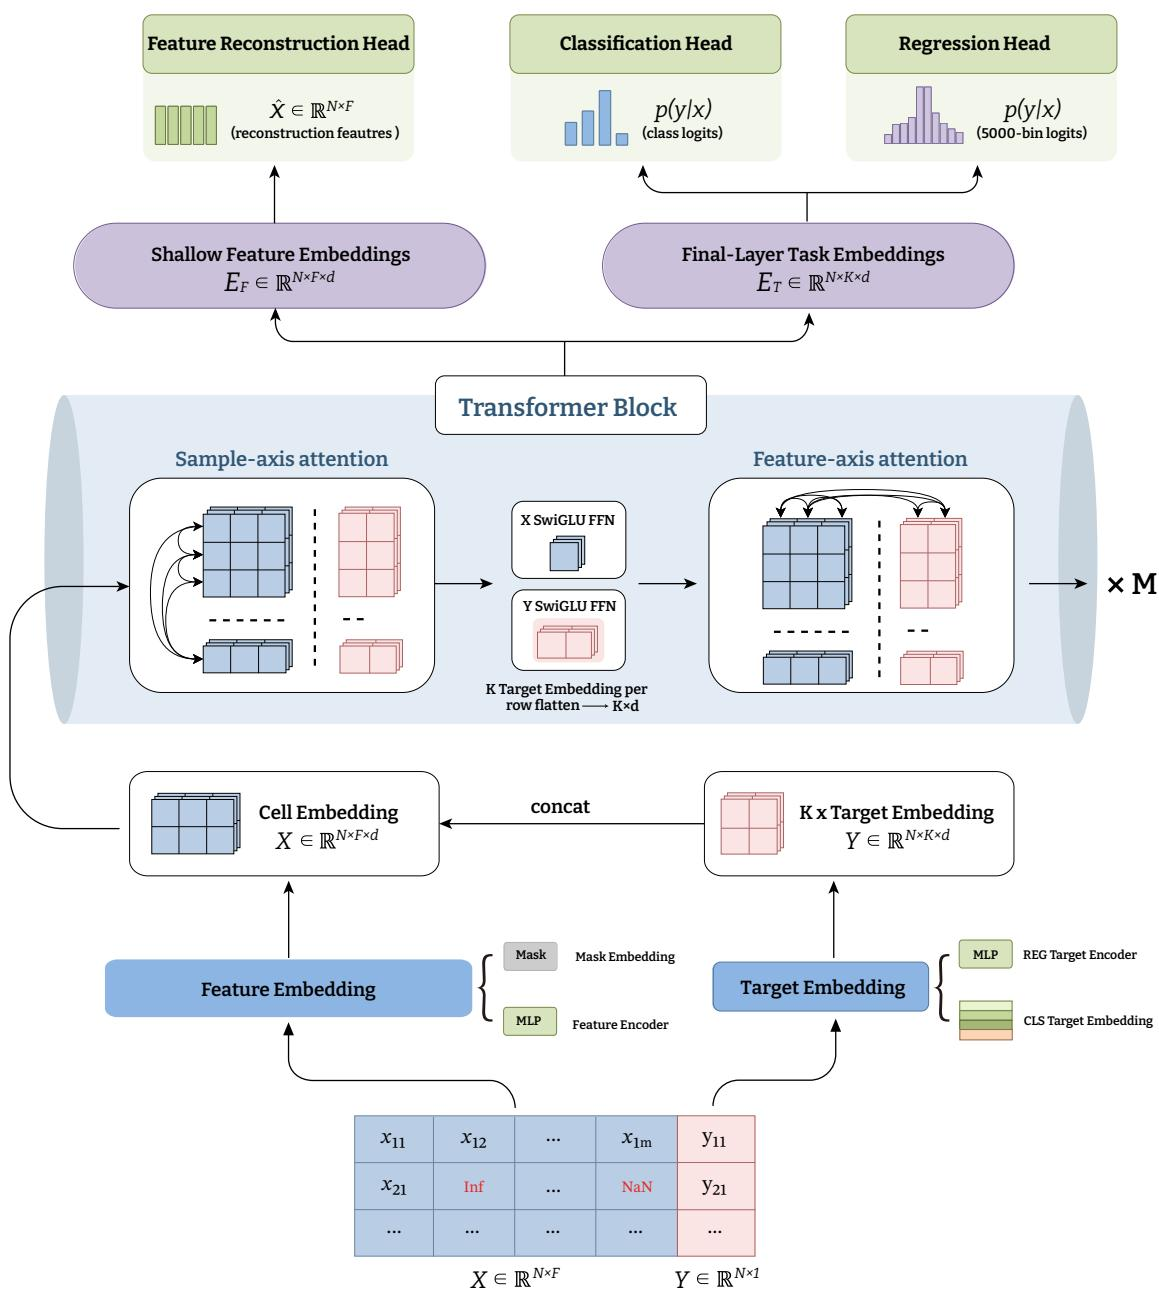
如下图所示,该架构通过不同的路径处理特征和目标嵌入。在每个块内,计算遵循特定顺序:
- 样本轴注意力:表示跨样本传播。对于目标位置,K个任务嵌入在注意力之前拼接为统一向量。上下文行相互关注,而查询行仅关注上下文行。查询、键和值映射在特征间共享,但在特征和目标之间不同。
- 独立SwiGLU:共享MLP被替换为分别针对特征和目标表示实例化的门控前馈网络。特征FFN在Rp中操作,而目标FFN在拼接后的槽位空间RKd中操作。
- 非对称特征轴注意力:特征表示同时关注其他特征和目标表示,而目标表示仅关注特征表示。这种不对称性将信息从特征导向任务读出端。
多头注意力使用所有键和值头,在计算分数之前对查询和键进行归一化。查询按头通过长度相关因子sh=(1+whlogn)βh进行缩放,以在不同上下文长度下保持稳定性。
预测头附加在不同深度。掩码特征重建利用浅层表示来捕捉局部数据细节。分类和回归任务从最终层表示解码。对于分类,头输出logits并使用交叉熵训练。对于回归,目标范围被划分为B=5000个有序箱,预测每个箱的概率以推导回归值y^=∑i=1Bpici。
作者采用上下文条件掩码建模来捕捉联合依赖结构。每个预训练回合将表划分为不相交的上下文集和查询集。模型基于观测特征和上下文数据估计掩码特征和查询目标的条件概率。为了拓宽观测模式的覆盖范围,训练结合了三种掩码方案:单个条目、查询行中的选定列以及条目块。掩码单元格被替换为共享的缺失值嵌入与列标识码的组合。
为了在多样化的变量依赖和任务属性上进行训练,作者使用结构因果模型框架构建大规模预训练数据。
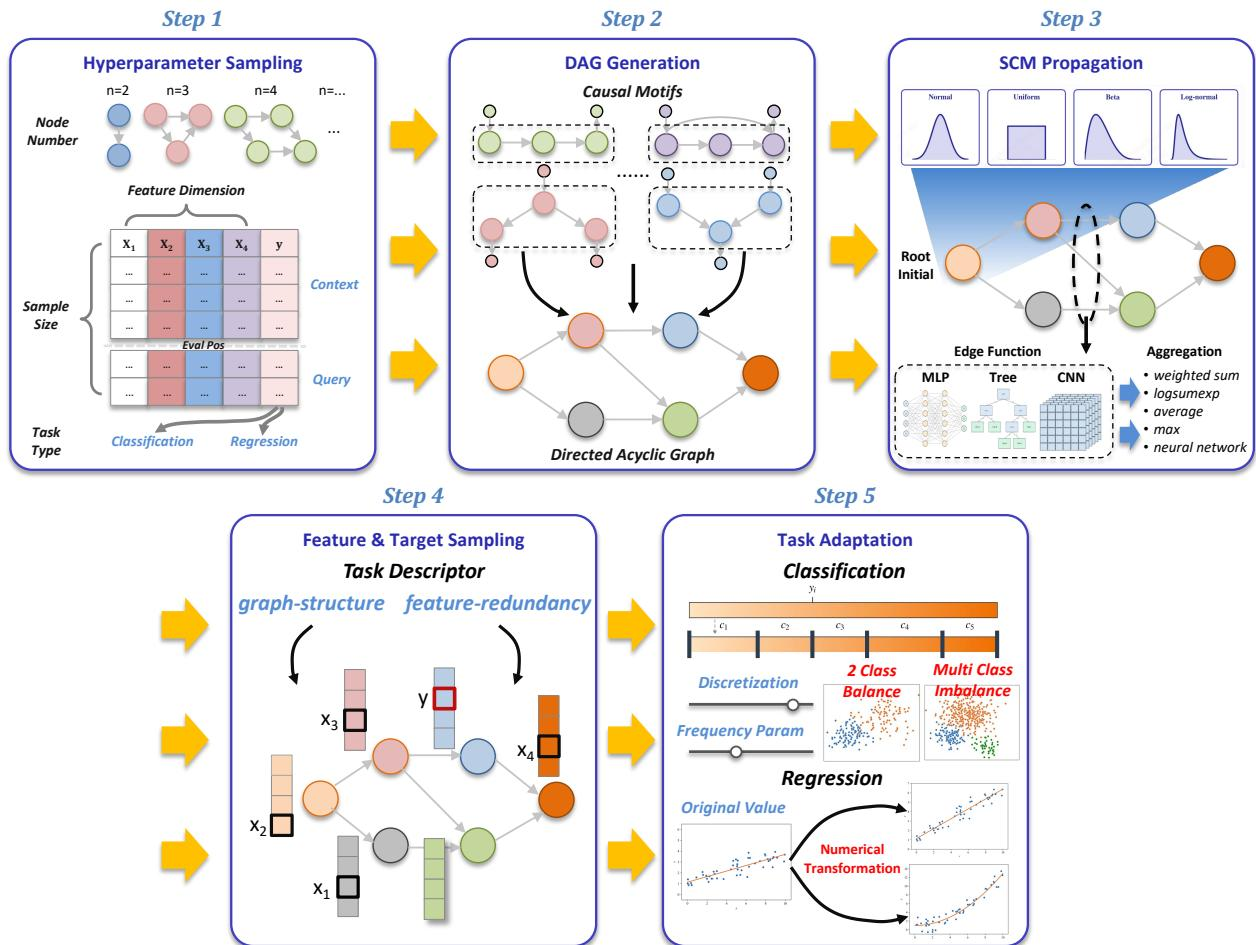
如下图所示,合成数据生成流程包含五个阶段:
- 超参数采样:从多种分布中采样全局属性,如样本量、特征维度和任务类型。
- DAG生成:使用因果基序分层生成有向无环图,以捕捉宏观和微观层面的依赖,并通过受拓扑约束的变换进行丰富。
- SCM传播:从多样化分布中采样根节点值,其余节点通过沿图拓扑传播函数机制(如MLP、CNN、决策树和核函数)计算得到。
- 特征与目标采样:多目标选择机制基于图结构和特征冗余性筛选候选任务,以确保多样化的统计特性。
- 任务适配:应用随机观测变换,如缩放和非线性映射。分类目标通过具有不同类别频率的随机离散化创建,而回归目标经历尺度和偏度调整。
实验
LimiX-2在三个公开表格基准(TabArena、TALENT和BCCO)上进行了评估,涵盖分类、回归和鲁棒性场景,在所有基线上取得了最高的Elo评分、最低的平均排名和超过50%的广泛成对胜率,包括基于树的模型、AutoML、神经网络和其他表格基础模型。在六个数据集上的因果骨架恢复评估中,LimiX-2的特征注意力取得了最高的F1分数和最低的结构汉明距离,优于专用因果发现方法和组级注意力模型,突显了单元格级表示的优势。一项包含六种模型规模(1250万到4.062亿参数)的扩展研究表明,所有评估系列中Elo改进呈对数线性关系,拟合优度R平方在0.96到0.98之间,未观察到饱和现象,支持向十亿参数模型的外推。
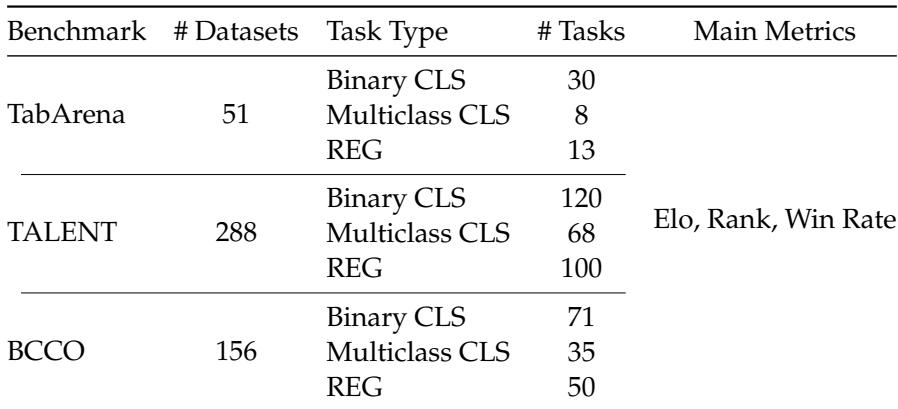
下表概述了三个表格基准TabArena、TALENT和BCCO,包括数据集数量、任务类型和主要指标,用于评估LimiX-2。TabArena侧重于实际预测性能,TALENT侧重于多样化任务泛化,BCCO侧重于不完整数据下的鲁棒性。它们共同提供了对预测性能、泛化能力、可扩展性和鲁棒性的全面评估。TabArena包含51个数据集,涵盖二分类、多分类和回归,使用Elo、排名和胜率进行评估。TALENT在排除12个超过10个目标类别的数据集后包含288个数据集,涵盖二分类、多分类和回归。BCCO提供156个数据集,侧重于鲁棒性,包括106个分类和50个回归任务,处理缺失和不完整特征。
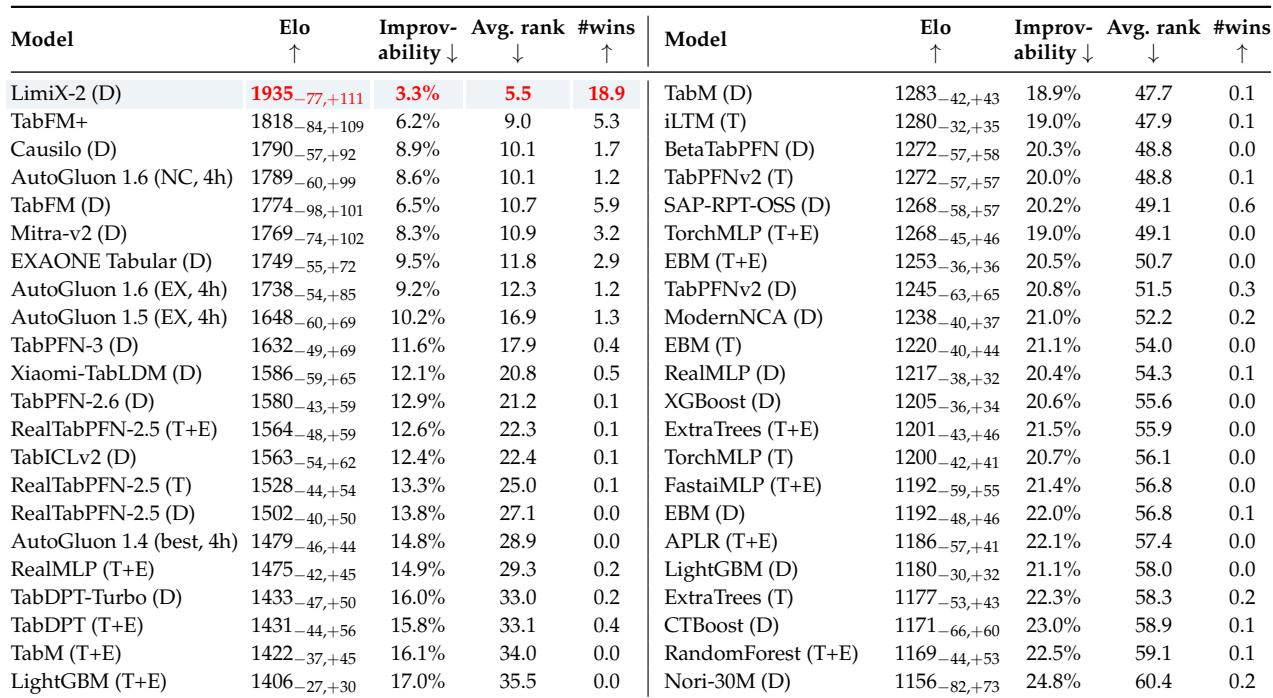
LimiX-2在TabArena基准的所有指标上均取得最高排名,在Elo评分上大幅领先第二名TabFM+。其还显示出更低的改进空间、更好的平均排名和更高的总胜场数,表明在所有对比方法中具有一致性优势。LimiX-2拥有最高Elo评分,超过第二名100多分。LimiX-2的改进空间约为TabFM+的一半,表明性能更稳定。LimiX-2的总胜场数约为TabFM+的3.6倍。TabM、iLTM和其他基线在Elo和胜场数上远远落后。
LimiX-2在TabArena分类任务上优于所有基线,在Elo、改进空间、平均排名和胜场数上均领先。该模型的改进空间显著低于TabFM+,表明性能更稳定,并且取得了显著更好的平均排名和总胜场数。LimiX-2取得最高Elo,超过TabFM+ 100多分。LimiX-2的改进空间得分(4.3%)远低于TabFM+(7.5%),表明性能更一致。LimiX-2的平均排名(6.0)优于所有其他模型,总胜场数(10.6)也更高,而TabFM+分别为9.9和4.7。
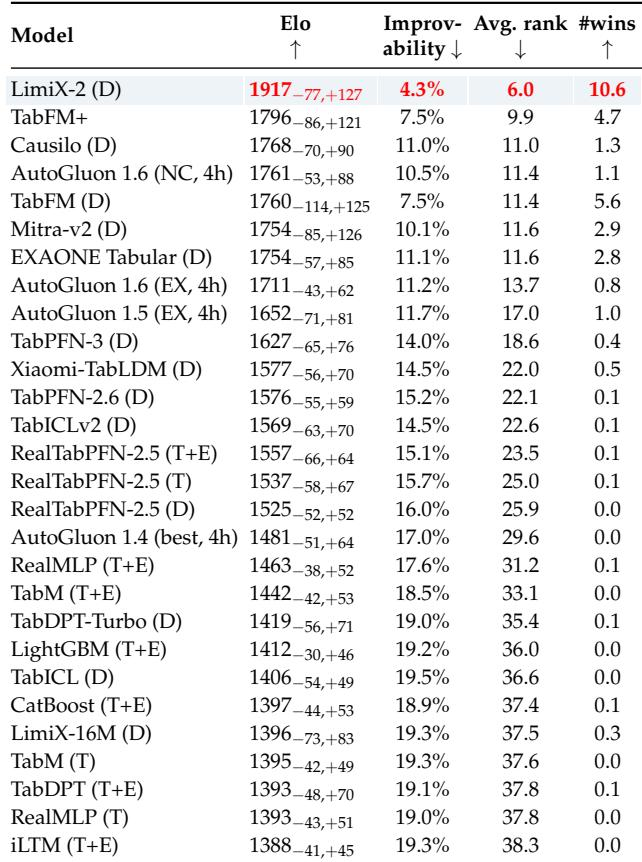
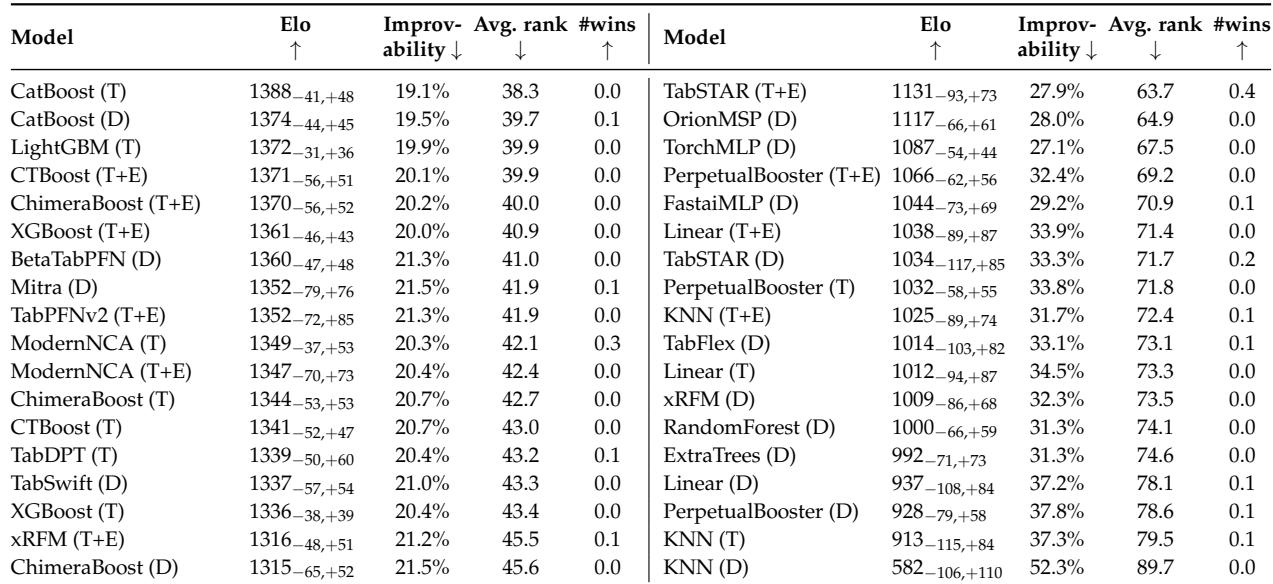
LimiX-2在TabArena基准的所有预测指标上均取得最高排名,包括在对比方法中最高的Elo评分和最低的改进空间。在分类任务上也表现出强劲的聚合性能,具有较高的平均成对胜率和最佳平均排名。这些结果突显了其在传统提升模型和其他表格基础模型上的持续优势。LimiX-2在分类任务上以1917分的Elo领先,明显超过第二名。该模型在分类数据集上取得最低的改进空间(4.3%)和最佳平均排名(6.0)。LimiX-2记录的平均成对胜率为94.5%,表明在几乎所有对比中都能获胜或打平。CatBoost和LightGBM等传统基线明显落后,Elo评分约为1370-1390,且改进空间值更高。
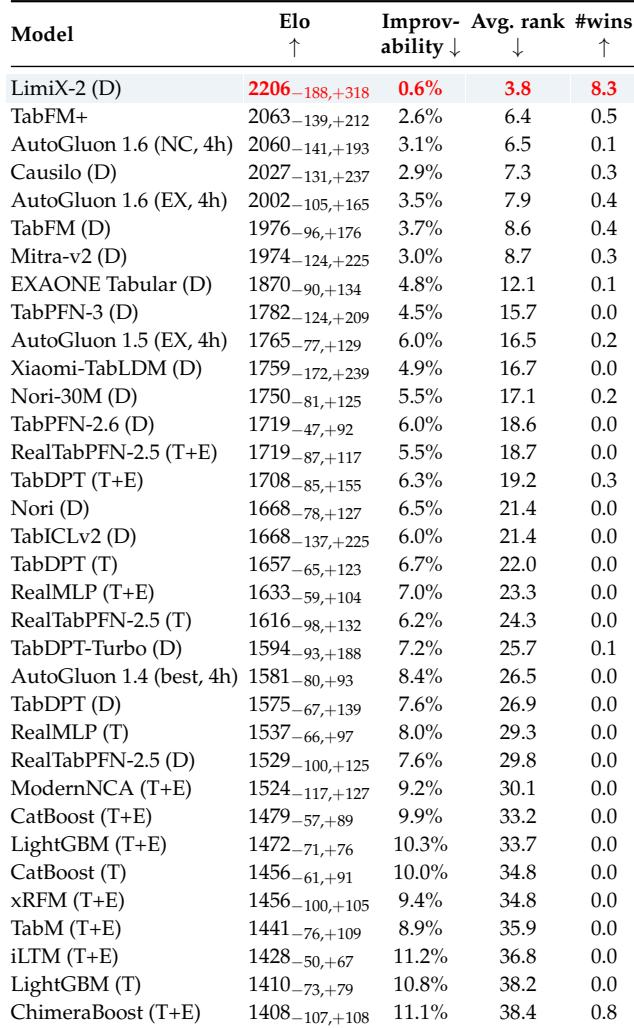
LimiX-2在TabArena回归任务上优于所有基线,取得最高Elo、最低改进空间、最佳平均排名和最多胜场数。其改进幅度尤其超过TabFM+和AutoGluon 1.6(非商业版,4小时),同时也显著超越其他变体和模型。LimiX-2在所有四项报告指标上均排名第一,Elo为2206,远超次优方法。与TabFM+和AutoGluon 1.6(非商业版,4小时)相比,LimiX-2的改进空间(0.6%)低得多,平均排名(3.8)也更好。LimiX-2记录了8.3次总胜场数,远超所有基线(最多0.5次)。在基线中,TabFM+和AutoGluon 1.6(非商业版,4小时)是最接近的竞争者,但两者在Elo上都落后LimiX-2超过140分。
评估涵盖三个表格基准:TabArena用于预测任务,TALENT用于泛化能力,BCCO用于不完整数据下的鲁棒性。在所有设置中,LimiX-2均持续优于基线,在Elo、胜率、平均排名和稳定性(更低的改进空间)方面领先,在回归任务上优势尤为明显,在分类任务上具有较高的成对胜率。结果确认了LimiX-2相对于传统提升模型和其他表格基础模型的优越性。