Command Palette
Search for a command to run...
基础模型时代的人工智能在游戏中的应用
基础模型时代的人工智能在游戏中的应用
Meng Luo Yanlin Li Hao Li Hongzhan Lin Pengfei Zhou Tianjie Ju Ran Zhang Yeying Jin Mong-Li Lee Wynne Hsu
摘要
基础模型,连同学习型游戏世界模型的快速进展,正在重塑人工智能在游戏生命周期中的使用方式。除了玩游戏之外,最新的系统还能对玩家和游戏动态进行建模,支持设计与开发,在运行时调整面向玩家的体验,并评估由此产生的产物。然而,这些方向在很大程度上是作为独立的研究线索发展的,这使得区分哪些能力可以跨场景转移,哪些仍然局限于特定游戏、引擎、界面或玩家群体变得困难。我们将文献按AI输出的直接用途分为六个角色:AI进行游戏与动作、AI对玩家与游戏建模、AI设计游戏、AI构建与维护游戏、AI在运行时生成与调整、以及AI测试与评估游戏。对于每个角色,我们考察游戏或工作流程提供了什么结构,AI学习、生成、预测或修正了什么;哪些能力能够转移,哪些产物可以跨场景和角色重用;以及哪些主张得到了现有证据的支持。我们进一步识别了具体的跨角色连接:轨迹可以训练世界模型,学习到的环境可以为智能体提供经验,设计规格可以驱动可执行的实现,游戏或测试中的反馈可以指导修订。然而,在这些连接中,控制方案、规则、引擎接口、状态表示和玩家上下文往往仍具有特定场景性,因此下游能力的主张需要在目标场景中进行验证。对于受限的游戏玩法和选定的学习环境,评估最为标准化且基于执行,而在学习世界中的持久状态、重复软件修订、验证过的玩家建模、持续的运行时调整以及有代表性的自动化测试仍不太成熟。总之,这些发现指向了游戏中AI的一个核心挑战:实现输出和能力在角色间的重用或转移,同时在其最终使用的特定游戏结构、界面和玩家上下文中重新建立其有效性的证据。
一句话总结
来自新加坡国立大学和南洋理工大学的研究者对基础模型时代的游戏人工智能进行了综述,将相关文献按六个角色进行组织,涵盖从游戏对局到游戏测试的各个层面。他们认为核心挑战在于如何跨角色复用或迁移能力,而无需在最终部署场景中的特定游戏结构、接口和玩家情境中重新验证这些能力。
核心贡献
- 提出了一种分类体系,根据人工智能输出的直接用途,将基础模型在游戏中的研究划分为六个角色,从对局与行动的人工智能,到测试与评估游戏的人工智能。
- 梳理了跨角色的关联,例如交互轨迹训练世界模型、设计规格驱动可执行实现,同时指出控制方案、引擎接口和玩家情境仍具有场景特定性,需要在目标环境中进行验证。
- 综合证据表明,评估在受限游戏对局和选定的学习环境中最为标准化,而在学习世界的持久状态、反复的软件修订、持续的运行时适应以及具有代表性的自动化测试方面,其成熟度相对较低。
引言
游戏人工智能已超越单纯的对局范畴。近期如GPT-6 Astra等模型已被用于陌生的交互环境(如ARC-AGI-3),也被集成到Playbot等开发工具中用于创建可玩原型,使同一个预训练模型在游戏生命周期的不同角色中发挥作用。以往的游戏对局、程序化生成和玩家建模研究大多在相互独立的研究社区中开展,在设计、实现和评估游戏等任务之间的关联有限。作者的主要贡献是一篇综述,将游戏人工智能组织为六个角色,通过角色间传递的输出来建立关联,并分析基础模型凭借其语言、多模态和工具接口如何重塑这些角色。他们特别考察了三个反复出现的发现:广泛的预训练扩展了接口,但并未消除游戏特定的结构;游戏对局日益提供超出最终得分的数据和反馈;进展具有任务依赖性,在受限对局方面有更强的基准,而在持续创作、适应或人类体验方面则较弱。
数据集
数据集描述:玩家建模与交互式生成
作者利用了广泛的数据集来支持玩家建模、动作接口和长时程生成。这些数据集在来源、规模和标注方式上各不相同,其使用方式取决于目标是行为推断、情感预测还是训练交互式视频生成器。
1. 行为与玩家建模数据
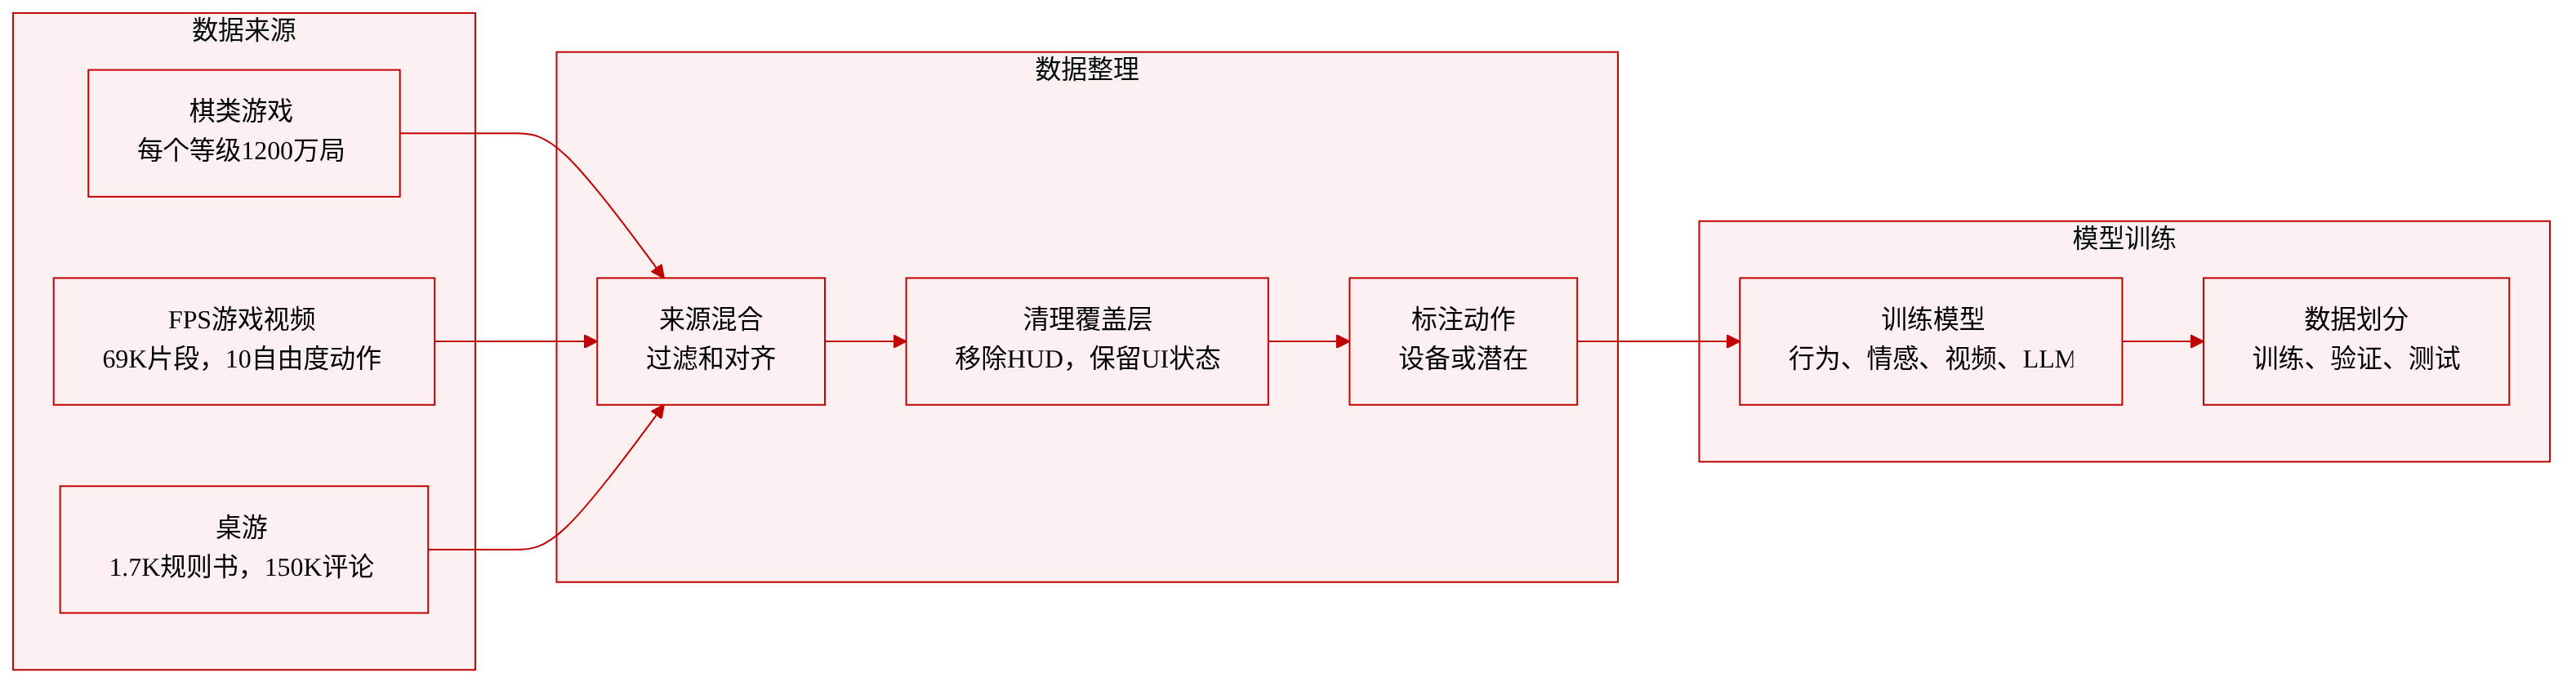
- 国际象棋走子数据集: Maia系列模型使用每个等级分区间1200万盘在线对局来建模不同水平玩家的类人走子。Maia-2在共享模型上以玩家技能为条件,而Maia-3使用棋盘方格token。在个体适应方面,Maia4All学习玩家原型,并仅从每位玩家约800个局面(约20盘对局) 中适应嵌入表示,在这种低数据情境下,留出走子准确率从51.4%(Maia-2)提升到53.2%。
- 大逃杀行为特征: 从超过75,000场对局中工程化提取,这些特征在预测玩家段位方面优于三种主流评级系统。
- 互动小说框架: “Learning to Play Like Humans”框架通过结构化地图构建和反馈驱动的经验分析来引导语言模型完成互动小说,使行为与叙事意图而非任务得分对齐。
2. 情感与体验数据集
- AGAIN数据集: 包含来自九款游戏的超过1,100个游戏内视频,由124名参与者以连续、第一人称的方式对游戏过程数据进行唤醒度标注,总计超过37小时的标注游戏过程。
- 用于情感预测的游戏视频: 一个生存射击游戏数据集使用50个视频进行留一视频交叉验证,高/低唤醒度分类平均准确率超过78%,最佳准确率达98%。商业作品《汤姆克兰西:全境封锁2》提供来自25名玩家的近20小时标注游戏过程,将游戏画面与手柄操作融合,用于预测长期参与度(平均最高72%,最佳准确率88%)。《愤怒的小鸟》用于从Let's Play视频中进行无标签情感近似。
- 基础模型情感研究: 一项针对九款第一人称射击游戏、六种提示策略下三个视觉语言模型的研究发现,零样本参与度预测总体较弱,往往无法超越按游戏划分的多数类基线。
3. 主观判断与游戏测试数据
- MeepleLM: 在1,727本修正规则书和150,000条桌游评论上训练,用于模拟不同玩家群体的体验和批评意见。
- 判断预测研究: Collins等人使用121款新颖策略游戏,将模型评估与来自超过450名参与者的期望收益和趣味性判断进行比较。模型与博弈论估计及人类判断的一致性呈非单调变化,表明更强的最优对局推理本身并不能产生更忠实的人类判断模型。
- Beyond Playtesting: 通过监督微调和强化学习,在大型真实玩家行为数据上使语言模型适应大型多人在线游戏,离线模拟能够再现玩家推理和对干预的反应。
4. 交互式视频生成数据
- 动作条件数据集:
- SCOPE: 在来自七款第一人称射击游戏的69,000个片段上训练,并配有对齐的10自由度控制,将局部空间动作(射击)与全局相机和移动信号分离。
- Game2World Engine: 引入了抬头显示器元素的去除流水线,以及96,000对合成视频和来自303款游戏的1,079个真实场景片段。在无界面游戏画面上训练,相较带界面叠加画面,VideoReward整体相对提升6.83%。
- H3-World: 使用7,872个训练片段和128个留出片段,配有结构化角色和相机指令,在保持初始观察和生成条件固定的情况下,通过动作干预测试语言条件控制。
- 潜在动作数据集: Genie从普通视频中推断帧间的离散动作,无需真实控制信号。ShadowDancer从保持运动而改变外观的成对渲染中学习动作潜在表示。
- 实体与语言控制: Incantation在五个留出实体-动作对上报告89%的动作控制准确率(动作索引基线为43%),在四个词表外探针上为90%(基线为0%)。ReactiveGWM测试了策略模块在两款格斗游戏之间的迁移。
- 长时程与服务研究: Yume-1.5将压缩历史与线性注意力相结合,配合蒸馏流式生成,并增加文本事件控制。AlayaRenderer-Flash使用物理引擎和四步流式模型,在单张H200上报告31.54 fps,在微调后支持SuperTuxKart实时运行达30 fps。
5. 裁剪、过滤与预处理
- 抬头显示器移除: Game2World Engine应用专用移除流水线去除游戏视频中的覆盖层,将场景动态与游戏特定的显示惯例相分离。作者认为血量、弹药和计时器可能是关键状态观测,建议在需要时将其作为独立通道保留。
- 视觉漂移缓解: CausVid将双向扩散Transformer蒸馏为因果少步生成器,用教师模型监督因果学生模型以减少误差累积。Self Forcing在模型自身的 rollout 上进行训练并配合键值缓存,对整个序列施加视频级损失。FramePack加入了漂移预防方法,包括早期确定端点以及调整采样顺序。
6. 模型训练与评估中的数据使用
- 训练划分: Maia按等级分区间使用独立模型,通过留出局面防止记忆化,通过留出玩家测试群体模型,通过同一玩家的后续对局测试个体表征的有用性。三种划分即使都以走子准确率评分,回答的问题也各不相同。
- 混合比例与适应: Beyond Asking从观测行为中推断用户画像,测试受控合成特征的恢复,并包含一个探索性的12人试点研究。三消部署使用语言模型推理来分配粗略玩家类型,并评估由此产生的个性化关卡。
- 验证策略: 作者强调区分观测、推断构念和干预结果。对于从交互中推断出的模型,在部署前需测量校准和时间稳定性,同时通过随机内容对比来评估下游收益。这可以防止将关卡完成率的提升视为所有中间画像都准确的证明。
- 长rollout评估: MultiGen生成同步的多视角输出并配以可编辑的外部地图,但其多人评估在单张地图上使用模拟Doom死亡竞赛。MASS将学习到的全局状态转移模型与逐相机渲染分离,在多人Snake中同时评估状态准确率和视角间一致性。
方法
作者提出了一个将人工智能集成到游戏开发和交互生命周期中的综合框架,分为四个主要角色:对局与行动、玩家与游戏建模、游戏构建与维护、以及运行时内容生成与适应。
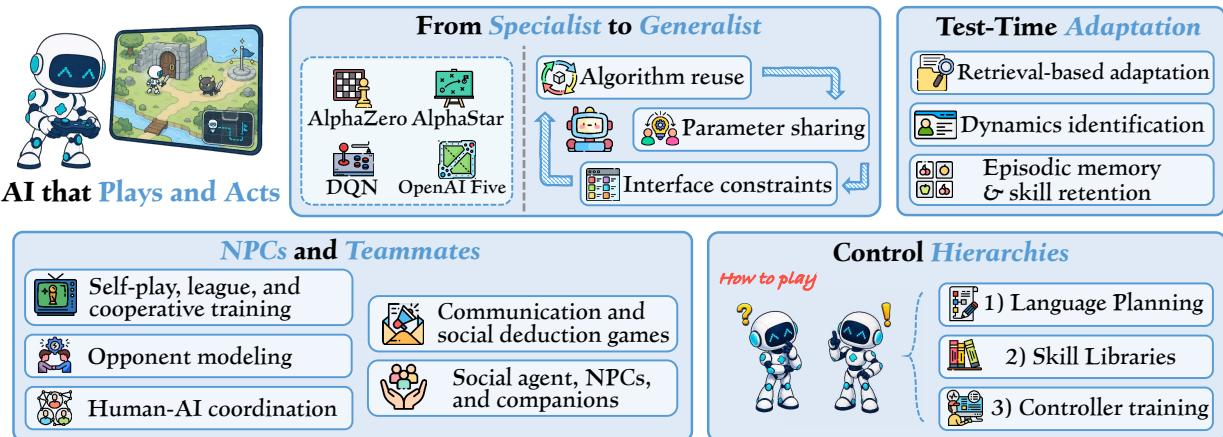
对于对局与行动型智能体,其架构通过算法复用、参数共享和接口约束,从专用策略系统过渡到通用系统。如下图所示,该系统采用控制层级结构,其中语言规划器负责高层推理,技能库提供可复用行为,控制器训练负责低层运动执行。测试时适应通过基于检索的方法、动力学识别和情景记忆保留来实现,以应对不熟悉的游戏机制和布局。
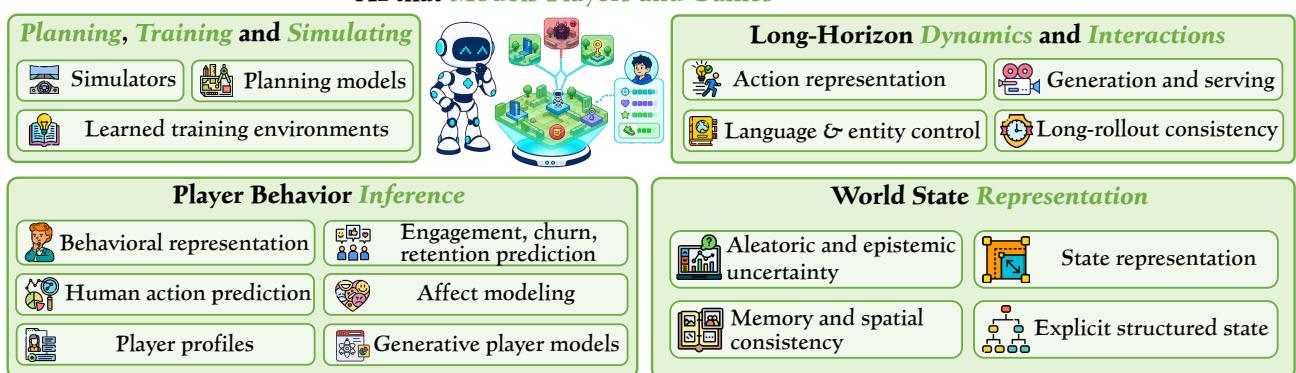
在玩家与游戏建模方面,该框架将规划、训练和模拟与世界状态表示及玩家行为推断相分离。学习到的动力学支持规划模型和训练环境,而长时程交互需要稳健的动作表示和生成服务。世界状态表示将偶然不确定性和认知不确定性估计与记忆和空间一致性相结合,同时辅以显式结构化状态来追踪数值变量和游戏机制。玩家行为推断利用行为表示学习、人类动作预测和情感建模来估计参与度、流失率和留存率。
在游戏构建与维护领域,作者描述了一条流水线,其中使用工具的开发智能体协调多智能体协作,以集成代码、场景和引擎组件。这些智能体利用仓库访问、编辑器状态和运行时反馈来执行和调试项目。维护阶段侧重于回归避免和更新感知测试,以确保新功能不破坏现有功能,促进开发者交接和长期项目演进。
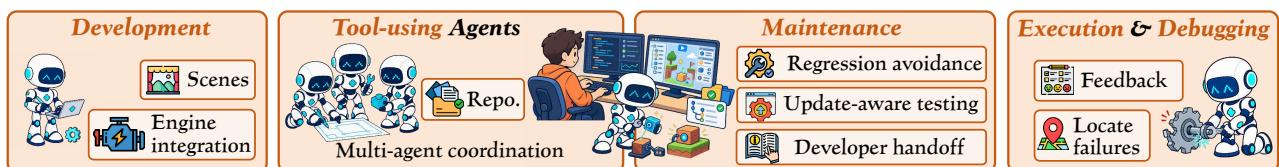
最后,在运行时生成与适应方面,系统管理对话、道具和任务等生成内容,同时维护长期角色记忆和状态-呈现一致性。动态规则和机制通过生成的代码和受限规则语言实现,并由引擎侧检查验证。个性化由情感和模型驱动的适应、难度调整和自适应角色来驱动,以定制契合个体玩家的交互体验。
实验
实验涵盖多个角色,包括多智能体协调与社会交互、玩家行为建模、游戏生成与修复、运行时个性化以及自动化测试。关键发现显示,执行反馈有助于修复,项目规模会显著降低运行时成功率,而结构化中间表示可以在牺牲运行时性能的情况下改善机制遵循度。反应式适应研究结果在玩家层面喜忧参半,效果取决于集成选择和响应时机;结合探索与多样化预言机的测试器能发现更多缺陷,但多样性并不等同于对真实玩家行为的代表性。跨角色的评估始终区分部分进展与任务完成,将模型能力与框架配置相分离,并提醒预言机一致或收敛并不构成独立验证。
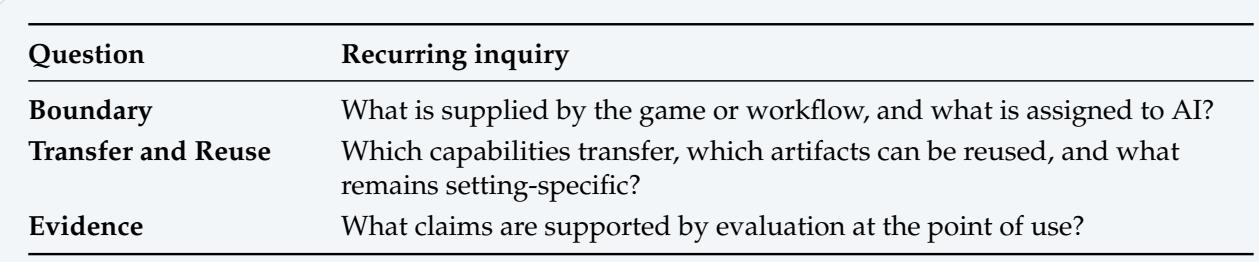
跨角色的分析聚焦于三个反复出现的议题:游戏/工作流与人工智能之间的边界设定、能力与产物的迁移和复用,以及在应用点上支撑主张的证据。评估不仅要考虑初始成功,还要考虑对规则、需求和玩家情境变化的稳健性,包括多人公平性和系统更新。边界问题询问哪些由游戏或工作流提供,哪些由人工智能承担,证据必须立足于应用点。迁移和复用取决于哪些能力和产物具有通用性,而某些要素仍具有场景特定性。自动化测试面临与状态覆盖、预言机准确率和采样代表性相关的局限,可以通过组合互补的探索策略和独立预言机来解决。使用模型评判者进行评估存在自我偏好和走捷径的风险,因此需要重复或更换评判者之外的独立验证。端到端评估应报告计算量和延迟,并测试失败更新后的回滚或降级,以及与共享多人状态的兼容性。
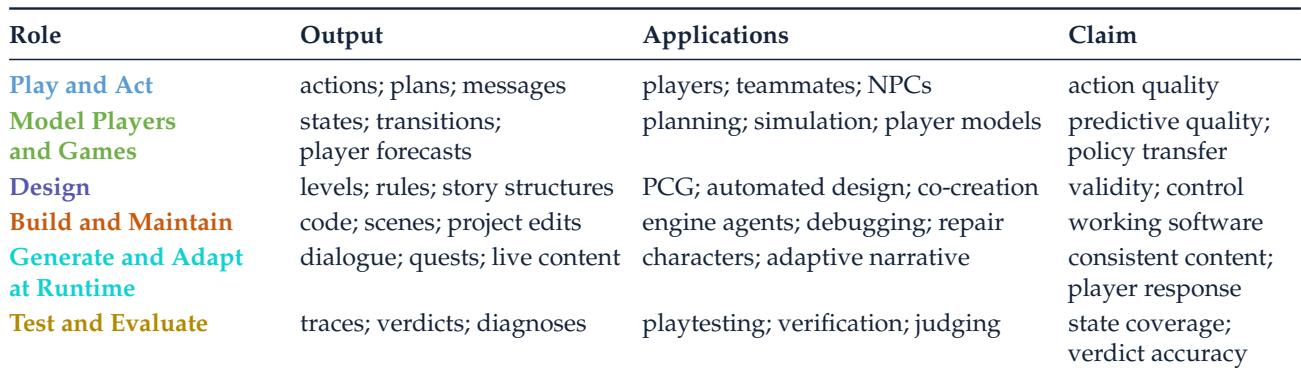
该表将人工智能游戏系统组织为六个角色,每个角色由其输出、应用和一项主要实证主张来定义。这些角色涵盖对局、建模、设计、构建、运行时内容生成和测试,重点关注预训练和多模态模型如何扩展这些任务。对局与行动角色为玩家、队友或NPC产生动作、计划和消息,其主张围绕动作质量展开。玩家与游戏建模输出状态、转移和玩家预测,应用于规划和模拟,其主张涉及预测质量和策略迁移。设计为程序化生成和共同创作生成关卡、规则和故事结构,其主张涉及有效性和可控性。构建与维护为引擎智能体和调试产生代码、场景和项目编辑,其主张是可工作的软件。运行时生成与适应输出对话、任务和实时内容,服务于角色和自适应叙事,其主张涉及内容一致性和玩家反应。测试与评估提供轨迹、判定和诊断,用于游戏测试和验证,其主张涉及状态覆盖和判定准确性。
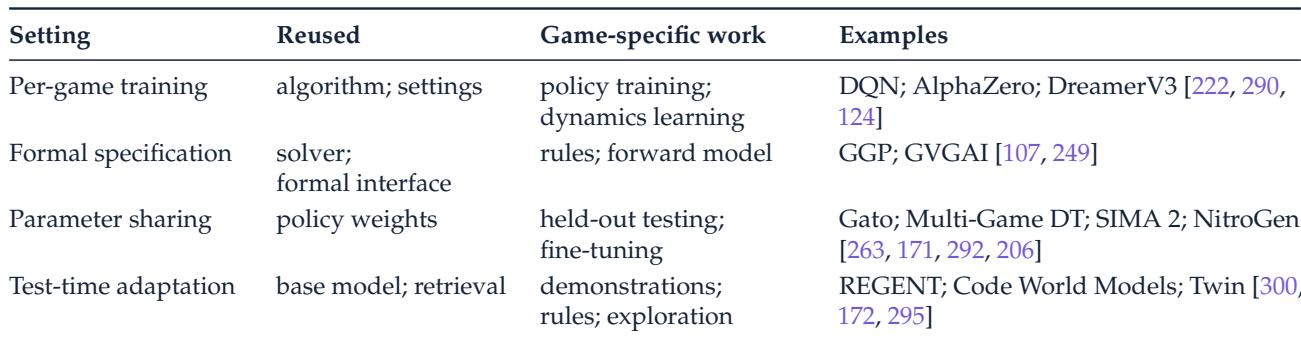
该表按哪些内容在任务间复用、哪些内容为游戏特定来组织游戏智能体训练方法,并附有各分类的示例。它区分了逐游戏训练、形式规格复用、参数共享和测试时适应,强调了每种设置所支持的不同泛化主张。逐游戏训练复用算法和设置,但需要针对特定游戏的策略训练和动力学学习,如DQN和AlphaZero所示。形式规格方法复用求解器和接口,同时保持游戏规则和前向模型的独特性,如通用游戏对局。参数共享复用策略权重并在留出游戏上测试,如Gato和多游戏决策Transformer。测试时适应复用基础模型和检索机制,配合游戏特定的演示和探索,如REGENT和Code World Models。
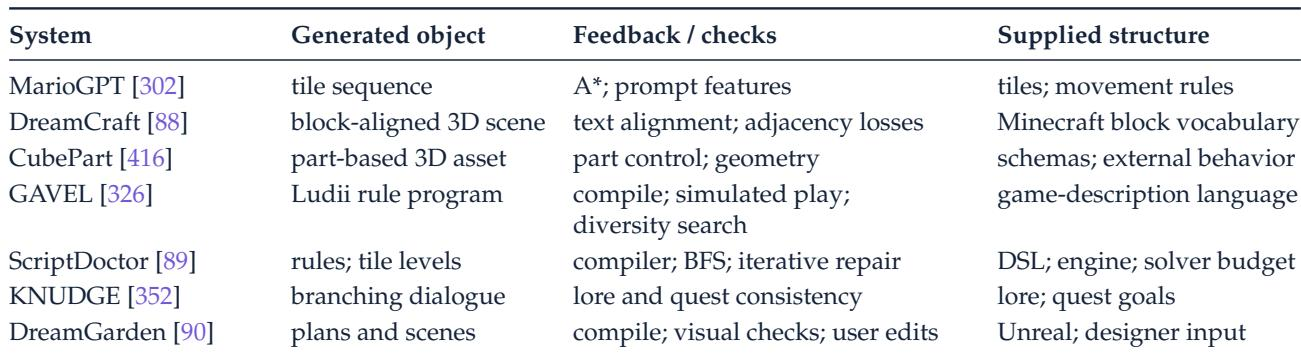
该表比较了七种设计方法在生成对象类型、所用反馈或检查以及提供给生成器的游戏结构方面的差异。这些方法涵盖从生成瓦片序列或3D场景到规则程序、对话和计划,其监督机制包括编译器、模拟对局和迭代修复。这些区别展示了不同方法如何将有效性约束和设计者控制嵌入生成过程。MarioGPT和DreamCraft都生成基于瓦片的内容,但反馈方式不同:MarioGPT使用A*检查和提示特征,而DreamCraft依赖文本对齐和邻接损失。GAVEL和ScriptDoctor都生成游戏逻辑,但GAVEL使用编译和模拟对局,而ScriptDoctor增加了带BFS求解器的迭代修复。KNUDGE专注于分支对话,带有背景故事和任务一致性检查,与结构生成方法形成对比。DreamGarden将编译的视觉检查与用户编辑相结合,突出了人在回路中的验证。
该表提供了跨游戏六个人工智能角色解读评估结果的指南,阐明了每个角色的目标所衡量的内容以及解读应在何处停止。它强调在一个情境或指标上的成功并不意味着在另一个情境中的有效性,例如短期保真度不能保证持久性,覆盖度也不等同于正确性。对于对局与行动,评估结果是协议特定的,跨规则、控制或时机的迁移未经测试。玩家建模方面,短时程保真度不能确立持久性,合成特征不能确认真实玩家的有效性。设计评估不能确立创作效率或预期玩家体验。构建与维护结果不能确保长期维护或顺畅的开发者交接。运行时适应证据仅限于单会话,适应效果需要适当的控制条件。对于测试与评估,覆盖度不等于正确性,采样行为也不能代表完整总体。
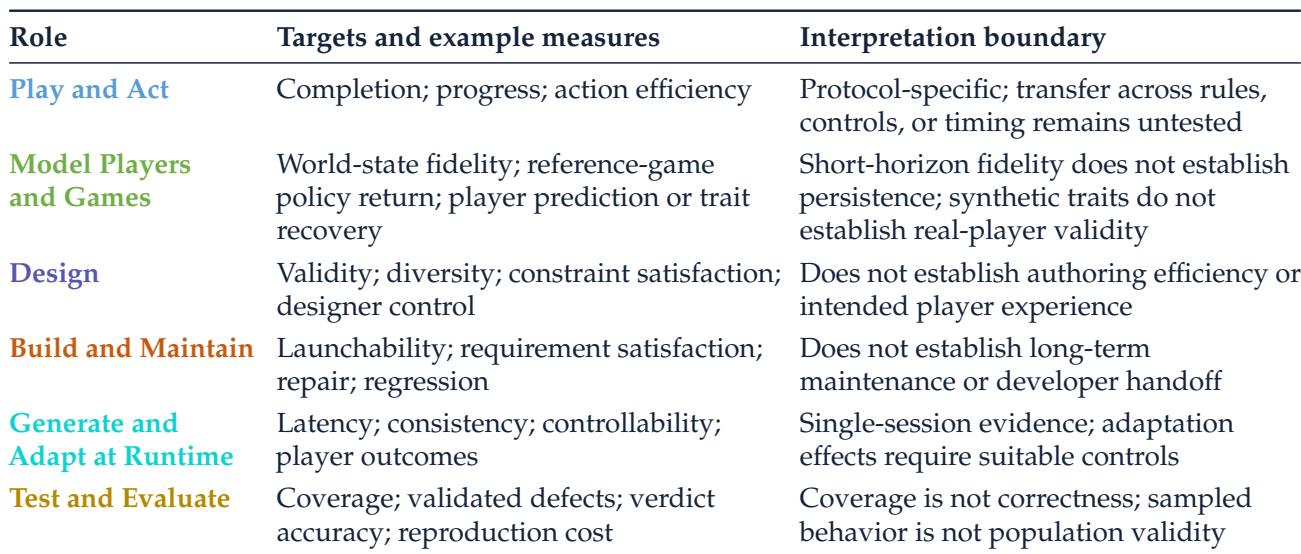
评估框架回应了关于人工智能-游戏边界、能力迁移和证据扎根的反复出现的议题,强调对规则变化、多人动态和系统更新的稳健性。六个人工智能角色(对局、建模、设计、构建、运行时内容生成和测试)各自承载不同的主张,但结果均为协议特定,未经额外验证不能跨情境泛化。训练方法从逐游戏训练到参数共享和测试时适应各不相同,对复用有不同的主张。设计方法通过编译器、模拟对局或迭代修复来嵌入有效性约束,然而一个指标上的成功并不能确认另一指标上的有效性,例如覆盖度不等同于正确性,短期保真度不能确保持久性。