Command Palette
Search for a command to run...
StepAudio 3 音乐技术报告
StepAudio 3 音乐技术报告
摘要
我们推出了 StepAudio 3 Music,这是一个大规模、长格式的音乐生成模型,支持显式音乐规划和开放域文本控制生成。StepAudio Music Tokenizer 将音频表示为来自 65536 项单码本的 50 Hz 流,利用语义感知的自监督和多任务训练来保持音乐结构和重构相关信息。一个流匹配扩散 Transformer(DiT)预测连续的 StepAudio VAE 潜在变量,我们的 VAE 解码器将其转换为 48 kHz 音频。这种离散-连续设计通过与单码本 VQ、语义和声学 RVQ 以及不同 DiT 配置的比较加以指导。对于显式规划,一个混合专家自回归模型使用 ABC 记谱法在预测音乐标记之前生成中间编排计划(ABC-CoT),使和声、节奏和旋律结构成为生成上下文的一部分。通过渐进式训练课程和监督微调,支持歌曲和器乐生成、从干声人声生成伴奏,以及长达 5 分 30 秒的翻唱歌曲合成。利用直接偏好优化(DPO)进行强化学习,最终模型在评估系统中获得了最高的 AudioBox 内容享受度、内容有用性和制作质量分数,以及最高的 MuQ-MuLan 相似度,并在 SongBench 上取得了有竞争力的成绩。在初步的 Artificial Analysis Music Arena Vocals 排行榜上,其质量 Elo 为 1105,仅次于 Suno V5.5 和 Mureka,领先于 Suno V5、MiniMax 模型及其他系统。音频演示可在 https://stepaudiollm.github.io/step-audio-3-music 获取。
一句话总结
StepFun、ACE、香港中文大学和加州大学圣迭戈分校联合推出 StepAudio 3 Music,这是一个大规模长篇幅音乐生成模型,融合了 50Hz、65536 词表大小的单码本 tokenizer,并结合语义信息驱动的自监督与多任务训练;其流匹配扩散 Transformer 预测连续 VAE 潜变量并解码为 48kHz 音频;同时采用基于 ABC 记谱法进行显式规划的专家混合自回归模型(ABC-CoT)。通过 DPO 优化,该模型在 AudioBox Content Enjoyment、Content Usefulness 和 Production Quality 上取得最高得分,并在 MuQ-MuLan 相似度上领先所有被评估系统,同时在 Music Arena Vocals 初步排行榜上取得 1105 的 Quality Elo。
核心贡献
- 提出 StepAudio 3 Music,一个大规模音乐生成模型,结合 50Hz、65536 词表大小的单码本 tokenizer、用于连续潜变量预测的流匹配扩散 Transformer,以及用于 48kHz 音频渲染的 VAE 解码器;tokenizer 的设计基于对单码本 VQ 与 Semantic/Acoustic RVQ 的受控比较实验。
- 通过 ABC-CoT 实现显式音乐规划,即由专家混合自回归模型在预测音乐 token 之前先生成可读的 ABC 记谱法中间编排方案,并通过 music-to-ABC 与 ABC-to-music 训练将符号规划与声学输出相连接,支持文本、记谱法和参考条件控制。
- 在渐进式课程训练、监督微调和直接偏好优化之后,该模型在 AudioBox Content Enjoyment、Content Usefulness 和 Production Quality 上取得最高分,在 MuQ-MuLan 相似度上领先所有被评估系统,在 SongBench 上取得有竞争力的结果,并在 Artificial Analysis Music Arena Vocals 排行榜上以 1105 的 Quality Elo 排名第三,仅次于 Suno V5.5 和 Mureka。
引言
近期音乐生成的进展使模型能够生成长时长的优质音频,扩散和流匹配方法能够处理复杂的声学分布,扩散 Transformer 则能建模长时间上下文。然而,随着生成从片段转向完整歌曲,模型必须在多个尺度上协调决策,从旋律发展和段落过渡,到精细的音色与人声质感。此前的一些分层系统(如 Seed-Music 和 ACE-Step 1.5)将语言模型与扩散渲染器结合,而 MusiCoT 和 Qwen-Music 等思维链方法则显式规划旋律或配器等要素。然而这些规划往往不透明或在时间结构上受限,且先前工作(如 JASCO 和 InstructME)中针对和弦或旋律的直接控制条件并未暴露模型的内部编排决策供用户检查或修改。ABC 记谱法等符号音乐表示(如 ChatMusician 中所用)提供了可读的接口,但在长篇幅场景中尚未与声学生成紧密集成。
作者提出 StepAudio 3 Music,一个支持通过 ABC-CoT 进行显式音乐规划和开放域文本控制的大规模音乐生成模型。作者在 25Hz 下比较了单码本 VQ、Semantic RVQ 和 Acoustic RVQ,发现多码本 RVQ 能提升重建质量,但单码本 VQ 能使自回归生成更加稳定。基于此,作者设计了一个 50Hz、65536 词表大小的单码本 tokenizer,并结合语义信息驱动的训练,搭配流匹配 DiT 渲染器将连续 VAE 潜变量转换为 48kHz 音频。这种分离使自回归模型专注于音乐序列组织,而渲染器负责声学细节;ABC-CoT 规划模式在合成之前提供可读的和弦、速度、拍号和旋律编排,使创作者能够在音频生成之前检查和修改决策。
数据集

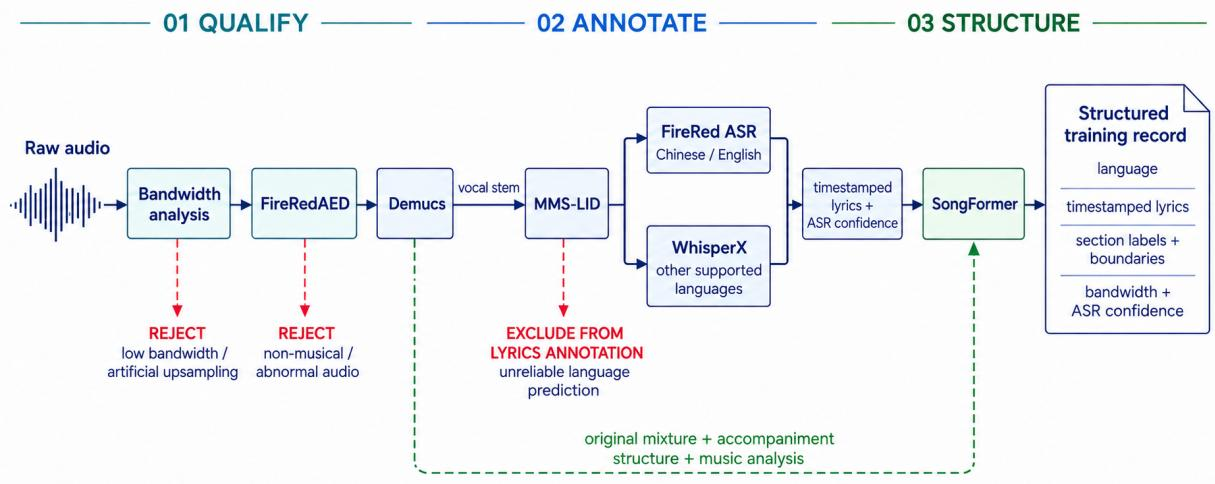
作者构建了一个结构化的数据管道,用于准备大规模音乐训练数据。该管道会过滤低质量素材,并通过多个阶段将每首保留歌曲转换为结构化训练记录,这些阶段包括:频带分析、音频事件检测、音源分离、语种识别、多语言歌词转写和歌曲结构分析。
-
声学过滤: 每个音频文件先经过频谱分析以估计有效带宽,从而去除低带宽录音和疑似人工升采样的样本。随后,多标签音频事件检测(AED)识别语音、歌唱和音乐,排除非音乐录音以及音乐内容不足的样本,再进行后续处理。
-
音源分离和转写: 保留的样本通过 Demucs 将人声与伴奏分离。分离出的人声轨道用于语种识别(通过 MMS-LID)和歌词转写。语种预测置信度较高的样本会进入对应语种的自动语音识别系统,其中中文和英文由 FireRed ASR 处理,其他支持语种由 WhisperX 处理。语种预测不确定的样本则不进行歌词标注。
-
结构化标注: 对于每个识别出的片段,作者保留转写文本、起止时间戳和 ASR 置信度分数。这些分数可作为过滤和任务特定数据选择的质量信号,使管道能够在不提前丢弃语料的情况下移除或标记低置信度样本。
-
歌曲结构分析: 带时间戳的歌词输入 SongFormer,由其将每首歌曲划分为前奏、主歌、副歌、桥段、尾奏等部分。每个歌词片段根据与预测边界的重叠情况对齐到对应部分。
-
最终训练记录: 每条记录包含检测到的语种、带时间戳的歌词、段落标签和边界、频带测量结果以及 ASR 置信度分数。这些结构化标注支持歌词生成歌曲、歌曲生成歌词识别以及长篇幅歌曲结构建模等任务。
-
监督微调(SFT)用途: SFT 语料包含约 20B token,包括直接音乐 token 生成和带有显式 ABC-CoT 规划的生成。ABC-CoT 子集在音乐 token 序列的上下文中保留记谱法规划。对于一般音乐生成样本,样本按流派分组,并在组内使用 SongBench Musicality 分数排序,以保留高质量样本,同时避免高资源流派主导选择。
方法
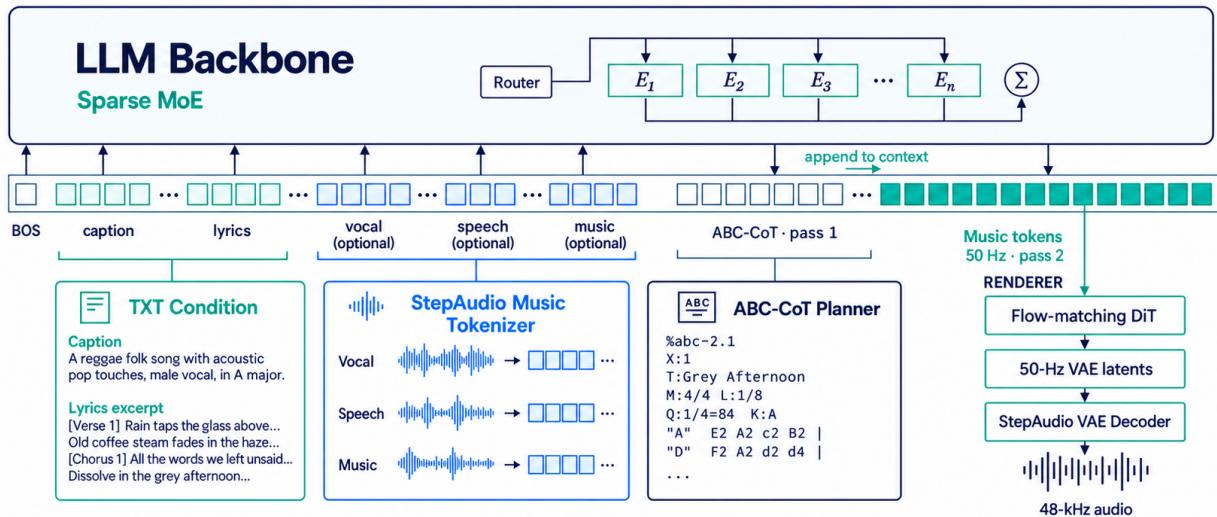
作者利用共享的自回归骨干网络,支持开放域文本控制生成和显式音乐规划。如框架图所示,专家混合解码器以歌词、文本提示和可选的任务特定参考为条件来预测音乐 token。StepAudio Music Codec 提供该离散序列与高保真音频之间的接口,将长程音乐组织与声学渲染分离。当显式规划启用时,自回归模型首先生成 ABC-CoT 编排方案,并将其纳入音乐 token 生成的上下文。这种两遍分解使模型能够在预测 50Hz 音乐 token 序列之前,生成包含和弦、速度、拍号和 ABC 序列的编排方案。
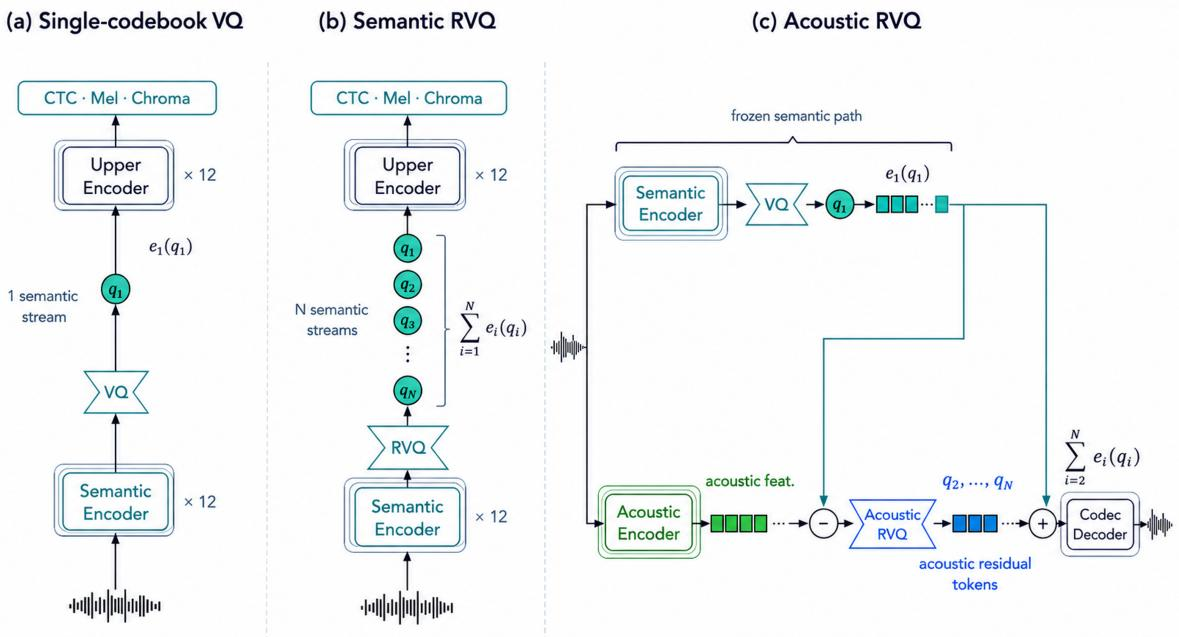
StepAudio Music Codec 由音乐 tokenizer 和流匹配 DiT 解tokenizer组成。Tokenizer 将 24kHz 音频转换为来自 65536 词表大小的单码本的 50Hz 离散 token 流。以此类 token 为条件,解tokenizer生成连续 VAE 潜变量,再解码为 48kHz 波形音频。为了设计有效的离散瓶颈,作者在统一的 25Hz 帧率下比较了三种候选架构。单码本 VQ 每帧产生一个语义 token,提供最简单的预测目标。Semantic RVQ 在相同的语义监督潜空间中对残差进行量化,而 Acoustic RVQ 冻结语义 tokenizer,并对声学特征与对齐后语义特征之间的残差进行量化。作者选择单码本 VQ 设计,因为它能保持良好的音乐性,同时避免多流残差量化中观察到的误差累积,最终采用 50Hz 配置以提供更密集的 token 级监督。
为了支持大规模音乐训练,作者构建了一条自动化数据管道,逐步过滤低质量素材并将保留歌曲转换为结构化训练记录。原始音频首先经过带宽分析和音频事件检测,以剔除低带宽或非音乐样本。保留样本通过 Demucs 分离为人声和伴奏音轨。人声音轨进入语种识别和多语言转写系统,例如中文和英文使用 FireRed ASR,其他语种使用 WhisperX。最后,SongFormer 分析全局歌曲结构,将音频划分为各个部分,并将带时间戳的歌词对齐,生成包含语种、段落标签和置信度分数的结构化训练记录。
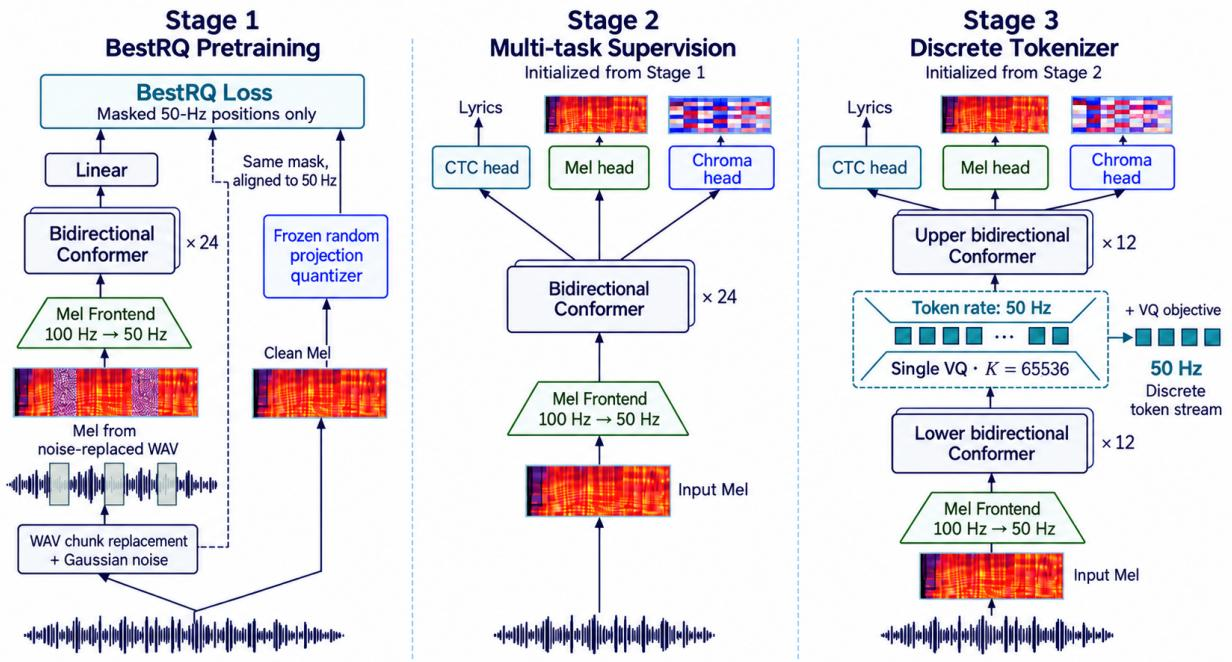
训练过程从音频表示逐步推进到语言模型。作者首先训练 StepAudio Music Tokenizer 和 DiT 渲染器,然后固定 codec,优化 MoE 语言模型。Tokenizer 通过三个阶段依次训练。阶段 1 适配 BEST-RQ 自监督目标,即在 Mel 特征提取之前将连续的波形片段替换为高斯噪声,模型预测掩蔽的 50Hz 位置处的干净目标。阶段 2 对整首歌曲输入引入多任务监督,利用 CTC、Mel 和 Chroma 重建目标,将表示适配为适合音乐 tokenization 的结构化空间。阶段 3 在下方和上方的 12 层 Conformer 堆叠之间插入离散瓶颈,将连续表示量化为包含 65536 个词条的单码本。联合训练目标结合了歌词识别、Mel 重建、Chroma 重建和向量量化损失。
Tokenizer 训练完成后,流匹配 DiT 渲染器在真实音乐 token 和来自 StepAudio VAE 的对应连续潜变量上进行训练。离散条件与 50Hz VAE 潜变量逐帧对齐。长篇幅生成以 30 秒为块进行,每个后续块基于前一个块生成的潜变量序列的最后两秒作为条件,以保持局部声学连续性。
codec 固定后,LLM 从专家混合文本语言模型初始化,并采用三阶段课程进行训练。阶段 1 侧重于歌词生成音乐和音乐生成歌词识别的大规模预训练。阶段 2 扩展上下文长度并引入 ABC-CoT 生成,以教授两遍生成流程,同时包括音乐理解和参考条件任务。阶段 3 专注于歌曲生成、翻唱生成和人声混音生成等核心创作任务的高质量退火。后训练阶段通过监督微调和直接偏好优化进一步对模型进行专门化,利用专家成对偏好将输出与高质量听感偏好对齐。
实验
评估覆盖完整的 StepAudio 3 Music 管道,从流匹配解tokenizer的消融实验开始:50Hz VAE 在直接重建上优于 25Hz,但将 DiT 从 0.9B 扩展到 8B 并未带来一致的提升,表明存在 tokenizer 造成的信息上限,因此采用 0.9B 模型。通过 DPO 进行偏好优化在音乐性、感知质量和描述一致性等所有指标上均优于 SFT。加入 ABC-CoT 规划带来小幅提升,而基于 LLM 对符号方案进行编辑则带来更大改进,尤其在混音、编排和旋律方面,这支持了可解释方案作为音乐知识有效接口的设想。在主要比较中,StepAudio 3 Music 在 AudioBox-Aesthetics 和 MuQ-MuLan 相似度上领先,但 SongBench 将 Mureka V9 排在更高位置,盲测竞技场将模型排在第四;局限性包括 SongBench 过滤并非独立进行、评估为单样本评估,以及覆盖范围仅限人声轨道。
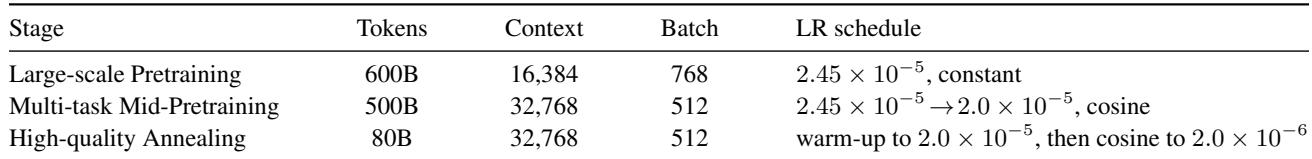
StepAudio 3 Music 的 LLM 分三个阶段训练,token 预算递减、上下文长度递增,学习率调度从常数切换为余弦衰减。训练语料非常广泛,覆盖多样的音乐任务,并包含专门的 ABC 记谱法语料以增强显式音乐控制。训练从 600B token 的大规模预训练推进到 500B token 的多任务中期训练,最后是 80B token 的高质量退火。上下文长度在第一阶段后从 16,384 翻倍至 32,768,批大小从 768 降至 512。学习率调度从阶段 1 的常数切换为后续阶段的余弦衰减,阶段 3 包含预热和更低的最终学习率。训练语料包含超过 1 亿首歌曲和约一万亿 token,涵盖歌词生成音乐、音乐生成歌词识别,以及基于 ABC 的理解和生成任务。
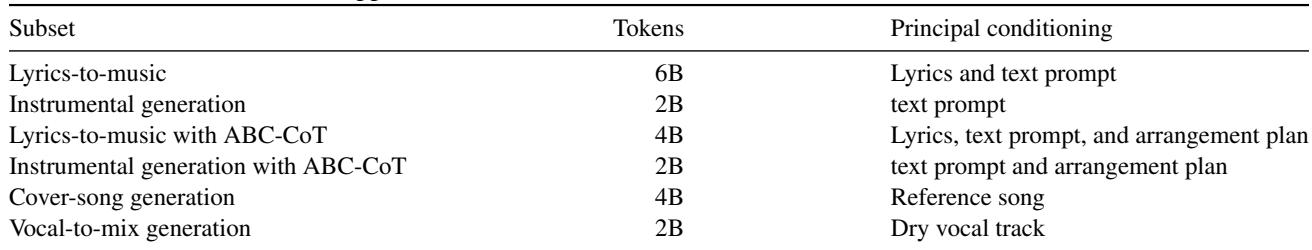
监督微调语料包含约 20B token,分布于六个任务子集,每个子集具有不同的条件输入,包括直接生成和带显式 ABC-CoT 规划的生成。在 SFT 数据中包含带记谱法方案的 ABC-CoT 子集,有助于建立音乐条件与其音频实现之间的关联。一般音乐样本的数据选择采用流派分组和 SongBench musicality 排序,以保留高质量样本且避免流派主导。语料包含六个任务子集,其中歌词生成音乐规模最大,为 6B token,其次是带 ABC-CoT 的歌词生成音乐和翻唱生成,各为 4B token。条件格式从简单文本提示到歌词、文本、编排方案、参考歌曲或干人声音轨的组合。ABC-CoT 子集携带显式编排方案作为上下文,强化了音乐条件与声学输出之间的关系。一般音乐样本按流派分组并按 SongBench musicality 排序,以平衡音乐质量和流派代表性。
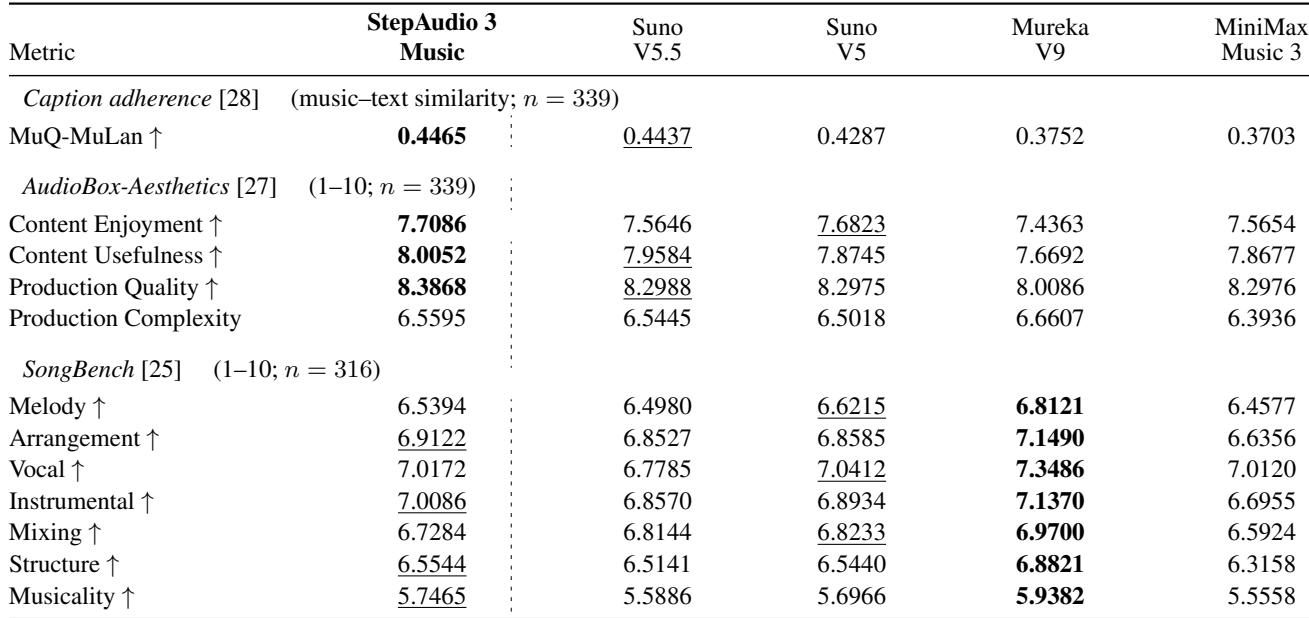
StepAudio 3 Music 在描述遵循度以及 AudioBox-Aesthetics 的 content enjoyment、usefulness 和 production quality 指标上领先,而 Mureka V9 在 SongBench 的各个单项维度上位居首位。结果表明 StepAudio 3 Music 在感知质量和文本对齐方面表现突出,但不同的评估体系会给出不同的排名。StepAudio 3 Music 在音乐文本相似度以及 Content Enjoyment、Content Usefulness 和 Production Quality 上得分最高。Mureka V9 在 SongBench 的各单项维度上领先,表明排名取决于所使用的评估器。Production Complexity 在各系统间相近,Mureka V9 最高,MiniMax Music 3 最低。
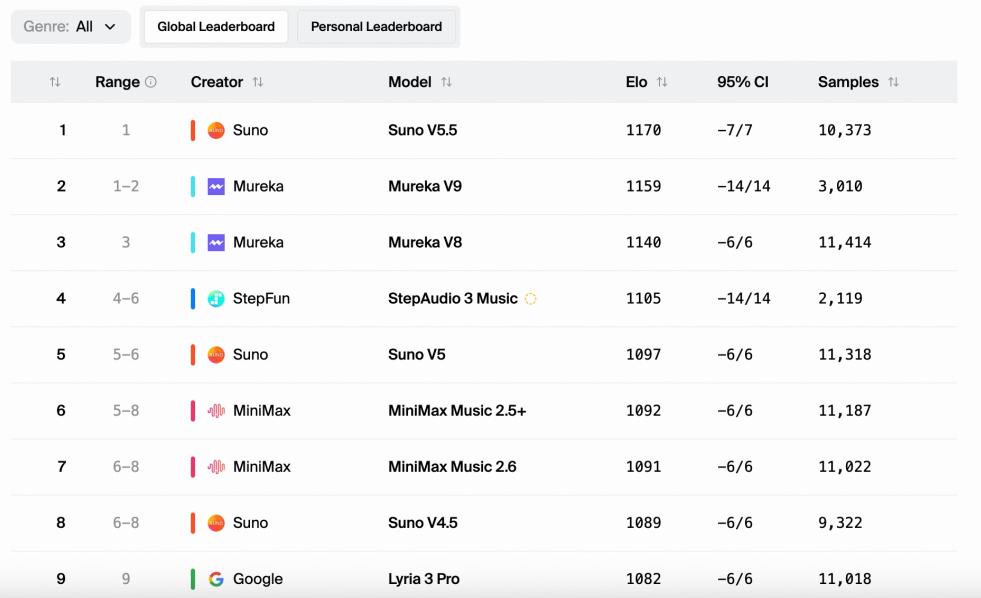
在 Artificial Analysis Music Arena vocals 排行榜中,StepAudio 3 Music 在盲选偏好投票中取得 1105 的 Quality Elo,在所列出模型中处于中上区间。排名最高的模型是 Suno V5.5 和 Mureka V9,StepAudio 3 Music 与它们的差距较小。StepAudio 3 Music 以 1105 的 Elo 排名第四,基于约 2,119 个样本。Suno V5.5 以 1170 的 Elo 位居榜首,Mureka V9 以 1159 紧随其后。StepAudio 3 Music 的 Elo 与最高模型相差 65 分以内,表明其人声质量具有竞争力。
消融实验比较了 25 Hz 和 50 Hz 下的直接 VAE 重建,以及使用 50 Hz VAE 和 0.9B、4B、8B 参数 DiT 的 token 条件解tokenization。50 Hz VAE 在直接重建的所有指标上均优于 25 Hz VAE。在 token 条件生成中,最小的 0.9B DiT 在大多数指标上得分最高,表明性能上限来自 tokenizer 而非渲染器容量。50 Hz VAE 的直接重建优于 25 Hz VAE,MCD 更低,SI-SNR 和 SDR 更高。在 token 条件解tokenization中,0.9B DiT 在 MCD、MS-Mel-L1、MS-STFT-L1、SI-SNR 和 UTMOS 上表现最佳,而 4B 模型仅在 SDR 上领先。将 DiT 从 0.9B 扩展到 4B 或 8B 并不能带来一致的质量提升,表明 tokenizer 限制了可达到的性能。
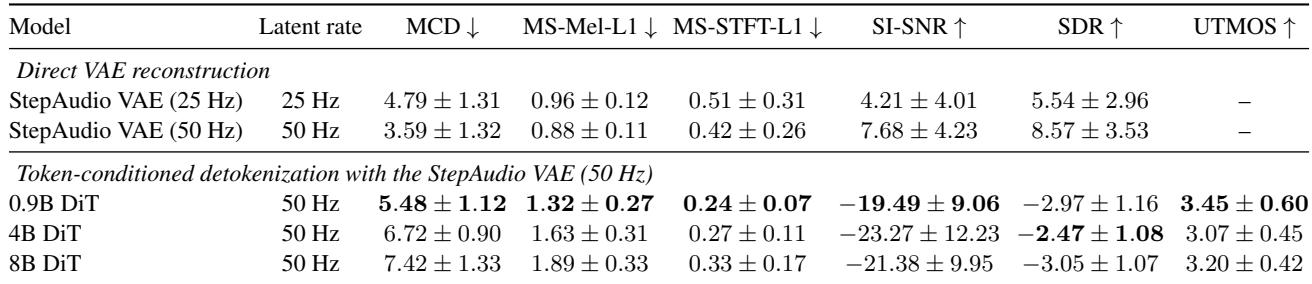
StepAudio 3 Music 的 LLM 分三个阶段训练,token 预算递减、上下文长度递增,学习率从常数切换为余弦衰减,语料约为一万亿 token,并包含 ABC 记谱法以增强控制能力。其监督微调使用约 20B token,分布于六个任务子集,其中 ABC-CoT 规划的纳入将音乐条件与音频输出关联起来,流派平衡选择则保持质量。在评估中,该模型在描述遵循度和 AudioBox-Aesthetics 指标上领先,而 Mureka V9 在 SongBench 的各个单项维度上表现更优;竞技场排行榜将 StepAudio 3 Music 排在第四,其人声质量具有竞争力。消融实验表明,50 Hz VAE 在重建上优于 25 Hz VAE,但 token 条件解tokenization在较小的 0.9B DiT 处即饱和,表明限制性能的是 tokenizer 而非渲染器容量。