Command Palette
Search for a command to run...
贝尔曼策略优化
贝尔曼策略优化
Zhuoqing Song Haotian Xu Xikun Zhang Lidong Bing
摘要
具有可验证奖励的强化学习(RLVR)能够提升大型语言模型(LLMs)的推理能力。我们提出了贝尔曼策略优化(BPO),这是一种由策略镜像下降(PMD)推导而来的无评论家方法。对于具有终止奖励的自回归生成,BPO 利用贝尔曼方程将 PMD 重新表述为轨迹级目标。这种重新表述避免了对中间状态的状态价值进行估计。我们证明了其与原始 PMD 目标具有相同的唯一最优解。我们通过近似该目标推导出实用的 BPO 损失。其失配校正权重是互补词元概率的平滑比值。在数学推理基准上的实验证明了 BPO 的有效性。
一句话总结
Apodex US, Inc. 和普林斯顿大学的研究人员提出了 Bellman Policy Optimization(BPO),这是一种源自 Policy Mirror Descent(PMD)的无 critic 方法,通过 Bellman 方程将 PMD 重构为面向自回归生成、使用终止奖励的轨迹级目标,避免状态值估计,并使用平滑的互补 token 概率失配校正权重,在数学推理基准上展现出有效性。
核心贡献
- Bellman Policy Optimization(BPO)被提出为一种源自 Policy Mirror Descent 的无 critic 强化学习方法,利用 Bellman 方程构建轨迹级目标,避免估计中间状态值。
- 该方法证明,在 rollout 策略可到达的状态上,该轨迹级目标与原始 PMD 目标具有相同的唯一最优解,并推导出一个实用的 token 级损失,其中带有基于互补 token 概率的平滑失配校正权重。
- 在数学推理基准上,BPO 使用 Qwen3-30B-A3B-Base 在 AIME 2024 至 2026 上达到 50.5% 的峰值平均准确率,比 GRPO-ClipHigher、GSPO、CISPO 和 DPPO 高出 3.1 至 11.0 个百分点;在 Qwen3-4B-Base 上的消融实验显示,不同平滑和截断设置下的性能相似。
引言
使用可验证奖励的强化学习(RLVR)是提升大语言模型推理能力的重要方法,其利用任务特定验证器给出的结果级奖励来指导训练。GRPO 等广泛使用的方法在采样组内归一化奖励并避免使用价值模型,但它们依赖 PPO 式裁剪目标中的 token 级重要性采样比率。直接应用 Policy Mirror Descent 会需要中间状态的价值估计,而训练单独的价值模型会增加内存和计算成本,并可能在推理任务上产生不准确的估计。作者提出了 Bellman Policy Optimization(BPO),这是 Policy Mirror Descent 的一种无 critic 重构,它利用 Bellman 方程和策略似然比将终止奖励优势转换为轨迹级目标,从而避免中间价值或优势估计。由此得到的实用损失将 GRPO 的重要性采样比率替换为平滑的失配校正权重,BPO 在数学推理基准上优于多个基线。
方法
作者将 Bellman Policy Optimization(BPO)构建为一种用于可验证奖励强化学习的无 critic 策略优化方法。该方法基于分组优势估计和 policy mirror descent,将 GRPO 中使用的重要性采样比率替换为从 PMD 最优性条件推导出的失配校正权重。
对于每个提示 x,从 rollout 策略 μ 中采样一组 G 条响应 {yi}i=1G。给定终止奖励 Ri=R(x,yi),BPO 使用与 GRPO 相同的分组归一化优势:
A^i=std({Rj}j=1G)Ri−mean({Rj}j=1G).对于响应 yi 中的 token yti,BPO 的逐 token 损失定义为
Li,tBPO(π)=−A^iMtimin{sg(ωti),C}logπ(yti∣x,y<ti),其中 C 是用于稳定性的常数上限,Mti 是裁剪掩码。与 GRPO 的主要区别在于权重 ωti,它替换了重要性采样比率 rti。该失配校正权重定义为
ωti=1+ϵ−π(yti∣x,y<ti)1+ϵ−μ(yti∣x,y<ti),其中 ϵ 控制加性平滑。掩码 Mti 遵循与 GRPO 相同的裁剪规则,但使用 ωti 代替重要性比率:
Mti=⎩⎨⎧0,0,1,A^i>0 and ωti>1+ϵhigh,A^i<0 and ωti<1−ϵlow,otherwise.因此,BPO 保留了 GRPO 的逐 token 加权对数似然形式,同时将比率 rti 替换为截断的失配校正权重 min{sg(ωti),C}。
BPO 的推导从基于优势的 policy mirror descent 开始。对于每个状态 st=(x,y<t),PMD 更新被表述为
π(⋅∣st)∈Δ(V)maxEyt∼π(⋅∣st)[Aμ(st,yt)]−η1DKL(π(⋅∣st)∥μ(⋅∣st)),其中 Aμ(st,yt) 是 rollout 策略的优势函数。唯一最优策略具有如下形式
π+(yt∣st)=Zμ(st)μ(yt∣st)exp(ηAμ(st,yt)).直接实现该更新需要估计中间状态上的优势,通常通过学习得到的 critic 来完成。BPO 通过推导无 critic 的重构来避免这一点。
作者证明,PMD 可以通过平方轨迹级残差目标等价地表达。对于依赖 prompt 的正权重 ϕ(x),无 critic 目标为
π∈ΠμminL(π)=Ex∼D,y∼Pμ(⋅∣x)[ϕ(x)⋅2ηδ(x,y;π,μ)2],其中轨迹级残差为
δ(x,y;π,μ)=η(R(x,y)−Vμ(x))−t=1∑∣y∣(logμ(yt∣st)π(yt∣st)+DKL(μ(⋅∣st)∥π(⋅∣st))).该目标仅取决于终止奖励和初始值函数 Vμ(x),而不取决于中间状态值。通过重写 PMD 最优性条件、将其与轨迹上的 Bellman 方程结合,并证明 PMD 解使残差 δ 为零,建立了该无 critic 目标与原始 PMD 问题之间的等价性。
实用的 BPO 损失通过四个步骤从该重构得到。首先,在 π=μ 附近对平方残差目标进行线性化。其次,用组平均奖励估计 Vμ(x),并将 ϕ(x) 替换为经验奖励标准差的倒数,从而得到归一化优势 A^i。第三,将完整反向 KL 散度近似为二元 KL 散度,由此产生 token 级比率
∇(logπ(yti∣sti)+DKLbin(μ(⋅∣sti)∥π(⋅∣sti);yti))=1−π(yti∣sti)1−μ(yti∣sti)∇logπ(yti∣sti).随后对该比率应用加性平滑,得到 ωti。最后,应用 GRPO 式掩码和上限 C,得到 BPO 梯度
∇Li,tBPO(π)=−A^iMtimin{ωti,C}∇logπ(yti∣sti),该梯度对应公式(14)中的 BPO 逐 token 损失。
实验
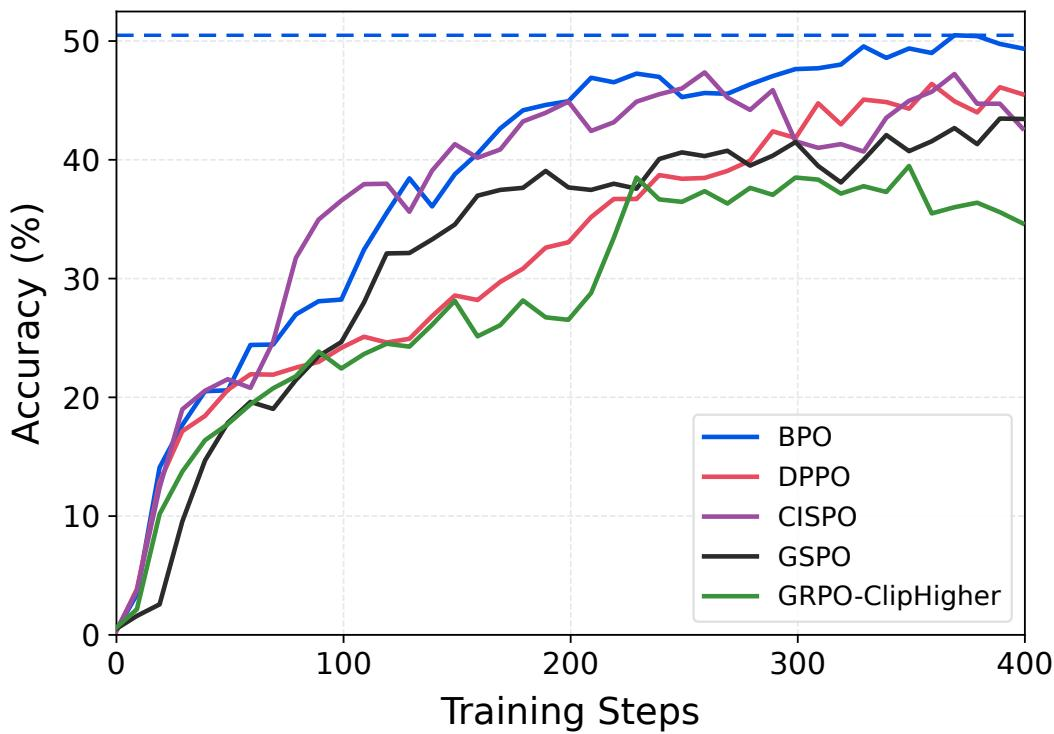
实验评估了 BPO 在数学推理上的表现,使用在 DAPO-Math-17k 英文子集上训练的 Qwen3-30B-A3B-Base,所有方法除策略损失外共享相同的 rollout 和优化设置。使用通过 Avg@32 估计的 Pass@1 在 AIME24、AIME25 和 AIME26 上进行评估,结果显示 BPO 在所有基准上以及训练结束时都一致取得最高准确率。结果表明 BPO 优于 CISPO 和 DPPO 等强基线,验证了其作为提升数学推理能力的有效策略优化目标。
在所有比较的策略损失方法中,BPO 取得了最高平均准确率,并在每个 AIME 基准上取得最高分。最佳检查点处最强的基线是 CISPO,BPO 平均比其高出 3.1 个百分点。训练结束时,BPO 的平均准确率也超过了最强的最终基线 DPPO。BPO 在 AIME24、AIME25 和 AIME26 以及总体平均值上均领先所有方法。BPO 相比最强的 best-checkpoint 基线提高了 3.1 个百分点,并在训练结束时超过最强的最终基线。
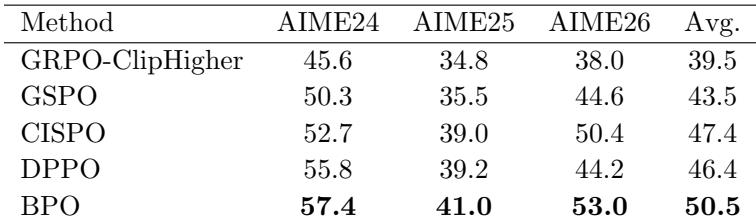
评估比较了 AIME 基准上的策略损失方法,同时考虑最佳检查点和训练结束时的表现。BPO 取得了最高平均准确率,并在每个 AIME 基准上取得最高分,超过了最强的 best-checkpoint 基线 CISPO 和最强的最终基线 DPPO。它在 AIME24、AIME25、AIME26 和总体平均值上均领先所有比较方法,表现出持续的优势。