Command Palette
Search for a command to run...
EvoOntology:面向数据智能体的自进化本体层
EvoOntology:面向数据智能体的自进化本体层
Meiduo Chong Shaolei Zhang Ju Fan Xiaoyong Du
摘要
数据智能体的目标是在异构数据(包括表格、文件和数据库)上完成自然语言指令。然而,数据智能体面临着具有挑战性的智能体–数据鸿沟:异构数据位于智能体之外,而智能体只能通过通用工具访问这些数据(例如列名和文件路径)。现有方法要么让智能体直接探索原始数据源,要么将人工构建的语义层注入提示。然而,这两种方法既难以扩展到大规模异构数据源,也难以适应不同的智能体行为。本文提出了 EvoOntology,一个面向数据智能体的自进化本体层。EvoOntology 将本体封装为一个 MCP 服务器,该服务器包含模式层、内容层和工具层,使智能体能够在运行时主动查询本体并与之交互。为此,我们引入了一个用于自主构建本体的构建器智能体,以及一个自进化循环;该循环通过归因引导的类型化编辑持续优化本体,并且这些编辑只有在经过骨干条件化配对评估后才会被接受。在三个广泛采用的数据智能体基准以及四个 LLM 骨干上的实验表明,EvoOntology 一致地优于强基线和现有语义层方法,有效弥合了智能体–数据鸿沟,并能更有效地与异构数据进行交互。
一句话总结
中国人民大学的研究者提出 EvoOntology,一个面向数据 agents 的自我进化本体层,该本体层将 MCP server 封装为 schema、content 和 tool 层,其中 builder agent 构建本体,并通过归因引导的类型化编辑循环和基于 backbone 条件的成对评估对其进行优化;在三个广泛采用的基准测试上、跨四个 LLM backbones,EvoOntology 均优于强基线和现有语义层方法。
核心贡献
- EvoOntology 为数据 agents 引入了一个可交互的本体层,封装为带 schema、content 和 tool 层的 MCP server,使 agents 能在运行时查询和交互异构数据。
- builder agent 自主构建本体,自我进化循环通过归因分析、有针对性的类型化编辑和基于 backbone 条件的成对评估,在留出验证数据上优化本体。
- 在三个数据 agent 基准上、跨四个 LLM backbones 的实验表明,EvoOntology 始终优于强基线和现有语义层方法。
引言
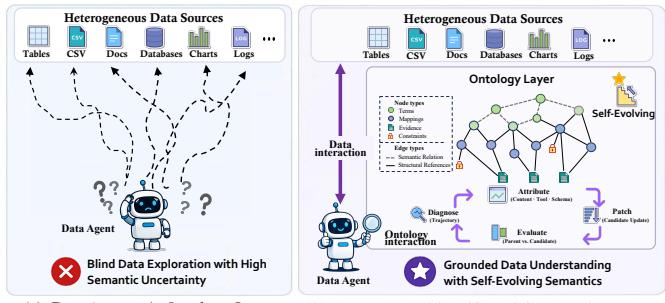
数据 agents 必须回答异构结构化和非结构化来源上的自然语言任务,但通常只能通过 SQL 接口和文件读取器等通用工具访问数据。由于这些来源的 schema 和 content 事先未知,agents 只能盲目探测和低效探索,形成持续的 agent 与数据之间的鸿沟。先前基于原始查询的方法难以扩展到宽泛的异构数据,而语义层方法通常是静态、人工维护且过大,无法放入 agent 上下文。作者提出 EvoOntology,一个通过 Model Context Protocol server 暴露的自我进化本体层,agents 可以在运行时查询;该本体层能够自动构建、将本体条目建立在观察到的数据之上,并通过来自 agent 交互轨迹的归因引导编辑和成对验证进行自我优化。
方法
为减少人工语义层编写工作,同时使该层适应 agent 行为,作者提出 EvoOntology,一个以 agent 为先的构建与进化框架。EvoOntology 维护由 content、schema 和 tool 层组成的版本化本体状态。builder agent 从训练工作负载和原始数据源构建以证据为基础的初始状态,而 evolution agent 则从历史轨迹中优化该状态。这种设计以 agent 为先,因为本体围绕工作负载构建、通过工具接口访问,并根据执行历史进行调整。
如下图所示:
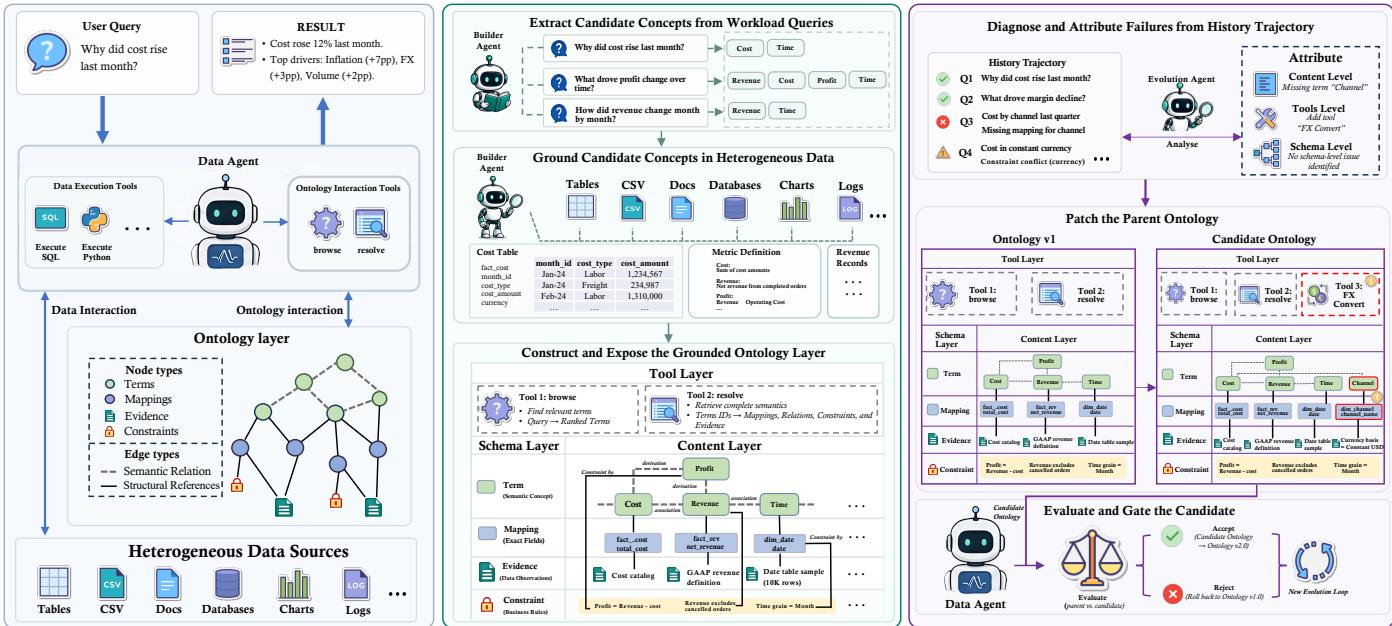
该框架将第 t 轮进化时的本体状态表示为 Lt=(St,Γt,Rt),它将语义知识、对象模型和运行时暴露分离开来。这种分离允许被部署的 agent 只检索与当前步骤相关的语义,并使 evolution agent 能够更新本体状态的有界部分。
Content 层 St 是一个类型化语义图,包含四类节点(Terms、Mappings、Constraints 和 Evidence)和两类边(Semantic Relations 和 Structural References)。Terms 表示领域概念,Mappings 将概念关联到字段和连接路径,Constraints 约束其合法使用,Evidence 支持其语义声明。Schema 层 Γt 定义节点族的字段、可用的 Semantic Relation 类型以及允许的引用模式,使 schema 更新能够扩展表示能力而不改变已实例化的内容。Tool 层 Rt 通过两个 MCP 工具和一个 session manifest 暴露本体。函数 fbrowse(q,k,n) 检索查询 q 和类型 k 的前 n 个语义匹配,而 fresolve(T,c) 返回请求的记录及其链接对象。manifest 在会话初始化时提供紧凑的来源和使用信息,并且是唯一直接放入 prompt 的本体内容。
在初始化阶段,builder agent 从训练工作负载 W 和原始数据源 D 构建初始本体,而不观察 gold answers。通过工作负载引导的探测,builder 从重复出现的实体、指标、操作和分析条件中提出候选概念 C。对于每个候选概念 c∈C,它发起一次探测,以识别候选字段和连接路径,检查其类型、值和语义一致性。通过以证据为基础的确认,只有得到探测结果支持的候选概念才会被提交到初始 Content 层:
C+={c∈C∣verify(probe(c,D))=1},S0=construct(C+,D;Γ0)经过验证的候选概念在 Γ0 下实例化,支持记录被保留为 Evidence,形成初始状态 L0=(S0,Γ0,R0)。
为了确保本体适合特定 agent,进化阶段利用历史轨迹作为行为证据。给定历史轨迹 Tt 和当前状态 Lt,evolution agent 提取重复出现的签名 Σt=analyze(Tt,Lt)。每个签名总结了一种交互模式、涉及的本体对象以及观察到的结果。agent 将签名归因到 Content、Tool 或 Schema 层,并说明一次更新预期带来的行为效果。对于已归因的签名,agent 提出只修改本体一个层面的局部干预。Content 干预添加、删除或修订 St 中已实例化的语义对象。Tool 干预根据观察到的 agent 行为修改现有工具,或在 Rt 中添加和删除工具。Schema 干预修订 Γt 中的对象模型。
最后,系统采用 backbone 条件成对验证。对于 backbone m,令 ϕ(L,V;m) 表示本体状态 L 在验证集 V 上的得分。候选状态及其父状态在相同的 V 上以相同的解码和交互预算进行评估。仅当候选状态的改进达到阈值 τ 时才予以保留:
Lt+1={Lt′,Lt,ϕ(Lt′,V;m)−ϕ(Lt,V;m)≥τ,otherwise.被拒绝的候选状态不会部署,其签名、干预和评估结果都会被记录,以避免重复的无效更新。所有 backbone 从相同的初始状态 L0 独立进化,使被接受的更新能够反映 backbone 特有的交互模式。
实验
EvoOntology 在 DDR-Bench、InsightBench 和 BIRD 上、跨六个 LLM backbones、使用互为两折设置进行评估,并与无本体 ReAct 基线、静态语义层 prompt 基线以及部分情况下基于记忆的检索进行比较。可查询本体层带来一致的提升,而静态 prompt 基线效果参差不齐甚至为负,情节记忆仍弱于结构化本体。builder 构建的本体提供了较强的初始改进,自我进化进一步带来收敛式提升;消融实验显示 evolution gate 和归因步骤以及 Mappings 和 Evidence 结构是最关键的组件,且 backbone 特定的本体在同一 backbone 内迁移效果最好。
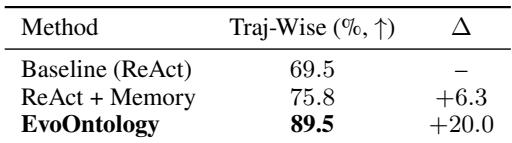
在 DDR-Bench 10-K 场景中,EvoOntology 对每个受评估 LLM backbone 都相比基线提高了轨迹级准确率,平均提升接近 18 个百分点,且不同 backbone 的提升有所不同。相比之下,将语义层作为静态 prompt 注入并不能带来一致提升,在某些 backbone 上甚至会显著降低准确率。优势来自通过可查询工具暴露本体内容,而不是依赖静态 prompt 片段。EvoOntology 在所有受评估 backbone 上都取得了相比基线的一致的轨迹级提升。基线加静态语义层有时不如无中介的 agent,包括在一个 backbone 上出现大幅下降。基于工具的主动本体访问是相比静态 prompt 改进的主要来源。被接受的进化轮次单调提高分数并在后期趋于稳定,表明是收敛而非单次偶然修复。
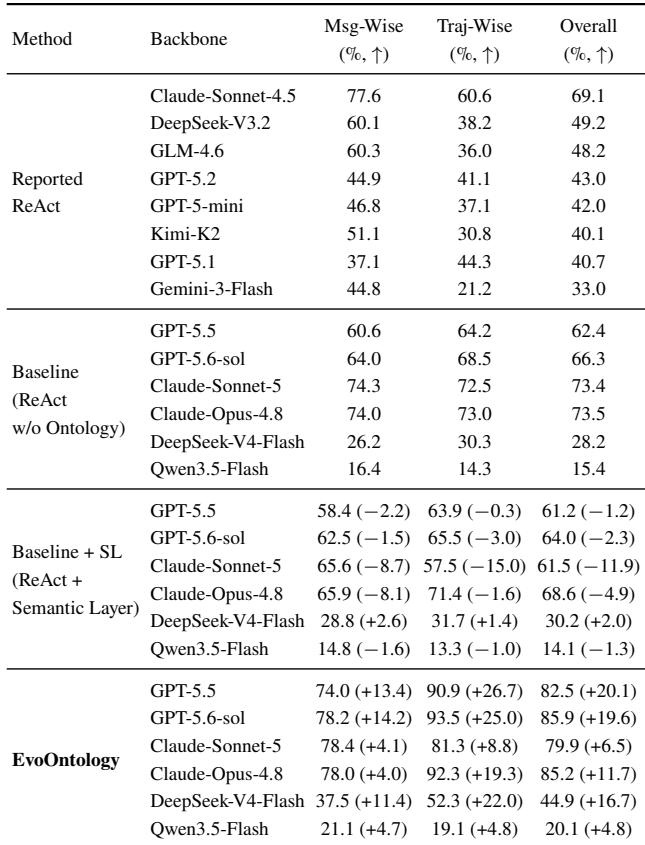
在 DDR-Bench 上跨四个 backbones 平均来看,将过去轨迹存储为可检索 episodes 相比基础 ReAct agent 带来了适度提升。EvoOntology 产生大得多的 Trajectory-Wise 增益,明显超过基线和记忆增强变体。添加过去轨迹记忆相比 ReAct 基线有所改善,但幅度相对较小。EvoOntology 实现了最强的 Trajectory-Wise 改进,大幅优于基线和基于记忆的持久化方法。
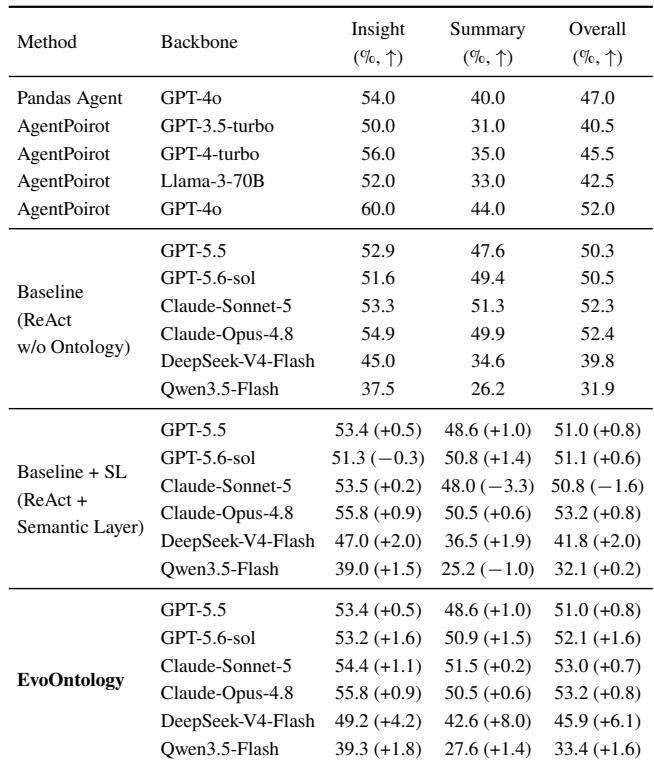
在 InsightBench 上,EvoOntology 在受评估 backbone 上提高了整体性能,相对基线有适度的平均提升。这些提升小于检索导向基准上的提升,因为一旦输出与参考风格的发现相匹配,洞察挖掘就会趋于饱和。与静态语义层不同,EvoOntology 通过可查询工具暴露本体内容,同时改善了 insight 和 summary 指标。EvoOntology 在 InsightBench 上跨 backbone 取得了一致的整体提升,其中 DeepSeek-V4-Flash 上的提升最大。静态语义层恢复了大部分 insight 增益,但不能一致地保持 summary 质量,并在一个 backbone 上出现下降。与静态语义层不同,EvoOntology 同时改善了 insight 和 summary 分数。
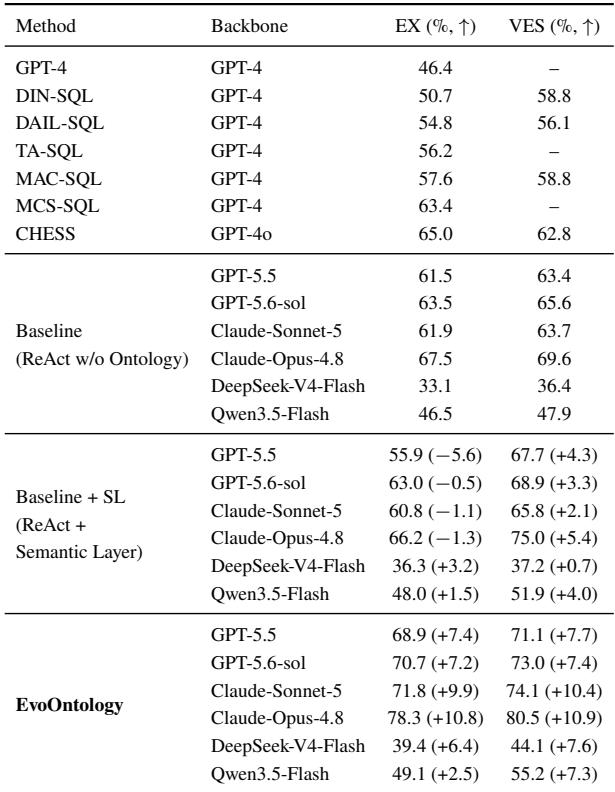
在 BIRD 上的 oracle knowledge 设置下,EvoOntology 在所有受评估 backbone 上同时提高了执行准确率和效率,并取得一致的平均提升。静态语义层提高了效率,但可能降低执行准确率,表明它有助于生成格式良好的 SQL,却会干扰正确查询生成。通过可查询工具暴露同一本体并通过进化循环进行优化,相比基线和先前 text-to-SQL 系统带来了稳定提升。EvoOntology 在每个受评估 backbone 上都提高了执行准确率和效率。静态语义层改善了 SQL 格式规范性,但可能降低执行准确率。可查询且经过进化的本体访问恢复了准确率提升,并优于先前的 text-to-SQL 方法。
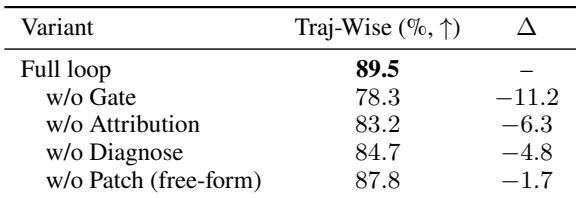
完整进化循环取得了最高的平均轨迹级分数,禁用任何一个步骤都会降低性能。gate 步骤最为关键,它通过筛选候选补丁防止了最大幅度的性能回退。patch 阶段影响最小,而归因和诊断带来中等程度的提升。在四个进化循环步骤中,移除 gate 步骤导致的性能下降最大。将类型化 patch 阶段替换为自由形式的本体重写,对最终性能影响最小。完整循环优于每一个禁用单个步骤的变体。
在 DDR-Bench、InsightBench 和 BIRD 实验中,EvoOntology 在轨迹准确率、insight 和 summary 质量以及 SQL 执行准确率和效率方面始终优于基础 agents 和记忆增强变体,而静态语义层往往带来不一致的提升或降低性能。改进的主要来源是在迭代进化循环中通过可查询工具暴露本体内容,该循环在已接受的轮次中收敛并趋于稳定。消融实验表明,完整进化循环优于每个禁用单步的变体,其中 gate 步骤最关键,类型化 patch 阶段影响最小。