Command Palette
Search for a command to run...
RSIAgent:面向新环境中递归自改进的自主探索
RSIAgent:面向新环境中递归自改进的自主探索
Sibo Zhu Shicheng Fan Xinyue Wang Wenyi Wu Kun Zhou Biwei Huang
摘要
数字智能体常常需要适应新的环境,而这些环境的接口、工具和失败模式并未被预训练模型完全捕捉。我们提出 RSIAgent,一个无需训练的、通过自主记忆构建实现递归自改进的多智能体框架。RSIAgent 协调课程、行动者和验证者智能体,持续探索环境、验证结果,并保留环境特定的知识,包括动作、条件与结果之间可复用的因果关系。该框架进一步采用“先广后深”的探索策略,将并行的广度递归自探索(用于发现多样化的环境结构)与聚焦的深度自探索(用于揭示困难案例、隐藏约束、边界条件以及此前未知的因果依赖)相结合。最终形成的记忆被冻结,可直接复用于下游任务,无需更新模型参数。在 OSWorld-v2 和 Agent’s Last Exam 上的实验表明,RSIAgent 显著提升了强大的开源模型,使 Kimi-K3 和 GLM-5.3 的性能超越了包括 GPT-6 在内的前沿闭源模型。
一句话总结
来自Aether AI、加州大学圣地亚哥分校和伊利诺伊大学芝加哥分校的研究人员提出RSIAgent,一个无需训练的多Agent框架,通过curriculum、actor和verifier agent的协同,自主探索新环境、验证结果,并采用先广后深的探索策略构建可复用的因果记忆,使得开源模型Kimi-K3和GLM-5.3在OSWorld-v2和Agent’s Last Exam上超越包括GPT-6在内的前沿闭源模型,且无需参数更新。
核心贡献
- RSIAgent是一个无需训练的多Agent框架,其中curriculum、actor和verifier agent自主探索数字环境,并构建包含动作、条件和结果之间因果关系的可复用记忆。
- 它采用先广后深的递归自我探索策略:广度递归自我探索构建多样化的环境覆盖,深度递归自我探索针对困难案例、隐藏约束、边界条件和未知的因果依赖。
- 在OSWorld-v2和Agent’s Last Exam上的实验表明,冻结的记忆能够提升强大的开源模型,使Kimi-K3和GLM-5.3在不更新模型参数的情况下超越GPT-6等前沿闭源模型。
引言
大型语言和视觉语言模型已催生出能够通过观察界面并执行点击或程序等动作来自动化复杂任务的数字agent。然而,将这些agent部署到新环境中具有挑战性,因为其预训练知识可能无法覆盖不熟悉的界面、工具和失败模式。传统的适应方法需要昂贵的人工辅助数据收集和重新训练,这对于私有或快速变化的环境并不实用。管理上下文和记忆的免训练方法提供了灵活性,但往往只是记忆成功的轨迹,而未能揭示动作、环境条件和结果之间的因果关系。作者提出RSIAgent,一个多Agent框架,能够自主探索新环境以发现此类因果知识,并将其整合为可复用的记忆。通过协调curriculum、actor和verifier agent,并采用先广后深的探索策略,RSIAgent实现了无需更新模型参数的递归自我改进,使开源模型在标准基准上超越前沿闭源模型。
方法
作者提出RSIAgent,一个递归自我改进框架,旨在使agent能够自主探索并适应新环境。为实现对自主探索和自我改进的稳健控制,作者设计了一个多Agent协调框架,通过协调的递归循环运行。该系统将agent架构分解为三个协作角色。
如下图所示:
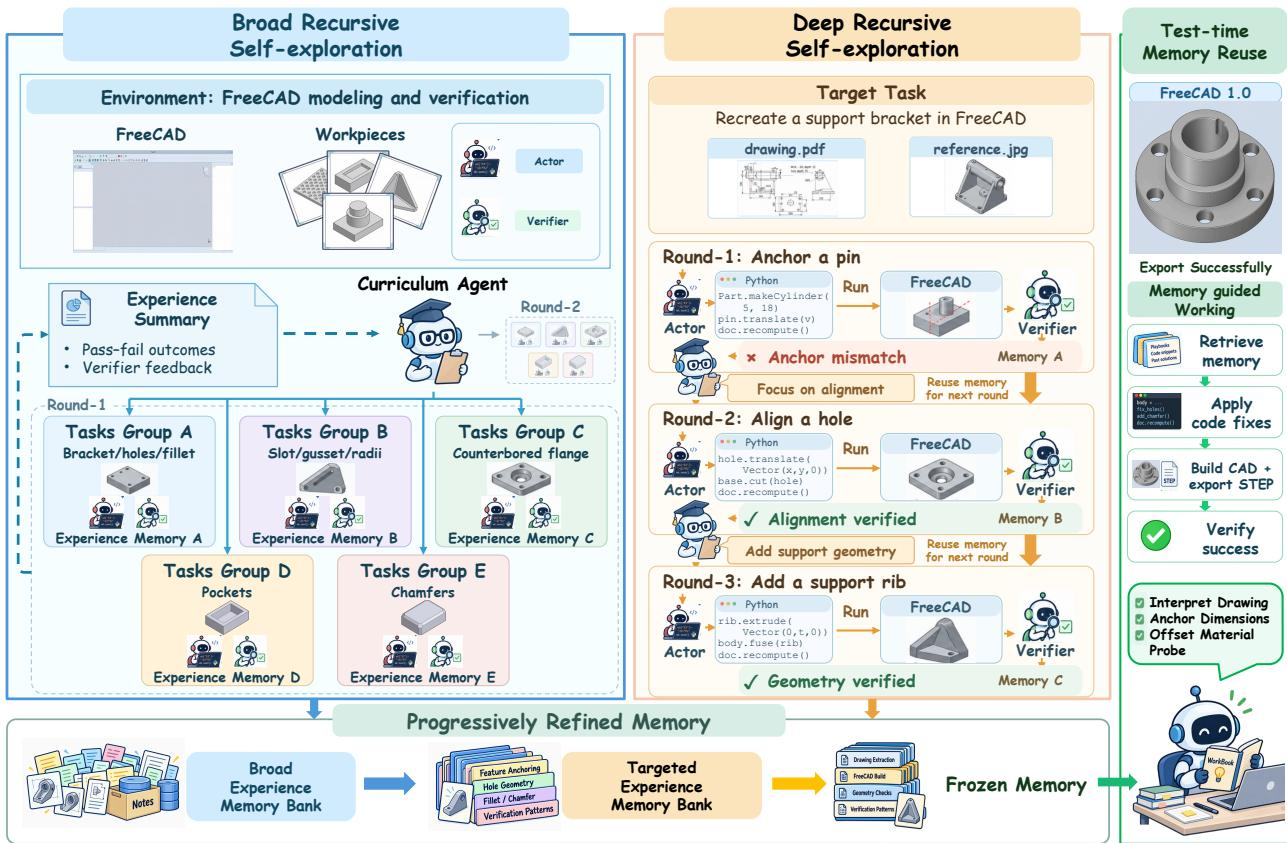
第一个组件是配备可进化记忆的Actor Agent。作为主要的策略模型,该agent负责理解环境并生成可执行的动作。它配有一个持久记忆模块,用于存储环境特定的知识、可复用的流程以及从先前执行中汲取的经验教训。该记忆具有高度可进化性。经过verifier的评估后,actor通过整合新知识并修订或丢弃过时信息来巩固经过验证的经验。后续的actor实例会继承这一更新后的记忆,使得有用的知识在整个探索阶段持续积累。
第二个组件是结合环境反馈的Verifier Agent。该agent充当独立的评估者,判断actor的执行是否成功满足任务要求。为确保判断可靠,verifier直接检查环境反馈,包括执行结果和界面状态,将其决策建立在可观察的证据之上。至关重要的是,verifier与actor的私有推理和记忆相隔离,从而在评估时减少关联错误。它返回二元成功或失败的判断,并附带支持性反馈,以指导记忆巩固。
第三个组件是用于引导探索的Curriculum Agent。作为高层协调者,该agent通过为actor和verifier生成合适的练习任务来主导探索方向。它根据当前目标、积累的记忆和先前的结果,选择前置技能、信息性变体、基于失败的练习和压力测试用例。这种渐进式的任务生成扩展了可进化记忆的覆盖范围,直到生成的任务在新知识获取方面收益递减。
在此多Agent框架的基础上,作者将自主探索过程组织为两个互补的阶段。第一阶段是广度递归自我探索(BRS),旨在通过收集多样化的交互经验,快速构建对新环境的全面理解。在此阶段,curriculum agent提出涵盖不同探索方向的多个任务,这些任务被并行执行和验证。随后,curriculum agent分析积累的经验,识别剩余的知识空白,为下一次迭代生成更具信息量的任务。这一递归过程逐步扩展了环境特定知识、可复用流程和失败模式的覆盖范围。
第二阶段是深度递归自我探索(DRS),通过针对初始执行中暴露的关键知识空白、困难案例和边界条件,来精炼积累的记忆。DRS遵循一个顺序递归循环,逐步提高探索难度。curriculum agent提出一个具有挑战性的任务,旨在暴露当前记忆中不可预测的问题或弱点。actor利用积累的记忆尝试该任务,verifier评估结果。基于成功、失败和新发现的不确定性,curriculum agent生成一个更具挑战性的后续任务。每个经过验证的经验在后续任务提出之前被巩固到记忆中,持续推动agent走向更难、探索更少的场景。
探索阶段之后,系统转入测试时记忆复用。积累的记忆被冻结并提供给actor agent用于下游评估。在此阶段,curriculum agent和所有记忆更新机制被禁用。给定目标任务,actor agent直接复用记忆中存储的流程、发现的约束和失败教训来指导其动作。verifier agent根据任务要求评估结果,这一动作-验证循环持续进行,直到verifier确认所有任务要求均已完全满足。
实验
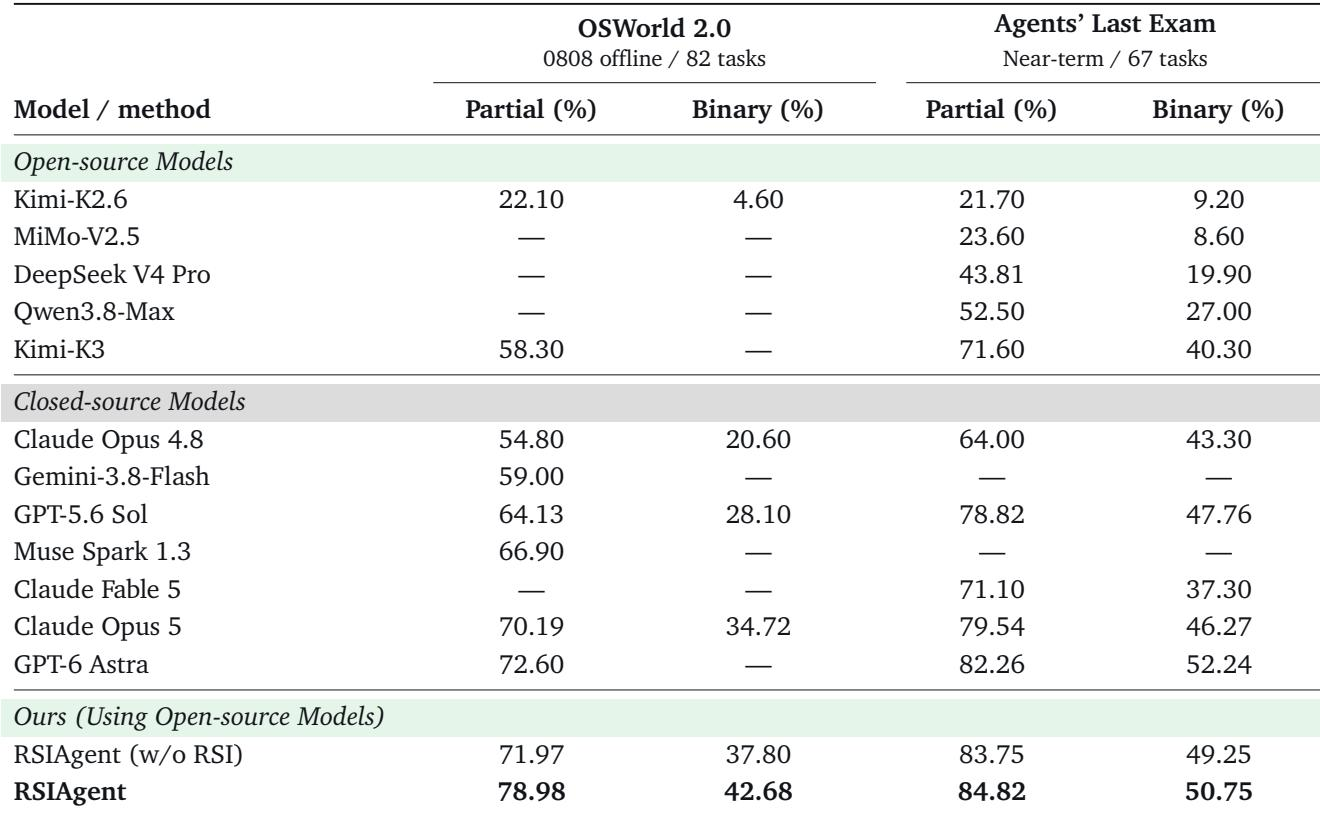
实验在OSWorld 2.0和ALE Near-term上评估RSIAgent,使用基于代码即策略的统一框架,以GLM-5.3作为actor,Kimi-K3作为verifier和curriculum agent。主要结果表明,递归自我改进提升了部分得分和完全完成的性能,且系统在部分得分上达到领先水平,与前沿模型相比。消融实验表明,结合广度和深度递归自我探索比单独任一阶段更有效,而对RSI轮次的分析显示,积累的记忆在覆盖关键需求时能够产生离散的任务级增益。额外的游戏环境评估证实了其对自主游戏开发的泛化能力,失败分析指出探索针对性不足、验证不完整和记忆巩固不可靠是主要的限制机制。
递归自我改进(RSI)增强了现有的agent框架,提升了OSWorld 2.0和Agents' Last Exam Near-term上的部分准确率和二元准确率。使用GLM-5.3和Kimi-K3的RSIAgent取得了最高的部分得分,超越了GPT-6 Astra和Claude Opus 5等前沿模型。这些增益源于具有两阶段探索和记忆复用的多Agent框架,在不更新参数的情况下增强了开源模型。RSI将OSWorld的部分得分从71.97提升至78.98,二元准确率从37.80提升至42.68,在ALE上也有类似的提升。RSIAgent取得了最高的部分得分,在OSWorld上超出GPT-6 Astra 6.38分,在ALE上超出2.56分,同时也超越了Claude Opus 5。将多Agent协调框架与两阶段探索和记忆复用相结合,使得开源模型无需微调即可超越前沿系统。
RSIAgent在所有基础生成器上均能持续提升游戏质量,其中包含RSI经验的完整版本取得了最高分。Play2Code有助于较弱的基础游戏,但可能降低已经较强的游戏的质量,而RSIAgent对弱起点和强起点都有益。加入积累的RSI经验进一步提升了所有质量维度。带有RSI经验的RSIAgent在强和弱的基础生成器上均取得了最佳的整体质量。Play2Code改善了较弱生成器的游戏,但降低了已经较强的游戏的质量。不含RSI的RSIAgent已在所有指标上超越Play2Code和基线。融入RSI经验在机制、深度、视觉和美术方面带来了额外的提升。
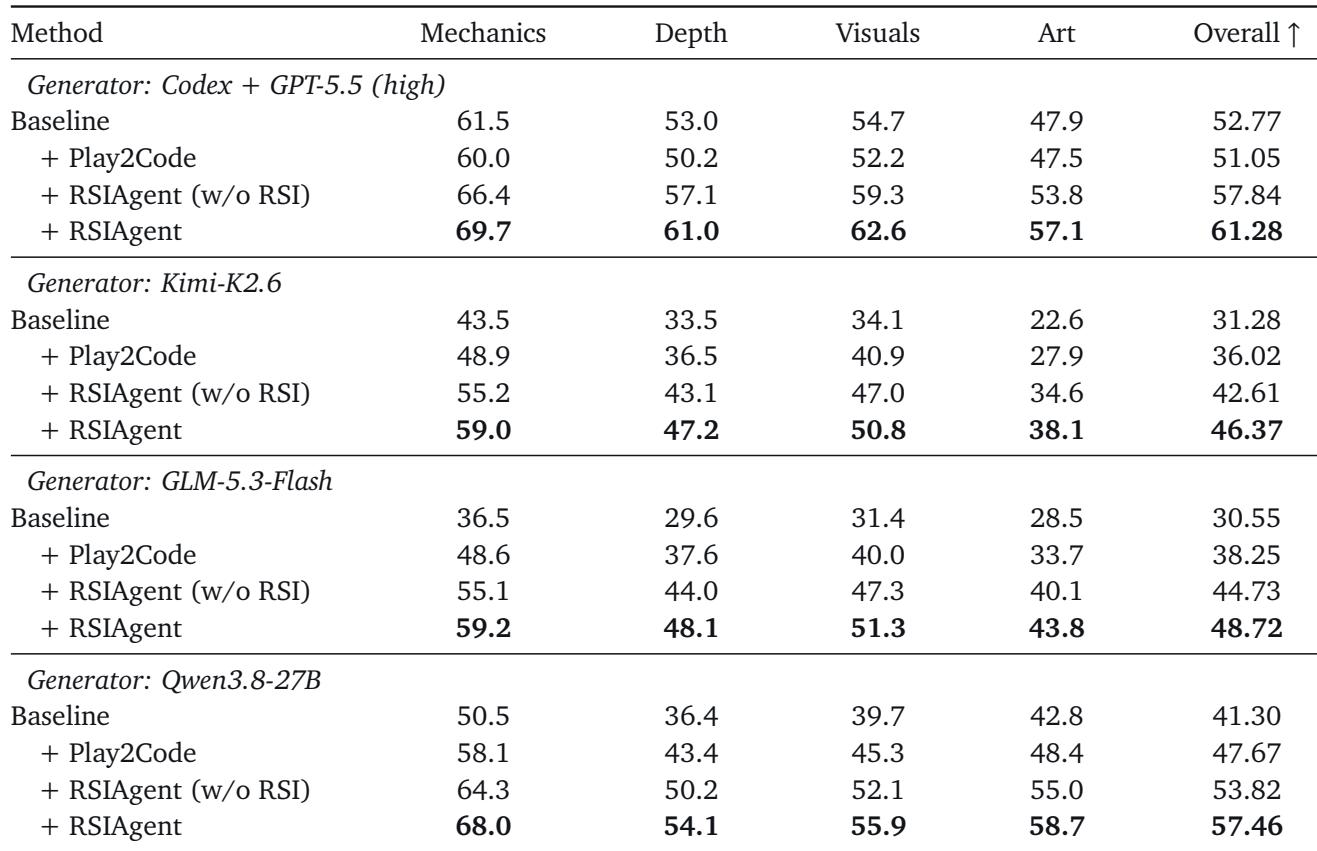
实验在OSWorld 2.0和Agents' Last Exam Near-term上评估了递归自我改进agent框架,并在游戏生成中使用了弱和强的基础生成器。使用GLM-5.3和Kimi-K3并采用两阶段探索和记忆复用的RSIAgent,提升了部分准确率和二元准确率,并在不更新参数的情况下取得了超越前沿模型的最高分。在游戏质量方面,RSIAgent持续提升所有基础生成器,而Play2Code有助于较弱生成器但可能降低较强生成器的质量,加入积累的RSI经验进一步提升了机制、深度、视觉和美术。总体而言,多Agent RSI框架让开源模型超越了前沿系统,并同时增强了弱起点和强起点。