Command Palette
Search for a command to run...
PhysBrain 1.5:从视觉-语言模型到物理基础模型
PhysBrain 1.5:从视觉-语言模型到物理基础模型
摘要
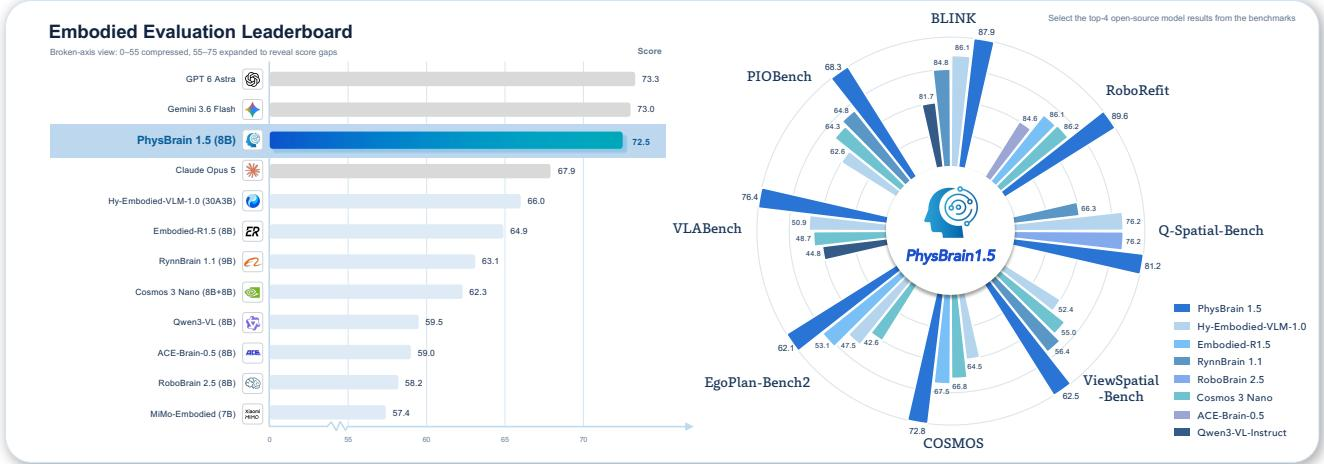
我们提出了 PhysBrain 1.5,一个用于理解物理环境、生成动作和预测未来状态的统一模型。受观察、交互和环境变化的物理循环启发,我们将这些能力整合到一个共同的学习框架中。从通用的视觉-语言模型出发,我们将语言响应、末端执行器运动和密集视觉目标编码为离散序列,并通过自回归下一标记预测进行联合优化。预训练完全从人类交互视频中获取具身监督,利用以任务为中心的片段将语义和空间上下文与恢复的运动及后续观察配对。随后,我们通过监督微调,在人类演示、机器人轨迹和模拟经验的混合数据上对模型进行适配。在 28 个具身理解基准测试中,我们的 8B 模型平均得分为 72.5,创下了开源模型的新纪录,并与 GPT-6-Astra 和 Gemini 3.6 Flash 等领先的专有模型表现相当。它在 14 个基准测试中取得了最佳开源结果,同时保留了通用的多模态能力。除了这些理解评估外,定性示例还展示了模型通过空间对齐的 RGB、深度和机器人掩码输出生成末端执行器轨迹和预测未来场景的能力。
一句话总结
DeepCybo 团队推出 PhysBrain 1.5,这是一个 8B 统一物理基础模型,通过自回归下一 token 预测,将语言、末端执行器运动与稠密视觉目标联合优化为离散序列,仅在人类交互视频上预训练,并在演示、机器人轨迹和仿真数据上微调,在 28 个具身基准上取得 72.5 的平均分,创下新的开源最优水平,与 GPT-6-Astra 和 Gemini 3.6 Flash 等专有模型相当。
核心贡献
- 提出 PhysBrain 1.5,一个统一模型,通过将语言响应、末端执行器轨迹和稠密视觉目标编码为离散 token,在单一自回归下一 token 预测目标下联合处理具身理解、动作生成和未来状态预测。
- 扩展了理解优先的方法,所有具身预训练监督均来自按任务中心片段组织的人类交互视频,随后通过人类、真实机器人和仿真数据的监督微调进行适配。
- 在 28 个具身理解基准上以 8B 模型取得 72.5 的平均分,创下新的开源最优水平,在 14 个基准上排名第一,并与专有模型 GPT-6-Astra 和 Gemini 3.6 Flash 表现相当,同时展示了末端执行器轨迹生成以及未来 RGB、深度和机器人掩码预测的定性结果。
引言
物理智能要求 agent 在环境中持续观察、理解、行动并重新评估,作者将此循环描述为物理闭环。先前工作通过面向视觉语言理解、空间推理和机器人控制的专用模型推进了这一目标,但这些能力通常是分开训练的,缺乏统一的学习目标。联合训练之所以困难,是因为监督信号差异很大:理解任务产生语言和坐标,动作生成需要时间结构化的运动,未来状态预测需要稠密视觉输出,且数据格式和粒度各不相同。
为解决这一问题,作者提出 PhysBrain 1.5,一个通过离散 token 统一具身理解、动作生成和未来状态预测的模型。作者将语言词表扩展出用于末端执行器轨迹的 ActionPiece token 和用于未来 RGB 图像、深度图及机器人掩码的视觉 token,所有 token 由共享的自回归骨干网络在统一的下一 token 预测目标下处理。预训练监督完全来自人类交互视频,包括第一人称和第一人称加第三人称同步录制,监督微调则加入人类、真实机器人和仿真数据。在 28 个基准上,8B 模型取得 72.5 的平均分,创下新的开源最优水平,并接近 GPT-6-Astra(73.3)和 Gemini 3.6 Flash(73.0)等专有系统。
数据集
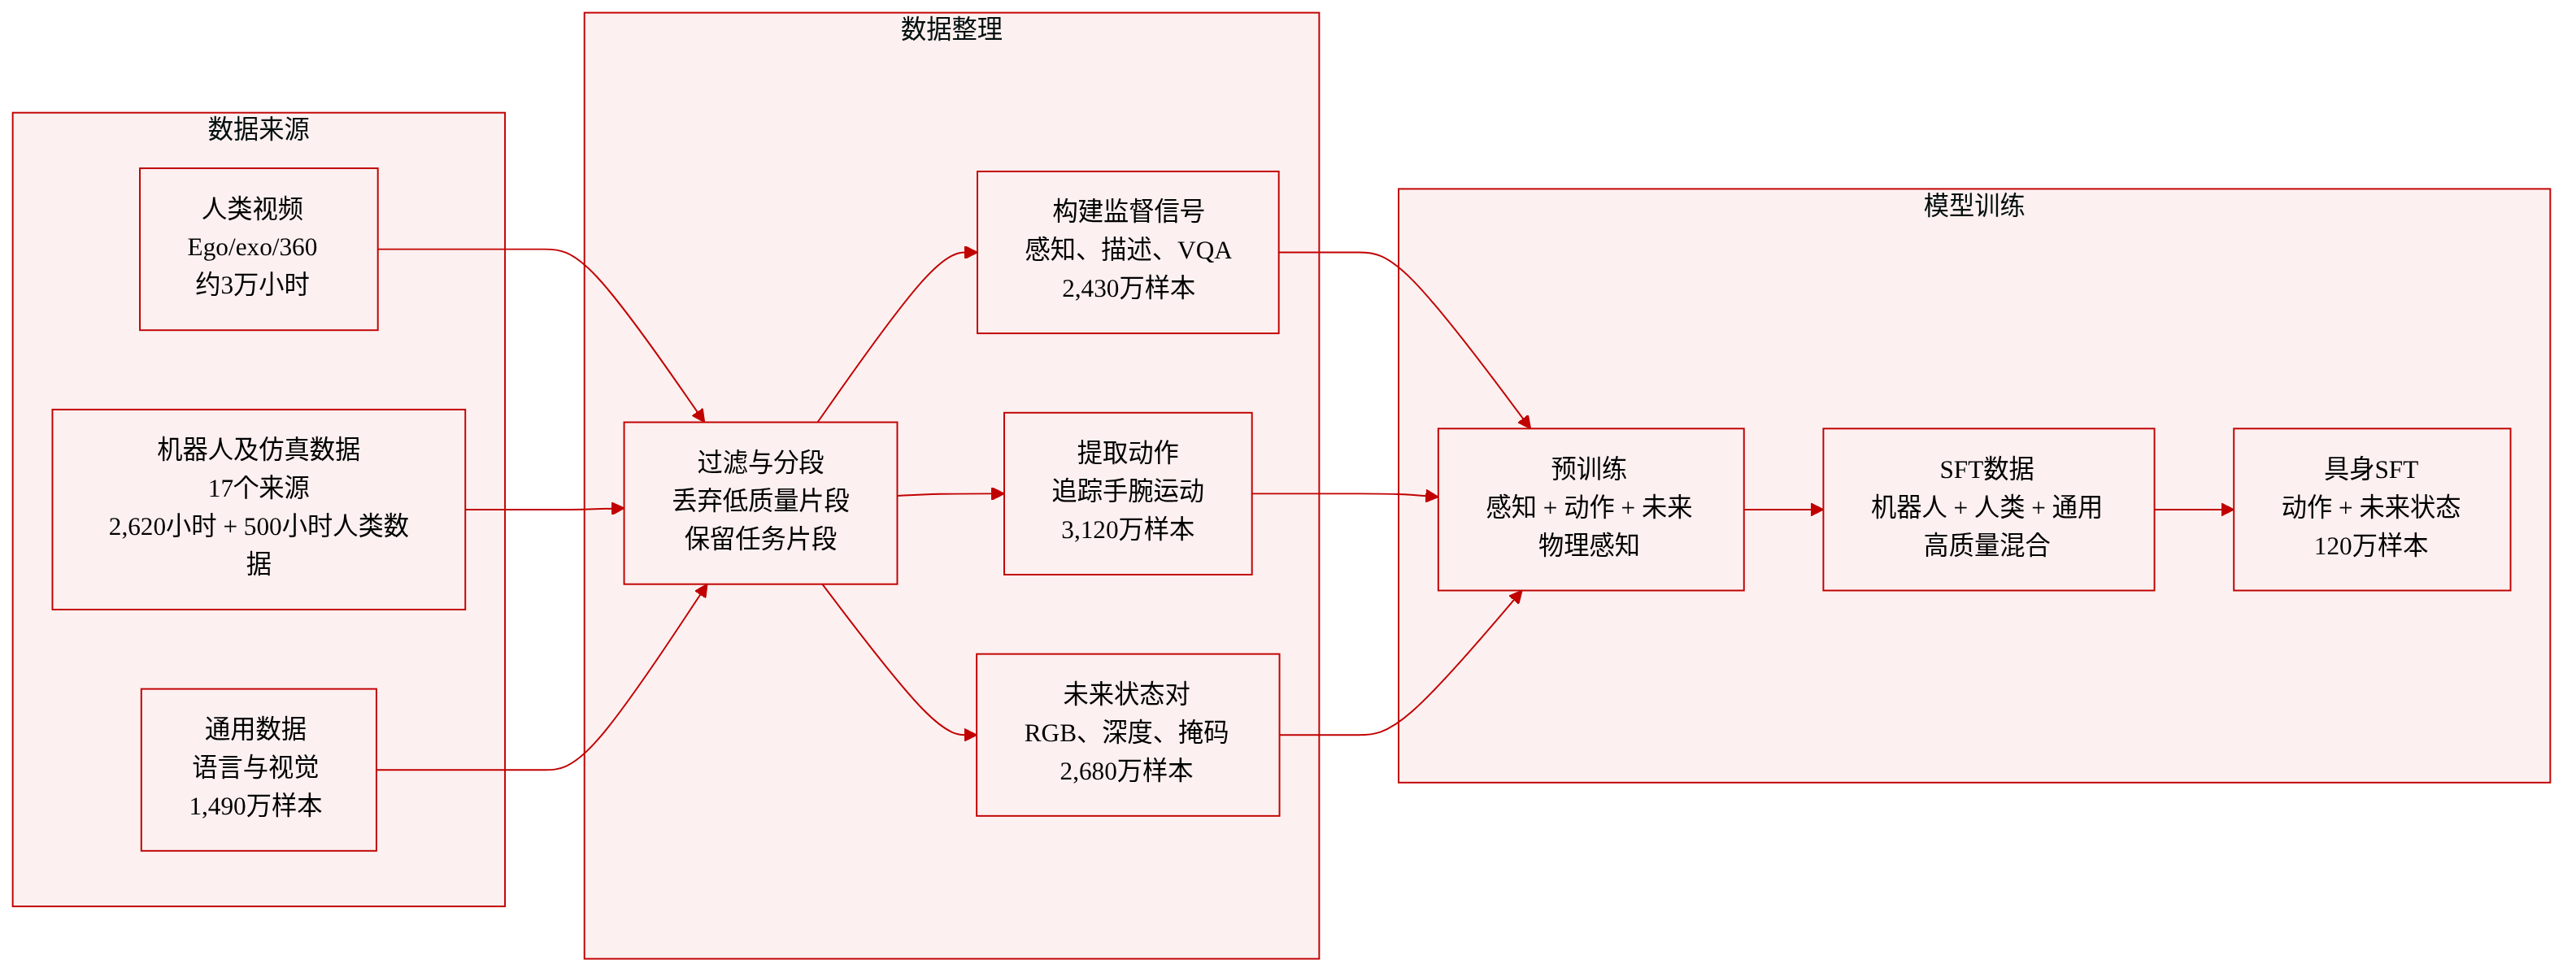
作者将训练数据组织为两个阶段:物理感知预训练和具身监督微调(SFT)。两个阶段均提供感知与理解、动作生成和未来状态预测的监督。物理感知预训练从大规模人类交互视频中派生这些监督类型。具身 SFT 复用预训练数据构建流程,并加入真实机器人和仿真环境交互,以在高质量数据上进行微调。
物理感知预训练数据
- 预训练语料整合了 Xperience-10M、Egocentric-10K、Ego4D、EgoVerse、EgoDex、EgoLife 和 Ego-Exo4D,以及两个内部语料:PhysBrain-Human(带同步第三人称视角的第一人称录制)和 PhysBrain-Ego360(带全身姿态、手部运动和任务级语音的全景视频)。
- 数据来源覆盖日常活动、工具使用、人机物交互和长时程任务,涵盖第一人称、第三人称和全景视角。
- 长视频按任务和动作边界进行切分,形成任务连贯的片段。存在运动模糊、曝光问题、损坏帧或交互遮挡的低质量片段被剔除。
- 整理后的语料包含约 30,000 小时视频,并从中构建三种训练数据类型。
物理感知数据
- 使用开源和内部模型从采样帧和片段中生成结构化标注、描述和问答对。
- 图像级监督涵盖目标检测、分割、深度估计、指认、计数和 3D 目标检测。视频级监督涵盖时间定位、时空定位和目标跟踪。
- 同步的第一人称、第三人称和全景录制支持跨视角目标对应和视角变化下的指代定位。
- 描述在帧级、片段级和情节级构建。帧级描述描述可见目标和场景属性;片段级描述将动作与操作对象及状态变化对齐;情节级描述总结环境、任务目标和进展。
- 对于 PhysBrain-Ego360,语音转写与视频证据结合,用于派生任务描述和步骤级描述。
- 物理 VQA 示例涉及任务识别、进展评估、动作理解、人机物交互、时间顺序和状态变化。
- 不一致的伪标签、描述和答案被剔除。最终语料包含 24.3M 训练样本。
人类动作数据
- 使用 Human-as-Humanoid 流程恢复人体运动,从运动链中派生腕部末端执行器轨迹。
- 时间对应关系将轨迹与任务描述和视觉观察关联起来。
- 视频被划分为短片段,每个样本保留动作片段、后续视觉观察和动作延续之间的时间关系。
- 姿态恢复不可靠、时间对应缺失或运动不合理的样本被剔除。语料包含 31.2M 训练样本。
人类交互未来状态数据
- 每个样本将交互前的场景上下文与后续物理状态配对,使用短视频片段。
- 未来状态目标包含空间对齐的 RGB 图像、深度图和人部分割掩码。RGB 图像取自目标时间戳的视频帧;深度和分割掩码由感知流程生成。
- 对时间偏移、图像完整性、深度有效性和跨模态空间对齐进行验证。不匹配或数据缺失的样本被丢弃。语料包含 26.8M 训练样本。
通用指令数据
- 预训练还包含 14.9M 通用语言和视觉语言指令样本。
- 语言来源包括 FLAN Collection、UltraChat、OpenAssistant Conversations、UltraData-SFT-2605 子集、MetaMathQA 和 Magicoder-OSS-Instruct。
- 视觉语言来源包括 FineVision、LLaVA-OneVision-1.5-Instruct-Data、Cambrian-7M、PixMo、ShareGPT4Video 和 LLaVA-Video-178K。
- 在能力感知采样前执行跨来源去重。
具身监督微调数据
- SFT 语料结合了高质量人类交互数据、真实机器人轨迹和仿真交互。
- 包含 1M 高质量通用语言和视觉语言指令样本,以在具身适配期间保持广泛能力。
具身理解数据
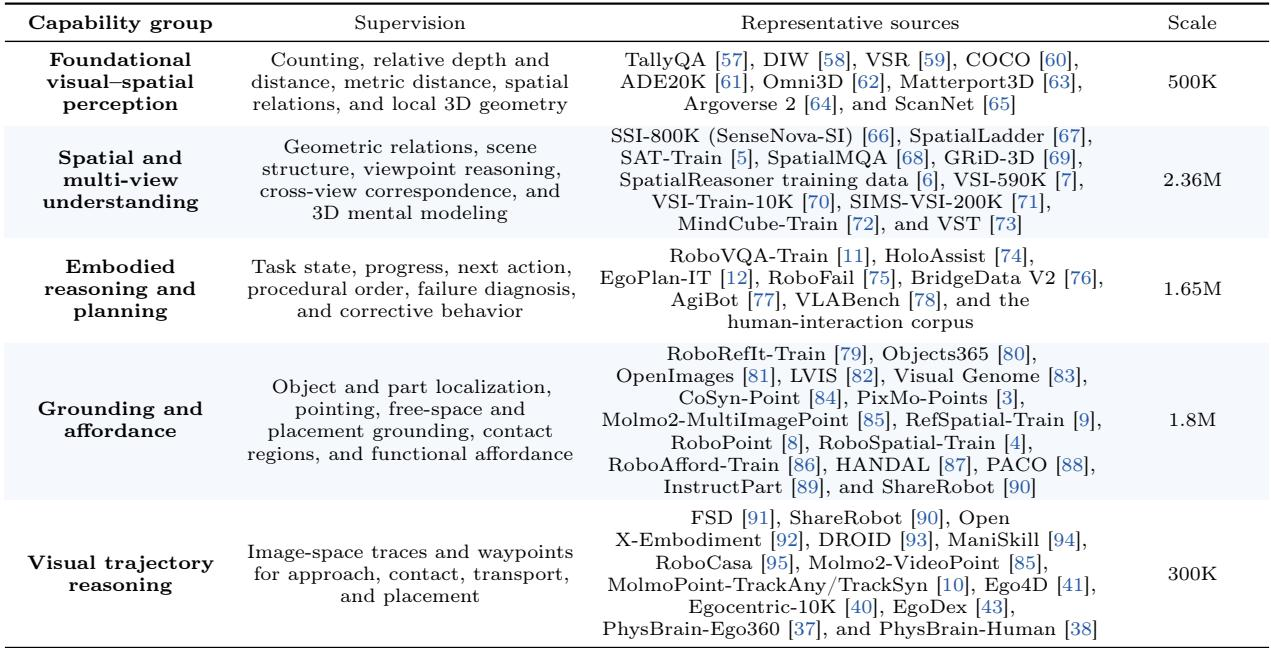
- 表 2 中的数据集按标注类型分组,原生标注被转换为指令格式的语言或空间目标。
- 示例涵盖计数、深度和距离判断、空间关系和目标定位,采用问答、描述或结构化空间预测格式。
- 空间和多视角示例保留原始图像、视频、相机和场景组织。
- 定位和视觉轨迹数据使用统一的归一化空间格式,用于点、框、区域和图像空间路径点。
具身动作数据
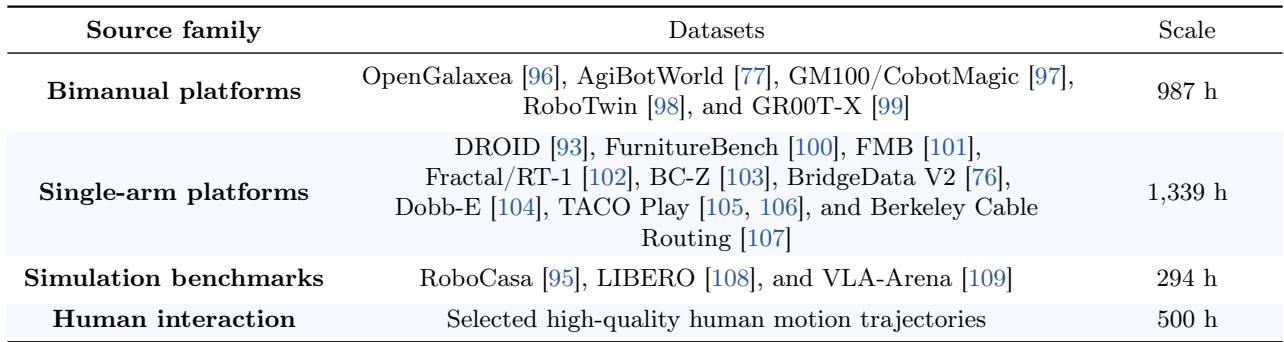
- 轨迹来自 17 个真实机器人和仿真来源,外加高质量人类运动数据,覆盖多样化的本体、视角、任务和运动分布。
- 原始集合包含约 2,620 小时真实机器人和仿真轨迹,以及 500 小时人类运动数据。
- 各来源在动作语义、物理单位和时间采样上存在差异。作者统一了单位和夹爪约定,同时保留经审计的原生坐标轴。
- 人类数据复用 Human-as-Humanoid 流程,保留姿态恢复可靠且对齐良好的序列。
- 低采样率来源被重采样以提高时间分辨率,而不改变样本锚点或来源权重。
- 轨迹使用 FrameSkip 中的运动信息量准则进行过滤。无信息片段被降采样,新运动片段被保留,静止片段被选择性保留。
- 每个样本包含任务描述、视觉观察、本体元数据、动作频率和时间对齐的运动轨迹。划分在情节级别构建。
具身未来状态数据
- 基于动作语料中使用的真实机器人和仿真轨迹构建,将任务描述和当前观察与后续目标帧关联。
- 时间戳和原生帧率建立时间对应关系;目标帧来自同一连续交互序列。
- 每个目标包含空间对齐的 RGB 图像、使用 MoGe-2 生成的度量 z 深度图,以及使用 RoboEngine 获得的机器人本体掩码。分割覆盖机器人本体,扩展了预训练中使用的人类手和手臂标注。
- 对完整性、时间偏移、深度有效性和空间对应关系进行检查。语料包含 1.2M 训练样本。
方法
作者提出 PhysBrain 1.5,一个基于 Qwen3-VL Instruct 系列构建的统一模型,扩展预训练视觉语言模型以联合处理物理感知、交互和状态转换。核心架构设计将语言、末端执行器运动和视觉状态目标表达为离散序列,通过单一自回归接口进行学习。
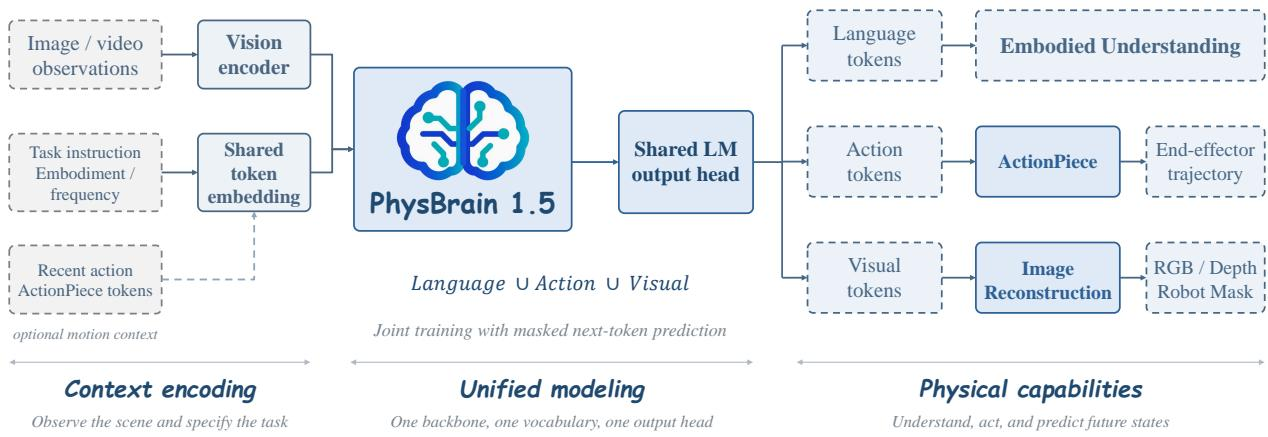
如框架图所示,模型通过共享语言模型骨干网络、token 嵌入和输出头来统一生成表示。原始语言词表被扩展出专用的动作 token 和视觉 token 集合,形成统一词表,定义为:
V=Vlang∪Vact∪Vvis这一公式使理解和生成的联合训练成为可能。感知监督为预测交互及其后果提供上下文,而动作和状态转换监督引入物理先验,支持空间定位和轨迹推理。给定视觉输入、指令和任务相关上下文 x 以及目标序列 y,模型使用掩码下一 token 预测进行优化:
pθ(y∣x)=i=1∏∣y∣pθ(yi∣x,y<i),LAR=−i=1∑∣y∣milogpθ(yi∣x,y<i)其中 mi 选择被监督的目标 token。任务格式和损失掩码决定模型输出自然语言、动作轨迹还是视觉状态序列,而底层预测目标保持不变。
对于具身动作生成,作者通过 Human-as-Humanoid 流程将人体运动转换为机器人动作表示,保留腕部位置和方向。每个动作被建模为长度为 H=16 的短末端执行器轨迹块。相对方向使用连续 6D 表示编码,动作目标结合相对平移、相对旋转和绝对夹爪开合。这些连续轨迹使用 ActionPiece tokenizer 进行离散化,将腕部轨迹编码为离散动作 token 序列。为处理不同数据集中的异构坐标帧和运动约定,模型利用紧邻的前一动作块作为局部运动上下文。这使得自回归解码器能够推断局部动作约定并自然延续轨迹,而无需全局归一化的坐标帧。
对于视觉基础生成,未来物理状态被建模为 RGB 图像、深度图和机器人掩码的空间对齐组合。三种模态使用共享的 VQ-VAE 在 128×128 目标分辨率下进行 token 化,产生与原子 VLM token 一一对应的离散编码。各模态在空间位置上按 RGB-深度-掩码顺序交错排列,使对应空间位置的 token 相邻,从而在自回归生成期间提供局部跨模态上下文。推理时,生成的负载被去交错并使用冻结的 VQ 解码器重建为各模态。
训练过程分两个阶段:物理感知预训练和监督微调。两个阶段均在统一自回归目标下联合优化文本生成、动作 token 生成和未来视觉状态生成。作者使用分布式 Adam 优化器和余弦学习率调度,每个阶段训练一个 epoch,并按样本数量比例混合数据类别。
实验
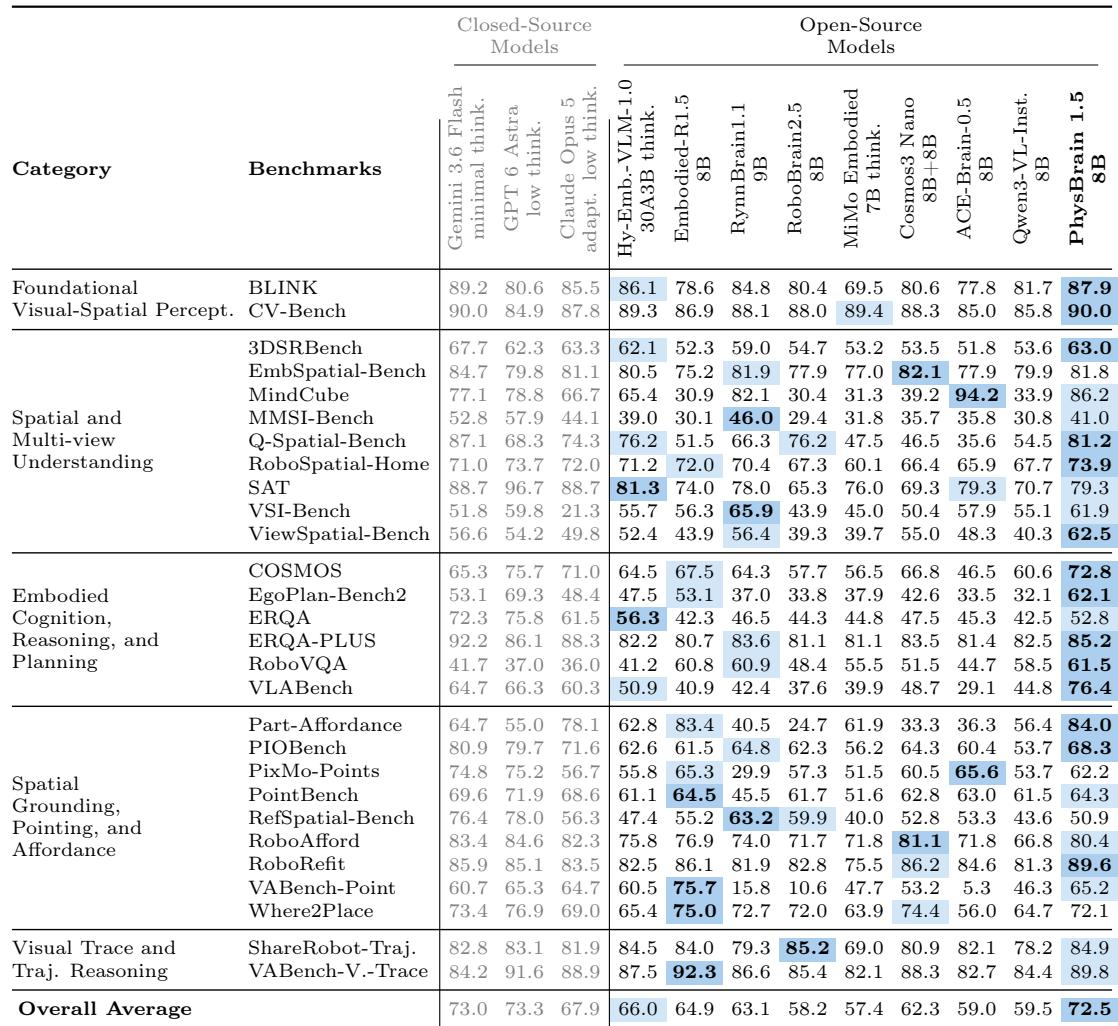
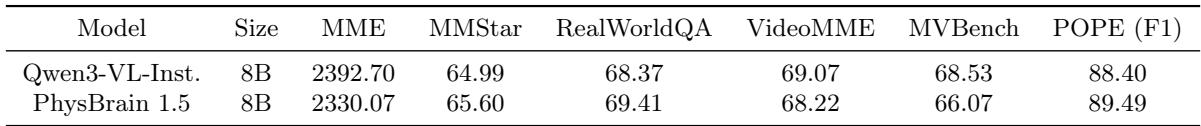
PhysBrain 1.5 在 28 个具身基准上进行了评估,涵盖感知、空间推理、规划、定位和轨迹理解,在开源具身模型中取得最高平均分(72.5),并在所有基准上优于其基础模型,同时接近专有领先模型。通用多模态理解在 12 个标准基准上评估,表现与基础模型相当,确认具身特化不会损害广泛的感知和推理能力。在理解之外,模型展示了动作轨迹 token 预测能力,在分布内和分布外场景中均能跟随参考运动趋势,并能预测 RGB、深度和机器人掩码的未来视觉状态,在保持场景布局的同时反映合理的任务进展。
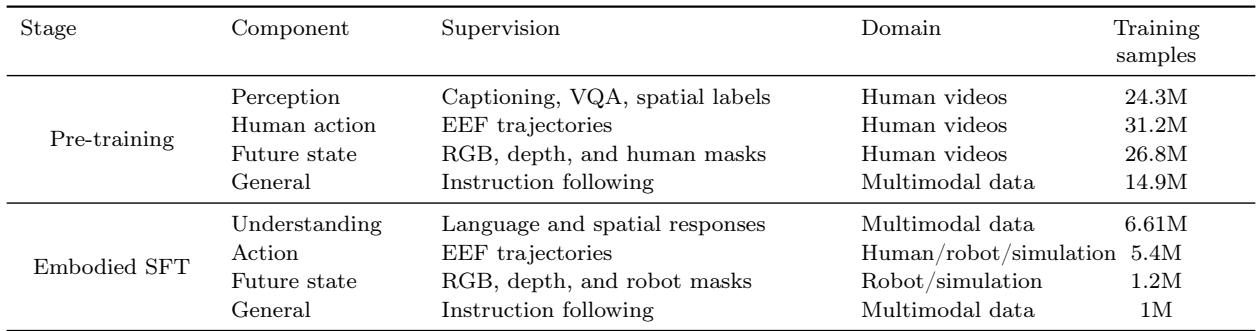
训练数据组织为两个阶段,物理感知预训练和具身监督微调,每个阶段涵盖感知、动作和未来状态监督。预训练依赖大规模人类交互视频,而具身 SFT 在精选人类数据之外加入真实机器人和仿真数据。两个阶段均包含通用语言和视觉语言指令数据。预训练使用人类视频提供所有三种监督类型,其中动作数据占比最大。具身 SFT 以多模态理解数据为最大组成部分,其次是来自人类、机器人和仿真来源的动作数据。具身 SFT 中的未来状态监督仅来自机器人和仿真数据,与使用人类视频的预训练不同。通用指令数据包含在预训练中,但未列入具身 SFT,后者更强调具身特定的理解和动作数据。
具身理解数据集按五个能力组组织,每组具有不同的监督类型和代表性来源,总计超过 660 万训练样本。最大组为空间和多视角理解,视觉轨迹推理最小,体现了感知、推理、定位和动作相关任务之间的刻意平衡。空间和多视角理解是最大的能力组,包含 2.36M 样本,聚焦几何关系和视角推理。基础视觉空间感知包括计数、深度和空间关系,来源于 COCO 和 ScanNet 等数据集,共 500K 样本。定位和可供性数据为 1.8M 样本,使用 RoboRefIt 和 Visual Genome 等来源覆盖目标定位和功能可供性。视觉轨迹推理是最小组,为 300K,强调接近和放置动作的图像空间轨迹。所有标注均转换为指令格式的语言或空间目标,并经过语义和几何可靠性过滤。
具身动作语料结合了真实机器人和仿真轨迹与高质量人类运动数据,总计超过 3,000 小时。数据涵盖多种平台类型,包括双臂、单臂、仿真和人类交互来源,规模和语义各异。该语料用于监督微调,以支持多样化的本体和任务。语料包含 2,620 小时真实机器人和仿真轨迹,以及 500 小时人类运动数据。双臂平台贡献 987 小时,单臂平台贡献 1,339 小时,是最大的来源家族。仿真基准增加 294 小时,人类交互数据增加 500 小时,覆盖多样化的本体和任务。各来源数据集在动作语义、物理单位和时间约定上存在差异,需要标准化和过滤。
PhysBrain 1.5 作为 8B 开源模型,在具身理解基准上取得开源模型中的最高总体平均分,超过最强开源基线 6.5 分。它在 14 个基准上排名第一,在 24 个基准上进入前二,并在全部 28 个基准上优于其基础模型。在五个能力类别中,它始终位列开源模型前二,接近领先专有模型的性能。PhysBrain 1.5 在开源模型中取得最高总体平均分,得分 72.5。它超过最强开源基线 6.5 分,并在 14 个基准上排名第一。模型在全部五个能力类别中均位列开源模型前二,包括感知、空间推理、规划、定位和轨迹理解。尽管规模仅为 8B,它接近 Gemini 3.6 Flash 和 GPT-6-Astra 等领先专有模型的性能。
PhysBrain 1.5 作为 8B 模型,在图像、视频和幻觉鲁棒性基准上保持与其基础模型 Qwen3-VL-Instruct(8B)相当的通用多模态理解能力。它在 MMStar、RealWorldQA 和 POPE 上略有提升,在 MME、VideoMME 和 MVBench 上略有下降。PhysBrain 1.5 在 MMStar、RealWorldQA 和 POPE 上得分高于基础模型,表明视觉推理更强、目标幻觉更低。模型的 MME、VideoMME 和 MVBench 得分略低于基础模型,但总体表现仍然相当。结果表明,具身后训练不会牺牲广泛的多模态理解能力,模型在通用基准上保持了强劲表现。
评估涵盖两阶段训练流程(物理感知预训练和具身监督微调),使用多样化数据来源,包括人类视频、真实机器人轨迹和仿真数据。具身理解数据集跨越五个能力组,超过 660 万样本,动作语料总计超过 3,000 小时,覆盖多个平台。结果表明,PhysBrain 1.5 作为 8B 模型,在具身理解基准上领先开源模型(平均 72.5,较最强基线提升 6.5 分),同时保持与其基础模型相当的通用多模态性能,并在视觉推理和幻觉鲁棒性上略有提升。总体而言,实验验证了具身后训练在不牺牲广泛多模态理解的前提下增强了任务特定能力。