Command Palette
Search for a command to run...
深度玻尔兹曼机中用于统计数据融合的跨块条件作用
深度玻尔兹曼机中用于统计数据融合的跨块条件作用
Junichiro Niimi
摘要
统计数据融合将两个共享一组协变量但观测不相交结果块的面板结合起来,在其传统形式中,没有一行同时观测到两个结果。这排除了人们原本希望用来训练深度玻尔兹曼机(Deep Boltzmann Machine)的判别准则,因为多预测训练需要为其所保留的任何部分提供真实值。我们提出了观测块多预测方法,该方法将多预测目标限制在从每一行实际观测到的数据中抽取的目标上。它对任何缺失模式都有良好定义,并在行数据完整时退化为原始准则。拥有一个在该设定下依然有效的判别准则,使我们能够通过将联合模型的贡献分解为表示部分和推理部分,来探究联合模型是否真的必要。在两个消费者面板上,在覆盖样本量和协变量宽度的网格上,跨越 35 个单元格和 875 次运行,经过微调的 DBM 在每个单元格中都是十五种方法中表现最好的;但这一优势几乎完全不是来自生成式预训练,生成式预训练的作用仅限于一个数据集上的最小样本量情况,在另一个数据集上则完全不存在。优势来自于在预测一个结果块时以另一个结果块为条件。这一项的贡献为 +0.19 和 +0.07 个百分点,在所有 35 个单元格中均为正值,并且与我们测量的所有其他贡献不同,它既不随面板增大而衰减,也不需要第二个隐藏层,也不需要更多的推理步骤。打乱一个结果块以破坏其与另一个结果块的关联,会完全消除这一增益,这与我们的解释所预测的一致。这些提升幅度很小。但是,一个不衰减的小效应与一个会衰减的效应是截然不同的,因为它建立在任何仅从协变量映射到结果的模型都无法接受的证据之上。
一句话总结
名城大学的研究者在统计数据融合中为深度玻尔兹曼机引入了观测块多重预测,结果表明,在从另一个结果块预测一个结果块时使用跨块条件化,在所有样本量和协变量宽度下都能提供微小但持续的正增益(+0.07–0.19 个百分点),这与生成式预训练形成对比,后者的收益会衰减。
核心贡献
- 观测块多重预测(OBMP)被提出作为一种判别式训练准则,它将多重预测限制在每行实际观测到的目标上,使其在具有不相交结果块的数据融合中定义明确,并在行完整时退化为标准准则。
- 在两个消费者面板的35个网格单元和875次运行中,使用OBMP微调的深度玻尔兹曼机优于15种方法。分解表明,优势来自跨块条件化项(贡献+0.19和+0.07个百分点,在所有单元中均为正),而非来自生成式预训练。
- 跨块项不随样本量或模型深度而衰减,并且是纯判别式模型在结构上无法获得的,这澄清了联合模型在数据融合中的独特贡献在于:在预测一个结果块时能够以另一个结果块为条件。
引言
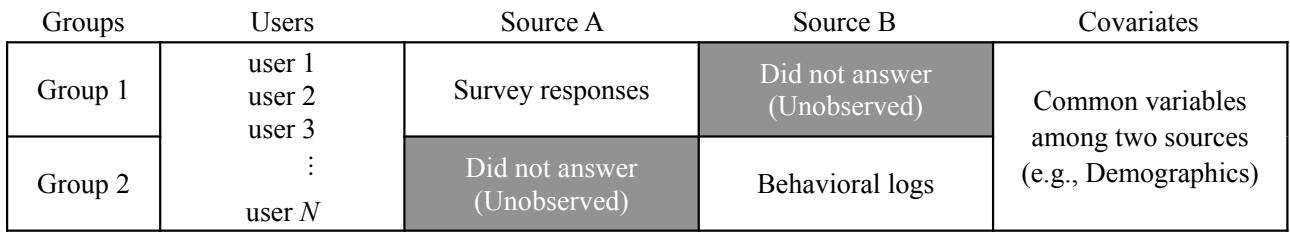
近期基于能量的模型的复兴重新点燃了对深度玻尔兹曼机(DBM)的兴趣,这是一种经典的深度EBM,其原生处理部分观测的能力使其天然适合统计数据融合。在此设置中,两个面板共享一个共同的协变量块,但从未同时观测到两个结果块,因此任何联合分布模型都必须在没有配对样本的情况下学习关联。先前的工作要么依赖对缺失维度进行边缘化的生成式训练目标,这会产生较弱的预测器,要么依赖判别式多重预测训练,这需要观测到的目标,因此当没有行同时包含两个结果块时无法实现。作者通过引入观测块多重预测(OBMP)填补了这一空白,这是一种判别式准则,将目标限制在每行实际观测到的内容上,从而使DBM能够在融合场景下进行判别式训练。他们进一步分解了模型的优势,表明持续的增益来自在预测一个结果块时以另一个结果块为条件,这是一种纯判别式模型无法复制的结构性优势。
数据集
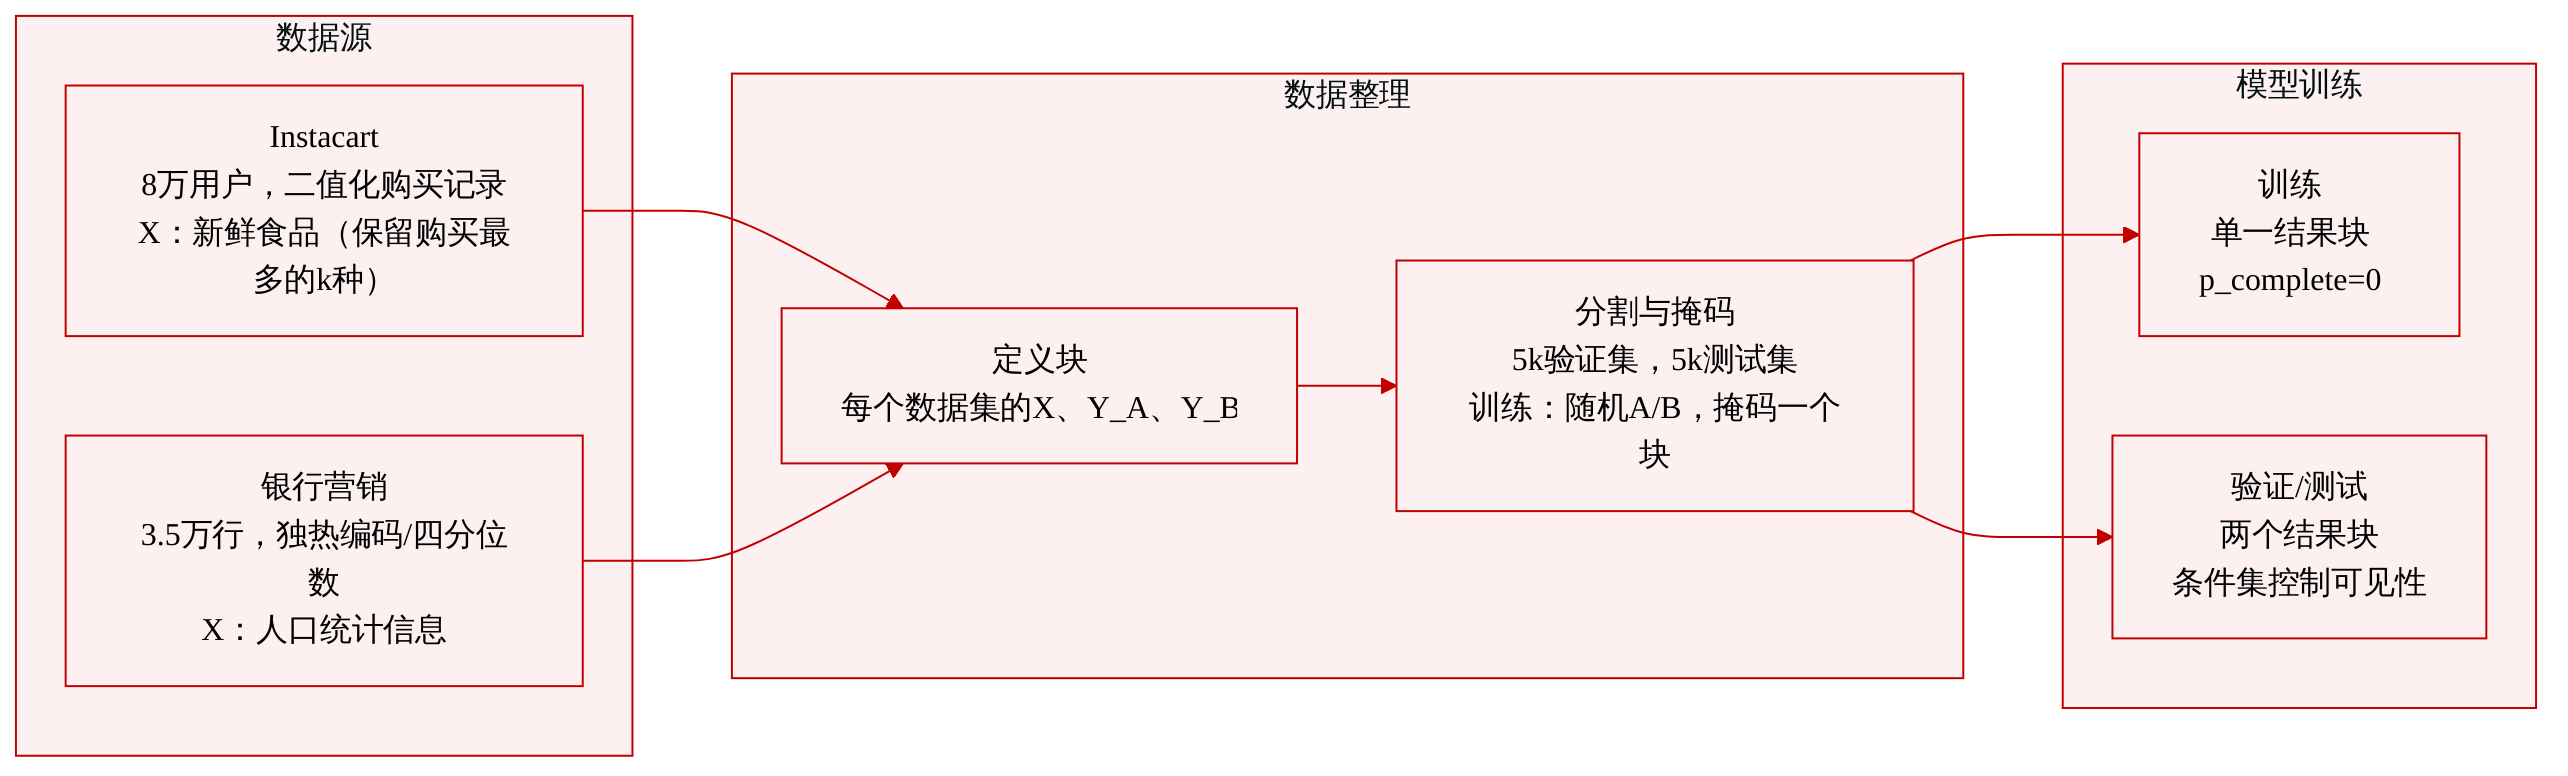
作者使用了两个具有特意不同块几何结构的数据集来评估融合设置。两者都被划分为三个块:一个可见块 X 和两个结果块 Y_A 和 Y_B。没有训练样本会同时看到两个结果块;验证和测试样本保留两者用于评分。
-
Instacart(在线杂货面板)
- 来源:在货架通道级别二值化的购买指标,取自80,000名用户池。
- 块组成:
- X:生鲜食品部门(农产品、乳制品/鸡蛋、饮料、烘焙、肉类/海鲜)。仅保留购买量最高的 k 个通道;其余直接丢弃,而不移至结果块。
- Y_A:常温食品部门(食品储藏、冷冻、零食、早餐、罐头食品、干货、熟食),53维。
- Y_B:非食品部门(个人护理、家居、婴儿、宠物、酒类、国际、散装、其他),46维。
- 总可见维度:k + 99。
- 划分:从80,000名用户池中留出5,000名验证用户和5,000名测试用户。
-
Bank Marketing(电话营销记录)
- 来源:一个包含35,000行的非行为面板,其块几何结构大致与Instacart相反。
- 所有变量均为独热编码或四分位数编码。
- 块组成:
- X:人口统计信息(年龄四分位数、职业、婚姻状况、教育程度)。
- Y_A:财务状况(违约标记、余额四分位数、住房和个人贷款),7维。
- Y_B:活动联系历史(联系渠道、日期/季节、通话时长四分位数、联系次数和先前联系次数、先前结果、订阅标记),29维。
- 总可见维度:k + 36。
- 划分:5,000行验证和5,000行测试。
-
训练中的数据使用
- 每个训练行以0.5的概率随机分配到源A或源B,并相应进行掩码(仅观测到一个结果块)。
- 一行同时观测到两个结果块(完整行)的概率设为零;这正是促使OBMP准则的场景。
- 验证和测试行保留两个结果块,但条件化集合控制在预测时允许模型看到哪个块。
方法
作者提出了一种针对数据融合场景的深度玻尔兹曼机(DBM)微调策略,其中没有训练行被完全观测。核心思想是观测块多重预测(OBMP)准则,它将判别式训练信号限制在真正观测到的条目上,使得即使整个结果块缺失,每一行也能贡献梯度。该方法包含一个两阶段流程:掩码感知的生成式预训练阶段,随后是OBMP微调,两者使用相同的DBM架构和可微的展开平均场推断过程。
DBM定义为一个可见层 v∈{0,1}Dv 和 L 个隐藏层 h(1),…,h(L),每个均为二元向量。联合能量遵循标准的伯努利-伯努利参数化:
E(v,h(1:L);θ)=−a⊤v−v⊤W(0)h(1)−l=1∑L−1h(l)⊤W(l)h(l+1)−l=1∑Lb(l)⊤h(l),参数为 θ={a,b(1:L),W(0:L−1)}。每个训练样本 i 携带一个二元观测掩码 mi∈{0,1}Dv,其中 mij=1 表示可见维度 j 被观测到。在数据融合中,可见维度划分为三个块:每行都观测到的公共协变量块 X,以及在不相交面板中观测到的两个结果块 YA 和 YB。因此 v=(x,yA,yB),一行的掩码要么是 1X+1YA(源A),1X+1YB(源B),或者对于完整行是全1向量。关注的情景是 pcomplete=0,即没有行同时包含两个结果块。
第一阶段:生成式预训练。 首先使用掩码感知的边缘对数似然训练模型,该似然对任何观测模式均有良好定义:
Lo(θ)=i∑logpθ(viobs)=i∑logvimiss,hi∑exp(−E(vi,hi;θ))−ntrainlogZ(θ).缺失的可见维度被求和消除,因此该准则是纯生成式的,不区分协变量和结果。梯度通过因子化平均场后验近似正相位,并使用持续对比散度近似负相位:
∇θLo(θ)≈−i∑Eqi[∇θE(vi,hi;θ)]+ntrainEp~θ[∇θE(v,h;θ)].可见偏置由在 mij=1 的条目上计算的观测边缘分布初始化,因为不存在用于逐层预训练的完整子集。得到的模型称为ML-DBM,作为第二阶段的初始化。
观测块多重预测(OBMP)。 原始的多重预测DBM(MP-DBM)随机抽取可见维度的子集作为预测目标,并要求这些条目具有真实值,当一行缺少整个结果块时这是不可能的。OBMP通过将目标限制在观测集上来克服这一点。对于每一行,引入两个二元掩码:条件掩码 ci 标记提供给推断的条目,目标掩码 ti 标记其已知值定义损失的条目,满足
ci⊙ti=0,ti⪯mi.第一个约束防止目标被用作证据;第二个确保每个目标都是真正观测到的。既不被条件化也不被作为目标的条目被边缘化。
令 μ(v)(ci)∈[0,1]Dv 表示当 ci 选择的条目被钳位到其观测值时,平均场过程返回的可见边缘分布。OBMP准则为每行归一化的二元交叉熵:
LOBMP(θ)=∣I∣1i∈I∑∑jtij∑jtijℓ(μij(v)(ci),vij),其中 ℓ(p,y)=−ylogp−(1−y)log(1−p),I={i:∑jtij>0}。内部归一化使每一行无论贡献多少目标都获得相等权重,防止具有更宽结果块的面板主导梯度。实践中,μ(v) 在取对数前被钳位到 [ε,1−ε]。
OBMP是MP-DBM的严格推广:当所有行完整且掩码为随机互补时,两个准则一致。关键的是,由于目标从每行实际观测的内容中抽取,即使 pcomplete=0,每一行也能贡献梯度。
在一般情况下,掩码通过随机分割观测集获得:为每行抽取一个保留概率 πi∼U(πmin,πmax),每个观测条目以概率 πi 独立保留以形成 ci,其余成为目标:
ci=mi⊙ρi,ti=mi−ci,ρij∼Bern(πi).数据融合实例化。 对于融合设置,作者将随机分割替换为反映部署模式的确定性分割。他们以公共块 X 为条件,并将每个观测到的结果作为目标:
ci=1X,ti=mi−1X=mi⊙(1YA+1YB).因此,源A行以 YA 为目标,源B行以 YB 为目标,完整行以两者为目标。这种选择使准则在数据融合的缺失机制下可识别:缺失由源指示符决定,在给定 X 的条件下与结果值独立,因此目标在源A行上为 p(yA∣x),在源B行上为 p(yB∣x),两者均可从观测数据中识别。训练期间从不要求联合分布 p(yA,yB∣x)。
可微的平均场展开。 为使 μ(v) 对 θ 可微,作者将平均场推断展开固定次数 T,并通过整个计算进行反向传播。初始化钳位条件化条目,其余由可见偏置设置,然后向上传播:
μ(v),0μ(l),0=c⊙v+(1−c)⊙σ(a),=σ(μ(l−1),0W(l−1)+b(l)),l=1,…,L,其中 μ(0),τ:=μ(v),τ。随后的每次传递 τ=1,…,T 从第一个隐藏层更新可见边缘分布,重新钳位条件化条目,并自底向上扫描隐藏层:
μ(v),τμ(l),τμ(L),τ=c⊙v+(1−c)⊙σ(μ(1),τ−1W(0)⊤+a),=σ(μ(l−1),τW(l−1)+b(l)+μ(l+1),τ−1W(l)⊤),l=1,…,L−1,=σ(μ(L−1),τW(L−1)+b(L)).自上而下的项使用前一次传递的边缘分布,因为扫描是自底向上的。条件化条目从不更新,因此每次传递的钳位都是精确的。最终的可见边缘分布 μ(v):=μ(v),T 用于OBMP损失。由于展开是仿射映射和逻辑非线性的组合,损失的梯度流经所有 T 次传递,为测试时使用的推断过程训练参数。
两阶段训练流程。 第一阶段通过在所有训练行上优化生成式准则(4)来拟合ML-DBM。第二阶段从第一阶段参数初始化,并使用融合分割(13)最小化OBMP准则(6),根据验证性能选择检查点。模型架构和平均场过程保持不变;仅训练目标从生成式转向判别式。
推断时的条件化。 单个OBMP检查点支持多种条件化模式。在跨块条件化中,为预测 YA,模型钳位该行观测到的其他所有内容,包括 YB:c=1X+1YB。对称地,预测 YB 使用 c=1X+1YA。在仅X条件化中,两个结果块均隐藏:c=1X,与训练条件化一致。这两种模式之间的差距隔离了在预测一个结果块时以另一个结果块为条件的价值,这一量完全由联合模型的生成式结构提供,因为两个块在训练期间从未被一起观测到。
实验
实验在两个数据集上评估用于数据融合的联合模型(OBMP),改变训练集大小和共享协变量宽度,并将其与判别式基线和插补方法进行比较。主要优势源于推断时的跨块条件化,它利用结果块之间的关联来改进预测,且这一贡献保持为正且不随样本量衰减。生成式预训练仅提供暂时的收益,随着更多数据可用而消失,并且跨块效应不依赖于深层架构,使其成为仅依赖共享协变量的模型无法获得的结构性优势。
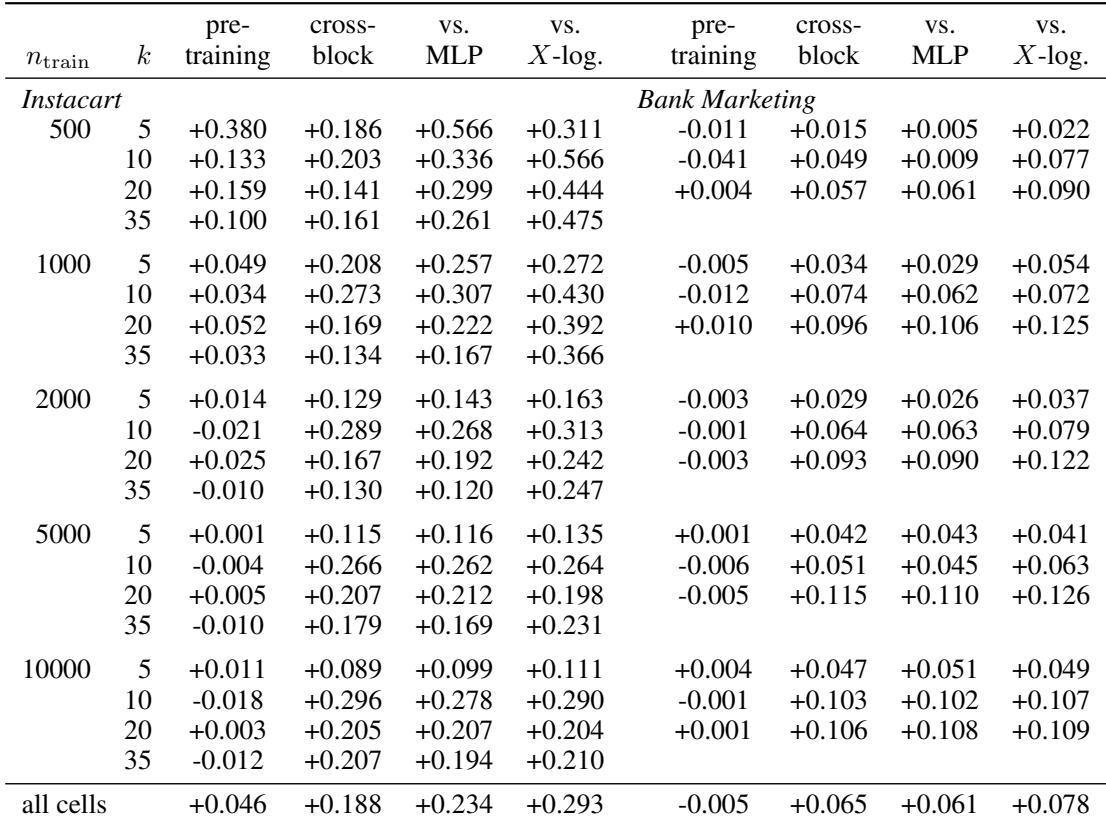
在具有两个结果块的统计数据融合任务中,大多数相对于基线的性能提升随着训练数据增加而缩小。然而,跨块项保持稳定,表明它捕获了仅将协变量映射到结果的模型无法访问的结构信息。整体效应较小,但其不衰减的性质使其与其他逐渐减小的边际区分开来。跨块项不随更多训练数据而缩小,而其他增益会衰减。在一个结果块上,基线模型无法超越常数预测器,几乎没有改进空间。
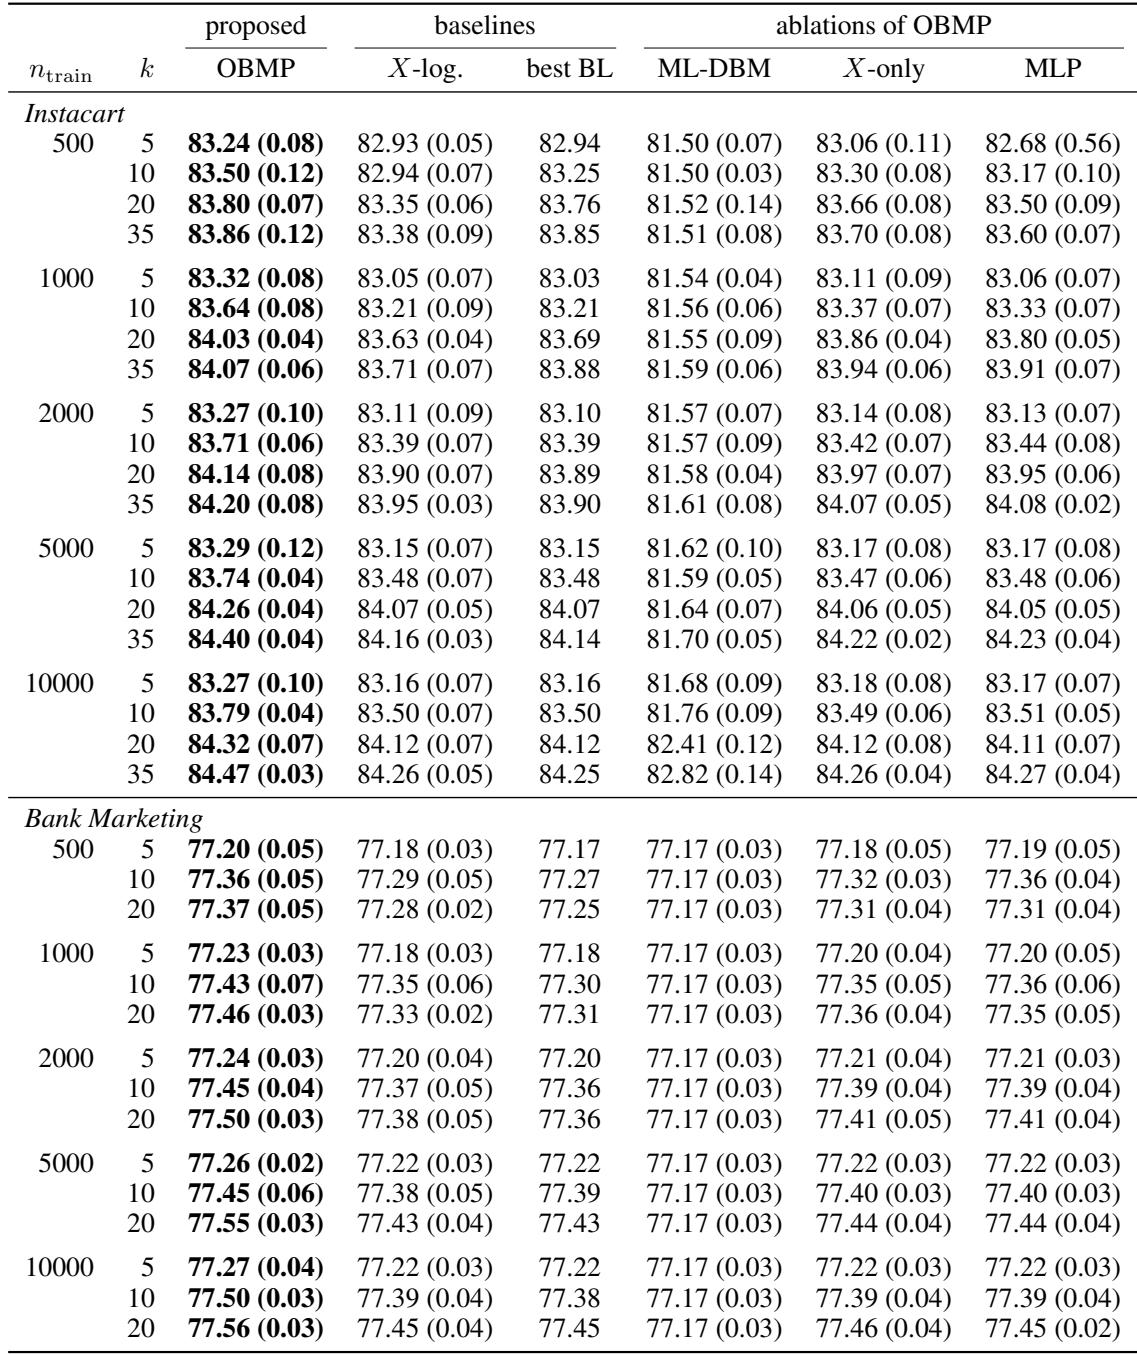
在两个数据集上,跨块条件化的OBMP在所有训练规模和协变量集合下均达到最高的组合准确率。其相对于基线和消融实验的优势在低资源设置下最大,并随着训练数据增长而缩小,但从未逆转。单独的生成式模型表现接近常数基线,确认增益源于跨块条件化而非生成式阶段。跨块条件化的OBMP在每个单元中都是最佳方法,在最小训练规模下优势最大。跨块条件化始终优于仅X条件化,而独立的生成式模型(ML-DBM)仅略微超过常数预测器。
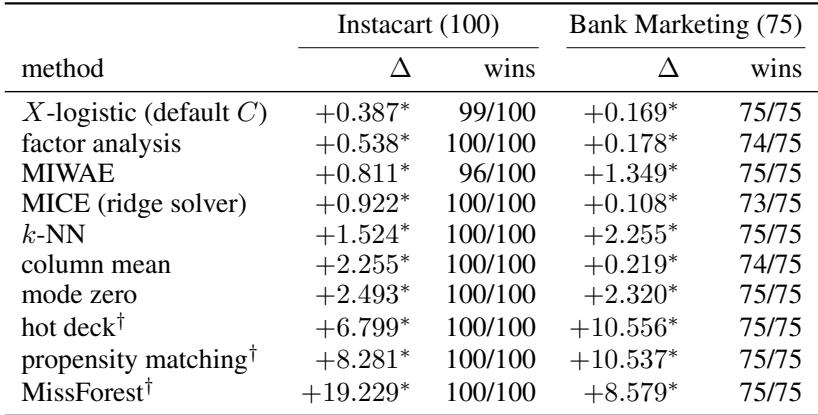
在两个数据集上,OBMP始终优于所有插补基线,每次比较的配对差异均为正,且边际统计显著。与X-logistic和MICE的差距最小,与列均值和k-NN等简单方法的差距最大。OBMP在绝大多数单独运行中获胜,对任何单一基线最多输掉少数几次。OBMP的优势在X-logistic上最小,在列均值和k-NN上最大。在Instacart的100次运行中,OBMP对任何插补基线至少赢96次;在Bank Marketing的75次运行中至少赢73次。
一旦有足够的训练数据,生成式预训练相对于相同容量的判别式训练网络几乎不提供收益,其贡献集中在最小样本量,并在其他地方消失。相比之下,跨块条件化在两个数据集的所有测试配置中始终提高准确率,且其增益不随更多数据而缩小。跨块项捕获了从未一起观测到的结果之间的关联,这是仅将协变量映射到结果的模型无法复制的结构性优势。在Instacart和Bank Marketing的所有网格单元中,跨块条件化均产生正的准确率增益。生成式预训练的贡献几乎完全限于最小训练规模(n_train=500),并随更多数据变得可忽略。在Bank Marketing上,生成式预训练总体上贡献基本为零,所有运行平均为-0.005个百分点。与预训练优势不同,跨块优势不随训练样本增加而衰减。跨块项利用了从未从配对数据中拟合的结果关联,通过联合模型的共享隐藏层传播。
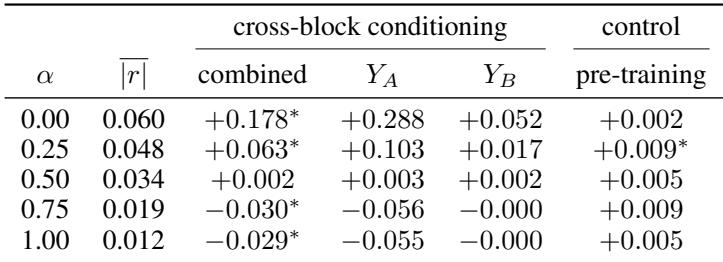
当通过置换一个结果块的行来打破结果块之间的关联时,跨块条件化项从正贡献降至接近零,然后变为轻微负值,紧密跟踪平均块间绝对相关性。生成式预训练贡献在所有置换水平上保持平坦,确认跨块项专门捕获了两个结果块之间的依赖关系。跨块项从关联完整时的+0.178个百分点降至块完全独立时的-0.029个百分点,在约50%置换时穿过零。生成式预训练在所有置换比例下保持不变,保持在±0.01个百分点内,而跨块项随操控的相关性系统性变化。置换一个结果块仅对仅X逻辑回归臂造成可忽略的附带损害(0.048个百分点),因此整体性能的损失几乎完全归因于跨块通道。
在具有两个结果块的统计数据融合任务中,所提出的跨块条件化OBMP模型始终优于基线,在低数据设置下增益最大。跨块项捕获了从未一起观测到的结果之间的结构性关联,其优势不随更多训练数据衰减,这与生成式预训练不同,后者的收益随样本量增长而消失。通过置换打破结果关联会消除跨块增益,确认其依赖于块间依赖关系。