Command Palette
Search for a command to run...
Dream-RSI:通过演化世界实现递归自我改进
Dream-RSI:通过演化世界实现递归自我改进
摘要
递归自我改进对于自主 AI 代理正变得越来越重要,其进展依赖于在复杂领域中发掘高价值解决方案。这一过程的驱动力是有效的探索,然而,管理和改进探索策略仍然是一个主要瓶颈。当前系统面临一个根本性困境:固定策略在搜索空间扩展时无法适应,而在线策略优化则需要在长时程轨迹中,于延迟且昂贵的反馈下,导航庞大的元搜索空间。我们引入了 Dream-RSI,一个用于可扩展且递归自我改进探索的框架。一个轻量级的编排层使探索变得显式且可编程,同时保持底层编码代理不变。我们的关键见解是,累积的发现历史可以作为已实现搜索空间上的回放模拟器。通过在由历史发现树构建的回放模拟器中进行“梦境”操作,Dream-RSI 获得了即时、低成本的离策略反馈,以评估和改进探索策略,而无需重复调用昂贵的在线评估。改进后的策略随后被重新部署到线上以推动进一步发现,从而在自我改进循环中持续扩展模拟器池。在算法工程、数学优化和 GPU 内核工程中,Dream-RSI 实现了具有竞争力或更优的发现质量,同时在多种设置下显著降低了发现成本。
一句话总结
来自谷歌、马里兰大学、谷歌DeepMind和弗吉尼亚大学的研究人员提出了Dream-RSI,这是一个用于可扩展递归自我改进的框架。在该框架中,轻量级编排层使探索过程显式且可编程,累积的发现历史作为回放模拟器,为优化探索策略提供即时、低成本的离策略反馈,而无需重复进行在线评估。在算法工程、数学优化和GPU内核工程等领域,该框架以显著更低的成本实现了具有竞争力或更优的发现质量。
核心贡献
- 提出Dream-RSI框架,通过轻量级编排层使探索策略显式且可编程,底层编码agent保持不变,并能在不修改agent本身的情况下实现探索策略的递归自我改进。
- 将累积的发现历史转化为回放模拟器,使候选探索策略能够利用存储的结果获得即时、低成本的离策略反馈进行评估,而非重新运行昂贵的在线发现过程,从而解决了元层面反馈延迟且成本高昂的瓶颈问题。
- 在算法工程、数学优化和GPU内核工程中,Dream-RSI实现了具有竞争力或更优的发现质量,同时在多种设置下显著降低了发现成本,验证了回放模拟器方法在可扩展探索改进中的有效性。
引言
AI系统中的递归自我改进(RSI)通常依赖于迭代发现循环,其中agent生成、评估并优化候选解决方案。随着这些循环扩展到大规模搜索空间中的长周期探索,编排探索过程的能力变得至关重要,然而现有方法通常使用固定的、手动设计的策略,无法根据累积经验进行自适应调整。先前尝试在线优化探索策略的工作面临两大瓶颈:元层面的反馈延迟且成本高昂,以及可能的策略空间极为庞大,使得每次评估都代价不菲。
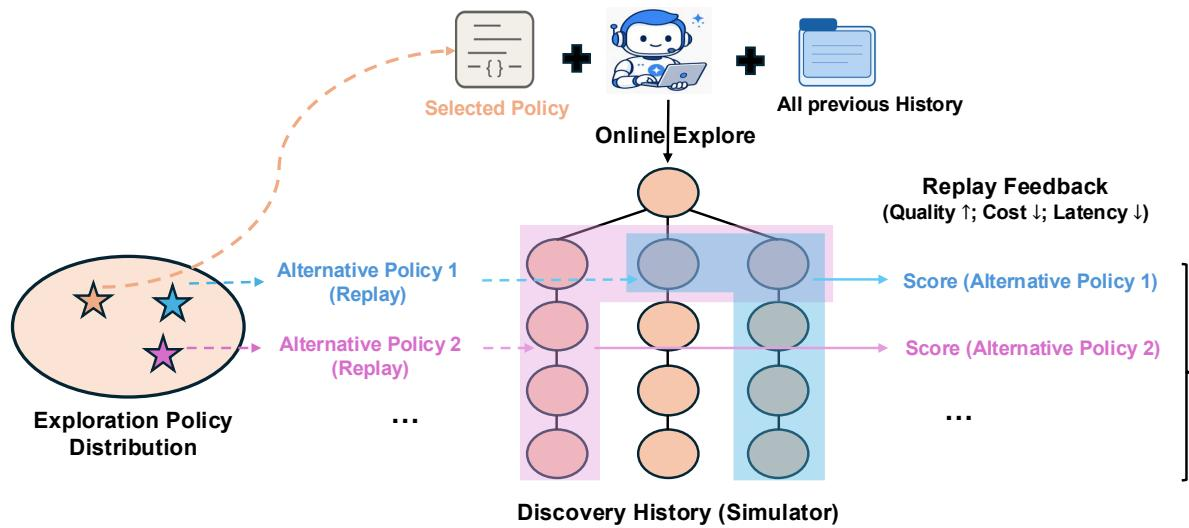
作者提出了Dream-RSI框架,通过将已完成的发现历史视为回放模拟器来解决这些挑战。无需重新运行底层发现agent,替代探索策略可以在预先记录的发现树中导航,读取存储的结果并以极低的成本评估其有效性。这将元策略改进从昂贵的在线试错过程转变为基于模拟的快速“梦境”过程。Dream-RSI建立了一个闭环机制,包含三个阶段:在线探索、从日志执行轨迹构建模拟器,以及基于梦境策略改进,随后将升级后的策略重新部署以扩展模拟器池。实验表明,Dream-RSI在算法工程、数学优化和GPU内核工程中均展现出更高的发现效果和效率,agent调用次数最多减少162倍,在某些设置下实现了超过50倍的预算节省。
方法
作者提出了Dream-RSI框架,该框架在在线探索和离线梦境之间交替进行,以迭代改进一个可执行的探索策略,该策略负责分配发现计算资源。如下图所示,系统通过三个核心阶段在递归自我改进循环中运行:在线探索、构建回放模拟器以及基于梦境的策略改进。
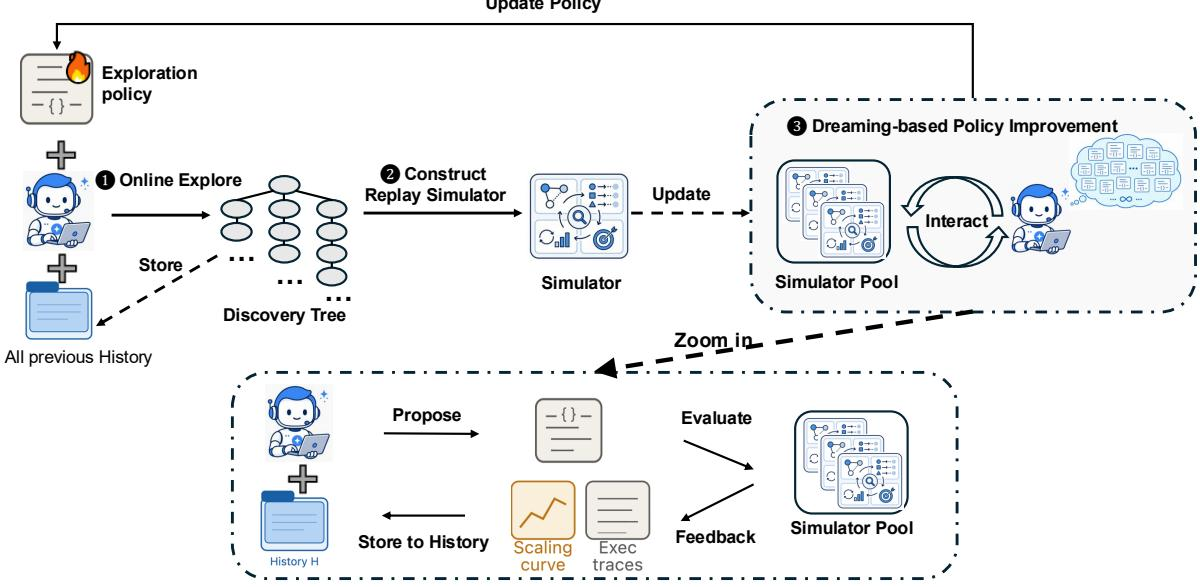
在线阶段,当前策略引导一个固定的发现agent扩展发现树,同时一个固定的评估器对生成的候选方案进行评分并提供诊断反馈。生成的发现树作为回放世界,在其中可以使用记录的结果评估替代策略。一个基于LLM的固定策略开发agent利用这些反馈修订探索策略代码,评估出的最佳版本被部署用于下一轮在线探索。只有探索策略代码发生变化;底层模型、评估器和执行接口均保持不变。
发现树的根节点为r,代表初始工作区状态。每个非根节点ν恰好有一个主父节点。该父节点标识了ν中尝试的起始位置:发现agent恢复父节点保存的工作区,并利用其累积的观察作为上下文生成新的尝试。节点ν保留这一继承的历史,并记录新生成和评估尝试的结果,包括生成的文件系统快照、生成的工件、评估诊断和分数sν。
在在线执行和离线回放中,探索策略观察树T(初始仅包含根节点),并选择继续探索的节点。符合条件的节点构成集合A(T)={r}∪{ν∈T:ν 是叶子节点}。设W≥1为并行工作线程数。探索策略的动作是一个批次C∈A(T;W),其中A(T;W)={C⊆A(T):∣C∣≤W}是可行批次集合。每个选中的节点指定一次尝试的起始点,因此批次同时决定了探索的继续位置和并行调度的尝试数量。
在第t次迭代的在线探索过程中,策略πt在可访问的完整发现历史Ht−1的指导下引导新一轮探索。设Ttk表示完成k轮决策后的新发现树。在第k轮,探索策略选择节点批次Ctk∈A(Ttk;W),每个节点ν∈Ctk被分配给一个工作线程。发现agent生成新的候选方案,评估器评估结果。这些尝试并行运行,每个尝试为其选定的父节点生成一个新子节点。当策略选择空批次或完成K1轮决策时,探索结束。最终的树被记录为Tt并追加到历史中,即Ht=Ht−1∪{Tt}。
随后,方法利用这一扩展的回放世界集合进入离线阶段。如框架图所示,一次昂贵的在线发现运行可以支持许多对替代探索策略的低成本评估。在回放模拟器中,替代探索策略在记录的发现树中产生不同的轨迹。评估这样的轨迹仅需揭示沿选定分支已存储的结果,而无需重新运行底层编码agent和评估器。
在外层迭代t的离线阶段,历史Ht保持不变,同时方法构建并评估M≥1个策略版本πt0,…,πtM−1,其中πt0=πt。对于每个策略-树对,回放重置策略的每轮状态,并从Tim,0={r}开始。在每个决策点,πtm利用已揭示的观察选择批次Cim,k∈A(Tim,k;W)。与在线执行不同,回放确定性地返回所选节点的已记录子节点,而非生成新候选方案。回放最多允许K2轮决策,并在策略选择空批次、达到轮次限制或所有记录节点均被揭示时终止。
回放目标在发现质量、执行成本和并行度之间取得平衡。设Nim=∣Tim,kim,⋆∣−1为已揭示的非根节点数量。对于固定系数β1,β2≥0,回放得分为:
Vim=ν∈Tim,kim,⋆maxsν−β1Nim+β2max{1,kim,⋆}Nim.第一项衡量回放过程中达到的最佳解决方案质量。第二项惩罚尝试生成的次数。第三项奖励每轮决策中平均执行的尝试数量,倾向于选择能够批量执行有用延续的策略。
策略版本πtm的评估得分是其在整个固定历史中的平均回放得分,即Vm=t1∑i=1tVim。策略开发agent检查πtm的回放轨迹和得分,结合早期修订的反馈,识别成功决策和反复出现的失败。随后,它修订可执行策略代码以生成πtm+1。经过M次修订后,下一个在线策略从所有评估版本中选择,即πt+1=πtm⋆,其中m⋆∈argmaxm∈{0,…,M−1}Vm。选定的策略随后被部署到在线环境中以收集Tt+1,从而扩展可用于下一轮离线改进阶段的历史。
实验
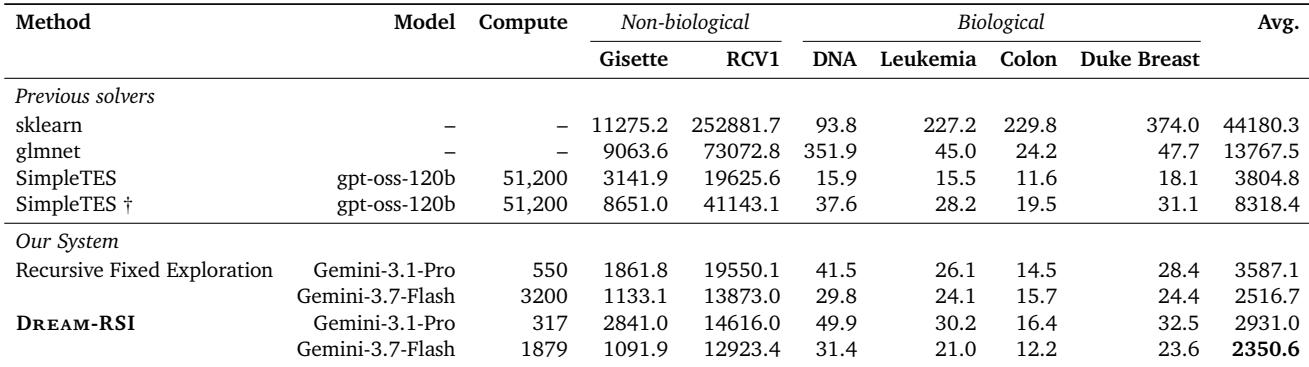
Dream-RSI与受控基线“递归固定探索”在算法工程、数学优化和内核工程三个领域进行了对比评估,使用相同的发现agent、初始化和每轮预算。在Lasso正则化路径发现任务中,Dream-RSI以更少的发现agent调用次数改善了相对于基线的下游质量-计算权衡,并优于标准求解器和SimpleTES。在三个数学优化任务中,它以显著更低的计算量达到或超过了现有系统。在GPU内核工程中,它以更少的生成次数达到相当或更高的性能,进一步分析表明,来自历史的显式语义指导效果不佳,而学习到的探索策略能够跨轮次自适应调整计算分配。
所提出的系统在非生物和生物基准测试中均持续优于先前的求解器和基线,在大多数任务中实现了显著更低的误差分数。它还在内核工程中展现了更高的效率,以更少的生成次数或在类似预算下达到相当或更高的性能。分析表明,自适应探索策略在长周期发现中比显式语义指导更有效。所提出的系统在所有方法中实现了最低的平均误差,尤其是相对于sklearn和glmnet等先前求解器取得了较大改进。在内核工程任务中,系统要么以更少的生成次数匹配最终性能,要么在类似预算下实现更高性能。来自历史轨迹的显式方向性指导始终不如无引导探索,表明强烈的语义偏见可能阻碍发现。探索策略跨轮次自适应调整,在取得进展时减少计算量,在性能停滞时再次增加努力。
Dream-RSI在三个数学发现任务中表现具有竞争力,在Sum-Difference任务中取得了所有对比方法中的最佳得分,在Circle Packing中与最优结果持平,并在Autocorrelation中保持竞争力。值得注意的是,它以远少于最先进基线的生成次数实现了这些结果,表明其具有强大的效率和泛化能力。Dream-RSI在所有对比方法中取得了最高的Sum-Difference得分。在Circle Packing中,Dream-RSI与表中报告的最强结果持平。在Autocorrelation中,Dream-RSI与现有系统保持竞争力,同时使用的生成次数远少于领先基线。
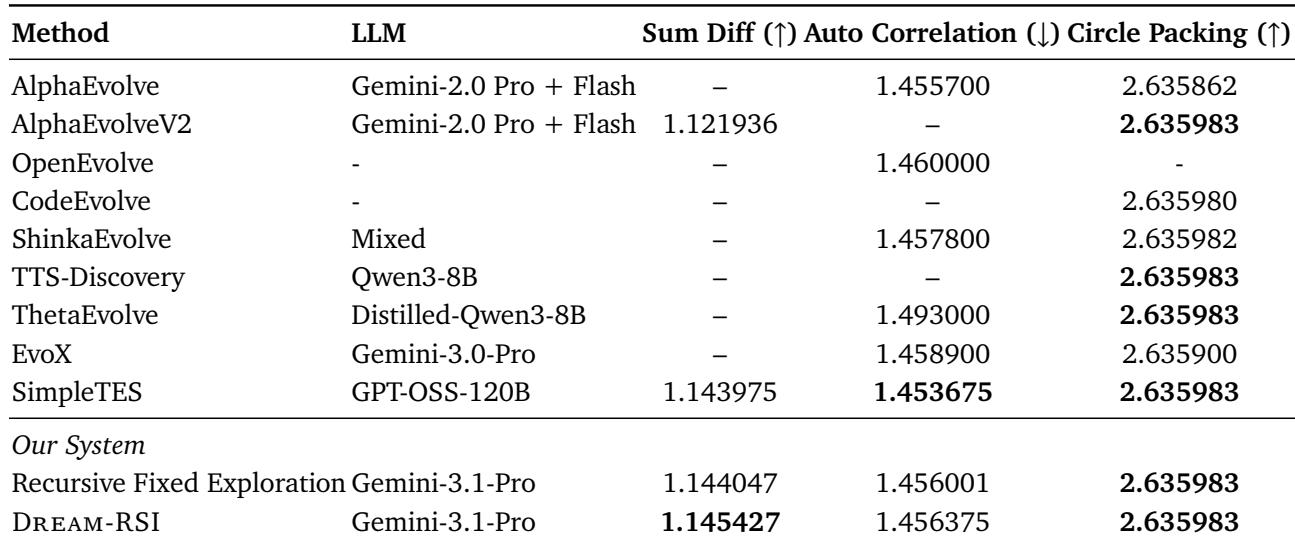
所提出的系统在非生物和生物基准测试中均优于先前的求解器和基线,在大多数任务中实现了更低的误差分数,并提高了内核工程效率,要么以更少的生成次数匹配最终性能,要么在类似预算下超越性能。自适应探索策略被证明比显式语义指导更有效,因为方向性历史线索始终不如无引导探索。在三个数学发现任务中,该系统(Dream-RSI)取得了最佳的Sum-Difference得分,在Circle Packing中与最优结果持平,并在Autocorrelation中保持竞争力,同时使用的生成次数远少于领先基线,表明其具有强大的效率和泛化能力。