Command Palette
Search for a command to run...
广义智能体迭代:迭代策略改进与递归自我改进的统一形式化框架
广义智能体迭代:迭代策略改进与递归自我改进的统一形式化框架
Hongyao Tang Yi Ma Pengyi Li Yifu Yuan
摘要
当我们谈论递归自我改进(RSI)时,我们是在谈论一种现象、一种机制,还是一种前景?在迈向自主和进化智能的进程中,RSI 在诸多尺度上被提及,然而目前尚无一个统一的框架能够正式描述这些涌现的实例。其在经典领域的对应物——迭代策略改进——由广义策略迭代(GPI)所刻画,该框架具有广泛的适用性和完善的理论性质,但仅限于更新原则和评估基准均位于智能体外部的情形。本文提出了广义智能体迭代(GAI),一个将迭代策略改进和 RSI 描述为同一学习范式下两个案例的形式化框架。GAI 将智能体定义为系统内可修改组件的配置,并将学习过程建模为智能体评估与智能体改进的循环。随后,两个关键维度区分了不同实例:改进机制是否属于智能体的一部分,以及其所依据的标准是否根植于外部。前者划定了 GPI 与 RSI 之间的界限,后者决定了系统的极性——锚定、目标漂移或完全自指。此外,我们利用这些坐标将现有系统置于同一双轴上,并使得递归自我改进的缺陷能够逐条件地得以陈述。我们认为本文是探索 RSI 形式化表征的第一步,该表征基于经典理论,使现有系统具有可比性,并为分析和设计新系统提供了原则性基础。
一句话总结
天津大学和山西大学的研究人员提出广义 Agent 迭代(GAI),这是一个形式化框架,通过两个旋钮(改进机制是否为 Agent 的一部分,以及其评估标准是否来自外部)统一了迭代策略改进与递归自我改进,从而能够沿这些轴线对现有系统进行定位和缺陷分析。
核心贡献
- 提出广义 Agent 迭代(GAI),这是一个形式化框架,将迭代策略改进和递归自我改进统一为同一学习范式的两种情形,由 Agent 评估与 Agent 改进的循环来定义。
- GAI 规定两个用于区分系统实例的旋钮:改进机制是否位于 Agent 内部(区分 GPI 与 RSI),以及评估标准是否锚定于 Agent 外部(将系统划分为锚定型、目标漂移型或完全自指型),这使得现有系统能够被放置在相同的两条轴线上。
- 该框架提供了一份缺陷目录,逐条说明递归自我改进在何种条件下偏离经典保证,每个缺陷都被标记为结构性的,并在适用处指出现有系统中的观测实例,同时确定了三个有待形式化定理的开放目标:刻画自洽条件解集的特征、将 RSI 到 GPI 的归约形式化为一个命题,以及判定内部监视器能否验证其自身的修改批评者。
引言
作者回应了人工智能领域一个长期存在的空白:缺乏对自我改进系统的统一形式化描述。经典的迭代策略改进在广义策略迭代(GPI)中拥有严格基础,它假定改进机制和奖励都位于 Agent 外部;而现代递归自我改进(RSI)系统则通过允许 Agent 修改自身的改进机制或评估器来打破这一设定。以往的工作,包括 Gödel 机器和经验性 Agent 循环,均缺乏关于什么构成自我改进、以及当经典假设被打破时失败如何产生的精确判据。
为填补这一空白,作者提出广义 Agent 迭代(GAI),这是一个形式化框架,将迭代策略改进和递归自我改进视为同一交替学习循环的两种设定。该框架围绕两个旋钮展开:改进机制是否为 Agent 自身的一部分,以及评估标准是否保持锚定于 Agent 外部。通过将现有系统(从 Gödel 机器到共同进化的评估器)放置在这些轴线上,作者为各种不同方法提供了统一的解读。他们还识别出递归自我改进的四种结构性缺陷,每种缺陷都与经典 GPI 中被自指系统违反的一个条件相关联,并概述了未来形式化刻画的开放问题。
方法
3 广义 Agent 迭代(GAI)框架
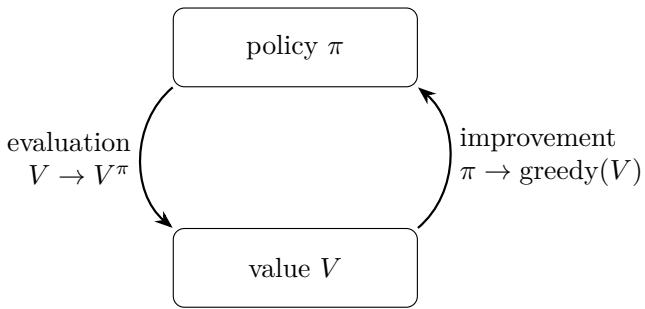
作者提出广义 Agent 迭代(GAI)作为一种形式化学习范式,将经典的广义策略迭代(GPI)框架扩展到可描述其改进组件本身可被编辑的 Agent 系统。GPI 涵盖了一大类策略改进方法,但无法解释递归改进的系统,即负责改进 Agent 的机制本身也是 Agent 可以修改的一部分。GAI 在核心保留了评估与改进的交替循环,并将 GPI 和递归自我改进都视为同一底层结构的具体实例。这两个实例在两个维度上有所不同,作者称之为该框架的两个旋钮:(1)改进 Agent 的机制是否位于 Agent 内部,(2)衡量改进所依据的标准是否保持锚定于 Agent 外部的事物。
3.1 自我改进系统与 Agent
自我改进系统在世界中行动,并以目标来衡量其表现。作者将世界保持为马尔可夫决策过程 W=(S,A,p,r),并用 G 表示系统应当服务的外部目标。世界和目标都属于环境,不是系统本身的一部分。系统的目标是服务外部目标 G,其在世界中的标量实例就是奖励 r。最能服务该目标的配置为
χ⋆∈argχ∈XmaxE[t≥0∑γtr(St,At)χ],该配置仅由世界和目标决定,而非由系统本身决定。作者指出,某些自我改进系统允许 Agent 提出自己的任务或目标作为学习手段;他们将其视为自我改进的一种特定形式,因为此类自设任务仍然从属于一个客观的、不可被 Agent 编辑的外部目标。
设 χ 为一个由组件构成的系统,O={π,V,m,U,ρ} 为组件集合,Co 为组件 o 的内容空间。系统位于空间 χ∈X=∏o∈OCo 中。设 Ag⊆O 为构成 Agent 的组件集合;Agent 实例是对这些组件的内容赋值 ξ∈XAg=∏o∈AgCo。此外,χ[ξ] 表示将 χ 的 Agent 部分替换为 ξ 后得到的系统。作者用 Δ(Y) 表示空间 Y 上的概率分布集合。
在一个外部世界 W 和目标 G 之上,系统是一个配置 χ=(π,V,m,U,ρ),即五个组件当前内容的元组:π:S→Δ(A) 是选择世界动作的策略;V:S→R 是评估 π 行动好坏的动作批评者;m:X→Δ(XAg) 是提出系统应如何改变的修改器;U:X→R 是评估所提修改是否服务 G 的修改批评者;ρ 是评估基,即批评者所对照的标准。这五个角色都属于系统;实例可以令其中某些角色不使用,例如当修改器固定时,修改批评者 U 就不被使用。Agent 是系统内部可修改的部分。其成员因系统而异,例如当修改器固定时 Ag={π,V},而当系统还可以重写其修改器甚至评估标准时 Ag={π,V,m,U,ρ}。
广义 Agent 迭代是一个在系统 Agent 部分上交替执行两种操作的过程。Agent 评估根据评估基 ρ 对 Agent 部分进行评分,其中 V 在策略层面、U 在 Agent 层面。Agent 改进产生新的 Agent 实例 ξ∼m(⋅∣χ),系统将其采纳为 χ←χ[ξ]。这一定义留下两个选择:改进 Agent 的机制是否在这些组件之中,以及评估基指向何处。这就是框架的两个旋钮,每一个都形式化了 GPI 与递归自我改进之间的一个区别。
第一个旋钮关注改进 Agent 的机制是否位于 Agent 内部。Agent 仅通过修改器改变:在每一步,m 抽取一个新的 Agent 实例 ξ∼m(⋅∣χ),系统移动到 χ[ξ]。如果 m∈/Ag,其内容是固定的,m 充当外部改进机制,即 GPI 所迭代的抽象评估与改进算子。如果 m∈Ag,系统可以重写自身的修改器,因此递归在 m 处闭合,不存在外部元层。
第二个旋钮关注改进所依据的标准是否保持锚定。每次评估都向某一标准(其评估基)回归;作者将该基视为单一标准 ρ,并仅在需要区分两个批评者时写出其实例 ρV 和 ρU。该基是系统的一个组件,第二个旋钮所问的是其内容来自何处以及 Agent 是否可以重写它。当评估基的内容来自系统外部(即世界和目标)且该基本身位于 Agent 外部时,该评估是锚定的。此时 Agent 不能重写衡量其所依据的标准。一个内容来自外部但 Agent 可以重写的基,会随系统自身的编辑而移动;一个完全没有外部内容的基,仅以自洽性约束循环。
3.2 GPI 与递归自我改进作为 GAI 的两个实例
作者将 GPI 和递归自我改进重新引入为上述系统定义的两个实例。它们仅在两个旋钮的设置上有所不同:对于 GPI,修改器位于 Agent 外部且评估基锚定于世界奖励;对于递归自我改进,修改器本身是 Agent 组件。其余描述全部共享。
GPI 作为锚定实例。 Agent 由策略和动作批评者组成,Ag={π,V},修改器不是 Agent 的一部分,m∈/Ag。m 的内容被固定为评估算子 Em 和改进算子 Im,下标 m 表示更新原则是 m 的内容。由于 m 固定,两个算子也都是固定的。通过 m,Agent 按组件方式变化为
V←Em(V,π;ρV)(evaluation),π←Im(V)(improvement),而 m 本身不变。唯一在使用的评估是动作批评者;修改批评者 U 存在但不被使用,因为 m 固定且没有替代修改被评分。动作批评者的基 ρV 是锚定的,其内容为世界奖励 r。当 Em 是策略评估、Im 是贪心时,这两个更新恰为策略迭代或值迭代,在有限 MDP 中于标准假设下收敛到最优策略 π⋆。公式(1)的目标函数也由同一策略最大化,此时动作批评者取其值 Vπ⋆。
递归自我改进作为自修改实例。 现在修改器是 Agent 的一部分,m∈Ag,典型地 Ag={π,V,m,U}。步骤不变,现在写作
policy update:V←Em(V,π;ρV),π←Im(V)agent update:ξ∼m(⋅∣χ),χ←χ[ξ],m′←(ξ)m,U′←(ξ)U第一行中的算子带有下标 m,表示它们由当前修改器决定而非外部固定:GPI 的策略级更新在递归自我改进中变成了 m 可以实现的内容。第二行就是递归本身:(ξ)m 和 (ξ)U 是提议中的修改器和修改批评者槽位,因此下一个修改器和下一个批评者由当前修改器产生。递归在 m 处闭合,没有外部元层更新它。每个 Agent 组件仅通过 m 改变,而 m 可以运行上述 GPI 式交替,但同样可以重写自身、替换其批评者,或改变其选择规则。
这一描述中没有任何内容保证 m 朝任何外部目标改进;改进是 m 内容的属性,而非框架的属性。如果 m 朝其基改进,则其内容 (m,U) 必须满足一对自洽条件,作者将其陈述为参考理想。记 ρU(χ,ξ) 为基对从 χ 采纳 Agent 实例 ξ 所赋予的值。则
agent evaluation:agent improvement:U(χ)=Eξ∼m(⋅∣χ)[ρU(χ,ξ)+γU(χ[ξ])]suppm(⋅∣χ)⊆argmaxξ∈XAg[ρU(χ,ξ)+γU(χ[ξ])]其中第一个条件将修改批评者校准到基,第二个条件要求修改器只提出批评者估计为改进的 Agent 实例。这些是刻画条件,而非强制更新:它们描述了自我改进者必须具备的内部结构,没有任何外部机制保证它们。
3.3 自我改进的极性:锚定型、目标漂移型与完全自指型
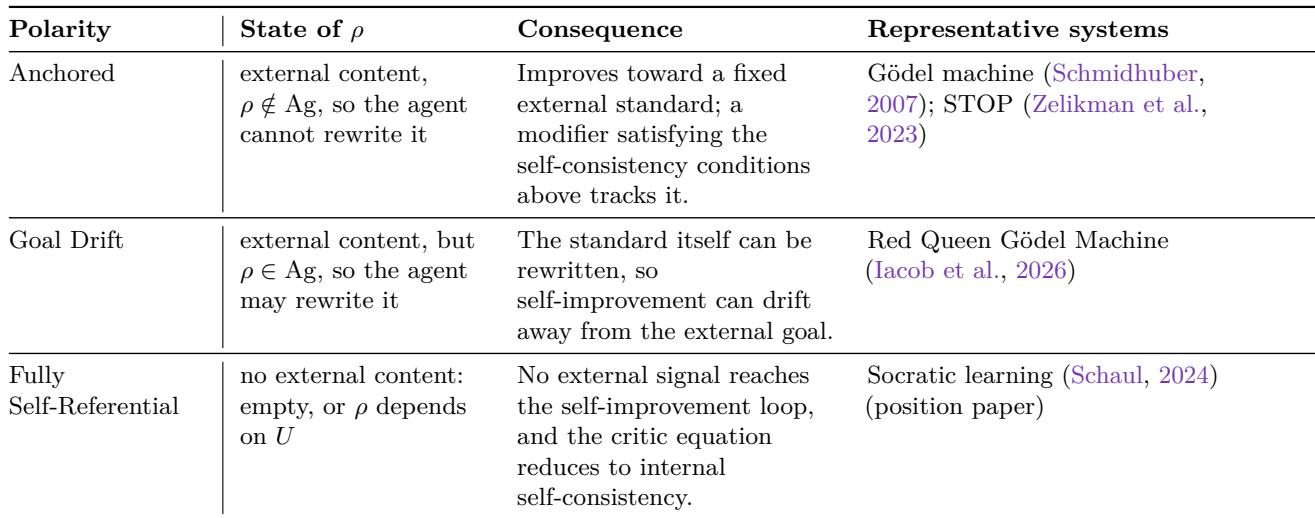
第二个旋钮同样适用于动作批评者的基和修改批评者的基。它仅在修改器是 Agent 的一部分时才区分极性:在 GPI 中,修改批评者从不被使用,因此唯一在使用的基是动作批评者的基,锚定于世界奖励,GPI 的极性条目为锚定型。对于 m∈Ag,第二个旋钮决定自我改进的极性,即评估基 ρ 是否保持锚定。作者区分它可以采取的三种状态:锚定型、目标漂移型和完全自指型。
外部评判者或奖励模型是锚定型的,无论其训练数据是什么:该旋钮问的是标准位于何处,而不是它对目标的忠实度。代理指标可以是锚定的,但在不服务目标的情况下仍然得到满足;同一个评判者作为 Agent 组件则是目标漂移的情形。中间行,目标漂移型,描述的是系统偏离其固定目标,而非目标本身的改变:移动的是衡量朝向目标进展的标准。在当前实践中,大多数已展示的自我改进系统属于锚定行;下面两行目前主要由边界情况和立场论文代表。
两个旋钮合在一起,对所有实例进行定位。将修改器置于 Agent 外部并将唯一在使用的基固定为世界奖励,即得到 Ag={π,V} 的 GPI 循环。将修改器保持在 Agent 内部同时保持 ρ 锚定,即得到锚定递归自我改进,如 STOP 及其固定验证示例,或 Gödel 机器,其证明门限制了尝试哪些重写。让 ρ 进入 Agent,或消失或指向自身,则得到非锚定端。将修改器冻结为外部程序并移除修改批评者及其基 ρU,即恢复经典策略与值循环。
实验
评估设置涉及 Agent 在固定目标模型和外部评估下修改自身的训练数据策略,通过搜索候选自我来探测递归自我改进的可行性。结果表明,尽管大多数首次尝试能提升性能,但继续超过最佳分数后往往导致最终性能下降,这表明即使存在固定的外部标准,改进步骤也是非单调的。潜在的结构性缺陷被识别为:缺乏对无界内容空间的一般决策程序,以及当评估器成为 Agent 组件时外部评估的丧失,这两者都损害了自我改进的稳定性和有效性。
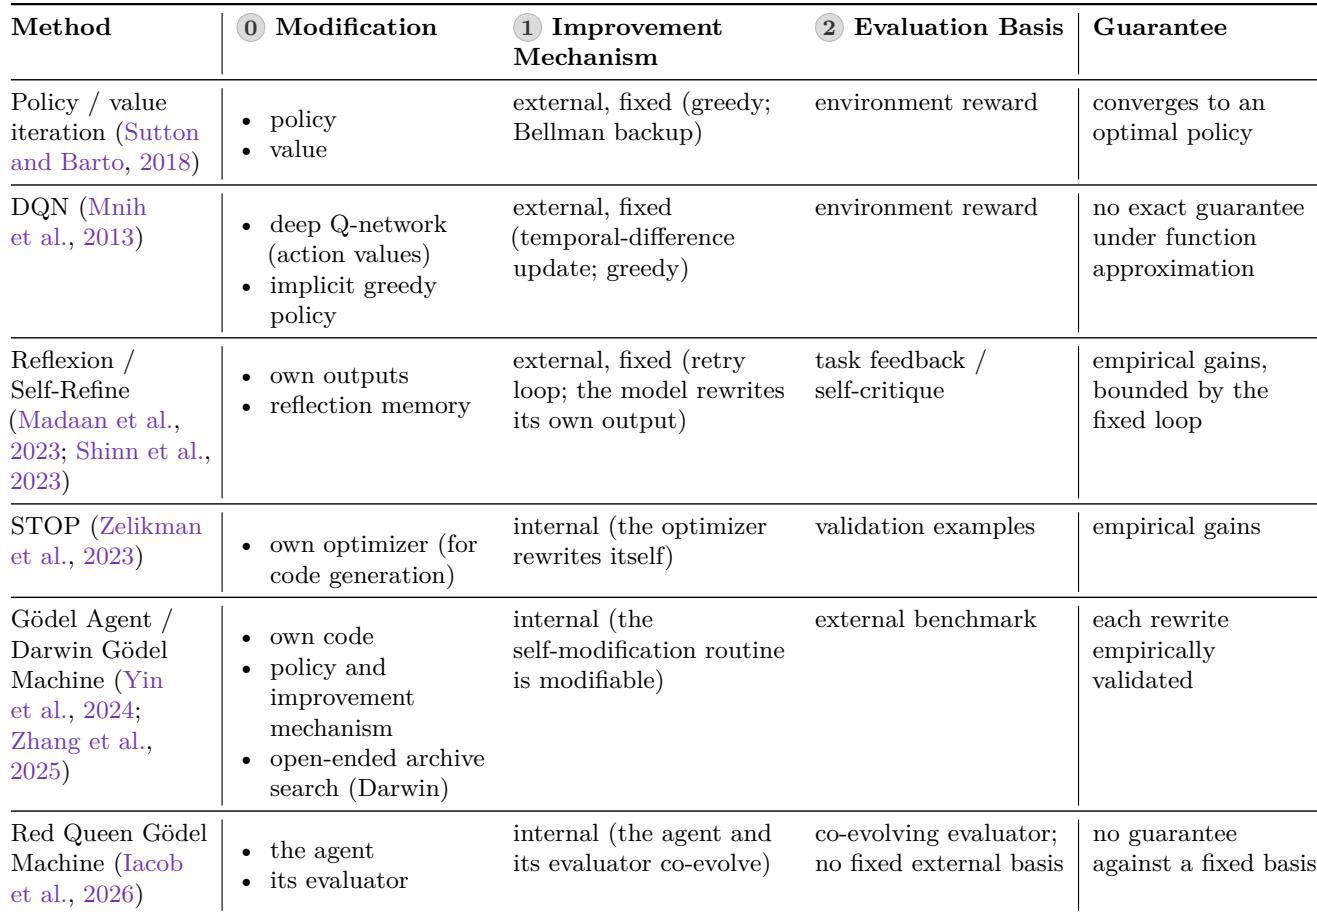
表格按修改对象、改进机制是内部还是外部、以及评估基础是否固定在 Agent 外部来对策略迭代方法和自我改进 Agent 进行分类。经典方法和一些经验性循环保持评估外部化,而更高级的自我改进 Agent 则将修改和评估都内部化,用保证换取灵活性。策略/值迭代和 DQN 等经典方法依赖环境奖励等外部固定评估器,而较新的自我改进 Agent 往往将评估内移。Reflexion/Self-Refine 和 STOP 只改进 Agent 的输出或优化器,保持改进循环外部化;而 Gödel 式 Agent 则在内部修改自身代码和改进机制。随着评估内部化,保证逐渐减弱:经典方法在假设下收敛,经验性循环显示有界收益,共同进化的评估器则对固定基不提供任何保证。
表格按评估基的极性对自我改进系统进行分类:评估基可以锚定在 Agent 外部,作为 Agent 可重写的组件而发生漂移,或者变成完全没有外部锚定的完全自指形式。排序反映了剩余锚定量的多少,大多数当前系统属于锚定行,非锚定行主要由边界情况或立场论文代表。锚定系统保持评估标准外部且不可修改,因此改进追踪固定目标,如 Gödel 机器和 STOP。目标漂移发生在 Agent 可以重写评估基而目标本身保持固定时,使得进展度量可能偏离原始目标。完全自指系统在评估循环中没有外部信号,因此批评者退化为内部自洽性,如苏格拉底式学习。
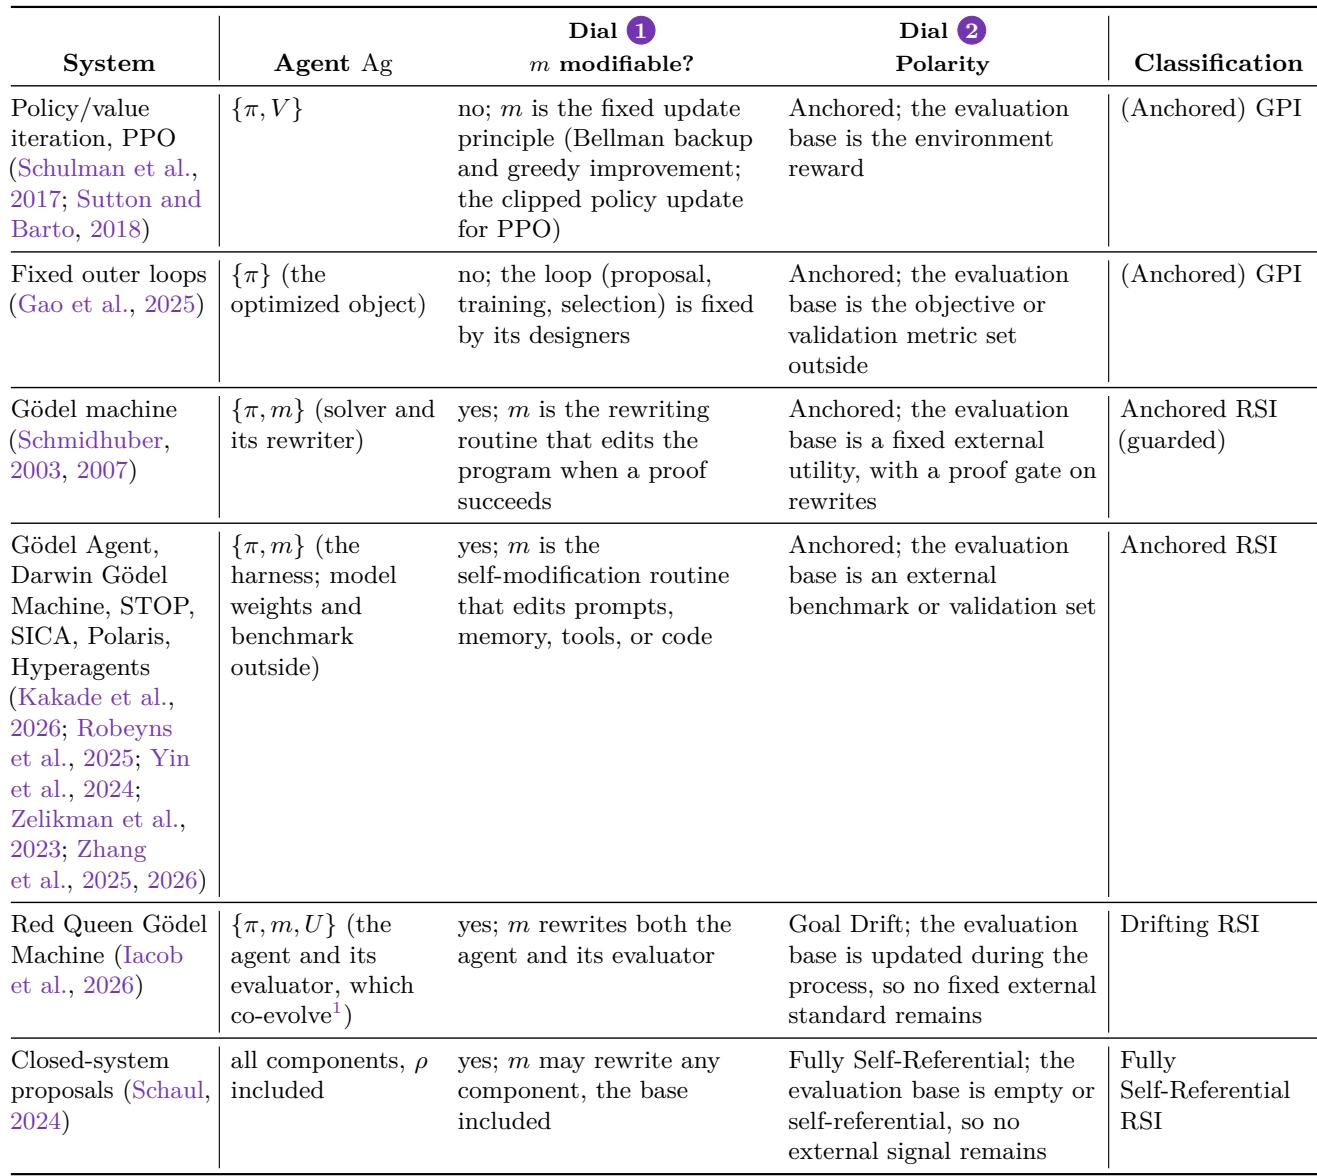
表格按修改器能否修改自身以及评估基如何处理来对自我改进系统进行分类,揭示出三类主要范畴:具有固定评估的锚定系统、评估器共同进化的漂移系统、以及没有外部信号的完全自指系统。大多数现有系统,包括固定循环、Gödel 机器及其后继者,都是锚定型的,因为评估基准保持外部且不可修改;只有 Red Queen Gödel Machine 和封闭系统提案偏离了这一模式。固定外部循环和 Gödel 机器是锚定型的,因为评估基保持在 Agent 外部,即使修改器可以编辑 Agent 本身。在 Red Queen Gödel Machine 中,评估器与 Agent 共同进化,因此评估基随时间变化,不存在固定的外部标准。封闭系统提案允许任何组件(包括评估基)被重写,使系统完全没有外部信号。Gödel Agent 的后继者(如 Hyperagents)保持锚定型,因为只有脚手架可修改且基准是外部的。
表格识别出递归自我改进中的四种缺陷,每种缺陷都与特定的旋钮设置及其违反的 GPI 条件相关联。这些缺陷是结构性的,其中一些在实践中已被观测到,突显了目标导向策略改进(GPI)的保证在何处失效。当修改器是 Agent 组件时,会出现候选自我搜索,违反改进应廉价且单调的条件。当效用是 Agent 组件时,出现自我评估缺陷,破坏评估者应独立于被评估对象的要求。无根基基由无根基的进展机制产生,违反目标从 Agent 外部评估的条件。当进展机制是 Agent 组件时,触发目标漂移,因为基被重写而失去固定标准。结构性缺陷是固有的,而观测到的缺陷则通过 Red Queen Gödel Machine 或显示非单调改进的基准等系统得到验证。
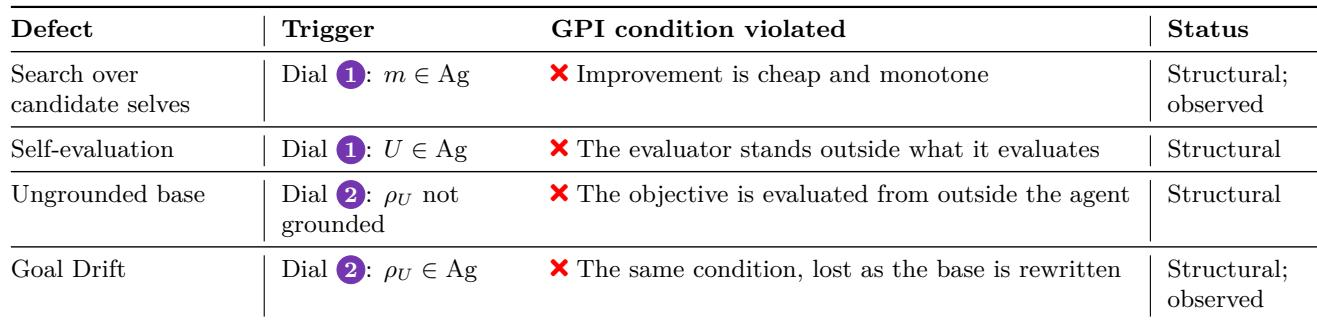
实验使用分类法和表格对自我改进 Agent 和策略迭代方法按修改对象以及评估是内部还是外部进行分类。经典方法(如 DQN、策略迭代)保持评估外部化并提供收敛保证,而 Reflexion 和 STOP 等较新的 Agent 只改变输出或优化器,同时保留外部循环。Gödel 式 Agent 将修改和评估都内移,用形式保证换取灵活性,共同进化的评估器或完全自指系统则失去任何固定标准,导致目标漂移、自我评估偏差和无根基进展等结构性缺陷。研究结果表明,将评估内移会逐步削弱保证,锚定系统保留固定目标,而非锚定系统则面临非单调改进的风险。