Command Palette
Search for a command to run...
ZGCM-1:一个完全开放且极其高效的数学与智能体搜索基础模型
ZGCM-1:一个完全开放且极其高效的数学与智能体搜索基础模型
摘要
尽管基础模型在数学推理和智能体问题求解方面不断突破前沿,但由于高昂的计算需求和封闭的训练方法,更广泛的学术界在很大程度上被排除在这一进展之外。在这项工作中,我们提出了 ZGCM-1,一个完全开放的 7B 稠密基础模型,从零开始训练,并在数据、系统和算法上实现了极高的效率。ZGCM-1 基于一个核心前提:紧凑型模型无法被动地记忆开放网络内容,但可以通过将有意识的内部思考与主动的外部工具使用相结合来克服参数容量限制。为了在 256K 上下文中支持这一范式,我们开发了一种端到端的高效开放训练方案:(1)架构与系统协同设计:交错的门控滑动窗口和全注意力机制,以及稳定的 FP8 Muon 优化器;(2)渐进式课程与 MDP 中期训练:在 16K、64K 和 256K 上进行上下文扩展,并将交互轨迹重新表述为马尔可夫决策过程。此外,我们建立了一个 AI 原生的研发工作流程,其中智能体群自主管理集群操作、数据整理和快速诊断评估。大量评估表明,ZGCM-1-7B 在通用基准测试上与 7B 模型家族具有竞争力。在几个具有挑战性的数学推理和智能体搜索套件上,它与规模大数个数量级的前沿模型(如 Qwen3-235B-A22B 和 GLM-5.1)保持竞争力。我们还表明,我们的预训练设计在 16K 预训练时间到损失方面提供了约 4.2 倍的效率提升。在整个开发生命周期中,我们提炼了八个可操作的实证发现,涵盖架构扩展、SFT 质量剪枝、长上下文泛化和智能体协同训练动态。为了促进社区研究,我们开源了预训练、中期训练和后训练阶段的模型权重、中间检查点、训练代码、各阶段数据和数据配方,以及 W&B 日志。
一句话总结
中关村学院与中关村人工智能研究院的研究人员提出了 ZGCM-1,这是一个完全开放的 7B 稠密基础模型,从零开始训练,以极高的效率将内部深思与外部工具使用相结合,通过交错的门控滑动窗口注意力、FP8 Muon 以及基于 MDP 的中期训练实现,在数学推理和智能体搜索任务上达到了与规模大数个数量级的前沿模型相当的性能,同时提供了约 4.2× 的预训练效率提升。
核心贡献
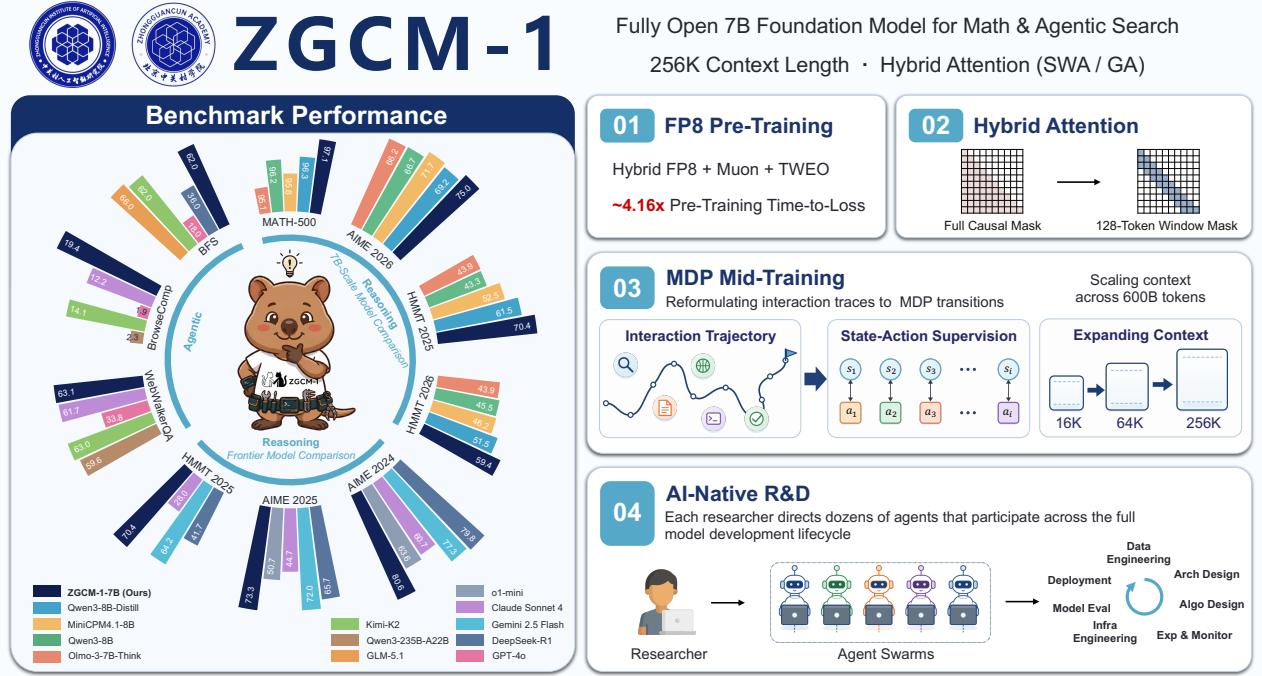
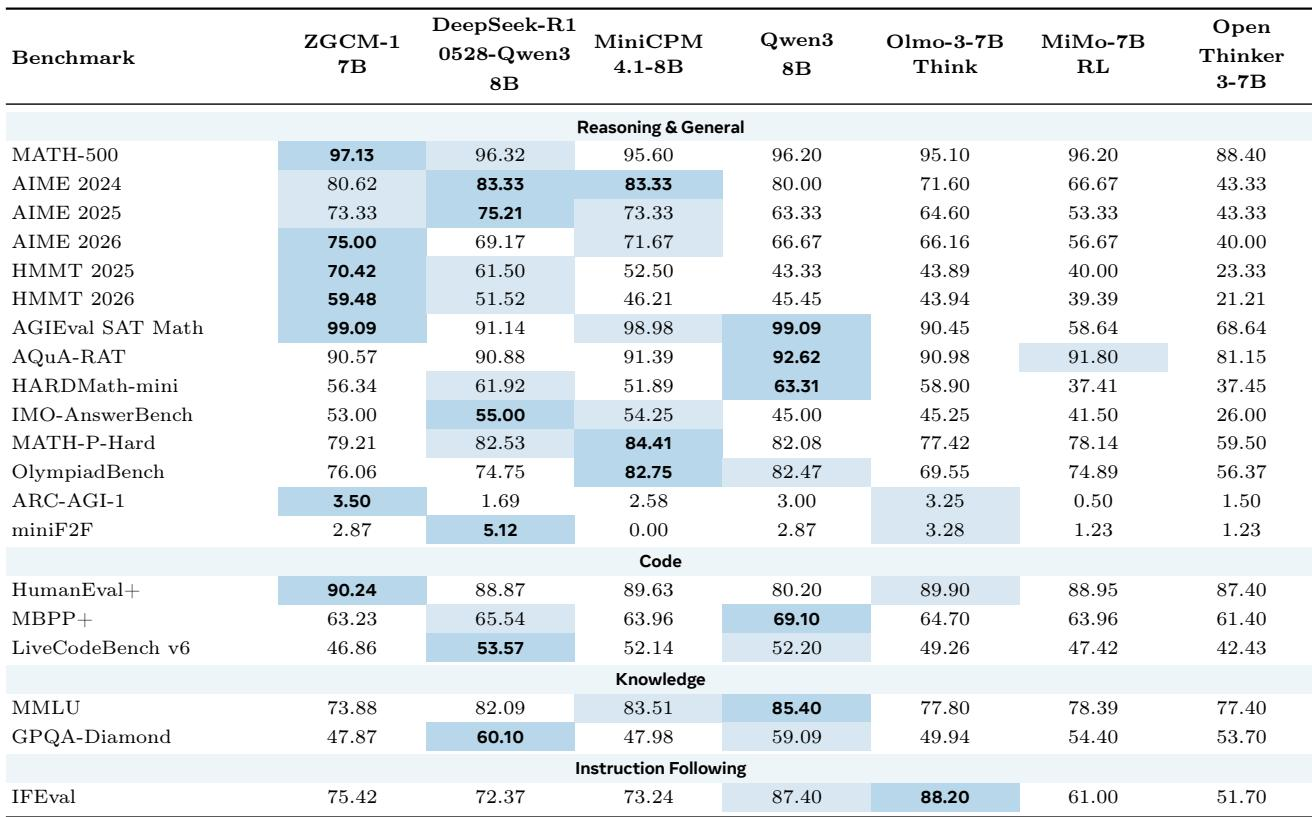
- 提出了 ZGCM-1,一个完全开放的 7B 稠密基础模型,从零开始训练,将思维链推理与外部工具使用相结合,以突破参数容量限制;在 7B–8B 规模下,14 个推理基准的平均性能排名第一,包括 AIME 2026 上的 75.0% 和 MATH-500 上的 97.1%。
- 提出了一种高效的训练方案,采用门控滑动窗口与全局注意力的混合架构(比例为 5:1),将 KV 缓存占用减少 6.4 倍,并在 256K 上下文下实现 3.94 倍的吞吐量加速;同时采用稳定的 FP8 Muon 优化器和 TWEO 离群值正则化,与 AdamW/BF16 基线相比,预训练达到相同损失的时间加速约 4.2 倍。
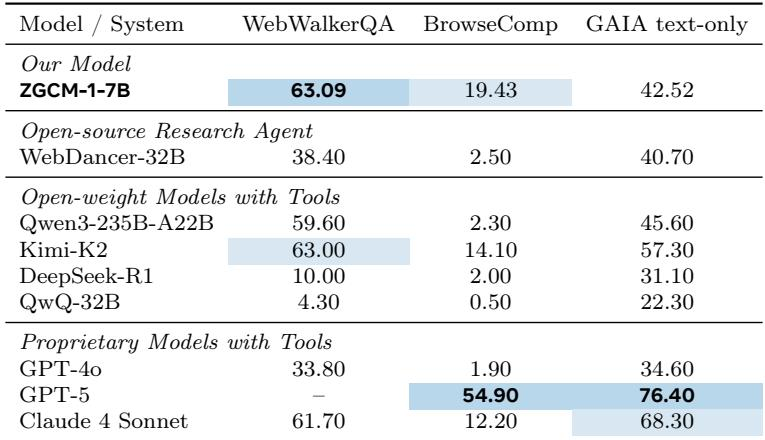
- 开发了一种基于 MDP 的中期训练渐进式课程,将上下文从 16K 扩展到 256K,覆盖 600B token,同时将交互轨迹重构为马尔可夫决策过程转移;该模型在智能体搜索任务上与规模大数个数量级的前沿模型保持竞争力,在 WebWalkerQA 上达到 63.1%,在 BrowseComp 上达到 19.4%。
引言
基础模型正在快速发展,但两个实际瓶颈阻碍了研究:规模壁垒,即前沿级智能被认为需要千亿参数系统;以及不透明壁垒,即竞争性模型以开放权重而非完全开源的形式发布,将训练方案和智能体轨迹作为专有黑箱。以往的工作在透明度和计算可及性方面存在局限,阻碍了对训练动态和容量限制的系统性研究。
作者提出了 ZGCM-1,一个 7.39B 稠密基础模型,在开放科学范式下从零开始训练,挑战了先进智能需要海量参数的观点。其核心论点是,紧凑模型虽然受限于静态参数容量,但可以通过内部深思与外部主动探索的双引擎超越这一限制,将长视野思维链推理与自主工具使用相结合,用于网络证据收集、终端交互和二进制程序分析。为了使训练在学术预算内可行,他们构建了一条高效的全栈流水线,包括混合注意力(门控滑动窗口与全局注意力按 5:1 比例交错,将 KV 缓存占用减少 6.4 倍,并在 256K 上下文下实现 3.94 倍吞吐量加速)、系统与算法协同设计(Muon 优化器、混合 FP8 精度、TWEO 离群值正则化,实现 4.2 倍预训练达到相同损失的时间加速)、覆盖 600B token 的带 MDP 监督的课程式中期训练,以及混合思考/不思考微调的执行落地对齐。在 20 个基准上的评估显示,ZGCM-1-7B 在 7B–8B 规模的 14 个推理基准上平均排名第一,AIME 2026 得分 75.0%,MATH-500 得分 97.1%,HMMT 2025 得分 70.4%,同时在 WebWalkerQA(63.1%)、BrowseComp(19.4%)和二进制函数搜索(62.0%)等智能体任务上与前沿模型竞争。作者还在整个开发周期中集成了 AI 原生研发智能体,并发布了模型权重、中间检查点、训练代码、数据方案和评估工具,以支持社区研究。
数据集
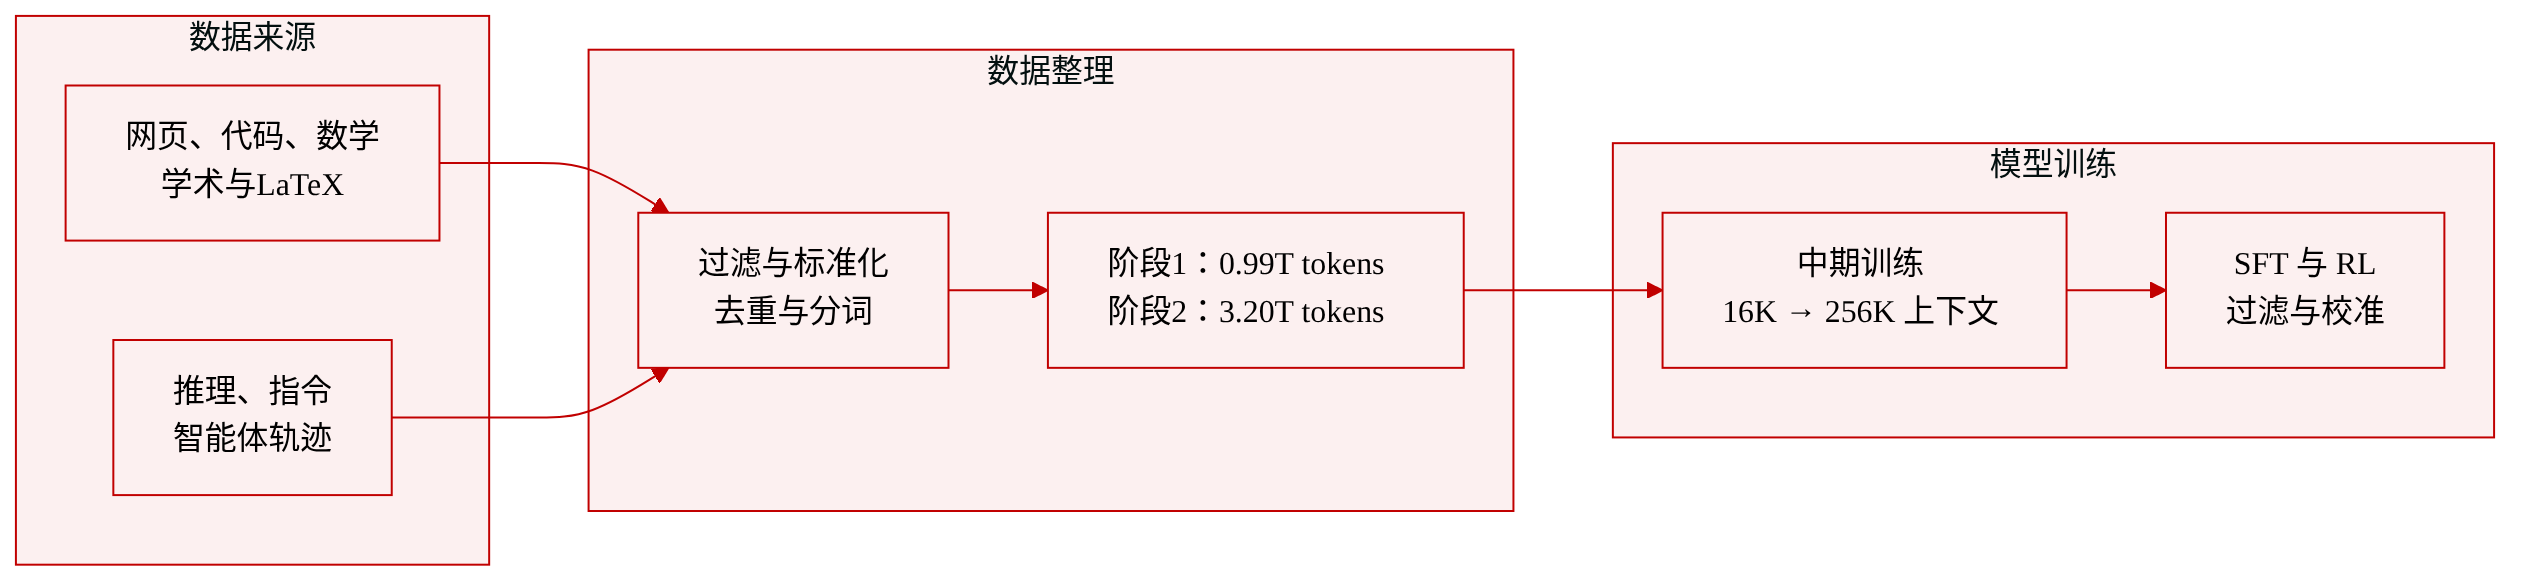
作者构建了一个多阶段训练语料库,针对通用预训练、中期训练和后训练分别采用不同的数据方案。以下是数据集组成、来源、处理和用途的详细说明。
通用预训练(阶段 1 和阶段 2)
- 作者首先使用一个在约 30B token 上训练的 0.3B 参数代理模型搜索最优数据混合比例,根据知识、代码和数学的损失与评估信号进行迭代。
- 最终的通用预训练语料库在阶段 1 包含约 0.99T token,在阶段 2 包含 3.20T token。网络数据在两个阶段中都是最大的来源;阶段 2 提高了代码和数学的相对占比,引入了专门的推理组件,并保留了学术、OCR 和 LaTeX 内容。
- 网络数据: 精选英文网络语料是主要来源,辅以受控比例的中文网络数据。作者保留了经过验证驱动的过滤后得到的上游文档级质量分数和质量分层,然后将文本和语言元数据规范化为统一的文档表示。
- 学术和 OCR 数据: 作者将经过教育过滤的 PDF 视图与来自 Ai2 的 OCR 科学内容相结合,后者通过 olmOCR 流水线生成。对于 arXiv 论文,内部流水线在保留技术内容的同时提取和清洗文本。
- 代码数据: 代码混合包含代码丰富的网页和开源仓库文件。结构化发布被转换为文本视图,文件级元数据被规范化,仓库工件和非源代码内容被清理,同时保留程序、技术文档和解释性代码文本。
- 数学数据: 优先使用数学语料库中更高质量的层级,以及经过分类器过滤的网络数学和教科书集合,遵循 SmolLM2 数学方案。处理过程结合了启发式清洗、质量模型选择和保留公式的规范化,使 LaTeX 表达式保持在其推理上下文中,如 Proof-Pile-2 的做法。
- LaTeX 论文: 将 RedPajama-1T 的 arXiv LaTeX 源码切片与过滤后的近期 TeX 源相结合。接受的视图恢复主要文本流,过滤格式错误或内容贫乏的文档,并保留方程和科学结构。
- 专门推理数据: 面向推理的材料作为独立的源族保留。作者使用 Nemotron-Pretraining-Specialized-v1,验证源模式和版本,选择指定的高质量推理视图,并将其作为独立控制的混合组件纳入阶段 2。
- 每个源族都经过特定于源的语言和质量过滤、文本提取或仓库清理。被接受的文档被规范化为统一的记录模式,物化为带版本的切片,并注册到源清单中。这些切片使用 GLM-5.1 tokenizer 进行 token 化和索引。跨阶段去重会在采样前排除阶段 2 选择中的所有阶段 1 内容。
中期训练(面向能力持续预训练)
- 作者对候选池进行全池去重,得到 2.86T token,并从中构建了一个 600.51B token 的采样计划,分为 16K、64K 和 256K 上下文阶段。
- 最大序列长度在各阶段间逐步增加,遵循 Qwen2.5-1M 的多阶段上下文扩展方式。每个后续阶段都是累积的:64K 阶段包含 180.89B 个不超过 16K 的 token 和 59.11B 个位于 16K–64K 范围内的 token;256K 阶段结合了 127.81B 个不超过 16K 的 token、21.72B 个位于 16K–64K 范围内的 token 和 30.98B 个超过 64K 的 token。
- 16K 阶段以标准上下文长度训练,使用代码、数学、知识和推理的均衡混合。64K 阶段引入更长的文档和推理序列。256K 阶段增加超长文档、跨文档信息和长视野智能体轨迹,同时回放较短长度范围的数据。
- 代码和数学在整个课程中各自保持接近 20%。随着上下文长度的增长,知识数据从 10.50% 增加到 14.23%,智能体数据从 1.50% 增加到 3.30%。预训练回放从 13.00% 减少到 9.00%。网络、问答、推理和指令数据保持相对稳定。
- 推理数据: 来源被规范化为统一模式,并根据自包含性、答案证据和推理价值被路由到接受、重写、待定、保留或拒绝视图。具有不合适原始轨迹的有价值问题被提取为独立问题,由教师模型重构或改进,并在通过解析有效性、完整性、泄漏风险、重复性和可训练性检查后才被接受。
- 指令数据: 语料库包括源自 Tulu 和 FLAN 的数据,被转换为预训练兼容的原始上下文。流水线保留合法的短标签任务,将翻译风险子集路由到模型审查,并将选定的单轮示例改写为多轮讨论。
- 智能体数据: 涵盖通用交互轨迹和软件工程轨迹。通用轨迹被重构为马尔可夫决策过程风格的状态条件下一步动作预测示例。软件工程轨迹经过执行感知过滤,并保留用于规划、工具使用和迭代改进的交互上下文。
监督微调(SFT)
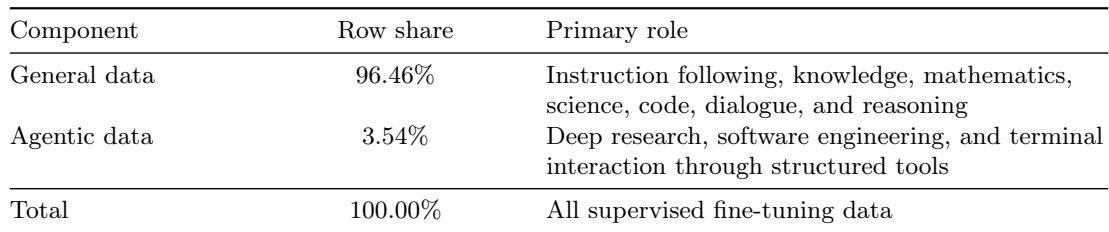
- SFT 语料库结合了开源数据集与内部蒸馏数据,包含 4,921,933 个示例,分为通用数据和智能体数据。所有示例都被规范化为统一的消息和工具模式,然后进行结构有效性、响应正确性和工具轮次一致性的过滤。
- 通用数据: 涵盖指令跟随、知识、数学、科学、代码、对话和推理。多阶段策展流水线使用确定性启发式规则,随后使用针对人工标注基准校准的基于模型的评估器。示例根据教育价值、逻辑严谨性、推理连贯性、事实一致性和安全合规性进行评分,然后分类为离散的质量层级。激进的层级过滤,即修剪约 50% 的原始候选,将六个基准的平均分从 67.78 提高到 68.83,收益集中在推理任务上。
- 去污使用 8-gram 匹配滑动窗口;任何与评估提示或参考答案的 8-gram 重叠超过 50% 的样本都会被清除。
- 混合消融扫描显示,不成比例地扩展长思维链(CoT)轨迹会引入冗长偏差。作者校准了长形式推理、直接回答问答和严格格式指令的比例。最终语料库交织了思考示例(结构化标签中的显式推理链)和不思考示例(简洁的即时响应)。
- 智能体数据: 包含三个分支:深度研究、软件工程和终端交互。每个任务族都将其训练模式与下游推理环境对齐,包括系统指令、消息角色、工具定义、结构化调用和观察位置。工具协议验证将特定于源的格式转换为目标结构化表示,验证参数结构和调用-观察配对,并丢弃不可恢复的示例。
- 深度研究:20,217 条多步骤研究轨迹被规范化为共享的交互环境,包含搜索和访问工具,以对齐的思考和不思考形式提供。
- 软件工程:30,014 条执行落地轨迹和 30,000 条无执行轨迹,经过过滤和评分,然后投影到 GLM-5.1 结构化工具格式。
- 终端:从隔离 Docker 环境中的终端任务环境收集轨迹,包含持久 shell 和结构化 bash 工具,在任务环境级别进行去重。配对源消融视图包含 22,309 条轨迹和一个包含 15,748 条轨迹的验证器成功子集。
- 将通用和智能体示例交织的联合调度优于顺序调度,并用于最终训练运行。
强化学习(RL)数据
- RL 语料库涵盖数学、代码和通用能力任务。提示难度通过初始策略的 rollout 进行估计,模型已经频繁解决的问题被移除,以将训练集中在能提供有用学习信号的提示上。
方法
ZGCM-1 采用仅解码器 Transformer 架构,约 7.39 亿参数,使用分组查询注意力、RMSNorm、SwiGLU 激活和旋转位置编码。该模型采用混合因果注意力主干,将门控滑动窗口注意力与全局注意力按 5:1 的局部到全局比例交错。在 32 个 Transformer 层中,27 层使用窗口大小为 128 个 token 的门控滑动窗口注意力,而五层使用全局因果注意力,按特定间隔放置以允许信息在局部窗口之外流动。
参考框架图:
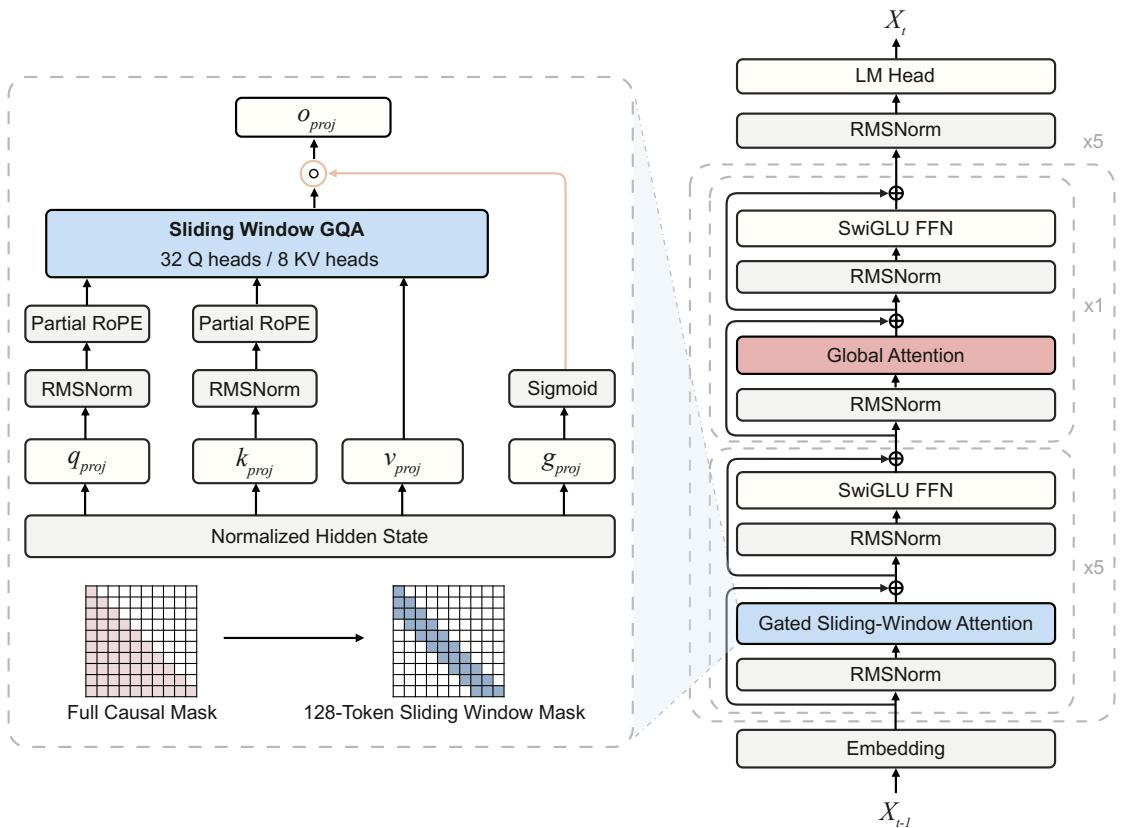
对于归一化隐藏状态 h,门控滑动窗口注意力模块并行形成查询、键、值和门控投影。RMS 归一化和部分 RoPE 应用于查询和键分支。门控注意力输出计算如下:
GatedSWA(h)=oproj(ASWA(q,k,v)⊙σ(gproj(h)))其中 ASWA(q,k,v) 表示 128-token 滑动窗口分组查询注意力输出,学习到的 sigmoid 门控在输出投影之前逐元素调制局部注意力输出。这种混合设计显著减少了推理时的键值缓存占用,将每 token 占用从 128 KiB 降至 20 KiB,从而支持高效处理长达 256K 的 token。
预训练过程包括两个连续阶段:通用预训练和中期训练。
如下图所示:
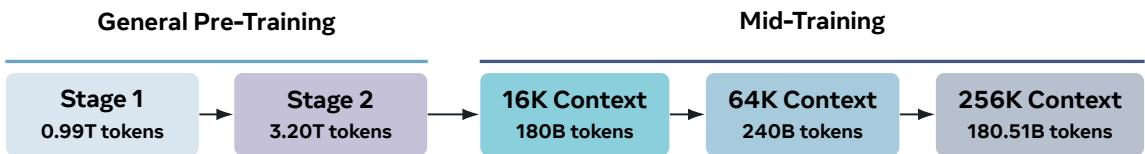
通用预训练在两个数据阶段中构建广泛的语言、知识、数学和代码能力。阶段 1 使用 0.99T token,包含课程式预训练阶段,其中通用语言文档按词汇复杂度排序,而代码和数学独立交错。阶段 2 将语料库扩展到 3.20T token,提高代码和数学的相对贡献并引入专门的推理数据。中期训练随后保留全序列因果语言建模目标,同时引入更密集的推理、指令和智能体数据,将上下文从 16K 逐步扩展到 64K 和 256K。
这些阶段的数据混合组成经过精心平衡,以优化能力覆盖和损失收敛效率。
参考数据混合图表:
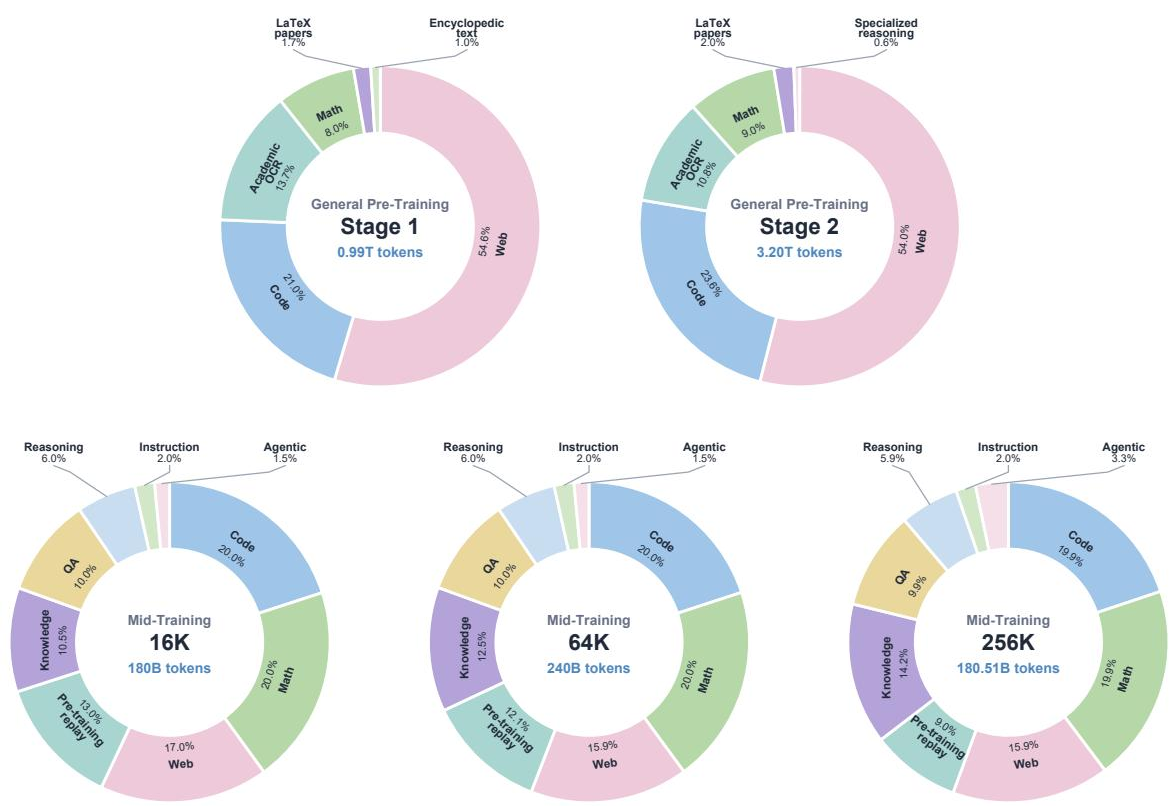
网络数据在通用预训练期间始终是最大的来源。在中期训练期间,代码和数学各自保持接近 20%,以保持核心编程和推理能力。随着上下文长度增长到 256K,知识和智能体数据的密度增加,以支持长文档和多步任务示例,同时保持预训练回放以维持广泛覆盖。
对于智能体数据的构建,作者利用 AI 驱动的自迭代治理过程来开发和验证特定于源的处理方案。
如治理流水线图所示:
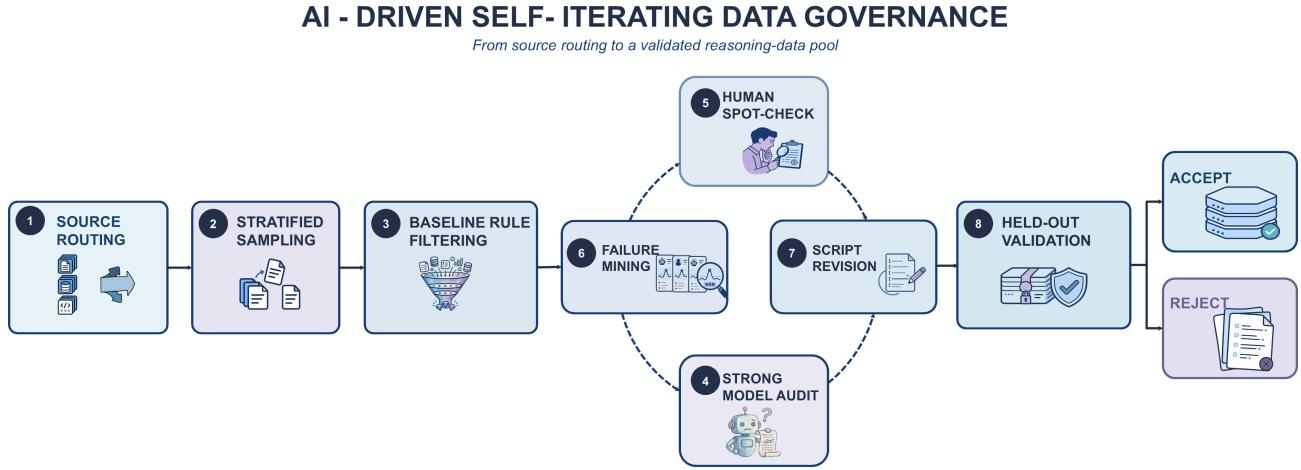
该流水线独立路由和采样每个源族,通过特定于源的规则过滤、强模型审计、失败挖掘、人工抽查和迭代脚本修订进行处理,然后被接受的示例进入经过验证的推理数据池。
后训练流水线包括监督微调,随后是混合强化学习。监督微调阶段使用统一的思考和直接响应监督目标建立响应模式,将显式推理链与简洁响应交织,使模型能够动态切换全面深思与高效零样本响应。强化学习阶段使用组相对策略优化与领域特定奖励,结合基于结果的奖励、参考策略 KL 正则化和轻度长度惩罚,以稳定长视野优化。
实验
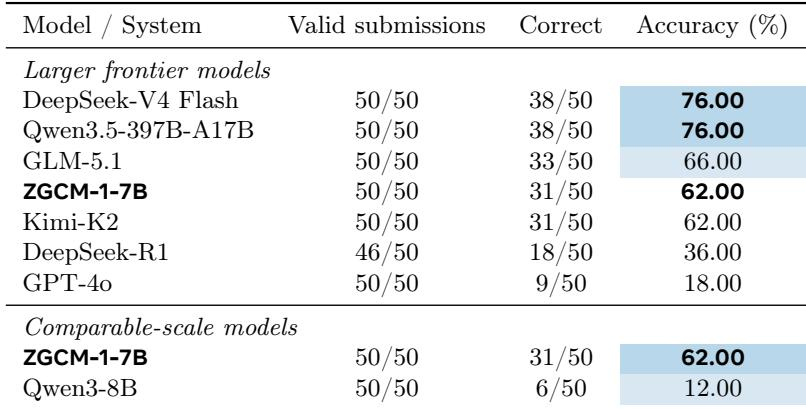
注意力变体的实验表明,SWA 5:1 在匹配全注意力损失的同时实现了最高吞吐量,其速度优势从 4K 上下文下的 1.13 倍扩大到 256K 下的 3.94 倍。混合架构在 256K 上下文下将 KV 缓存内存减少 6.4 倍,直接提高了解码效率。训练监控揭示了跨领域的能力发展异质性,并识别出通过周期性 CUDA 缓存清理解决的吞吐量下降问题。7B 模型在 20 个基准和两个智能体设置中的评估显示出竞争性性能,特别是在二进制函数搜索中达到 62% 的准确率,而相似规模基线仅为 12% 或更低。贡献者对研发生命周期中 AI 自主性的评估发现,操作任务达到 L4 自主性,而设计任务保持在 L2。
监督微调语料库主要由通用数据组成,涵盖指令跟随、知识和推理等领域,并包含少量用于工具和环境交互的智能体部分。分层策展流水线过滤质量,去污移除与评估集重叠的样本。数据质量的重要性得到了修剪候选可以提高基准性能这一发现的支持。通用数据占语料库的 96% 以上,智能体数据低于 4%。策展流水线使用基于规则的检查和基于模型的评分来分配质量层级。去污移除任何与评估数据 8-gram 重叠超过 50% 的样本。修剪一半候选池提高了平均基准性能,尤其是在推理任务上。
ZGCM-1-7B 在众多推理和通用基准上与其他 7B–8B 规模模型相比表现出竞争性或优越的性能,特别是在 MATH-500 和 HMMT 2025 上表现突出。其优势在推理密集型任务中最为明显,而一些模型在特定 AIME 子集上表现更好。ZGCM-1-7B 在所有对比模型中取得了 MATH-500 的最佳分数。ZGCM-1-7B 在 HMMT 2025 和 HMMT 2026 上领先,得分明显高于大多数同类模型。在 AIME 2024 和 AIME 2025 上,ZGCM-1-7B 落后于 DeepSeek-R1-0528-Qwen3-8B 和 MiniCPM4.1-8B,但仍优于多个其他基线。ZGCM-1-7B 最大的性能优势出现在 HMMT 基准上,其得分明显超过第二名模型。
ZGCM-1-7B 在网络环境深度研究基准上表现强劲,在 WebWalkerQA 和 BrowseComp 上领先,同时在 GAIA 纯文本上保持竞争力。在二进制函数搜索中,其准确率达到 62%,远超相似规模基线,接近更大的前沿模型。ZGCM-1-7B 在所有对比系统中取得了最佳 WebWalkerQA 分数,包括专门的研究智能体和更大的开放权重模型。在 BrowseComp 上,ZGCM-1-7B 优于所有开源基线,仅次于 Kimi-K2。对于 GAIA 纯文本,ZGCM-1-7B 与专门智能体和开放权重模型具有竞争力,尽管 Kimi-K2 领先。在二进制函数搜索中,ZGCM-1-7B 达到 62% 的准确率,远超相似规模基线(Qwen3-8B 为 12%,其他为 0%),接近 GLM-5.1 的 66%。
该表评估了多个模型的二进制函数搜索准确率,表现最佳的模型达到 76% 的准确率。像 ZGCM-1-7B 这样的较小模型表现出竞争性性能,超越相似规模基线并接近更大的前沿模型。DeepSeek-V4 Flash 和 Qwen3.5-397B-A17B 以 76% 的准确率并列第一。GLM-5.1 达到 66% 的准确率,而 ZGCM-1-7B 和 Kimi-K2 均达到 62%。ZGCM-1-7B 以大幅优势超越相似规模基线,准确率远超 Qwen3-8B 和其他小模型。DeepSeek-R1 尽管是更大的模型,但仅达到 36% 的准确率,落后于其他模型。
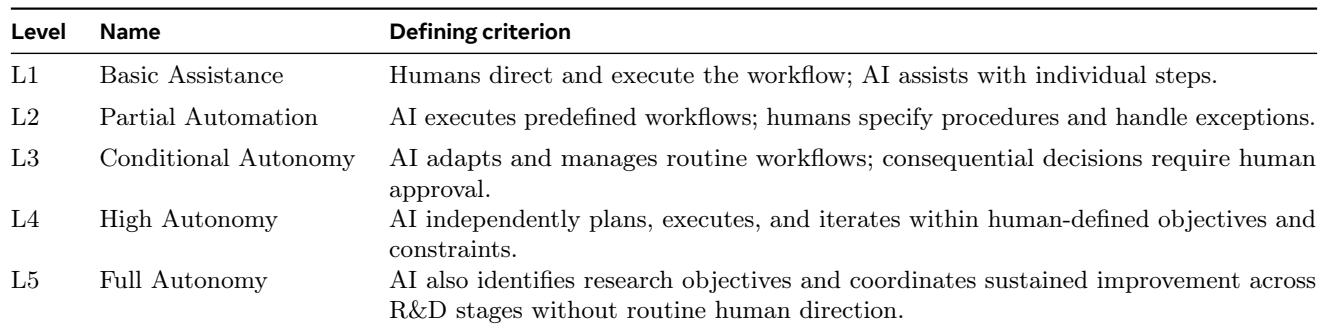
该表定义了研发工作流中 AI 自主性的五级评分标准,从基础辅助到完全自主。九位贡献者对 11 个任务类别的评分显示,自主性是不均匀且依赖任务的,操作任务达到比设计任务更高的水平。分配的级别集中在 L2 到 L4 之间,没有任务被评为高于 L4,表明完全自主尚未实现。实验和部署工程等操作任务达到 L4,而模型架构和学习算法设计等设计任务保持在 L2,从未超过 L3。99 个评分中只有一个是 L5,没有任务被分配高于 L4,因此工作流的自主性更适合按任务描述,而非单一总体级别。L4/L5 边界由自主目标形成定义:L4 在人类定义的目标内工作,而 L5 还识别研究目标并跨阶段协调。
评估设置结合了分层数据策展流水线与跨推理、通用知识和智能体任务的基准测试。结果表明,修剪一半候选语料库提高了平均基准性能,尤其是在推理任务上,并且 ZGCM-1-7B 在 MATH-500 和 HMMT 等推理密集型基准上与相似规模模型相比具有竞争力或优越性,同时在特定 AIME 子集上落后于部分同类模型。在网络环境深度研究任务中,ZGCM-1-7B 在 WebWalkerQA 和 BrowseComp 上领先,其二进制函数搜索准确率(62%)远超相似规模基线,接近更大的前沿模型。单独的自主性评分评估表明,研发工作流自主性依赖任务,操作任务达到 L4,但设计任务保持在 L2–L3,且没有任务超过 L4,表明完全自主尚未实现。