Command Palette
Search for a command to run...
SAS:通过端到端上下文排序优化实现简易注意力稀疏化
SAS:通过端到端上下文排序优化实现简易注意力稀疏化
Zhiwei Li Lei Zhu Hao Gu Xiang Hu Yan Wang Haitao Mi Sirui Han Leowei Liang Zhijiang Guo
摘要
训练后注意力稀疏化通过为每个查询选择一小部分上下文单元(词元或块),降低了预训练 Transformer 的二次累积注意力成本。现有的可训练方法通常依赖一个轻量级选择器对上下文单元进行评分,然后进行硬 Top-K 选择,这会阻断来自语言建模损失的梯度。因此,这些方法通常转而蒸馏逐层的稠密注意力分布。虽然这种方式鼓励选择器按照原始模型中的稠密注意力权重对上下文单元进行排序,但这种排序并未与固定注意力预算(即每个查询所关注的上下文单元数量)下它们对模型最终预测的影响直接对齐,从而可能将有限的注意力预算浪费在用处较小的单元上。为解决这种排序错位问题,我们提出了简易注意力稀疏化(SAS),这是一种门控稀疏注意力机制,能够利用语言建模损失端到端地优化上下文排序。其核心思想是在训练期间将选择器的连续分数注入注意力 logits 中,使语言建模损失能够通过标准反向传播更新选择器。我们确定了若干对使这一简易设计在实践中行之有效的关键选择:将对数形式的门置于注意力 softmax 内部,使用归一化 softmax 门来校准历史上下文与始终保留的当前块,以及保留连续的选择器分数,使模型学习相对优先级而非仅进行硬选择。为支持长序列训练,我们实现了一个内存高效的 Triton 内核,将我们的方法集成到 FlashAttention 风格的计算中。在推理、长上下文理解和智能体任务中,SAS 在不同注意力预算下均一致优于可训练的稀疏注意力基线,尤其在紧预算下增益显著,展示出对下游任务更有效的上下文排序。
一句话总结
来自腾讯混元大模型前沿团队和香港科技大学(广州与香港)的研究人员提出简单注意力稀疏化(Simple Attention Sparsification,SAS),一种门控稀疏注意力机制,通过将连续的选择器分数注入注意力 logits,并将门控置于 softmax 内部的对数域中,实现端到端的上下文排序优化,在推理、长上下文理解和 agentic 任务上持续优于可训练的基线方法,尤其在预算紧张时表现突出。
核心贡献
- SAS 将连续的对数域门控注入注意力 softmax 内部,使得上下文选择器能够通过语言建模损失进行端到端训练,而非逐层的注意力蒸馏。
- 设计依赖于三个关键选择:对数形式的门控置于 softmax 内部、对历史上下文与始终保留的当前块进行校准的归一化 softmax 门控、以及保持连续的选择器分数以学习相对优先级而非仅硬选择。
- 一个内存高效的 Triton 内核将 SAS 集成到 FlashAttention 风格的计算中以支持长上下文训练;SAS 在推理、长上下文理解和 agentic 任务上超越可训练的稀疏注意力基线,尤其在注意力预算紧张时增益最大。
引言
长上下文自回归推理产生的二次注意力成本已成为部署大语言模型的关键效率瓶颈。训练后注意力稀疏化通过将每个查询限制在上下文块的子集上,无需架构修改或重新训练来解决该问题。现有方法要么使用不能适应预测行为的固定启发式规则,要么通过逐层蒸馏密集注意力分布来训练可学习的选择器。这种蒸馏会导致排序偏差:它教选择器模仿密集注意力关注的位置,而非哪些上下文单元真正提升最终预测,同时忽略了跨层互补性和值矩阵效应。作者提出 SAS,一种端到端的优化范式,使选择器分数在注意力 softmax 内部可微,从而能够直接用语言建模损失进行训练。他们识别出关键的设计选择——对数空间门控注入、softmax 归一化门控、连续分数保留和高效的稀疏更新——这些设计产生了稳定且有信息量的梯度。SAS 持续超越先前的训练后稀疏化方法,在推理、长上下文理解和 agentic 任务上,在注意力预算紧张时提升显著。
方法
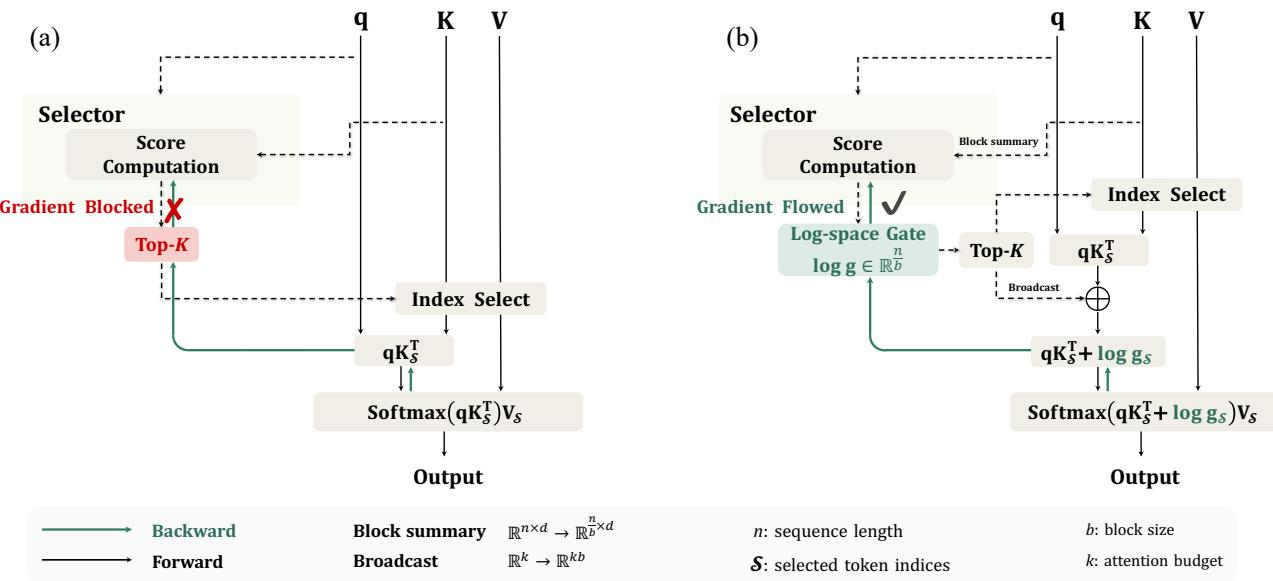
作者提出了 SAS(简单注意力稀疏化),一种基于语言建模损失训练轻量级选择器以对上下文块进行排序的方法。其核心思想是将稀疏块选择重新定义为一种可微的上下文排序问题。选择器并不直接生成离散的 Top-K 集合,而是学习对候选历史块的连续排序,该排序随后作为稀疏选择的基础。
为了使这种块排序可学习,选择器分数必须在训练中影响注意力计算。作者将上下文分割为始终保留的当前块 B0 和 C 个候选历史块 H={B1,…,BC}。选择器为历史块生成相关性分数 s∈RC,这些分数被转换为正门控值 g=ϕ(s)∈R+C,而当前块保持单位门控 g0=1。这些门控调制注意力计算,从而使语言建模损失的梯度能够回流至选择器。
这种可微分排序的有效性取决于四个关键设计要素:门控位置、门控激活、排序保留和训练范围。
如下图所示:
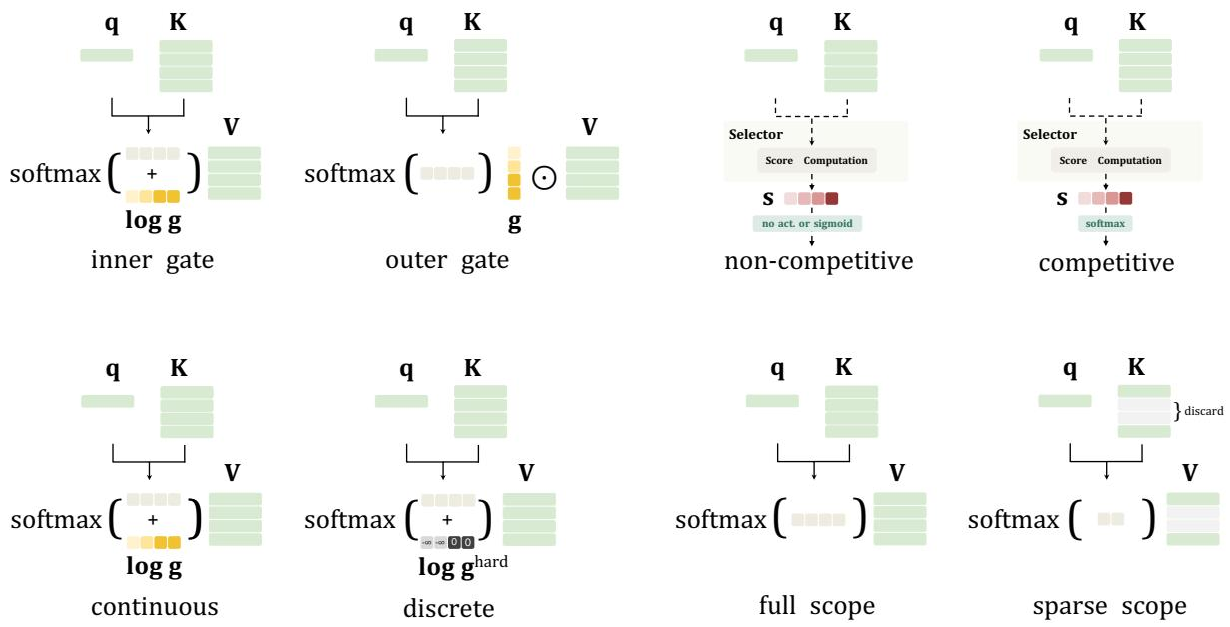
首先,门控位置决定了门控是注入 softmax 内部,oinner=softmax(qK⊤+logg)V,还是应用在 softmax 之外,oouter=softmax(qK⊤)(g⊙V)。其次,门控激活定义了如何转换块分数,对比了归一化 softmax 门控、独立 sigmoid 门控以及未归一化的 logit 注入。第三,排序保留决定了训练时是使用连续的软门控,还是通过 Straight-Through Estimator 将其压缩为离散的硬 Top-K 门控。最后,训练范围控制模型是否接收来自所有上下文块的梯度,还是仅接收选定稀疏子集的梯度。
基于对这些要素的控制消融实验,作者通过四个具体选择实例化 SAS:内部 softmax 门控注入、softmax 门控激活、保留排序信息的软门控,以及稀疏训练范围。训练过程中,选择器计算分数 s=Rθ(q,{KBm}m=1C),并转换为归一化门控 g=softmax(s)。选择 Top-K 历史块,并将它们的门控广播到 token 级别。最终的注意力计算公式为:
oSAS=softmax(qKS⊤+loggS)VS其中选定的历史块接收到归一化的对数门控偏置,而当前块保持不偏置。在推理时,学习到的连续排序会被离散化为 Top-K 块索引。
为了高效实现,作者设计了一个专门的 FlashAttention 风格 Triton 内核。该内核在流式扫描期间将块门控融合到 tile 级别的 qKS⊤ 计算中。它将归一化的对数门控添加到选定历史块的注意力 logits 中,遮蔽未选中的块,并执行标准的在线 softmax 更新,而无需物化完整的注意力矩阵。反向传播通过在每个选定的历史块内求和注意力 logit 梯度来累积块级对数门控梯度,从而在维持内存效率的同时支持稀疏训练范围。
实验
SAS 通过语言建模损失端到端训练轻量级块选择器,涵盖训练后稀疏化(冻结大语言模型,仅用数学数据训练)和继续预训练(联合训练骨干与选择器),并在推理、长上下文理解和 agentic 任务上进行评估。该方法持续优于基于蒸馏的稀疏注意力,常常在适中的块预算下恢复完整的注意力准确率,同时即使仅用数学数据训练,也能稳健地迁移到长上下文和工具使用场景。分析表明,SAS 的选择在跨层上更具互补性,产生更短的生成轨迹和更少的截断,并且其解码效率随上下文长度增长可扩展至大幅加速(例如,批大小为 8 时超过 10 倍)。
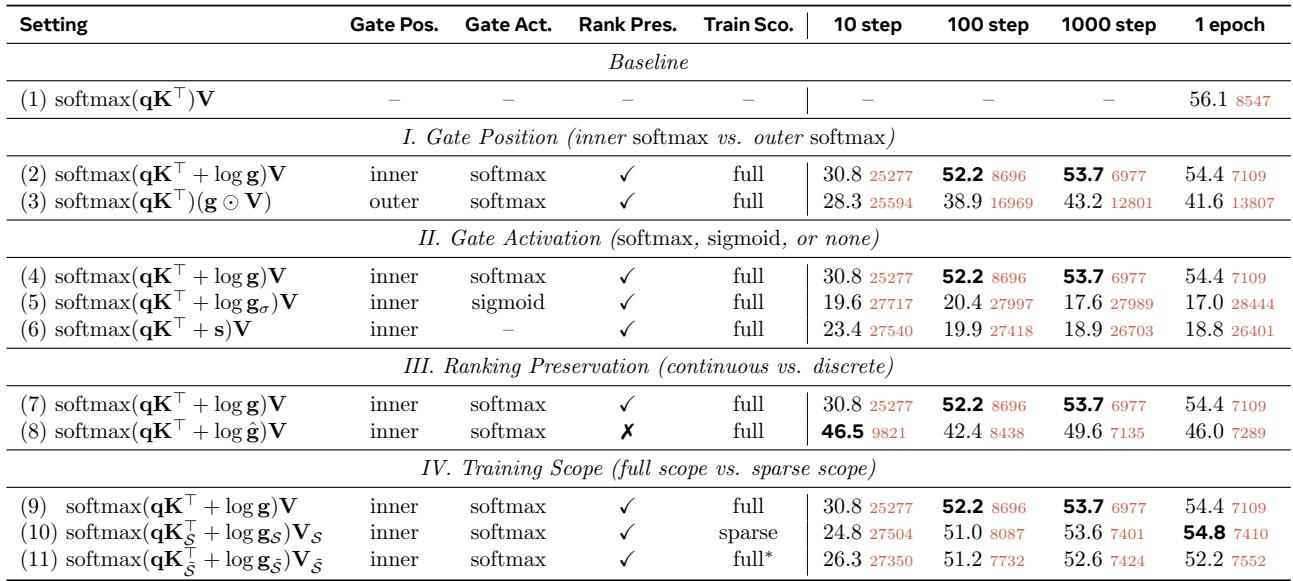
将门控放在注意力 softmax 内部明显优于放在 softmax 之后,能够达到接近无门控基线的准确率,同时缩短生成长度。softmax 归一化门控对于将历史上下文与当前块进行校准至关重要,从而带来更好的性能和训练稳定性。内部 softmax 门控在一个 epoch 后达到 54.4% 的准确率,生成长度为 7,109 token,几乎与基线的 56.1% 持平,远超外部门控的 41.6% 以及更长的 13,807 token 输出。softmax 门控激活优于 sigmoid 和未归一化 logit 注入,原因在于它能够将历史上下文与具有单位门控的当前块进行归一化,从而实现稳定训练和更高的最终准确率。
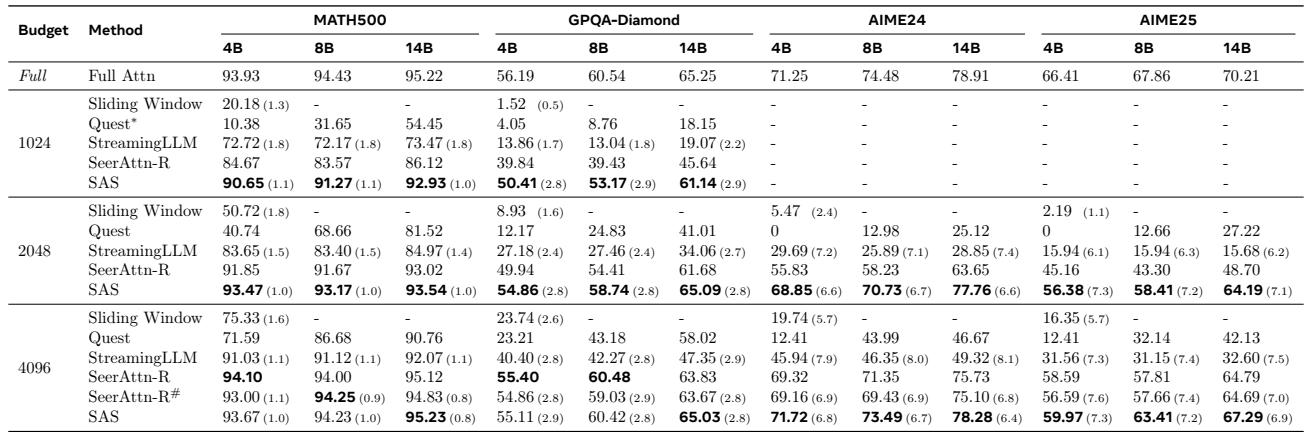
SAS 在推理基准上大幅优于所有稀疏注意力基线,尤其在 token 预算紧张时。用于训练选择器的语言建模损失比 SeerAttention-R 所使用的注意力蒸馏更有效,并且在适中的预算下,SAS 可以达到甚至超越完整注意力的准确率。在仅 1024 token 的预算下,SAS 保持推理准确率接近完整注意力,而滑动窗口和查询感知的 Quest 等静态稀疏方法则崩溃。SAS 持续击败使用相同门控架构但通过注意力蒸馏训练的 SeerAttention-R,证实了语言建模目标在稀疏选择上的优越性。在 4096 token 预算下,SAS 恢复了完整注意力的推理能力,例如在 AIME24 上,Qwen3-4B 的 SAS (71.72) 超越完整注意力 (71.25)。
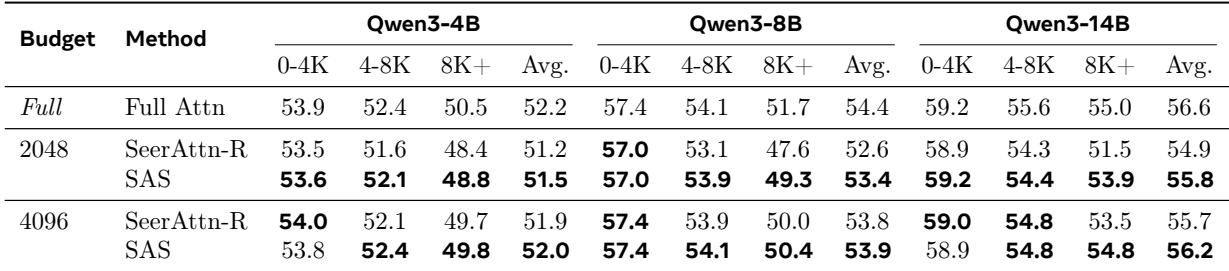
SAS 在 LongBench 上的所有预算和模型规模下均优于 SeerAttention-R,并在更长输入上增益更大。在 4096 token 预算下,SAS 几乎追平完整注意力,表明仅用数学数据训练的选择器能有效迁移到长上下文理解。SAS 在 8K+ token 桶上对 SeerAttention-R 有所提升,最显著的是 Qwen3-14B 在预算 2048 时提高 +2.4 分。在预算 4096 时,SAS 在 Qwen3-14B 上恢复了完整注意力性能(平均 56.2 vs 56.6),尽管存在与数学训练的分布偏移。
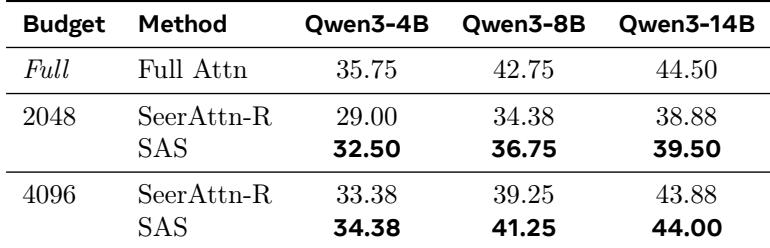
在多轮 agentic 基准上,SAS 在所有测试的模型规模和 token 预算下始终优于 SeerAttention-R 稀疏方法。在 4096 token 预算下,SAS 几乎追平完整注意力的准确率,在更紧的 2048 token 预算下展现出明显提升,表明端到端选择器训练对于复杂交互任务的有效性。SAS 在所有骨干模型和预算下均击败 SeerAttention-R,其中 Qwen3-4B 在 2048 token 预算下提升 +3.5 分。在 4096 token 预算下,SAS 几乎完全恢复完整注意力性能(Qwen3-14B 上 44.00 vs 44.50)。
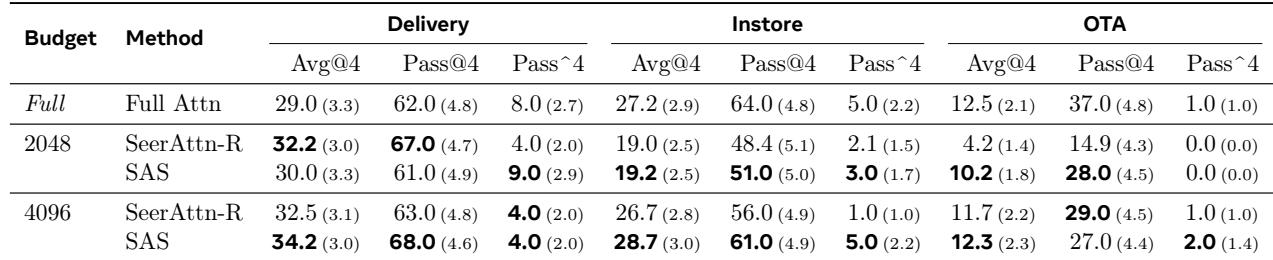
在 Qwen3-14B 的 VitaBench 上,SAS 在预算 2048 和 4096 的 Delivery、Instore 和 OTA 场景中的大多数指标上均优于 SeerAttention-R。在 4096 token 预算下,SAS 非常接近完整注意力性能,表明端到端稀疏选择在真实的长时程工具使用设定中仍然可靠。在预算 4096 下,SAS 的 Delivery Pass@4 达到 68.0,超过 SeerAttention-R (63.0) 和完整注意力 (62.0)。在预算 2048 的 OTA 场景中,SAS 在 Pass@4 上较 SeerAttention-R 高出两倍以上(28.0 vs. 14.9),并将 Avg@4 从 4.2 提升至 10.2。
评估首先确立了将门控置于注意力 softmax 内部并使用 softmax 激活对于稳定训练以及在生成紧凑输出的同时保持接近无门控基线的准确率至关重要。在推理、长上下文理解、多轮 agentic 任务和现实工具使用基准上,选择器通过语言建模目标端到端训练的 SAS 持续超越用注意力蒸馏训练的稀疏注意力方法。在适中的 token 预算下,SAS 恢复或几乎追平完整注意力性能,表明由语言建模训练的选择器能有效从数学数据迁移至多样的长上下文和交互式场景。