Command Palette
Search for a command to run...
打破视觉–动作捷径:面向可泛化机器人基础模型的潜在接口训练
打破视觉–动作捷径:面向可泛化机器人基础模型的潜在接口训练
Jianman Lin Shailesh Shailesh Zhongyi Luo Jiafei Duan
摘要
机器人基础模型在分布内性能表现强劲,但在视觉分布偏移下往往性能下降。当模型从预训练的视觉表征中学习生成动作时,可能会利用与训练分布内演示动作相关的、与任务无关的视觉线索。当这些相关性在分布偏移下发生变化时,此类视觉–动作捷径会损害泛化能力。要缓解这些捷径,需要在保留任务相关空间信息的同时,约束视觉信息用于动作生成的方式。我们提出潜在接口训练(LIT),这是一种与框架无关的两阶段策略:第一阶段在不使用图像的情况下建立以空间目标为条件的动作先验,第二阶段通过位姿监督的潜在接口约束视觉条件。第一阶段训练动作专家,使其根据语言、机器人状态以及每个演示动作块的末端执行器 SE(3) 终端位姿生成动作块,从而独立于视觉线索学习目标导向的动作生成。第二阶段引入一个潜在接口,该接口聚合视觉和语义表征,并作为预训练动作专家的唯一视觉条件通路。该接口通过监督学习来重建此前用于条件化第一阶段的终端位姿,促使其保留动作生成所需的目标相关空间信息。在四种视觉–语言–动作和世界–动作架构——π0.5、MolmoAct2、FAST-WAM 和 ImageWAM——上,LIT 将 LIBERO-Plus 整体成功率提升了 3.87 至 10.70 个百分点,同时保持或提升了平均 LIBERO 成功率。真实世界评估显示,在未见过的相机配置、光照变化和干扰物条件下,三个任务汇总的成功率提升了 13.30 至 16.70 个百分点。
一句话总结
作者提出潜在接口训练(LIT),一种两阶段框架,通过首先学习无图像的目标条件动作先验,然后通过姿态监督的潜在接口约束视觉信息,从而缓解视觉-动作捷径问题。该框架在LIBERO-Plus上针对四种架构(π0.5、MolmoAct2、FAST-WAM和ImageWAM)取得3.87至10.70个百分点的提升,在真实世界任务中面对未见摄像头配置、光照变化和干扰物时取得13.30至16.70个百分点的提升,显著增强了机器人基础模型的泛化能力。
核心贡献
- 潜在接口训练(LIT)是一种与框架无关的两阶段策略,通过将动作专家的视觉条件限制在姿态监督的潜在接口上,缓解视觉-动作捷径问题。
- 在第一阶段,动作专家在无图像条件下仅利用语言、机器人状态和每个动作块的末端SE(3)末端执行器姿态进行预训练。在第二阶段,潜在接口聚合视觉和语义表征,并在监督下重建该末端姿态,作为动作专家的唯一视觉条件路径。
- 将LIT应用于π0.5、MolmoAct2、FAST-WAM和ImageWAM后,在保留LIBERO性能的同时,零样本LIBERO-Plus成功率提升3.87至10.70个百分点,并在真实世界三个任务中,面对未见摄像头设置、光照变化和干扰物时获得13.30至16.70个百分点的提升。
引言
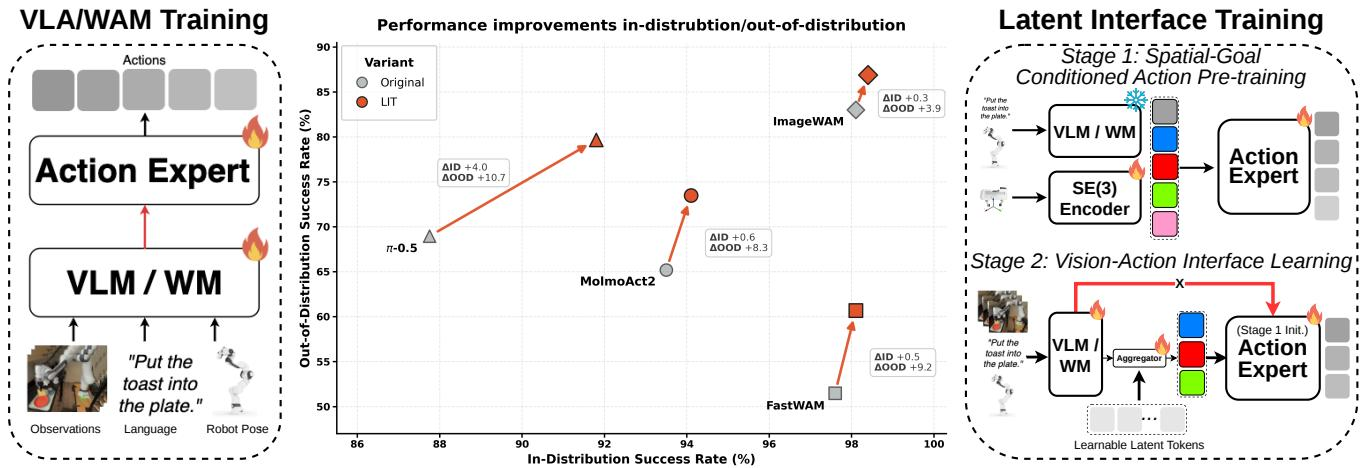
结合视觉-语言骨干与动作专家的机器人基础模型在分布内操作任务中表现强劲,但在视觉条件发生变化时往往难以泛化。由于动作专家接收丰富的视觉表征,它们可能依赖与训练动作相关的任务无关视觉线索——即视觉-动作捷径——而机器人演示数据中有限的视觉多样性会加剧这种依赖。以往工作尝试注入结构化空间信息或预训练无图像的动作先验,但这些方法并未直接约束动作专家在重新引入视觉输入时如何利用视觉信息。作者提出潜在接口训练(LIT),一种模型无关的两阶段策略,首先学习以空间目标为条件的无图像动作先验,然后仅通过姿态监督的潜在接口引入视觉条件。通过强制所有视觉信息经过该接口,并要求其重建预训练时使用的相同末端执行器姿态,LIT减少了视觉-动作捷径,同时保留了准确动作生成所需的空间信息。
方法
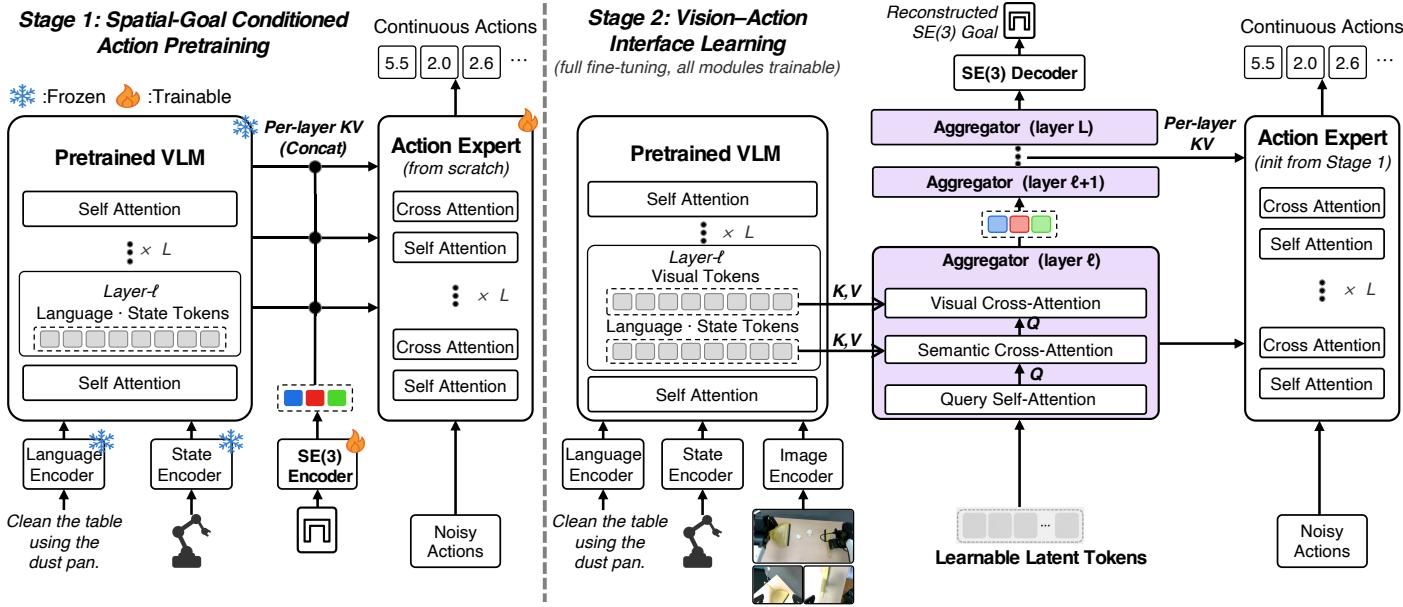
作者提出潜在接口训练(LIT),一种模型无关的两阶段策略,旨在减少视觉-动作捷径并保留任务相关的空间信息。整体框架首先建立无图像的动作先验,然后仅通过姿态监督的潜在接口引入视觉条件。
参考框架图:
问题设置 在每个时间步 t,策略接收视觉观察 ot、语言指令 l 和机器人状态 st,预测长度为 H 的动作块:
At=(at,…,at+H−1).对于每个演示动作块,使用末端机器人状态作为空间目标:
gt=[pt+H;rt+H;qt+H]∈R8,其中 p∈R3 和 r∈R3 表示世界坐标系下的末端执行器位置和轴角姿态,q∈R2 包含夹爪关节位置。该目标在第一阶段作为条件信号,在第二阶段作为重建目标。
第一阶段:空间目标条件的动作预训练 在第一阶段,作者从头训练动作专家,根据语言指令、机器人状态和末端姿态 gt 生成演示动作块,从而在没有任何视觉输入的情况下学习空间目标条件的动作先验。冻结的骨干仅处理语言指令和机器人状态,在 L 个耦合层的每一层产生语义表征 Hℓ,tsem。一个可训练的三层MLP(使用GELU激活)将目标 gt 映射为目标 tokens Gt,并与骨干表征拼接:
Gt=Eη(gt),Cℓ,t=[Hℓ,tsem;Gt],ℓ=1,…,L.这些拼接的 tokens Cℓ,t 通过原生条件机制为相应的动作专家层提供条件。作者保留了框架的流匹配目标。他们采样 τ∼U(0,1) 和 ϵ∼N(0,I) 构建带噪声的动作块和目标速度:
Atτ=(1−τ)ϵ+τAt,vt⋆=At−ϵ.给定条件 tokens,动作专家预测速度并最小化先验损失:
vtτ=vθ(Atτ,τ;C1:L,t),Lprior=EAt,τ,ϵ[∥vtτ−vt⋆∥22].仅更新动作专家参数 θ 和SE(3)编码器参数 η,骨干及其模态编码器保持冻结。
第二阶段:视觉-动作接口学习 在第二阶段,动作专家从第一阶段初始化,视觉条件仅通过姿态监督的潜在接口引入。作者定义可学习的潜在 tokens Z0∈RK×d,各输入共享,其中 K=100。对每个策略输入,接口从 Z0,t=Z0 开始。在耦合层 ℓ,骨干提供语言和状态表征 Hℓ,tsem 以及视觉表征 Hℓ,tvis。潜在 tokens 通过自注意力、语义交叉注意力和视觉交叉注意力更新:
Zℓ,t=Zℓ−1,t+SAq(ℓ)(Zℓ−1,t),Zℓ,t=Zℓ,t+CAq(ℓ)sem(Zℓ,t;Hℓ,tsem),Zℓ,t=Zℓ,t+CAq(ℓ)vis(Zℓ,t;Hℓ,tvis),ℓ=1,…,L.潜在 tokens 在每个交叉注意力操作中作为查询,骨干表征提供键和值。为参数效率,每 m 个连续耦合层共享接口注意力参数,索引为 q(ℓ)=⌈ℓ/m⌉。更新后的 tokens 为动作专家层提供条件,预测速度:
vtτ=vθ(Atτ,τ;Z1:L,t).一个MLP解码器从最终潜在 tokens 重建末端目标状态 gt:
gt=Dω(ZL,t),Lpose=∥gt−gt∥22,Lstage2=Lact+λposeLpose.作者设置 λpose=0.3。该重建损失鼓励接口保留目标相关信息。第二阶段联合优化骨干、动作专家、潜在 tokens、接口注意力模块和MLP解码器。
框架集成与推理 LIT在预训练骨干和动作专家之间引入潜在接口,使其适用于多种架构。该接口通过各架构的原生机制提供逐层条件,同时保留原始架构和目标。推理时,潜在接口保持激活,而姿态编码器和姿态解码器被移除。策略仅需视觉观察、语言和机器人状态,遵循原生的动作采样和执行流程。
实验
LIT在多种VLA和WAM架构上进行了评估,在保持或略微提升分布内任务性能的同时,持续增强了在多样视觉和任务扰动下的零样本泛化能力。真实世界机器人实验证实了对光照、摄像头和干扰物变化的鲁棒性提升,分析表明LIT通过将视觉信息路由经过姿态监督的潜在接口,降低了对虚假视觉相关性的依赖。消融研究进一步证实,空间目标条件动作预训练、姿态监督和受限视觉访问这三者的结合对于这些增益至关重要。
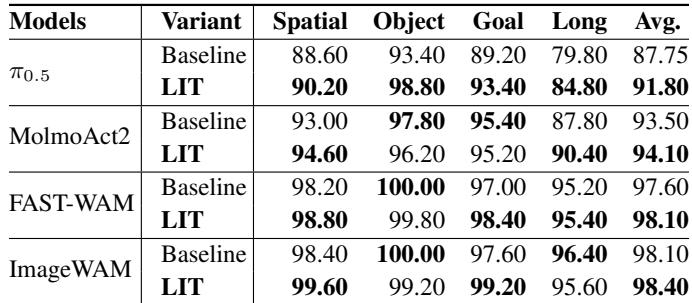
LIT在LIBERO上跨多种架构一致提升了基线模型的分布内成功率。性能提升在较低性能基线模型上更为显著,而已经较强的模型如FAST-WAM仅获得边际收益。ImageWAM达到了最高的总体平均分,在物体和目标子任务上取得完美或接近完美的分数。LIT将基础模型的平均成功率从87.75%提升到91.80%,超过4个百分点;而FAST-WAM的提升缩小到0.5个百分点(从97.60%到98.10%)。ImageWAM在物体子任务上达到100%,在目标子任务上达到97.60%,在所有评估变体中取得最高的分布内平均成功率(98.10%)。
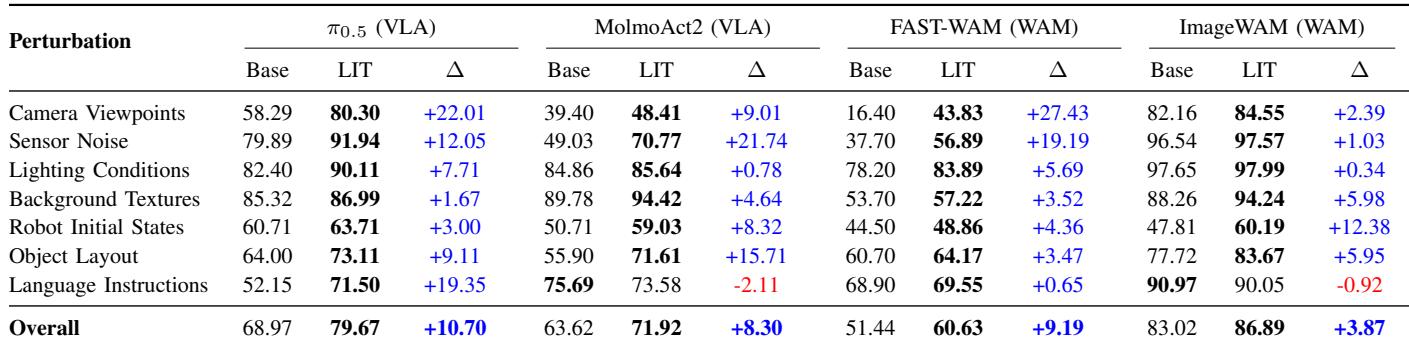
LIT在LIBERO-Plus上为所有评估的操作架构带来了一致的零样本提升,其中在摄像头视角变化和传感器噪声下绝对增益最大。从低基线起步的架构获益最多,而已经鲁棒的模型如ImageWAM主要在机器人初始状态变化下获得明显改进。消融研究表明,受限视觉通路和姿态监督对于这种泛化不可或缺,特别是针对任务无关的视觉扰动。对于π₀.₅ VLA,LIT在摄像头视角变化下成功率提升22.0个百分点,在传感器噪声下提升12.1个百分点。MolmoAct2在传感器噪声下提升21.7个百分点,在物体布局变化下提升15.7个百分点。FAST-WAM基线仅16.4%,应用LIT后在摄像头视角扰动下提升27.4个百分点。ImageWAM在传感器噪声和光照上已超过96%;其在机器人初始状态下的最大LIT增益为12.4个百分点。去除姿态监督导致传感器噪声性能下降10.8个百分点,背景纹理性能下降6.0个百分点。让动作专家直接获取视觉通路将总体OOD成功率从71.9%降至67.7%,支持了受限潜在接口的重要性。
LIT在总体分布外成功率上相比MolmoAct2基线有显著提升,其三个设计元素——第一阶段动作预训练、姿态监督和受限视觉通路——都为增益做出了贡献。移除任何一个组件都会降低泛化能力,而其他更简单的设计方案无法达到LIT的水平,表明空间目标条件先验、显式姿态重建和仅通过潜在视觉瓶颈的组合对于观察到的鲁棒性至关重要。移除第一阶段动作预训练会降低总体OOD成功率,特别是在机器人初始状态和物体布局变化下,证实了空间目标条件预训练有助于视觉策略适应。消融姿态监督在传感器噪声和背景纹理场景下导致最大下降,这与空间目标监督提高对任务无关视觉扰动鲁棒性的想法一致。允许动作专家直接获取视觉而非通过潜在接口,降低了OOD成功率,支持了受限视觉通路对于泛化的重要性。仅训练潜在 token 聚合而不使用动作先验和姿态监督,相比基线仅有微弱改善,表明仅潜在接口远不够。不使用LIT特定组件或简单地将姿态监督添加到基线的分阶段训练,OOD成功率均仅约65.5%,远低于LIT,排除了这些更简单的解释。
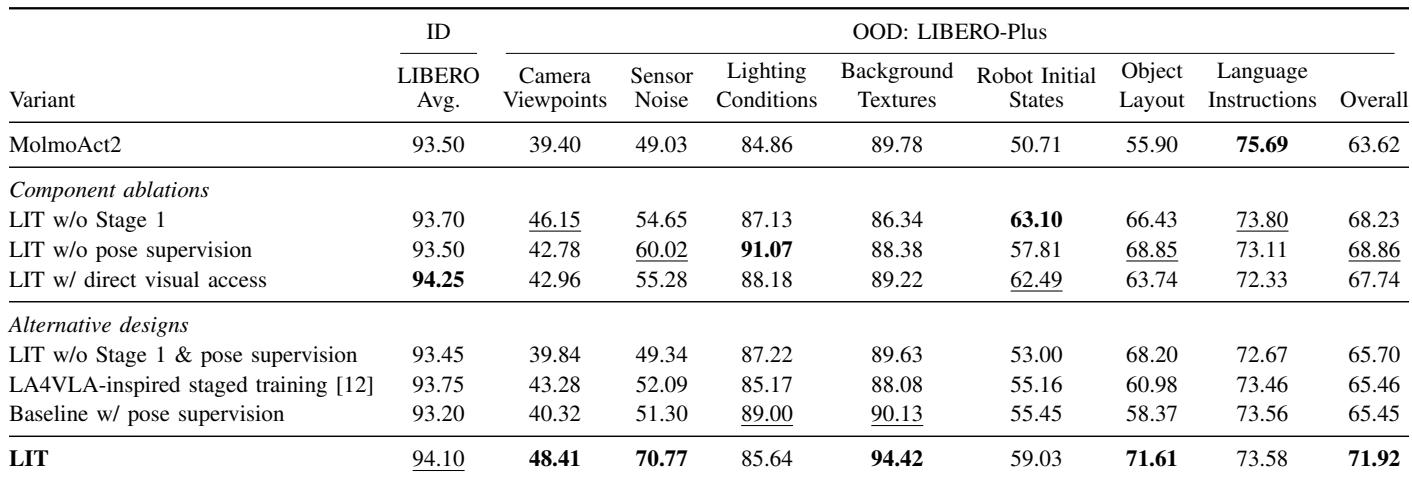
实验评估了LIT在LIBERO上的分布内性能和LIBERO-Plus上面对多样扰动的零样本泛化能力。LIT持续提升成功率,对较低性能基线增益最大,而已经较强的模型仅获边际收益。在摄像头变化、传感器噪声和视觉变化下,受限视觉通路和显式姿态监督被证明对鲁棒性至关重要,消融实验确认了所有三个设计组件——空间目标条件动作预训练、姿态重建和仅潜在瓶颈——共同支撑了观察到的分布外改进,排除了更简单的替代方案。