Command Palette
Search for a command to run...
突破 Token 上限:蒸馏更小、更强的字节模型
突破 Token 上限:蒸馏更小、更强的字节模型
Kalyani Marathe Artidoro Pagnoni Tomasz Limisiewicz Margaret Li Mike Lewis Luke Zettlemoyer Srinivasan Iyer
摘要
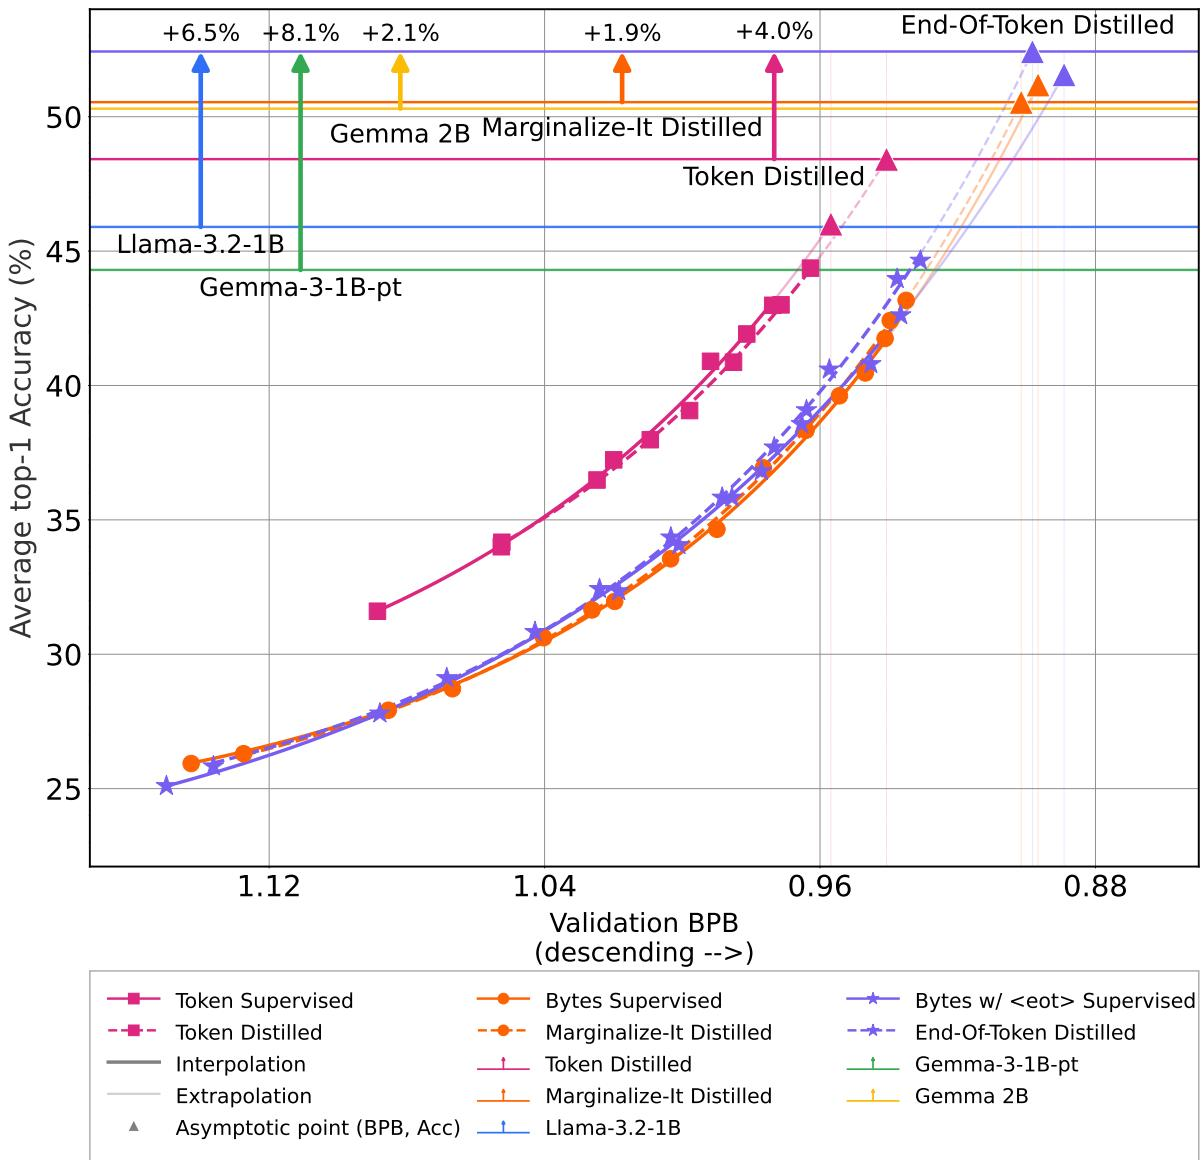
通过从共享相同分词方案的较大模型中蒸馏,小模型的能力得以增强。然而,随着计算量和数据量的增加,蒸馏后的字节模型和 Token 模型在扩展趋势上是否表现相似?为便于比较,我们引入了两种变体,以高效地将 Token 逻辑转换为字节逻辑:1) 近似方法:边际化(Marginalize-It),2) 精确方法:Token 结束(End-Of-Token)。随后,我们首次开展了大规模研究,对仅解码器的密集 Transformer 模型进行过度训练,同时改变两个维度:分词方案(Token、字节、带 的字节)和训练目标(蒸馏 vs. 交叉熵),扫描了约 10 亿参数、层参数匹配的模型,数据量高达 1 万亿字节。在涵盖三个类别(多项选择问答、语言生成和机器翻译)的八个基准测试中,我们发现 Token-1B 模型在低 FLOP 区域表现优于字节模型(End-Of-Token-1B 和 Bytes-1B),但最终趋于平稳;字节模型初始表现较差,但随着计算量增加,它们超越了 Token-1B 模型,达到了更高的下游任务性能上限。外推平均 top-1 错误率与验证 BPB 的扩展定律预测,渐近情况下,蒸馏的 End-Of-Token-1B 在平均下游任务性能上比蒸馏的 Token-1B 高出最多 4%。它们的数据效率也更高,仅使用六分之一的训练数据即可匹配蒸馏 Token-1B 的性能。此外,通过操作约 256 字节的小词汇表而非约 100K 个 Token,它们避免了在逻辑转储期间进行 top-k 截断的需求,同时将逻辑存储成本降低至约五分之一。最后,我们的下游性能扩展定律预测,蒸馏的 End-Of-Token-1B 模型在平均下游任务上渐近超越 Llama 3.2-1B 模型(Meta AI, 2024)、Gemma-3-1B-pt(Kamath 等, 2025)和 Gemma 2B(Team 等, 2024)模型,分别最多提升 6.5%、8.1% 和 2.1%。
一句话总结
来自华盛顿大学和 Meta FAIR 的研究者提出了 Marginalize-It 和 End-Of-Token 两种方法,将 token 级 logits 蒸馏为字节级 logits。研究发现,对约 1B 参数的稠密 transformer 进行过度训练后,字节模型在更多计算量下超越 token 模型,下游性能最高提升 4%,数据效率提升 6×,同时将 logit 存储成本降至 51。
核心贡献
- 提出了两种将 token 级 logits 转换为字节级 logits 的方法:Marginalize-It,一种通过边缘化前缀匹配 token 分布的近似方法;以及 End-Of-Token,一种通过添加
<eot>token 来保留教师分布的精确方法,避免了多次推理带来的计算开销。 - 首次对约 12.8 亿层参数的仅解码器稠密 transformer 模型进行大规模扩展研究,在多达 1 万亿字节的数据上扫描不同的 tokenization 方案(Tokens、Bytes、Bytes with
<eot>)和训练目标(蒸馏 vs. 交叉熵),结果表明字节模型初始表现较差,但随着计算量增加在下游性能上超越 token 模型,且仅需六分之一的训练数据即可匹配 token 模型的性能。 - 在八个基准测试和推断的扩展定律下,蒸馏的 End-Of-Token-1B 模型在平均下游任务上渐近优于蒸馏的 Token-1B 模型最高达 4%,通过在 256 字节词表而非约 10 万 token 上操作将 logit 存储成本降至约五分之一,并预计分别超越 Llama 3.2-1B、Gemma-3-1B-pt 和 Gemma 2B 最高达 6.5%、8.1% 和 2.1%。
引言
扩展已成为提升语言模型性能的主导策略,但实际部署同样要求成本效率。模型常被蒸馏为更小但能力相当的版本,或通过过度训练来分摊推理成本,然而随着计算规模扩大,学生模型的 tokenization 选择如何与这些技术相互作用仍不清楚。以往将 token logits 转换为字节 logits 进行蒸馏的工作需要多次前向传播,当教师推理成本高昂时这种方法代价过大。作者通过引入两种单次前向传播的 logit 转换方法来解决这一问题:Marginalize-It(近似)和 End-Of-Token(精确),这两种方法无需 top-k 截断即可保留教师分布。他们开展了一项涵盖训练目标和 tokenization 方案的大规模扩展研究,为验证 bits-per-byte 和下游任务性能拟合幂律。研究结果表明,蒸馏的字节模型(尤其是 End-Of-Token 变体)随计算量增加以更陡峭的速率提升,并在渐近意义上超越基于 token 的蒸馏,同时带来数据和存储效率的提升。
数据集
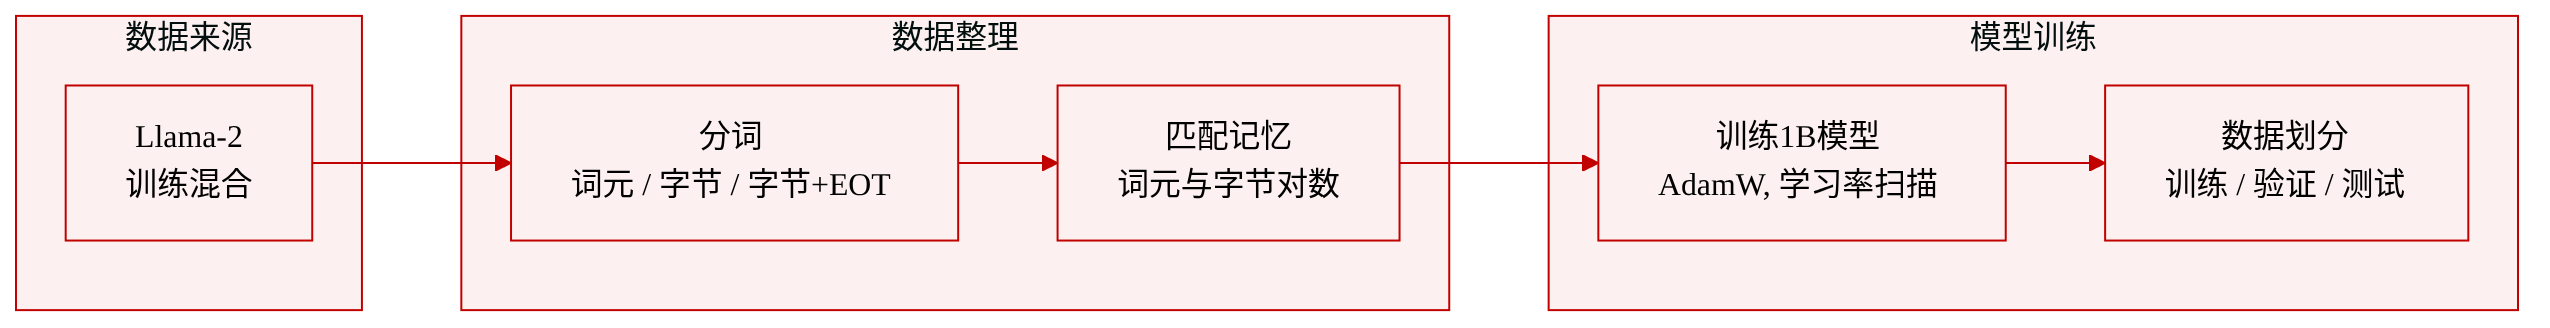
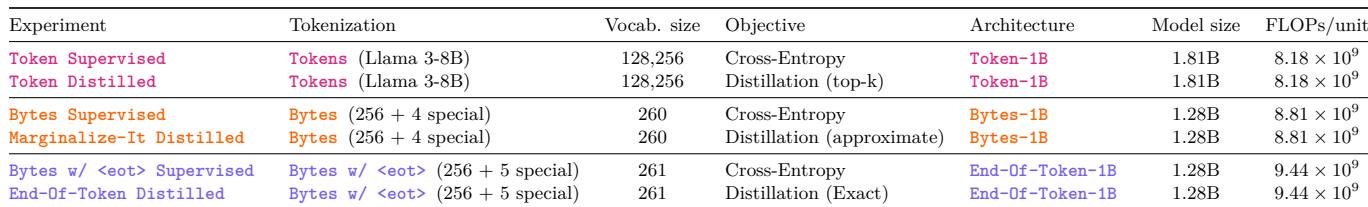
作者围绕三种模型变体设计实验,所有变体均约 10 亿参数且层参数匹配:Token-1B、Bytes-1B 和 End-Of-Token-1B。虽然总层参数相同(1.28B),但 Token-1B 因词表更大而整体规模更大(1.81B)。所有模型均使用 Llama-3 transformer 实现。
训练数据方面,作者在有监督和蒸馏实验中均使用 Llama-2 训练混合数据。研究设计确保对于相同数据量,token logits 和字节 logits 占用相同的内存空间,完整的存储成本分解见附录 A.6。
实验设置包含六种不同配置,沿两个维度进行扩展探索:tokenization 方案(Tokens、Bytes、Bytes with <eot>)和训练目标(有监督交叉熵损失和蒸馏)。这些设置详见表 1,模型规模和每单位 FLOPs 数据来源于表 9。对于 Marginalize-It 和 End-Of-Token 蒸馏变体,作者应用了第 2 节描述的 logit 转换过程。
训练使用 AdamW 优化器,对每个数据规模在三个学习率(1e-3、4e-3、8e-3)上进行扫描,并采用 10% 的预热步数。更多损失函数细节见附录 A.3。
方法
作者利用 Marginalize-It 和 End-Of-Token 两种方法,在扩展研究中高效地将 token logits 转换为字节 logits。
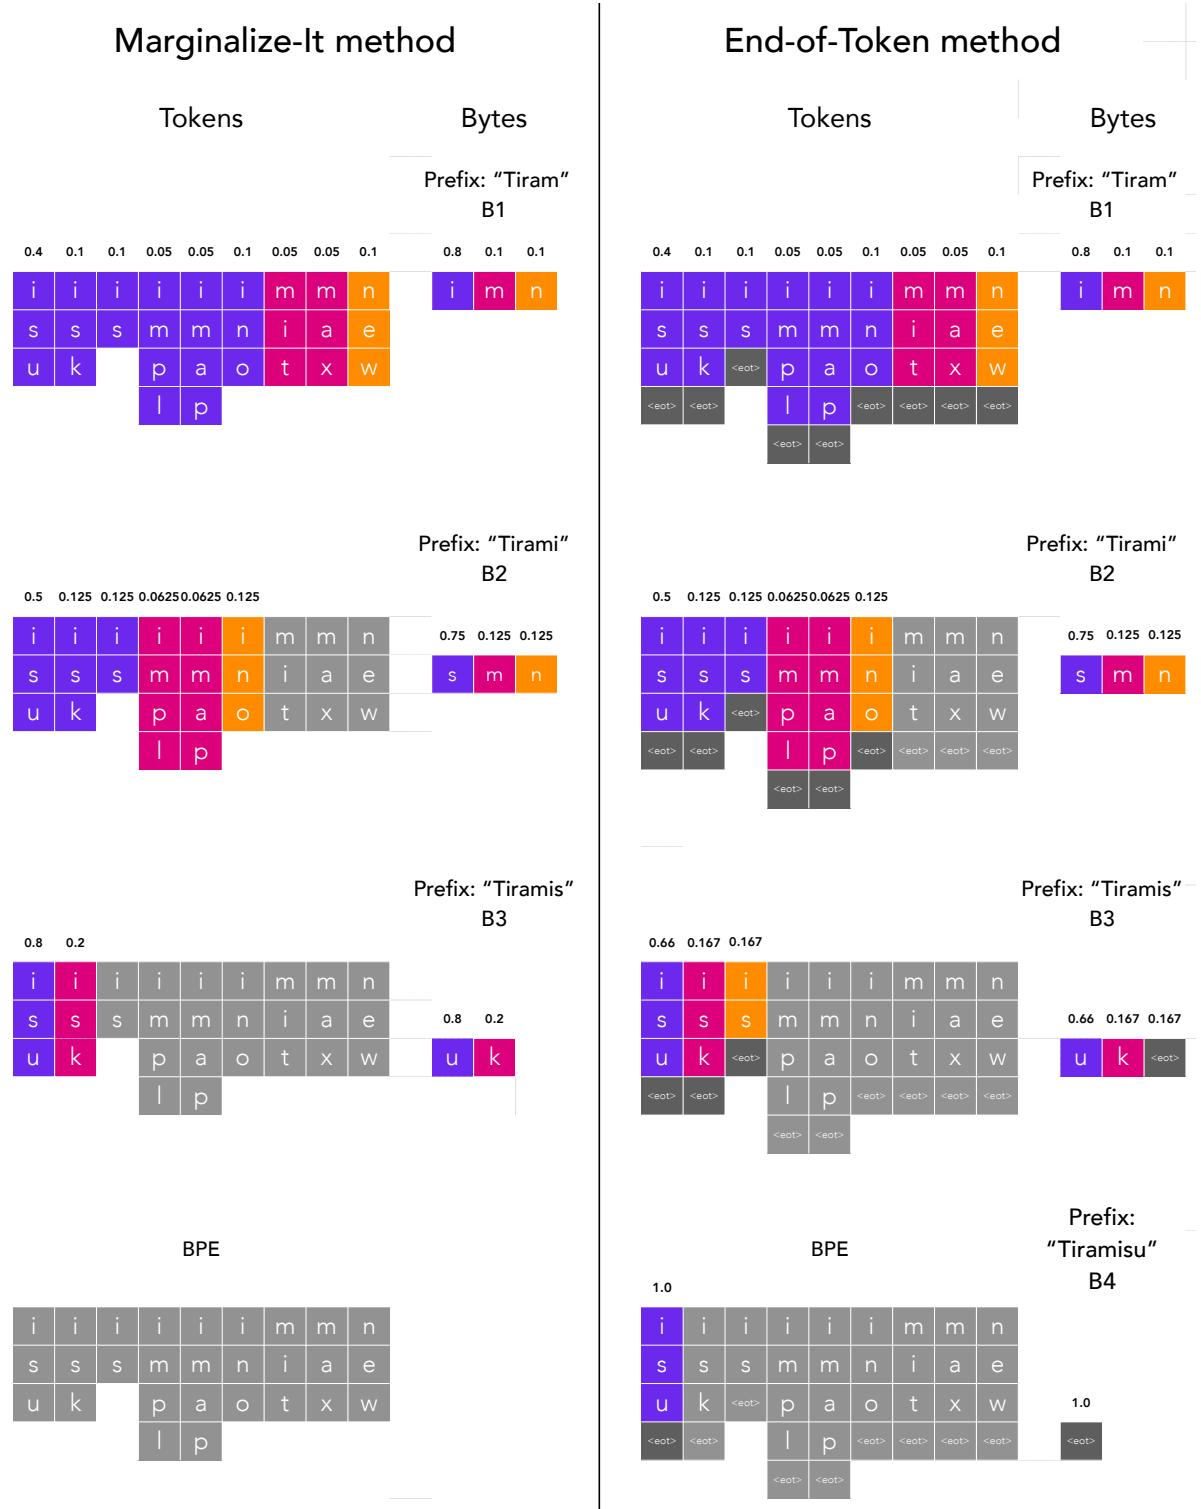
对于 Marginalize-It 方法,作者从教师推理得到的 ∣V∣ 大小 logits 张量出发,其中 V 是 BPE tokenizer 的词表。为计算每个 BPE token 的第一个字节分布,他们基于第一个字节对整个词表 V 进行边缘化。对于后续字节,他们将词表限制为前缀与真实字节匹配的 token,并在此子集上计算条件字节分布。虽然第一个字节的分布是精确的,但后续字节分布是近似的。例如,当预测第三个字节的分布时,某些 token 的延续可能被静默丢弃,剩余概率会在存活的 token 之间重新分配。具体而言,概率被重新计算为:
P(isu)=0.5+0.1250.5=0.8,P(isk)=0.5+0.1250.125=0.2.为解决 Marginalize-It 方法中固有的概率缺失问题,作者引入了 End-Of-Token 方法。该方法在每个 BPE token 末尾添加 <eot> token,并将字节词表扩展一个位置以存储 <eot> 概率。随后在字节位置上进行边缘化以形成字节 logits。训练时,在预训练数据中每个 BPE token 后追加 <eot> token。该方法是精确的,将可能延续的概率质量吸收到 <eot> token 中,无需额外的教师推理。对于同样的第三个字节预测,概率变为:
如下图所示:
作者采用 transformer 架构训练层参数匹配的约 10 亿参数模型,具体为 Token-1B、Bytes-1B 和 End-Of-Token-1B 变体。虽然三种架构的总层参数相同(1.28B),但 Token-1B 因词表更大而整体规模更大。设计选择遵循 Llama-3 实现。训练方面,他们在有监督和蒸馏实验中使用 Llama-2 训练混合数据,确保相同数据量下 token logits 和字节 logits 占用相同内存。模型使用 AdamW 优化器训练,在三个学习率 ∈{1e-3,4e-3,8e-3} 上扫描,每个数据规模采用 10% 的预热步数。
实验
该研究在多项选择问答、语言生成和机器翻译基准上评估了 token 级和字节级模型(有无蒸馏)。蒸馏模型在验证 bits-per-byte(BPB)和下游任务性能上均持续优于有监督对应模型,不过 token 模型在较低计算预算下初始表现更强,而字节模型提升更快并最终赶上。一个关键发现是,在不同 tokenization 方案和训练目标下,较低的 BPB 并不总是意味着更好的下游性能,因为字节模型可能取得更好的 BPB 却在任务准确率上更差。End-Of-Token 蒸馏方法展现出最佳渐近下游性能,所需文本数据更少,且存储成本比 token 蒸馏降低至五分之一。
该研究比较了六种因 tokenization 方案和训练目标而异的模型配置,所有配置层参数匹配但词表大小和每单位 FLOPs 不同。蒸馏模型,尤其是使用 end-of-token tokenization 的模型,展现出不同的扩展行为。其中 end-of-token 蒸馏在渐近下游性能和数据、存储效率上均优于基于 token 的蒸馏。End-of-token 蒸馏模型在渐近下游性能上超越 token 蒸馏模型,同时所需文本数据更少并降低存储成本。基于字节和 end-of-token 的模型在 bits-per-byte 上可超越 token 有监督模型,但在下游任务上表现更差,凸显了校准的重要性。在低计算预算下,token 蒸馏模型领先,但随着计算量增加,end-of-token 蒸馏模型超越基于字节的模型,并最终匹配或超过它们。
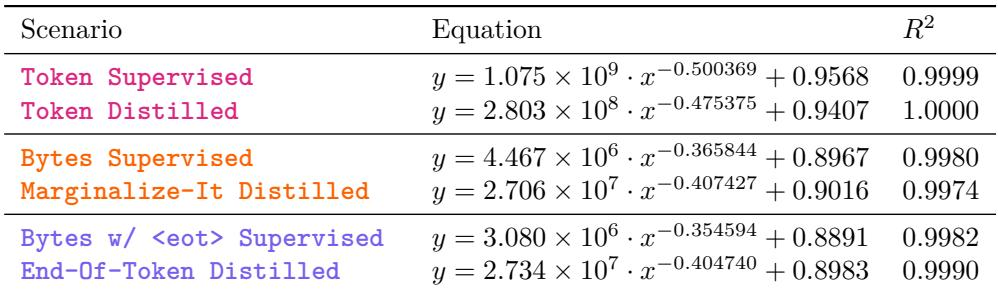
验证 BPB 对训练 FLOPs 的幂律拟合表明,蒸馏方法在 token 和字节训练中均达到比有监督对应方法更低的渐近 BPB。拟合高度精确,R 方值接近 1.0,基于字节的有监督训练达到最低的渐近 BPB。蒸馏方法在所有场景中均持续优于有监督对应方法的渐近 BPB。基于字节的有监督训练在所有场景中具有最低的渐近 BPB。所有拟合幂律均呈现非常高的 R 方值,表明拟合质量优异。
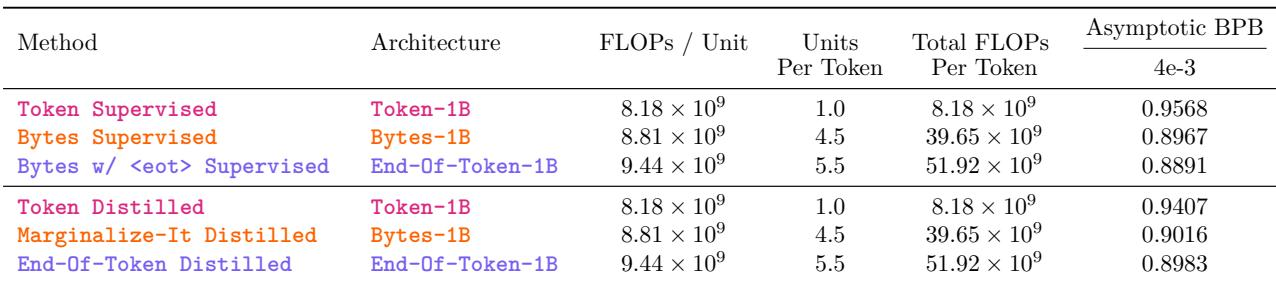
增加每 token 总 FLOPs 一致地降低有监督和蒸馏模型的渐近 BPB,蒸馏变体优于有监督对应模型。End-Of-Token 架构每 token 的 FLOPs 比 Bytes-1B 模型多约 31%,却在比较的设置中达到最低的渐近 BPB。蒸馏模型在所有架构中均实现比有监督对应模型更低的渐近 BPB。End-Of-Token-1B 每 token 的 FLOPs 比 Bytes-1B 多约 30.94%,但达到最佳的渐近 BPB。更高的每 token 总 FLOPs 与有监督和蒸馏模型更低的渐近 BPB 相关。
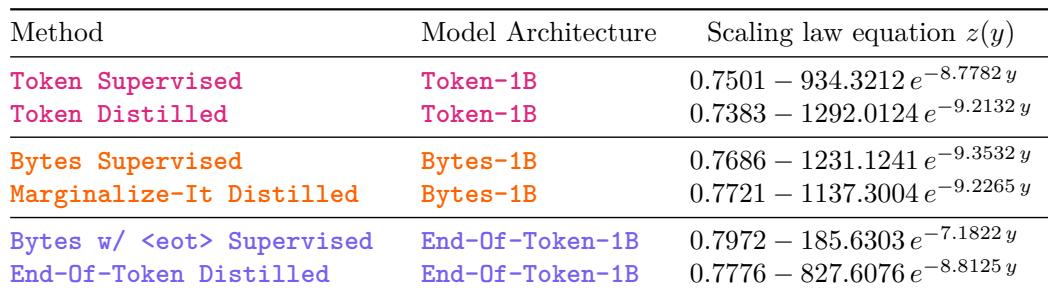
拟合的扩展定律显示,蒸馏变体通常达到比有监督对应模型更低的渐近下游任务误差,其中 End-Of-Token 蒸馏模型在六种变体中达到最佳渐近性能。基于字节的模型尽管改善了验证 BPB,但与基于 token 的模型相比并未将这一优势转化为更好的下游任务准确率。End-Of-Token 蒸馏在所有变体中达到最低的渐近下游误差,优于 Token 蒸馏和 Bytes w/ <eot> 有监督。Token 蒸馏的渐近误差低于 Token 有监督,表明蒸馏改善了同一架构的下游任务性能。Bytes 有监督和 Marginalize-It 蒸馏的渐近误差高于基于 token 的蒸馏模型,尽管其验证 BPB 曲线更好。扩展定律拟合显示渐近误差以不同速率趋近,其中 Bytes w/ <eot> 有监督模型的衰减最慢(gamma 最小),意味着其更缓慢地达到上界。
在渐近验证下,使用字节级和 end-of-token 蒸馏的模型在下游准确率上高于 token 有监督或 token 蒸馏模型,尽管其 bits-per-byte 值更低。End-of-token 蒸馏变体展现出最佳的渐近准确率,有监督字节模型也优于基于 token 的方法。End-of-token 蒸馏模型在所有变体中达到最高的渐近下游准确率。字节有监督和带 <eot> 的字节有监督模型在下游准确率上优于 token 有监督和 token 蒸馏模型。Token 蒸馏模型的渐近准确率低于基于字节的变体,尽管其 bits-per-byte 值更高。
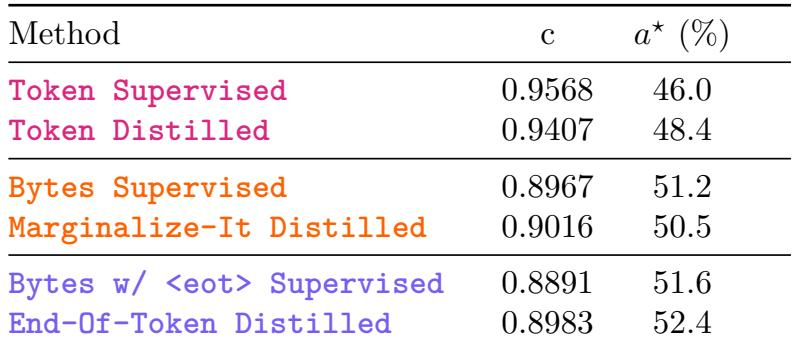
评估比较了六种在 tokenization 和训练目标上有所不同的模型配置,所有配置层参数匹配但词表大小和每单位计算量不同。蒸馏模型,尤其是使用 end-of-token tokenization 的模型,展现出不同的扩展行为:它们达到比基于 token 的有监督对应模型更低的渐近 bits-per-byte 和更好的下游准确率,同时降低数据和存储成本。然而,基于字节和 end-of-token 的模型在 bits-per-byte 上可超越 token 有监督模型,却在下游任务上表现更差,凸显了校准差距。在低计算预算下,token 蒸馏模型领先,但随着计算量增加,end-of-token 蒸馏模型超越它们,最终匹配或超过基于字节的变体,其中 end-of-token 蒸馏模型整体达到最佳的渐近下游性能。