Command Palette
Search for a command to run...
SenseNova-U1.5:迈向原生统一视觉智能
SenseNova-U1.5:迈向原生统一视觉智能
摘要
我们推出 SenseNova-U1.5,一个 8B-MoT 原生统一多模态模型,在无编码器、无 VAE 的架构中理解、推理并生成视觉内容。我们通过空间连贯的图块重建强化其视觉接口,并借助精心策划的生成与编辑数据、改进的任务形式化、结构化提示增强以及最高 4K 的原生分辨率来扩展训练规模。在后训练阶段,我们针对视觉美学、双语文本渲染、信息图生成和图像编辑优化了专用专家,并通过多专家在线策略蒸馏整合其能力。在广泛评测中,SenseNova-U1.5 大幅提升了图像保真度、文本渲染、复杂构图、多参考编辑和交错生成,同时改善了指令遵循能力,并能保持主体身份、几何结构及未修改区域。尽管生成数据中结构化格式的曝光有限,SenseNova-U1.5 仍能有效泛化到长、复杂且结构化的视觉指令,进一步证明多模态理解可以迁移至视觉规划与创作。这些发现共同表明,原生统一建模是迈向完全端到端感知、推理与创作系统的一条有前景的路径。我们将开源训练代码,包括监督微调、强化学习和在线策略蒸馏。
一句话总结
商汤科技等提出SenseNova-U1.5,一个8B-MoT原生统一多模态模型,在无编码器、无VAE架构中统一视觉理解、推理与生成,并通过空间一致patch重建和多专家在线策略蒸馏加以增强,在图像保真度、文本渲染与复杂编辑方面取得显著进展,同时可泛化至长程结构化视觉指令。
核心贡献
- 论文提出SenseNova-U1.5,一个8B-MoT原生统一多模态模型,在单一无编码器、无VAE架构中执行视觉理解、推理与生成,并通过空间一致patch重建强化其视觉接口。
- 设计了一套训练流程,借助精心筛选的生成与编辑数据、改进的任务形式化、结构化提示增强以及最高4K的原生分辨率进行扩展,随后通过后训练对美学、双语文本渲染、信息图生成与图像编辑等专门专家进行优化,并通过多专家在线策略蒸馏将其整合。
- 广泛评估表明,SenseNova-U1.5显著提升图像保真度、文本渲染、复杂构图、多参考编辑与交错生成,同时泛化至长程结构化视觉指令,为多模态理解可迁移至视觉规划与创作提供证据。
引言
作者着眼于视觉创作日益扩展的范围,如今已涵盖多语言排版、高分辨率渲染、多参考编辑与交错生成。多数系统通过预训练视觉编码器处理理解,通过VAE处理生成,形成分离的表示空间,阻碍无缝协调。SenseNova-U1等先前原生统一模型移除了这些分离管线,但将每个视觉token重建为独立RGB patch,导致高分辨率下可见接缝与纹理不连续。作者提出SenseNova-U1.5,一个8B-MoT模型,引入空间联合重建:token被投影到二维特征场,通过卷积与Pixel Shuffle逐步上采样,使相邻区域信息交换,实现一致4K生成。第二项进展以“先专精后统一”策略替代联合奖励优化,其中专用RL专家针对不同视觉能力优化,随后通过多专家在线策略蒸馏整合为单一策略,保留互补优势而不纠缠竞争目标。
数据集
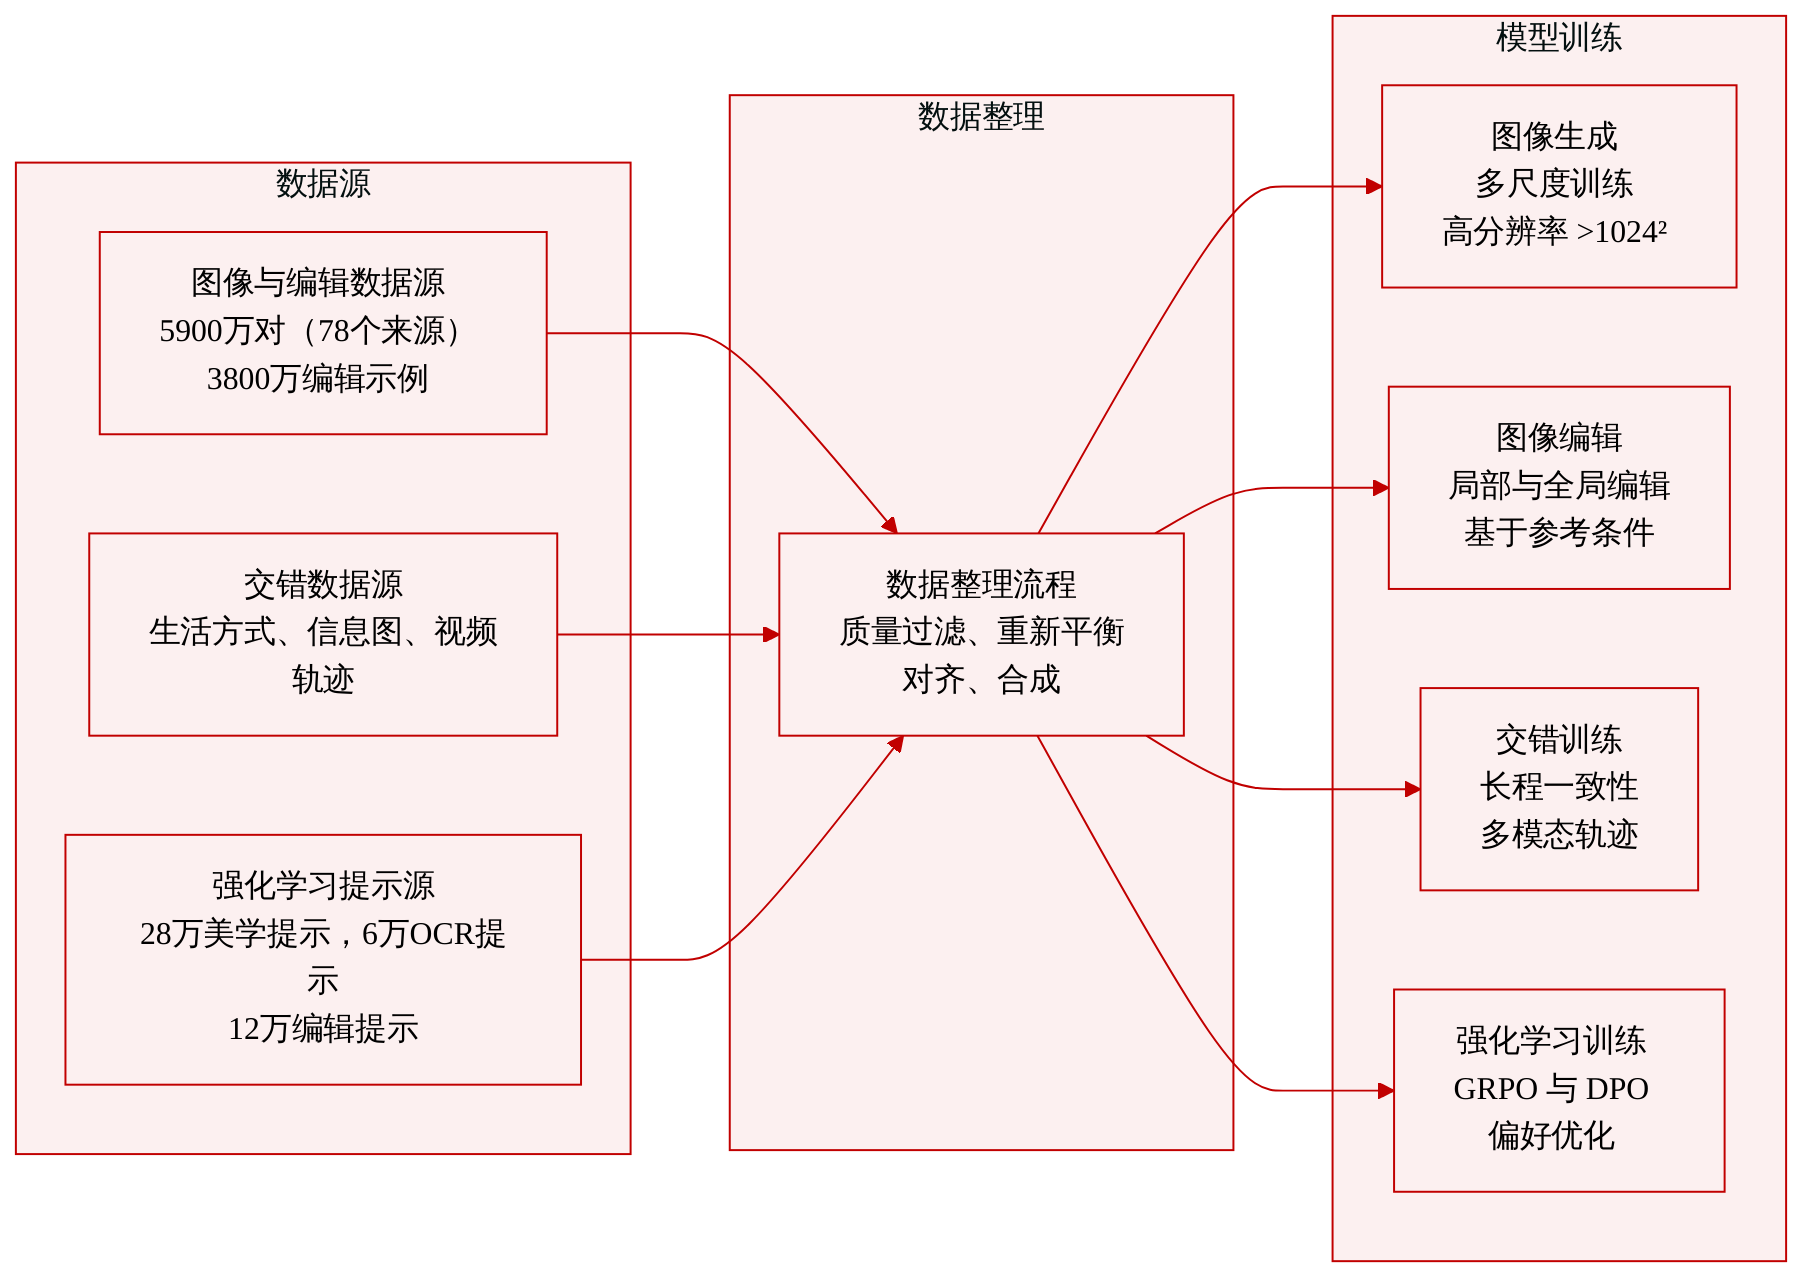
作者为SenseNova-U1.5构建大规模多模态训练语料,在先前SenseNova-U1基础上扩展,侧重数据多样性、视觉质量、高分辨率生成、复杂指令遵循与细粒度图像编辑。数据通过质量感知过滤、分布再平衡、更强图文对齐以及针对欠表示能力的定向合成进行筛选。语料组织为四个主要子集,每个具有不同组成、处理与用途。
-
图像生成数据
- 组成:约5900万额外图文对,收集自78个来源,覆盖通用场景、以人为中心的内容、物体、富含文本图像、信息图与专业领域。高分辨率样本占主导:88.2%有效训练量超1024²分辨率,64.4%超2048²。
- 处理:提供多粒度描述(长描述、简洁描述、语义标签),强化中英双语覆盖,尤其针对富含文本图像。针对罕见概念、复杂布局与文本密集设计生成合成数据。所有样本通过共享过滤管线,评估感知质量、提示保真度、文本正确性、布局质量与视觉多样性。
- 用途:此子集使模型接触丰富多尺度视觉统计,监督全局场景构图与细粒度局部细节。
-
图像编辑数据
- 组成:约3800万样本,覆盖四种设置——通用编辑(
43%)、空间控制信息图编辑(42%)、参考条件编辑(~15%)、带边界框与视觉标记的空间控制编辑。参考条件样本包含最多十张参考图像。 - 处理:编辑指令在形式、粒度与复杂度上多样化。针对多目标或多约束编辑,结构化提示增强与思维链样本显式描述编辑意图、目标区域、期望属性与需保留内容。筛选联合评估指令完成度、目标质量、参考/身份保真度与未编辑区域保留。
- 用途:数据训练模型覆盖广泛编辑场景,从局部属性变化到场景级变换与参考引导定制。
- 组成:约3800万样本,覆盖四种设置——通用编辑(
-
交错数据
- 组成:多模态轨迹,来源于生活导向序列(
44%)、信息图数据(29%)、视频衍生序列(19%)与推理密集样本(8%)。 - 处理:所有来源转换为统一轨迹格式,文本与视觉状态逐步交错。共享管线处理源预处理、领域特定变换或合成以及轨迹级验证。过滤确保语言有效性、视觉质量、跨模态一致性与整体连贯性。
- 用途:交错轨迹训练模型长程语义连贯性、视觉一致性、时序演化与多步推理条件生成。
- 组成:多模态轨迹,来源于生活导向序列(
-
RL训练数据
- 美学、OCR与信息图样本:
- 美学:~280K提示(来自HPSv3++、Pick-a-Pic、双语扩展与内部来源);每个提示多张图像用HPSv3++评分,移除奖励变化弱的组。
- OCR:~60K双语文本渲染提示(20K短文本提示来自Flow-GRPO扩展至40K更长、更密集提示);指定文本提取为参考转录用于在线OCR奖励。
- 信息图:首个GRPO阶段复用OCR语料;后续阶段联合迭代OCR与美学提示。此外,~120K来自Linear-DPO语料的过滤偏好对用于DPO,在肖像/非肖像内容与中英文提示间平衡。
- 图像编辑RL样本:
120K样本,局部编辑(80%)与全局编辑(~20%)。指令覆盖中文、英文与混合语言,长度与分辨率从512×512到2048×2048平衡。- 筛选:移除损坏、重复、低分辨率或退化样本;验证实体、文本与属性对齐;评估源图像与编辑图像的美学与技术质量;保留样本在任务类别与分辨率间重新平衡。
- 用途:这些RL特定子集用于GRPO与DPO阶段,使模型与人类偏好及任务特定奖励对齐,提升视觉质量、文本渲染与编辑精度。
- 美学、OCR与信息图样本:
总体而言,数据集用于训练SenseNova-U1.5跨图像生成、图像编辑与交错多模态任务,RL子集提供针对性偏好优化。
方法
作者设计SenseNova-U1.5采用原生统一多模态范式,在单一框架内整合理解与生成。架构具有近无损视觉接口,直接将原始图像或噪声扰动视觉输入转换为紧凑token序列,无需外部视觉编码器或VAE。两个带GELU激活的卷积投影下采样输入,为每个32×32图像区域产生一个视觉token。二维正弦位置嵌入保留空间坐标,特殊token界定各视觉块。文本与视觉表示投影到共享隐空间,由统一骨干联合处理。
如下图所示:
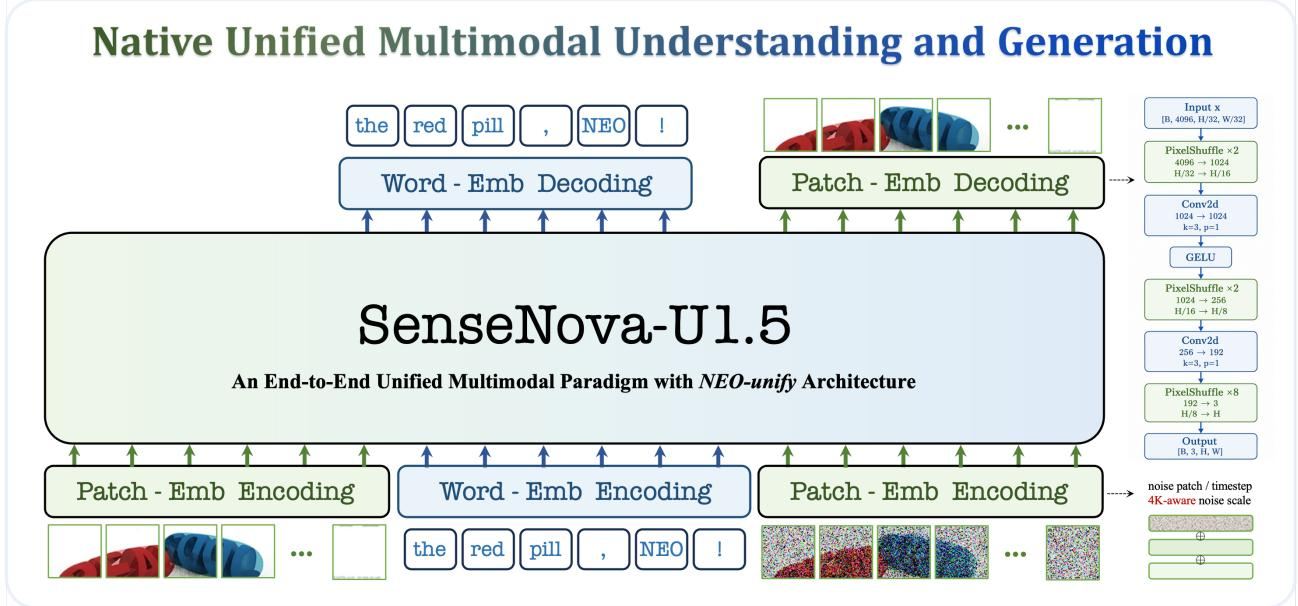
对于生成,模型显式引入分辨率依赖噪声尺度嵌入以条件化去噪过程。噪声尺度σR(H,W)经归一化并用专用正弦MLP编码,随后与扩散时间步表示结合,提供对扩散时间与分辨率依赖噪声统计的显式感知。为解决高分辨率下patch级分解伪影,作者将原始MLP头替换为轻量空间耦合解码器。给定骨干隐状态,模型恢复其二维拓扑,通过上采样因子为2、2、8的Pixel Shuffle阶段逐步重建全分辨率RGB图像。在连续上采样阶段之间,3×3卷积使相邻token区域信息交换,在像素合成前恢复局部空间交互。
原生Transformer混合设计将理解与生成整合在单一Transformer骨干内。清晰图文上下文与噪声条件视觉状态在统一序列中交错,使语义表示与生成动态通过共享自注意力直接交互。注意力模式结构化以协调因果语言建模与双向视觉交互。文本token仅关注前文,而每个清晰图像块内token双向关注。关键的是,架构统一并不意味着处处参数共享;理解与生成保留独立注意力投影、归一化层与前馈模块,在每层按token类型动态路由。
模型以统一目标训练,联合耦合自回归语言建模、原生像素空间流学习与感知监督。对于多模态理解,作者优化目标文本序列的条件似然:
LAR=−N1n=1∑Nlogpθ(xn∣x<n,c)对于视觉生成,模型直接在RGB空间学习像素空间流匹配,使用分辨率自适应噪声:
zt=tx+(1−t)σR(H,W)ϵ模型预测清晰端点以导出速度估计,由像素空间流匹配损失监督:
LFlow=E[∥vθ−v⋆∥22]进一步引入使用LPIPS的感知目标以提升结构一致性:
LPerc=LPIPS(x^θ,x)整个训练过程在统一目标下联合优化:
L=λARLAR+λFlowLFlow+λPercLPerc作者通过多阶段训练流程逐步构建原生多模态能力,随后进行能力特定学习与蒸馏。
参考框架图:
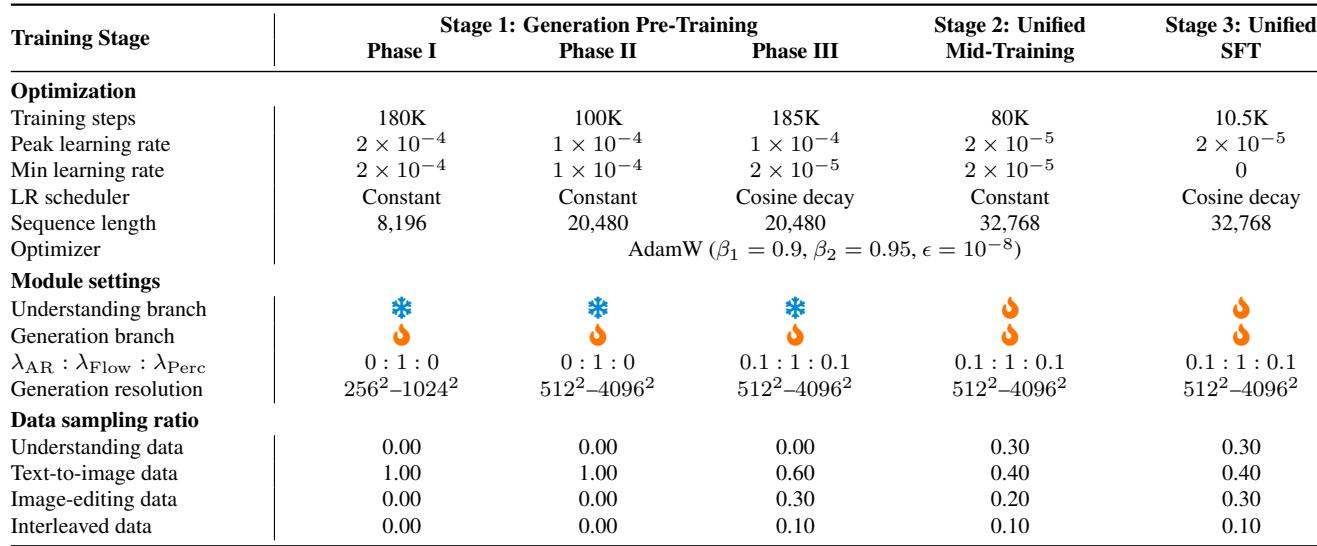
初始阶段包括生成预训练、统一中期训练与统一监督微调。阶段1中,生成分支随机初始化,通过像素空间流匹配训练,以冻结理解分支的表示为条件。此阶段引入专用原生4K训练阶段,扩展至更高分辨率文生图数据,并纳入图像编辑与交错生成任务。阶段2中,作者使用文本纯、多模态理解、文生图与图像编辑数据混合语料联合优化两个分支,平衡通用多模态能力与多样化生成能力。阶段3进一步在高质量指令遵循数据上微调模型,强化指令遵循度。
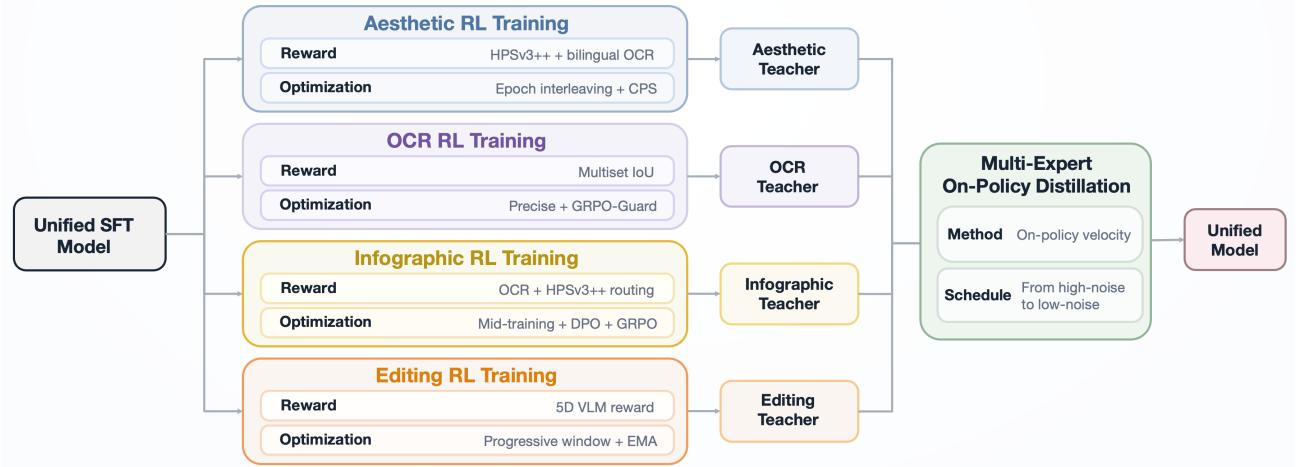
这些统一阶段之后,作者在阶段4实施多专家强化学习。训练四个专精专家,分别针对美学、文本渲染、信息图生成与图像编辑,每个具有任务特定数据、奖励与优化策略。美学专家交错美学偏好与排版数据,利用HPSv3++与双语OCR奖励。OCR专家使用归一化多集交并比分数专精准确双语文本渲染。编辑专家使用多维VLM奖励框架与渐进滑动窗口策略平衡指令遵循、内容保留与视觉质量。信息图专家经历从信息图导向中期训练到任务特定RL的完整训练过程,通过直接偏好优化与组相对策略优化精炼文本渲染与整体视觉质量。
阶段5中,作者应用多专家在线策略蒸馏,将四个专精专家整合为单一统一模型。每个训练样本硬路由至对应其能力的冻结专家。学生生成自身轨迹,学生与被路由专家在同一学生生成状态、时间步与条件下使用在线速度场蒸馏评估:
LOPD=E[∥vθ(sg(x^θ,t),t,c)−vm(sg(x^θ,t),t,c)∥22]为学习建立全局结构的高噪声状态与决定局部细节的低噪声状态,查询分布在训练过程中逐步从强调早期高噪声部分转向后期低噪声状态。学生使用固定30步确定性ODE去噪步骤训练,直接在无分类器引导下优化速度,使训练与推理对齐。
实验
SenseNova-U1.5在多模态理解、图像生成、编辑与交错生成基准上评估。模型保留强视觉与语言理解,同时增加稳健生成与编辑能力,在构图一致性、双语文本渲染与推理驱动编辑方面有显著提升。交错生成实验进一步表明,生成可作为中间表示支持多模态推理,验证原生多模态统一的有效性。
SenseNova-U1.5在多模态编辑、推理与交错生成任务中展示领先开源且常为最先进的性能。应用思维链推理时表现尤为出色,其生成能力可作为中间表示增强多模态理解。在OmniRef-Bench上,模型取得领先开源结果,在风格一致性与背景保留方面增益显著,同时可靠保持主体与姿态一致性。思维链推理在RISEBench上对因果、逻辑与时序编辑带来大幅提升,但空间编辑受益较不一致。借助思维链,SenseNova-U1.5在OpenING上取得整体最佳性能,在图文连贯性、人类对齐与多步一致性方面超越专有管线。在VBVR-Pro-Bench上,其在各认知能力维度设立新最先进水平,并对域外任务泛化强劲,超越领先专有模型。模型使用生成作为中间表示,在RealUnify-GEU上取得领先性能,同时在Uni-MMMU-GaU上保持竞争力。

训练方案依次经过生成预训练、统一中期训练与监督微调,学习率从2e-4降至2e-5,序列长度从8K增至32K token。早期阶段保持理解分支冻结同时训练生成分支,随后两个分支使用侧重文生图数据的混合语料联合优化。联合阶段中,生成损失权重为理解损失的十倍,以强化合成同时保留理解。阶段1生成预训练使用三个阶段降低学习率并提升序列长度,从恒定2e-4在8K token移至余弦衰减至2e-5在20K token。统一中期训练混合40%文生图、30%文本与理解、20%图像编辑与10%交错数据,应用恒定学习率2e-5与32K token上下文。在统一中期训练与SFT中,生成损失系数为1.0,理解损失系数为0.1,优先生成能力而不丢弃理解。
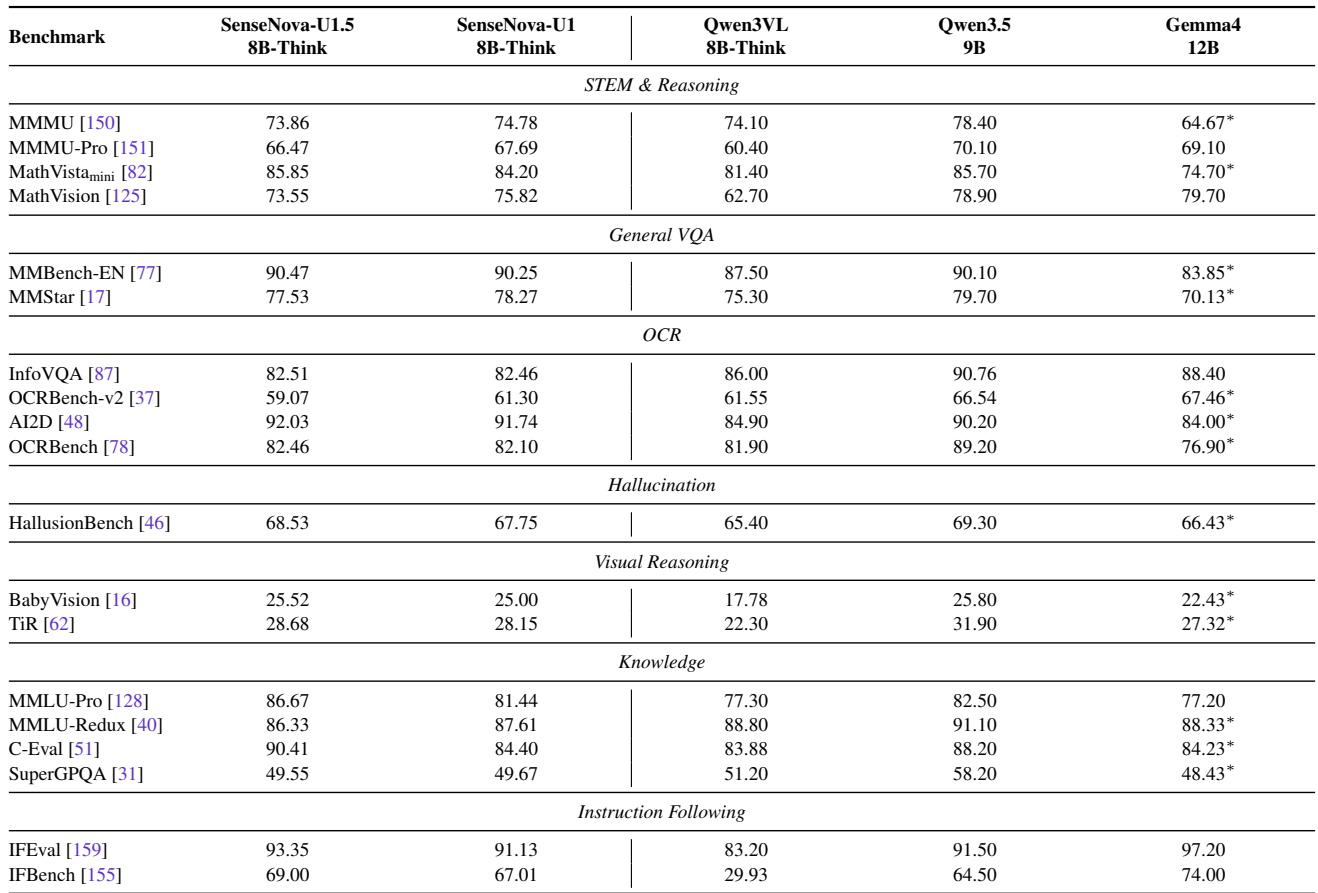
SenseNova-U1.5在多模态基准上保持或超越SenseNova-U1,同时增加生成与编辑能力,并在关键STEM与VQA任务上优于无编码器Gemma4-12B。统一训练不降低语言理解,U1.5在MMLU-Pro、C-Eval与指令遵循评估中取得强劲结果。SenseNova-U1.5在MMMU、MathVista、MMBench与其他多模态基准上匹配或超越SenseNova-U1,同时大幅扩展其生成能力。统一训练后语言理解保持稳健:U1.5在MMLU-Pro得分86.67,C-Eval得分90.41,IFEval得分93.35,指令遵循较U1提升。
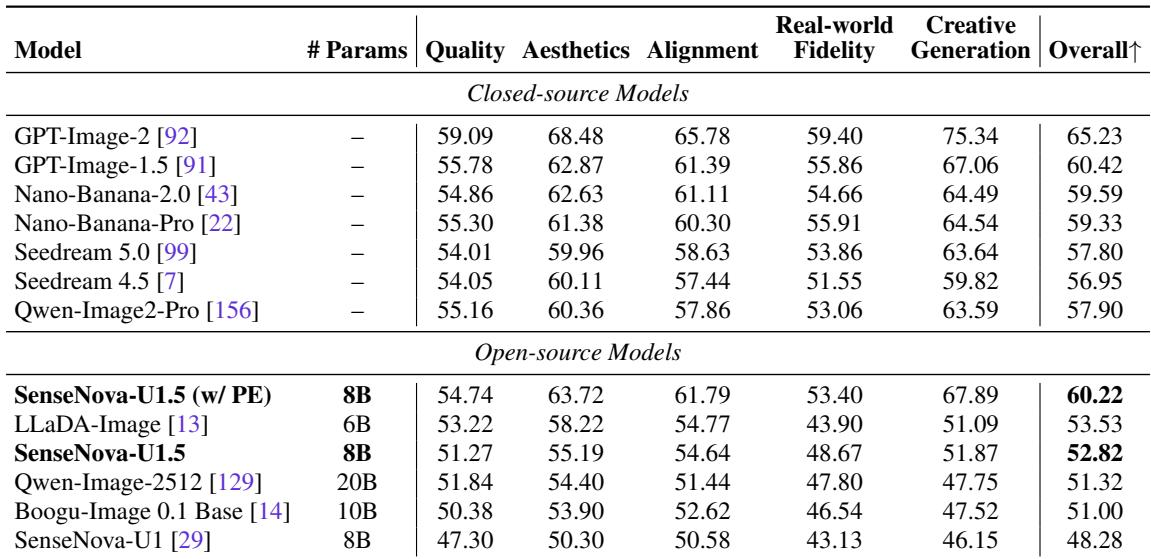
SenseNova-U1.5使用提示增强在Qwen-Image-Bench英文子集上取得整体得分60.22,为开源模型中最高。超越多个闭源系统如Nano-Banana-Pro与Seedream 5.0,并接近GPT-Image-1.5,展示强双语生成质量。使用提示增强,SenseNova-U1.5在开源模型中达到最佳整体性能,超越闭源系统如Nano-Banana-Pro与Seedream 5.0。即使无提示增强,SenseNova-U1.5相较前代SenseNova-U1持续提升,并与更大开源基线保持竞争力。
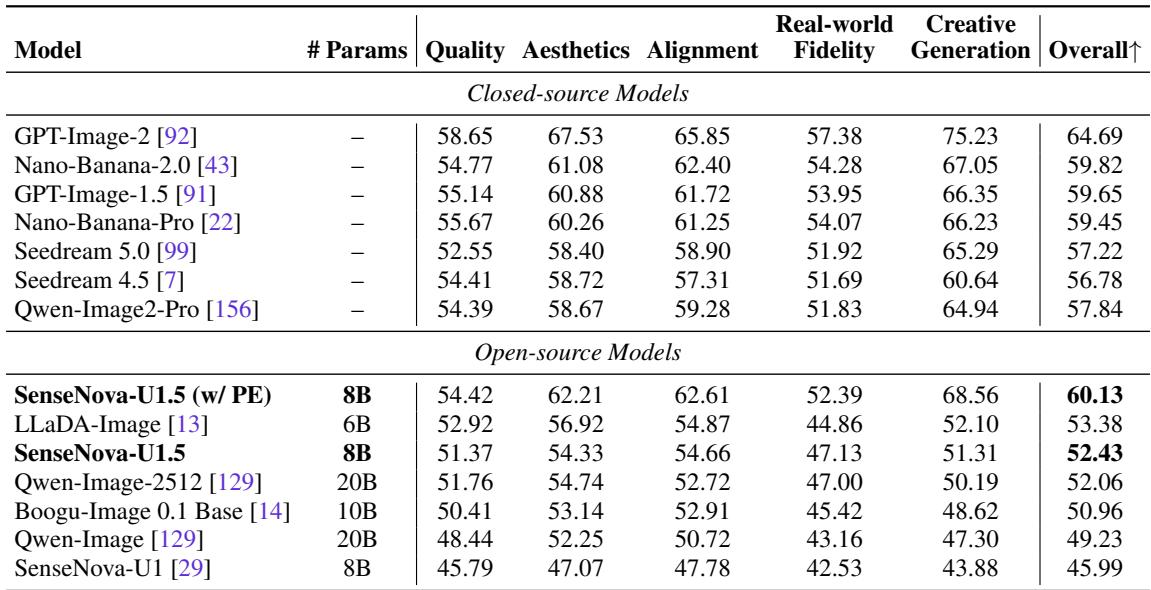
在Qwen-Image-Bench中文子集上,SenseNova-U1.5使用提示增强取得整体得分60.13,超越多个闭源模型如Nano-Banana-2.0与GPT-Image-1.5,仅次于GPT-Image-2。无提示增强时,模型仍较前代提升,并与更大开源基线保持竞争力,缩小与领先闭源系统的差距。SenseNova-U1.5使用提示增强在中文子集上达到60.13整体得分,超越闭源模型如Nano-Banana-2.0(59.82)与GPT-Image-1.5(59.65)。即使无提示增强,SenseNova-U1.5相较SenseNova-U1持续提升,并缩小与顶级闭源系统的性能差距。
SenseNova-U1.5通过生成预训练、统一中期训练与监督微调的渐进方案训练,生成损失权重高以保留合成同时维持理解。跨多模态编辑、推理与生成基准的评估表明,模型取得领先开源且常为最先进的性能,应用思维链推理时尤为突出,其生成能力可作为中间表示增强多模态理解。模型在理解基准上匹配或超越前代且无退化,使用提示增强在双语图像生成质量测试中取得最佳开源结果,超越多个闭源系统。