Command Palette
Search for a command to run...
COBRA-SKILLS:基于上下文赌博机引导的智能体技能进化优化
COBRA-SKILLS:基于上下文赌博机引导的智能体技能进化优化
Pingchen Lu Xiangyi Wang Xiang Li Jie Mao Zikun Qu Junfeng Luo Yao Shu Bryan Kian Hsiang Low Zhongxiang Dai
摘要
大型语言模型(LLM)智能体能够从先前任务经验中提炼可复用的技能,但现有的技能优化方法通常依赖代价高昂的基于执行的评估和大量任务数据。我们提出 COBRA-Skills,一个将技能优化建模为在动态演化的候选空间上进行预算受限的序列优化的高效框架。COBRA-Skills 将上下文赌博机引导的优先级排序与基于证据的技能进化相结合,有选择地将评估资源分配给有前景或信息量大的候选技能,同时根据执行反馈持续优化技能种群。在六个异构智能体基准和三个目标模型上,COBRA-Skills 在对比方法中始终取得最强的平均性能,同时相比 SkillOpt 将优化成本降低 55–58%,且每个基准仅使用 50 个独特的优化样本。进一步分析表明,COBRA-Skills 对智能体框架的变化保持鲁棒,并且在目标模型本身被用于技能生成和优化时依然表现有效。代码见 https://github.com/Jerry-LuP/COBRA-Skills。
一句话总结
香港中文大学(深圳)、天津大学、香港科技大学(广州)以及新加坡国立大学的研究者提出 COBRA-Skills,一种高效的技能优化框架,该框架将上下文bandit引导的优先级排序与基于证据的技能进化相结合,以有选择性地分配评估,从而在六个异构的agent基准测试和三个目标模型上取得了最强的平均性能,同时相比 SkillOpt 减少了55-58%的优化成本,并且每个基准测试仅使用50个独特的优化样本。
核心贡献
- Agent技能优化被形式化为在动态演化的候选空间上进行的有预算的顺序优化,其中候选技能的效用不确定,只能通过昂贵的target-agent评估来揭示。
- COBRA-Skills 将上下文bandit优先级排序与基于证据的种群进化相结合,共同改善评估分配、候选保留和持续的技能细化。
- 在六个异构的agent基准测试、三个目标模型(Qwen3.6-35B-A3B、GPT-5.4-Nano、Gemma-4-26B-A4B-it)以及多个执行框架上的大量实验表明,COBRA-Skills 在对比方法中取得了最强的平均性能,相比 SkillOpt 减少优化成本 55-58%,每个基准测试仅使用 50 个独特优化样本,并且在外部框架和self-teaching下依然有效。
引言
处理重复性任务的LLM agent可以利用编码了过程性知识的可复用“技能”,但创建可靠的技能具有挑战性。手动编写需要领域专业知识和精力,而完全从LLM的参数化知识中生成的技能往往缺乏依据,无法提升下游性能。近期的方法将技能构建建立在agent执行轨迹的基础上,并应用迭代进化式精炼,但这些方法存在显著的效率瓶颈:必须在留出任务上执行候选技能以评估其效用,从而将预算浪费在低质量候选上;并且频繁调用LLM重新分析轨迹并修正技能,导致token成本上升。
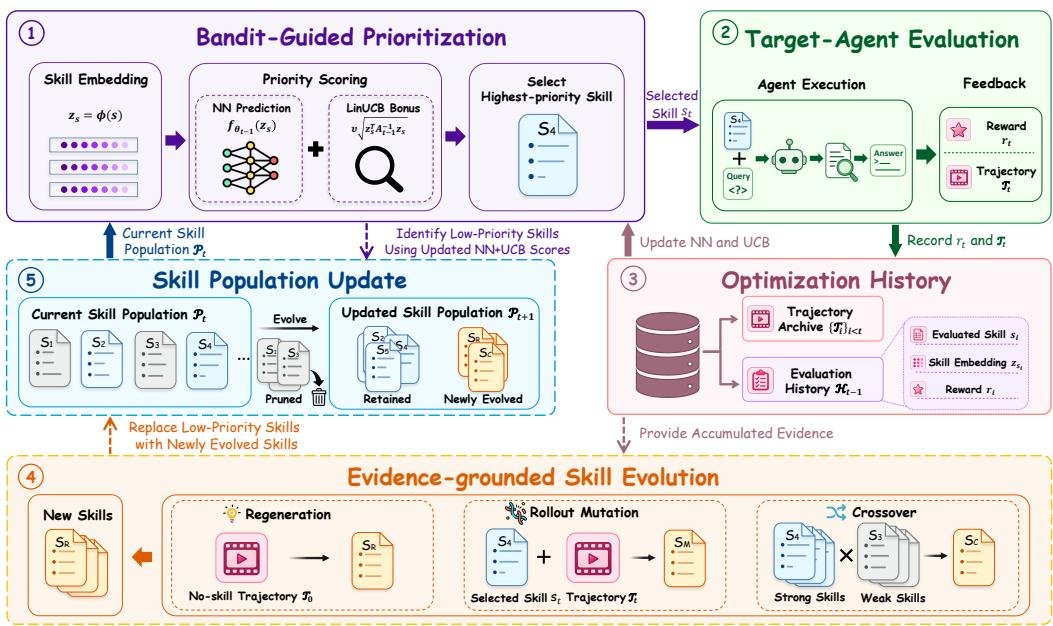
作者将agent技能优化形式化为一个动态变化的候选空间上的带预算的顺序决策问题,其中每个技能的效用不确定,仅通过昂贵的评估才能获知。他们提出COBRA-Skills,它将上下文bandit引导的优先级排序与基于证据的种群进化相结合。候选技能被视为由语义嵌入描述的臂,一个带有不确定度奖励(LinearUCB风格)的神经奖励预测器在利用与探索之间取得平衡,以高效分配评估。种群通过三种进化算子定期更新,这些算子从轨迹证据中推导出新技能,包括从无技能运行中重新生成、基于当前技能成功与失败轨迹的rollout mutation、以及利用正、负证据精细化强骨干的交叉;同时剪枝低优先级的技能。这一闭环不断细化搜索空间,在显著降低优化成本的同时提升agent在多样化基准上的性能。
方法
作者将agent技能优化形式化为一个顺序的、有预算的问题:给定从目标任务分布中抽取的小型优化集 Dopt 和一组初始的无技能轨迹 T0,一个教学模型 Mteach 必须迭代地提出候选技能,这些候选技能将由黑箱目标agent A 在 Dopt 上进行评估。每次评估产生一个奖励 rt 和执行轨迹 Tt,这些反馈用于指导搜索。目标是在固定的有限轮次 T 内,找到一个技能 s∗,使其在来自同一分布的未见实例上的期望度量最大化。
为此,COBRA-Skills 运行一个闭合循环,交替进行上下文bandit引导的选择和基于证据的种群进化。从高层来看,该方法维持一个固定大小的候选技能种群 Pt。一个基于已评估技能历史训练的神经奖励预测器,结合不确定性感知的探索奖励,为每个候选计算优先级分数。分数最高的技能被选中,由agent A 部署,其结果丰富优化历史。定期地,低优先级技能被剪枝,并由基于证据的进化算子生成的新候选替代,从而使得种群——进而搜索空间——随时间演化。
Bandit引导的技能搜索。 由于评估每个候选开销巨大,COBRA-Skills 学习一个轻量级奖励模型来有效分配评估预算。每个技能 s 首先通过固定编码器映射为语义嵌入 zs=ϕ(s)。一个带有ReLU隐层的两层层感知机 fθ 输出标量预测技能奖励。预测器基于累积历史 Ht−1 使用均方误差和 ℓ2 正则化进行拟合:
L(θ)=∣Ht∣1(si,zi,ri)∈Ht∑(fθ(zi)−ri)2+β∥θ∥22.仅依赖预测奖励可能会过度利用有潜力的技能。因此,作者用LinearUCB风格的探索奖励对预测进行增强:
bt(zs)=νzs⊤At−1−1zs,其中 At−1=λI+∑i=1t−1zsizsi⊤ 是基于先前评估嵌入构建的正则化设计矩阵,ν 控制探索强度。对于嵌入空间中访问次数较少的候选,该奖励增长,从而鼓励探索。
利用与探索项组合成优先级分数:
Ut(s)=fθt−1(zs)+bt(zs).在每一轮中,具有最高 Ut(s) 的技能被选作评估。同一分数随后指导种群剪枝:在进化补充步骤之前,m 个重新计算后优先级最低的候选被移除。
基于证据的技能进化。 COBRA-Skills 定期刷新种群以注入新的搜索方向,同时保留有潜力的候选。在剪枝 m 个最低优先级技能后,空缺槽位通过应用三种进化算子填补,这些算子均将其生成建立在真实的执行证据之上。
-
再生(Regeneration) 直接从原始的无技能轨迹 T0 构建新技能,不依赖当前种群中的任何父本。这种独立采样多样化候选池,有助于避免过早收敛。
-
执行突变(Rollout mutation) 对当前轮次中被选中的技能 st 进行局部精炼。它从新获得的轨迹 Tt 中采样成功和失败的轨迹,并将其作为具体证据生成改进的变体。这将bandit引导的选择直接与基于证据的局部精炼相结合。
-
交叉(Crossover) 利用全部已评估技能的历史 Ht。已评估技能被划分为高、低表现组,并从两者中采样候选。高表现技能作为骨干,其他强技能的策略提供正面证据,表现不佳的技能作为负面证据。结果是一种基于真实表现的重组,避免了父本文本的简单拼接。
通过这种神经奖励预测、原则性探索和基于证据的进化更新之间的相互作用,COBRA-Skills 持续将评估预算重新聚焦于最有前景且最不确定的候选,从有限的优化样本中迭代精炼技能。
实验
COBRA-Skills 在六个多样的agent基准测试和三个目标模型上始终优于基线,在通过bandit引导的优先级排序和动态技能进化减少超过一半优化成本的同时,带来了可观的准确率提升。消融研究证实,自适应评估和进化精炼二者均必不可少,并且使用目标模型进行self-teaching可以以大约一半的成本保留大部分性能,表明该方法不依赖于更强的外部教师。跨模型迁移实验进一步表明,优化后的技能捕捉到可重用的任务级策略,而非模型特定的启发式方法。
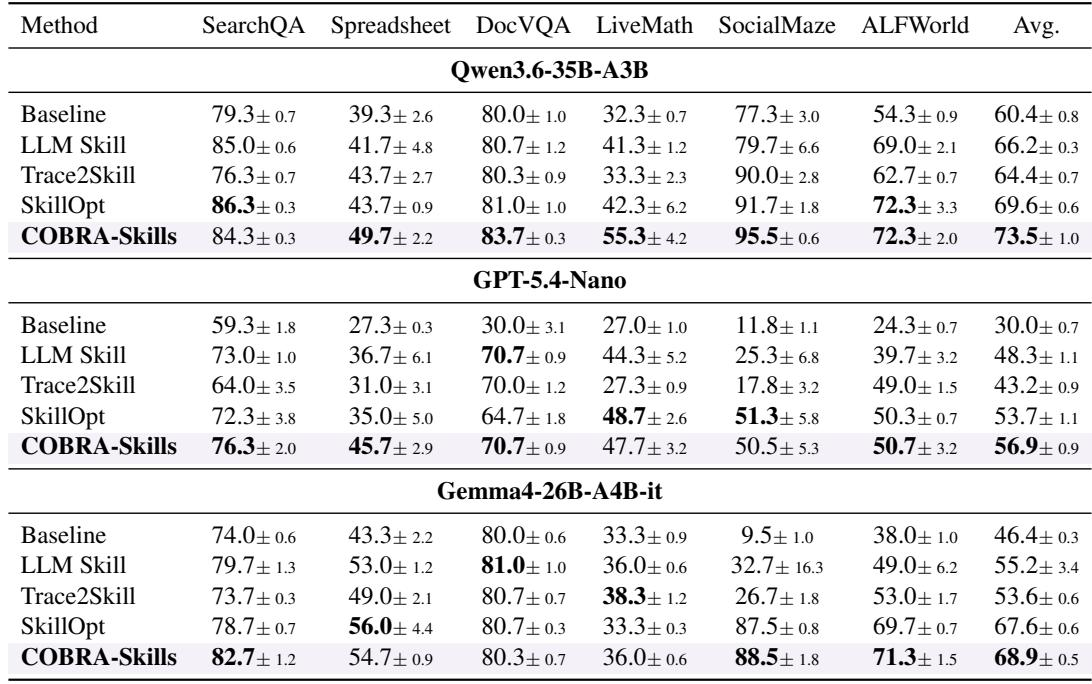
COBRA-Skills 在 Qwen3.6-35B-A3B agent 上获得了最高的平均准确率,超越了包括基于证据的技能生成和进化优化在内的所有基线方法。相对于无技能基线的最大提升出现在 LiveMath 和 SocialMaze 上,同时该方法在六个基准中的五个上取得了最佳结果。COBRA-Skills 将 Qwen3.6-35B-A3B 上的平均准确率相对于无技能基线提升了13.1个百分点。在 Spreadsheet、DocVQA、LiveMath、SocialMaze 和 ALFWorld 上均取得了顶尖性能,尤其是在 LiveMath(从32.3%到55.3%)和 SocialMaze(从77.3%到95.5%)上提升显著。
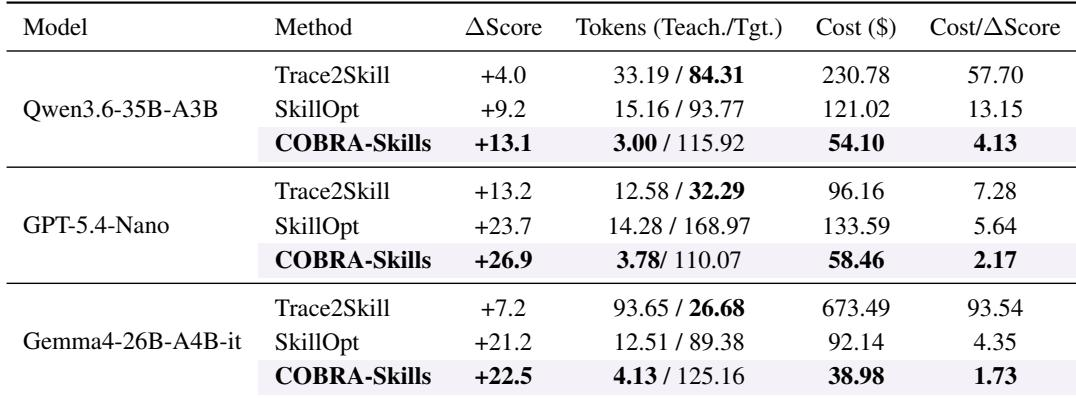
在所有三个目标模型上,COBRA-Skills 相对于无技能基线取得了最大的平均性能提升,同时产生的总优化成本和每一点提升的成本最低。其效率优势主要来自于使用的教学模型token数量明显少于 SkillOpt 等方法,从而减少了一半以上的总体开销。COBRA-Skills 在每个模型上都提供了最高的 ΔScore,Qwen3.6-35B-A3B 达到 +13.1,GPT-5.4-Nano 达到 +26.9,并且在 Gemma-4-26B-A4B-it 上(如报告所示)取得了最佳表现,且每种情况下总成本均低于 SkillOpt。与 SkillOpt 相比,COBRA-Skills 将总优化成本降低了超过55%,并将每点提升的成本降低了超过60%,这得益于教学模型 token 使用量减少67–80%。COBRA-Skills 每个基准测试仅使用 50 个优化样本,少于 Trace2Skill 和 SkillOpt 配置所用的样本池,但取得了更高的提升,证明了对有限评估预算的高效分配。
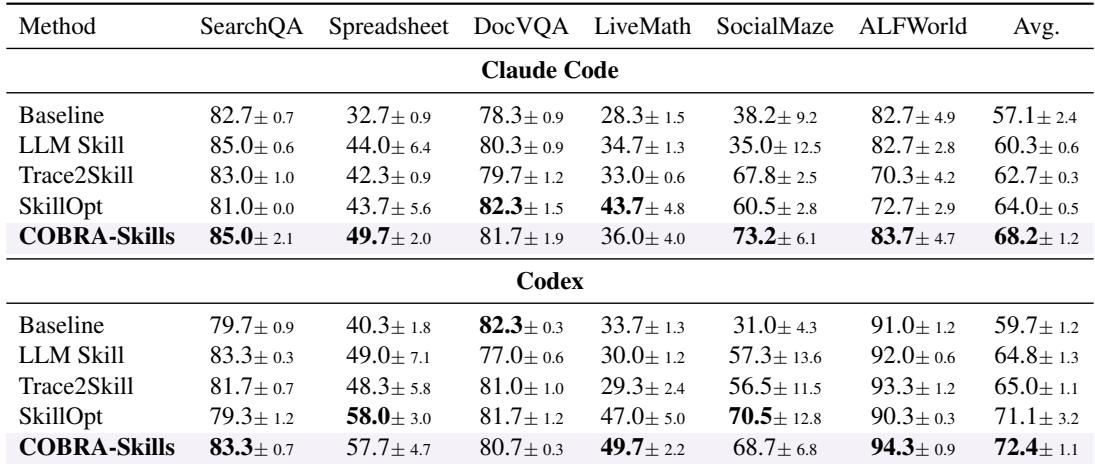
COBRA-Skills 在两个agent执行框架上均取得了最高的平均准确率,将 Claude Code 基线从 57.1% 提升到 68.2%,并在 Codex 上达到 72.4%。提升广泛,尤其是在 SocialMaze 和 Spreadsheet 上大幅跃升,而 SkillOpt 在 DocVQA 和 LiveMath 上领先。在 Claude Code 上,COBRA-Skills 将平均准确率相对于无技能基线提高了 11.1 个百分点,并以 4.2 个百分点的优势超越次优方法 SkillOpt。COBRA-Skills 将 SocialMaze 从 38.2% 提升到 73.2%,将 Spreadsheet 从 32.7% 提升到 49.7%,而 SkillOpt 则在 DocVQA 和 LiveMath 上获得最佳单项得分。相同的趋势延续到 Codex,COBRA-Skills 再次取得最高的平均准确率(72.4%),展示了在外部框架上的一致泛化能力。
对 COBRA-Skills 消融掉 bandit 引导的技能优先级排序或种群进化后,平均准确率均下降超过2个百分点,而从一个固定池中进行的best-of-30选择则落后2.5个百分点。这些发现表明,自适应评估分配和迭代候选空间进化提供了互补的收益,而仅仅生成更多的技能候选无法解释增益。去掉 bandit 优先级排序后,平均性能下降2.2个百分点;去掉进化后下降2.4个百分点,突显了两者的互补性。best-of-30选择从静态技能池中选取最优候选的方法比完整的 COBRA-Skills 方法落后2.5个百分点,确认其优势并非仅仅因为可以访问更多候选。
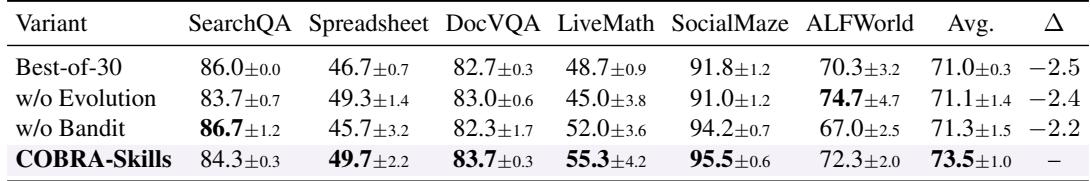
COBRA-Skills 在多个大型语言模型 agent 和外部编程框架上进行了评估,结果表明其 bandit 引导的技能优化持续优于基线,获得了最大的准确率提升,尤其是在 LiveMath 和 SocialMaze 等复杂任务上。该方法还实现了优越的成本效率,使用了更少的教学模型 token 和优化样本,同时提供了单位成本下最高的性能提升。消融研究证实,自适应评估分配和迭代技能进化两者都至关重要,因为去掉任何一个都会导致显著下降,而简单地扩展候选池无法复制这些收益。