Command Palette
Search for a command to run...
Vidu S2:实时交互、可编辑与空间视频生成
Vidu S2:实时交互、可编辑与空间视频生成
摘要
我们提出了 Vidu S2,它包含 Vidu S2-Avatar(一个实时交互的数字角色模型)和 Vidu S2-Editing(一个实时视频编辑模型)。此外,我们探索了 Vidu S2-Avatar 和 Vidu S2-Editing 在实时空间视频生成方面的可行性。与 Vidu S1 相比,Vidu S2-Avatar 支持实时 720p 视频生成、可随时更新的动态参考生成,以及更强的指令遵循能力,例如跳舞。Vidu S2-Editing 支持实时编辑视频流,包括风格迁移、虚拟试穿、角色替换和背景替换。实验表明,Vidu S2 在所有基线上均表现更优。在线可玩演示可在 https://vidu.com/vidu-stream 获取。
一句话总结
清华大学与生数科技推出 Vidu S2,包含 Vidu S2-Avatar 和 Vidu S2-Editing 两个模型,实现了支持动态参考图的实时 720p 交互式数字人生成和更强的指令跟随能力,以及支持风格迁移、虚拟试穿、人物或背景替换的实时视频编辑,在所有基线方法上均取得更优表现,并提供可体验的演示地址:https://vidu.com/vidu-stream。
核心贡献
- 提出 Vidu S2-Avatar,一种实时交互式数字人模型,支持 720p 视频生成,可在直播过程中任意时刻更新动态参考图,并提升了诸如跳舞等动作的指令跟随能力。
- 提出 Vidu S2-Editing,一种实时视频编辑模型,可对输入的视频流进行即时编辑,涵盖风格迁移、虚拟试穿、人物替换和背景替换,支持单目和立体输入。
- 展示了面向 VR 头戴显示器的实时空间视频生成与编辑能力,可将数字人生成或编辑后的单目视频流转换为同步的左右眼视图,并报告 Vidu S2 在满足实时推理要求的同时,在所有基线方法上均取得更优表现。
引言
当前的视频生成模型如 Sora、Veo 和 Wan 虽然能生成高质量内容,但依赖离线、一次性生成的范式,用户需要等待数分钟才能获得完整视频,且生成过程中无法交互。这一限制源于基于扩散的方法,该方法需要在多个步骤中同步对整个视频进行去噪。虽然这种方式适合预生成内容,但无法满足直播、游戏或面对面交流等交互式视觉体验的需求,这些场景要求内容能够即时响应用户输入。作者认为,实时交互式生成的需求潜力远大于离线生成,因为离线视频可以被回放和分享,从而降低每位用户对新生成内容的需求。
先前的工作,如 Vidu S1,已初步实现了实时、语音控制的视频生成,支持无限长度和在消费级 GPU 上最高 42 FPS 的帧率。然而,它仅限于以说话人为中心的角色,分辨率上限为 540p,直播开始后角色参考图无法更改,难以处理跳舞等大幅身体动作,并且无法编辑输入的视频流。这些限制阻碍了更广泛的应用和用户控制能力。
作者推出 Vidu S2,通过两个关键模型弥补上述不足。Vidu S2-Avatar 在 S1 的基础上改进,支持 720p 实时生成,允许用户在直播过程中随时更新参考图像,并能遵循更广泛的指令,包括跳舞。它采用了一种新颖的 Self-Replay Forcing 技术来提高训练稳定性和数据效率。Vidu S2-Editing 实现了对视频流的实时编辑,涵盖风格迁移、虚拟试穿、人物替换和背景替换,使用帧对齐注意力来保持运动和时序一致性。作者还探索了面向 VR 头戴显示器的实时空间视频生成与编辑,可将单目视频流转换为同步的左右眼视图,或直接编辑立体输入。高效的推理栈结合了注意力优化、低位 GEMM 和多 GPU 并行,使这些能力在低成本硬件上得以实用化。
数据集
数据集描述
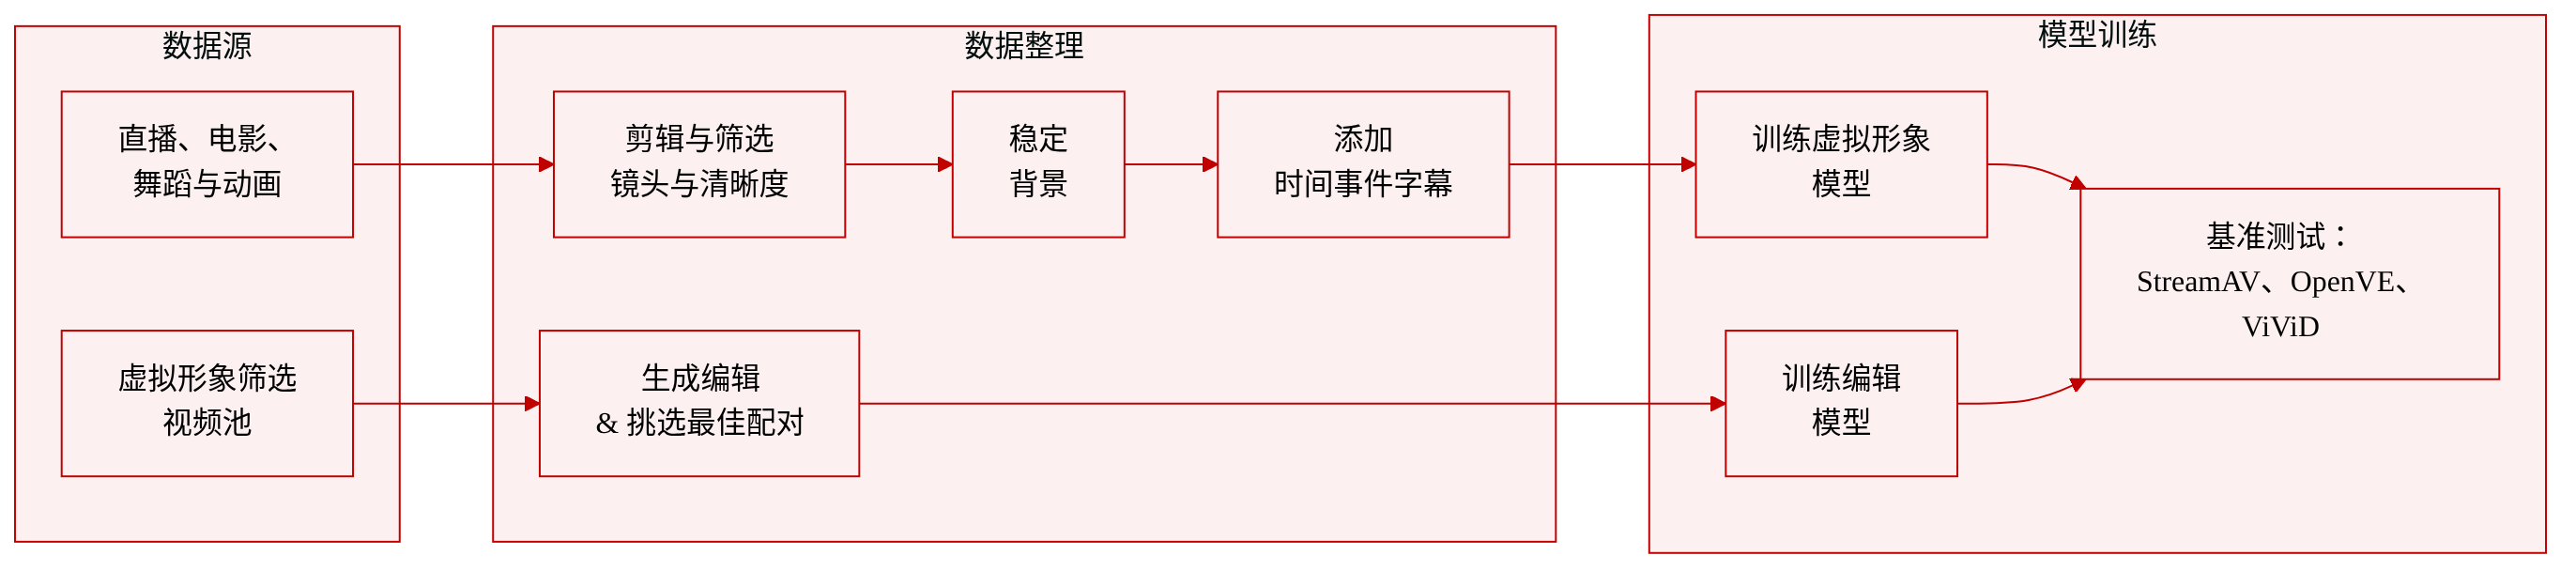
作者为 Vidu S2-Avatar 和 Vidu S2-Editing 两个模型变体构建了训练数据,并采用不同的处理流程。
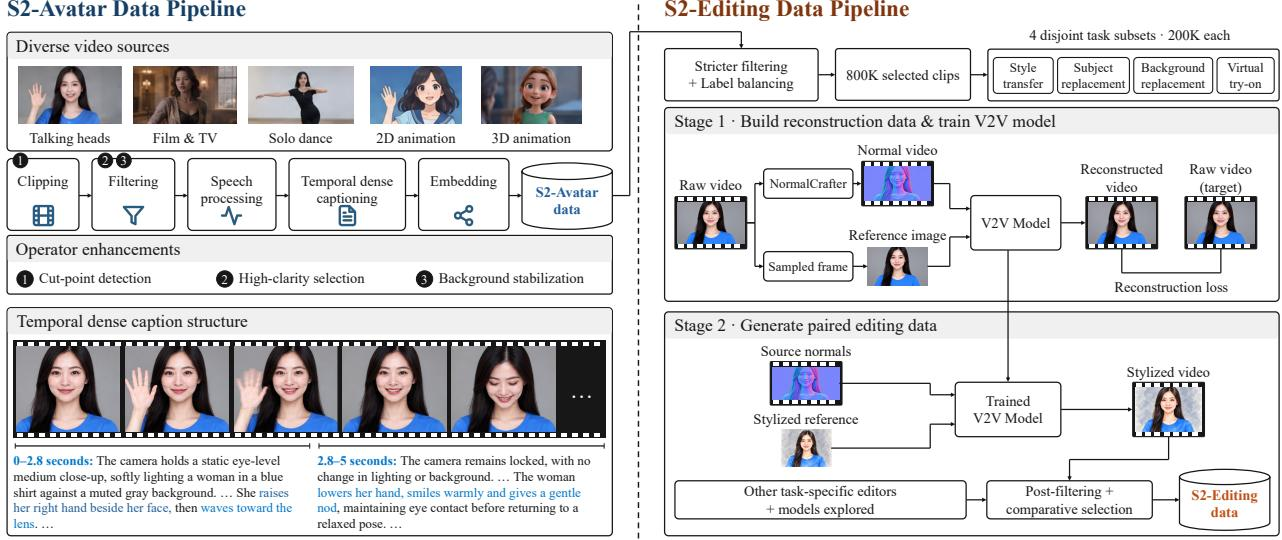
Vidu S2-Avatar 数据
- 来源与构成: 数据集基于 Vidu S1 框架构建,并扩展了数据来源,包括直播/说话人视频、影视内容、高质量单人舞蹈视频以及 2D/3D 动画数据。这种混合丰富了面部表情和身体动作的多样性。
- 流程阶段: 保留了五阶段流程(剪辑、过滤、语音处理、标注、嵌入),并优化了剪辑和过滤方法。
- 视频剪辑: 保留了单镜头剪辑方法,但引入视觉语言模型对候选片段进行第二阶段评估。这减少了 vlog 和开箱视频中细微剪辑造成的误报,将误拒率控制在 2% 以下。
- 视频过滤: 保留了 Vidu S1 的六维分类体系(主体检测、画面洁净度、视觉质量、内容安全、镜头稳定性、交互性)。新增了高清晰度选择算子,并放宽了镜头稳定性的硬性标准。
- 高清晰度视频选择: 采用多维混合框架,从分辨率、帧率、编码格式、像素格式、位深和码率等方面评估视频。专家模型评估技术质量、纹理细节、边缘锐度和压缩伪影。加权质量分数决定最终选择。
- 背景稳定化: 保留具有小幅或平滑相机运动的视频,并通过背景稳定化算子处理。对前景主体进行掩码,从背景区域估计相机变换,通过几何校正和裁剪获得稳定背景。第二次过滤确保主体仍在画面内。
- 数据标注: 标注使用按时间排序的密集描述而非结构化字段。事件按时间顺序描述,包含时间边界、动作和结果。块级标注在事件边界处切分,而非固定间隔。标注流程采用分层多 Agent 设计,使用专家模型进行目标检测和语音识别,随后由专门的 Agent 负责识别、描述、验证和过滤。
Vidu S2-Editing 数据
- 来源与规模: 训练数据来源于经过 Vidu S2-Avatar 流程过滤的视频。通过更严格的过滤和标签均衡,最终获得 80 万条视频。从中为四个任务各采样 20 万条互不重叠的子集:风格迁移、主体替换、背景替换和虚拟试穿。
- 风格迁移数据构建: 训练一个条件视频生成模型,从表面法线视频(使用类似 NormalCrafter 的模型估计)和参考图像重建原始视频。对于训练数据,将参考图像替换为风格化图像,模型按照原始空间结构和运动生成风格化视频。该方法可泛化到 50 多种风格。
- 其他编辑任务: 类似流程使用特定任务的视频编辑模型。开源模型(Bernini、SCAIL-2、Wan2.1 VACE、SAMA-14B、CoinVE-Edit)用于补充数据。后过滤和对比选择保留最佳的源视频-编辑视频对,因为没有任何单一模型能始终优于其他模型。
- 数据标注: 每条标注识别编辑任务并描述与该任务相关的参考图像属性(例如,风格迁移的视觉风格、虚拟试穿的服装属性)。标注明确要求保留源视频中预期编辑之外的所有内容。标注生成时不将源视频输入 VLM,防止通过文本条件产生内容泄漏。
评估基准
- 数字人生成: 公开评估使用 StreamAV-Bench(每个赛道 160 个场景,交互式赛道每 30 秒更新一次,最长 180 秒)。内部基准涵盖流式质量、长时稳定性、运行时更新、中断与恢复、音视频同步、响应性和成本。
- 视频编辑: 公开基准包括用于指令引导编辑的 OpenVE-Bench 和 Sparkle-Bench、用于参考条件编辑的 RefVIE-Bench,以及用于虚拟试穿的 ViViD 测试集。内部基准涵盖全部四个编辑任务,另加一个包含 10 分钟片段的长时集,用于测试身份保持、编辑区域稳定性和时序背景稳定性。
方法
作者利用全面的数据准备流程为 Vidu S2-Avatar 和 Vidu S2-Editing 构建高质量训练数据集。如框架图所示,Vidu S2-Avatar 的流程处理多种视频来源,包括说话人、影视内容、单人舞蹈以及 2D 和 3D 动画。工作流包含五个核心阶段:剪辑、过滤、语音处理、时序密集标注和嵌入。为提升数据质量,作者引入了算子增强,如切点检测、高清晰度选择和背景稳定化。对于 Vidu S2-Editing,流程通过更严格的过滤和标签均衡进一步筛选 Avatar 数据,最终获得 80 万条精选片段。这些片段被划分为四个互不重叠的任务子集,分别用于风格迁移、主体替换、背景替换和虚拟试穿。编辑数据构建包括构建重建数据以训练视频到视频模型,随后利用该模型结合其他任务专用编辑器生成成对编辑数据,再进行后过滤和对比选择。
Vidu S2-Avatar 采用音视频联合 Diffusion Transformer 进行参考条件视频-音频生成。给定参考图像 r 和条件序列 c1:∞,模型联合预测前 N 个片段的干净视频-音频潜变量:
x^01:N=fθavatar(xt1:N,t,r,c1:N),其中 xt1:N 表示扩散时间步 t 处的带噪联合视频-音频潜变量。为了在单一模型中同时支持图像到视频和参考图到视频的生成,作者联合训练了一个具有逐片段条件监督的双向模型。
为实现流式生成,双向时间注意力被替换为块级因果注意力掩码。第 i 个片段的因果去噪过程表示为:
x^0i=fθcausal(xtii,ti,r,ci,xτi<i,τi),其中 xτi<i 表示噪声水平 τi 下的历史视频-音频状态。训练策略结合了 Teacher Forcing 和 Diffusion Forcing,以提高对累积误差的鲁棒性。此外,作者引入了 Self-Replay Forcing,这是一种在线策略分布匹配蒸馏方法,在保持跨块梯度流的同时,将学生的自回归 rollout 分布与教师分布对齐。Self-Replay Forcing 的损失函数定义为:
LSRF=LDMD(fθcausal(xt1:N,t,r,c1:N))+Lperc(fθcausal(xt1:N,t,r,c1:N)).在双向和流式阶段均应用偏好优化以缓解视觉质量退化。一个单步超分辨率精炼器在潜空间内运行,以恢复细粒度的空间细节,利用历史缓存的不对称噪声水平将时序传播与空间细节恢复分离。
Vidu S2-Editing 采用类似的 Diffusion Transformer 架构进行指令引导的视频编辑。模型以源视频 s1:N、参考图像 r 和编辑指令 c1:∞ 为条件预测干净视频潜变量:
x^01:N=fθedit(xt1:N,t,s1:N,r,c1:N).训练先进行带帧对齐注意力的双向视频编辑阶段,随后使用相同的混合 Forcing 和 Self-Replay Forcing 框架进行因果流式训练。
为实现实时和低延迟推理,作者采用了端到端的推理加速框架。他们利用逐层混合注意力策略,根据层敏感性选择合适的近似注意力方法。线性层使用逐块 W8A8 GEMM 实现加速,以限制异常值的影响并保持数值精度。内核融合和 CUDA Graphs 用于减少启动开销和全局内存流量。多 GPU 上下文并行配合量化张量交换进一步高效扩展执行。对于 Vidu S2-Editing,细粒度的模块间调度在共享时间线上协调 VAE 编码器、主干网络、精炼器和 VAE 解码器,以最大化 GPU 资源利用率。
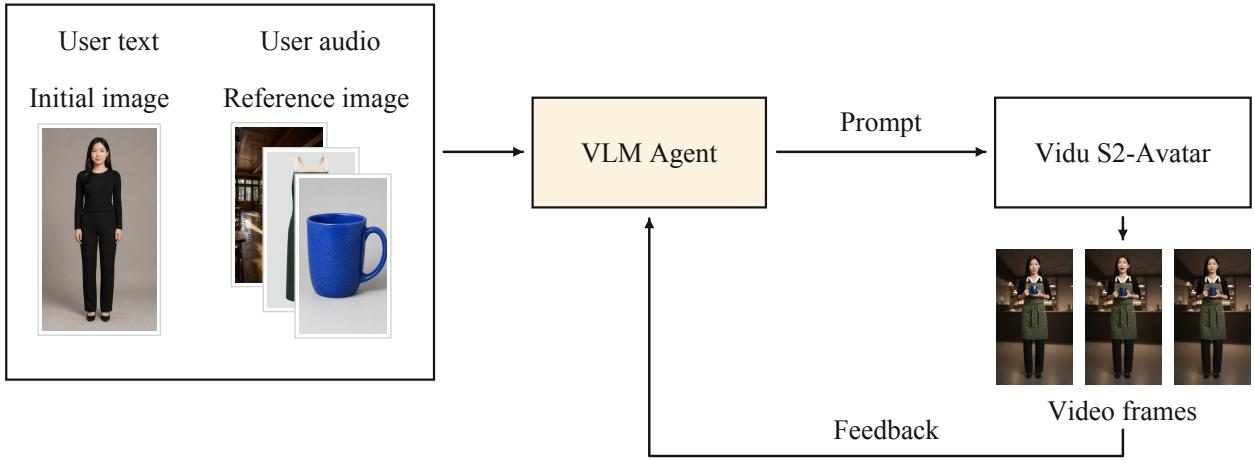
该系统整合了 Agent 工作流来管理用户交互和提示生成。如系统图所示,用户提供文本或音频指令、初始图像和可选的参考图像。视觉语言模型 Agent 处理这些输入以为 Vidu S2-Avatar 生成提示,并审查生成的视频帧以提供视觉反馈,从而优化后续提示。
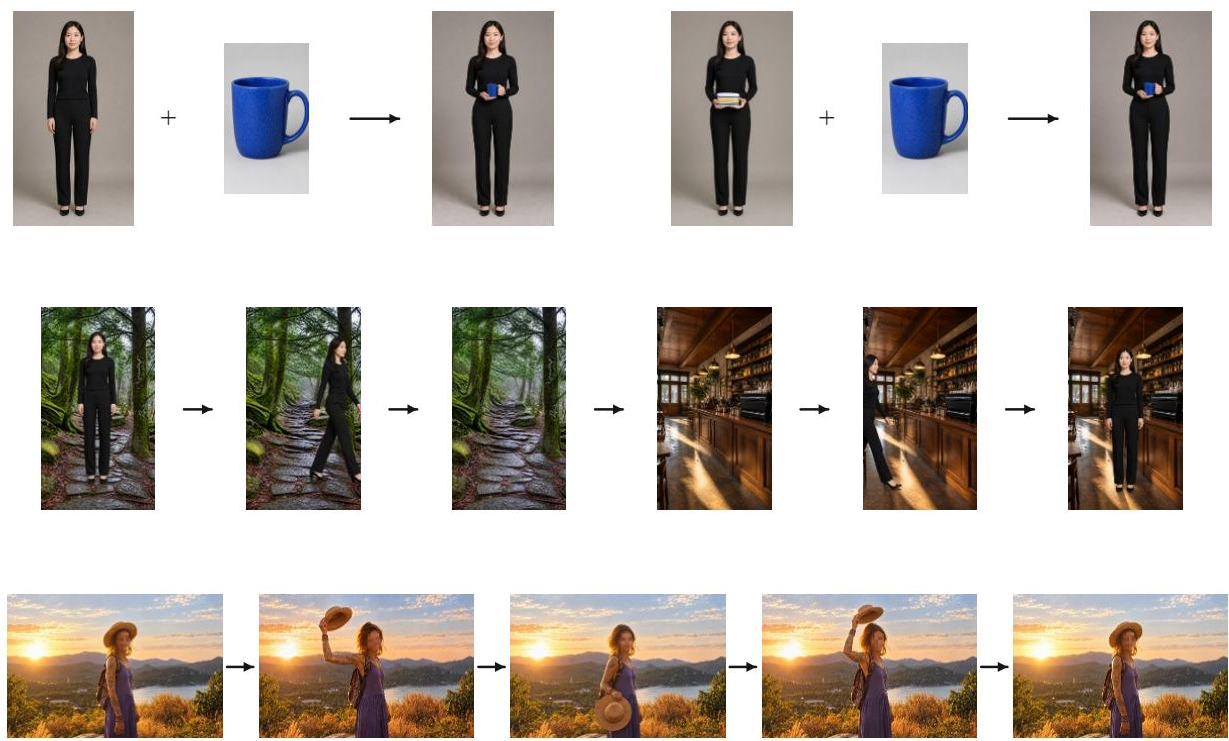
该 Agent 可处理复杂场景,如参考对象生成、场景转换和配饰操作。视觉示例展示了系统无缝整合参考对象、在不同场景间转换以及管理配饰穿戴和脱下的能力,同时保持时序一致性和角色身份。
实验
评估涵盖两个互补任务:流式数字人生成和流式视频编辑。在公开基准上,Vidu S2-Avatar 在数字人生成的所有报告指标上均取得最佳分数,尤其在音视频对齐、同步方面表现突出,并在长时 rollout 中主体和背景一致性接近满分。在视频编辑方面,Vidu S2-Editing 在指令引导编辑、参考条件编辑和虚拟试穿基准上均优于离线和流式基线方法。采用随机 GSB 成对比较的补充人工偏好评估显示,Vidu S2 相对于商业系统具有一致优势,在整体质量、时序一致性和长时稳定性方面提升最大。定性案例研究确认,Vidu S2 在长时间流中保持身份、细粒度几何和场景结构,而基线方法则出现面部漂移、身体比例变化和局部失真。
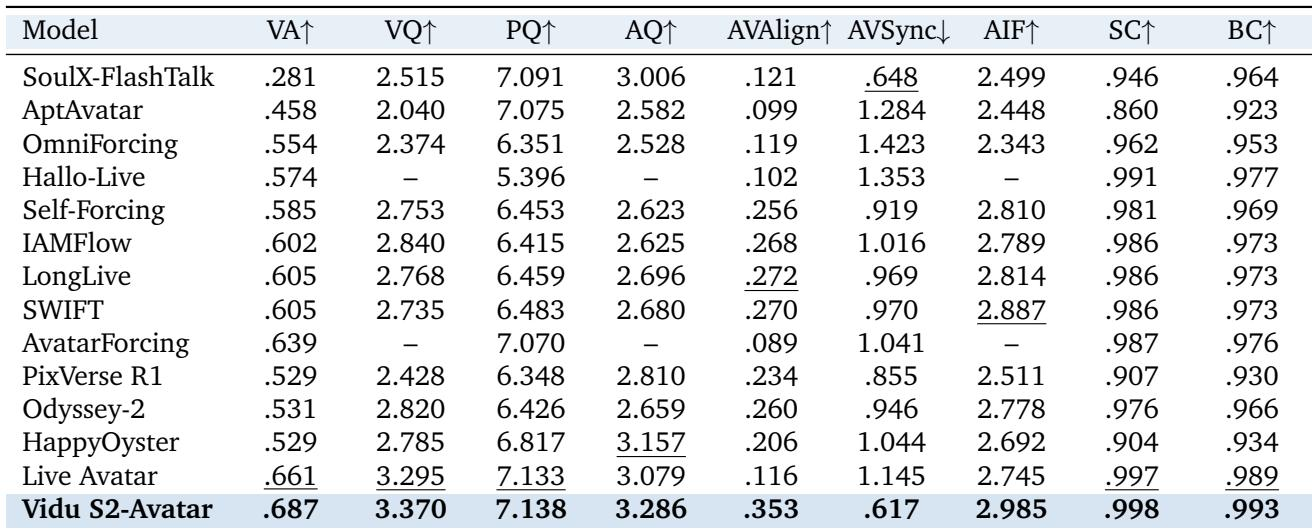
Vidu S2-Avatar 在 StreamAV-Bench 数字人基准上优于所有基线方法,在每项报告指标上均取得最佳分数。其优势涵盖视觉质量、音频质量、跨模态对齐和长时稳定性,表明这是一种均衡的提升而非单一维度的优势。Vidu S2-Avatar 在视觉吸引力和保真度方面领先所有其他系统,VA 和 VQ 分数更高。该方法还取得了最佳的音频质量指标,语音更清晰自然。跨模态协调更强,AVAlign 更紧密且 AVSync 值更低。身份和场景稳定性接近完美,SC 和 BC 分数接近最大值。
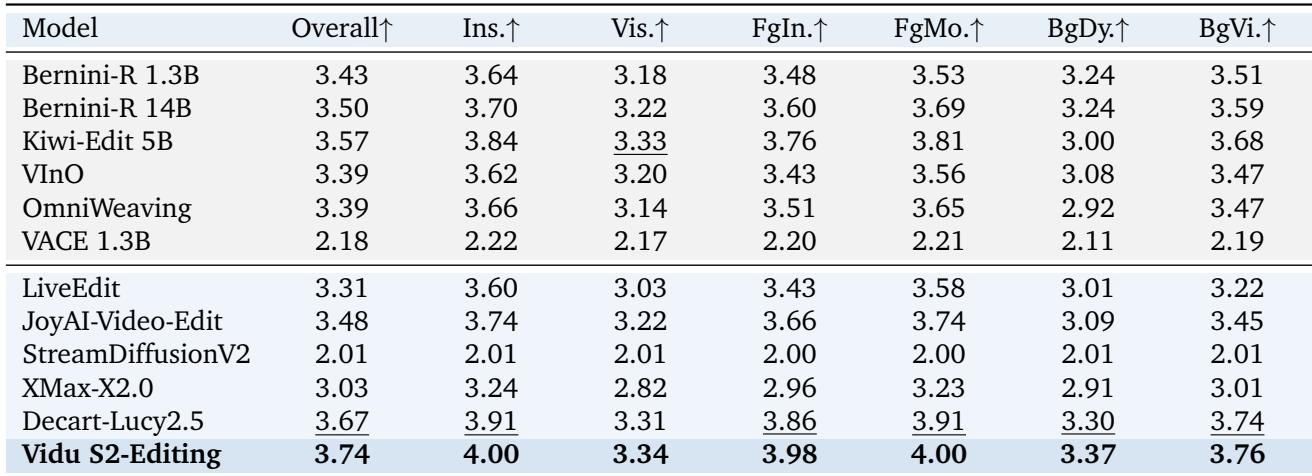
Vidu S2-Editing 在 Sparkle-Bench 视频编辑基准上取得最高总分,并在所有单项指标上领先,优于离线和流式基线方法。其优势在前景和背景标准上保持一致,表明编辑质量均衡。Vidu S2-Editing 在所有评估模型中取得最高总分。它在全局指令、全局视觉质量、前景指令、前景运动、背景动态和背景视觉质量方面均领先。其整体分数明显超越最强的离线基线方法。
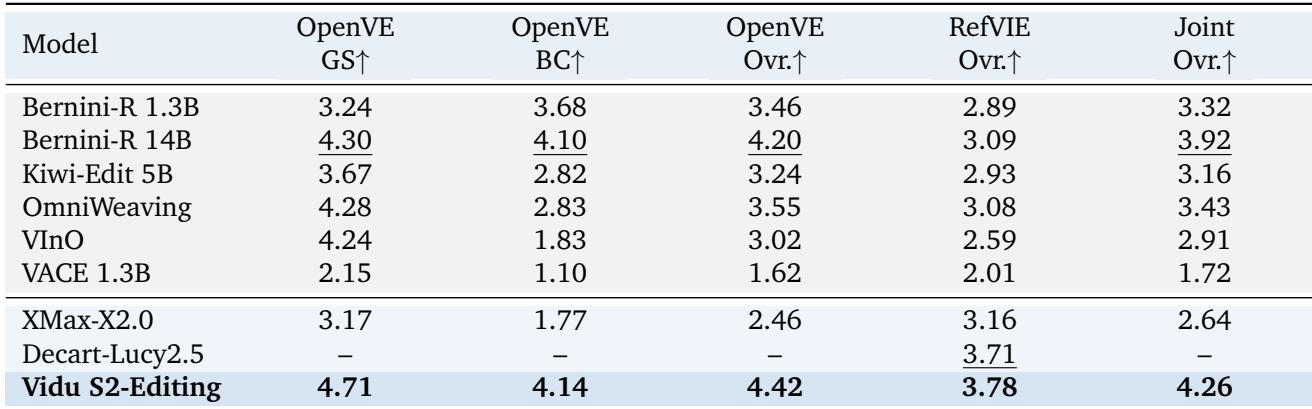
所提出的流式方法 Vidu S2-Editing 在 OpenVE 和 RefVIE 联合评估的所有报告指标上均取得最高分数,超越离线和流式基线方法。其优势在 OpenVE 上最为显著,尤其是全局风格和背景变化,同时在 RefVIE 上也以较小幅度领先。Vidu S2-Editing 在联合总分上位居首位,明显超越最强的离线基线方法。该方法在 OpenVE 的全局风格和背景变化两项上均领先,这为其高 OpenVE 总分做出了贡献。在 RefVIE 上,Vidu S2-Editing 以微弱优势超越最佳流式基线,显示出较小但仍具领先性的提升。
在 ViViD 非配对虚拟试穿基准上,Vidu S2-Editing 的 VFID 分数低于所有列出的基线方法,表明生成视频与参考视频分布之间的一致性更强。该方法大幅超越 CatV2TON 和 ViViD,而 StableVITO 和 OOTDiffusion 等其他基线方法的 VFID 值则高得多。Vidu S2-Editing 在所有评估方法中取得最佳 VFID 分数。与最强的接近基线(ViViD)相比,提升幅度很大,VFID 降低超过一半。基于扩散的试穿基线方法(StableVITO、OOTDiffusion)产生的 VFID 值明显更高,表明分布对齐较弱。
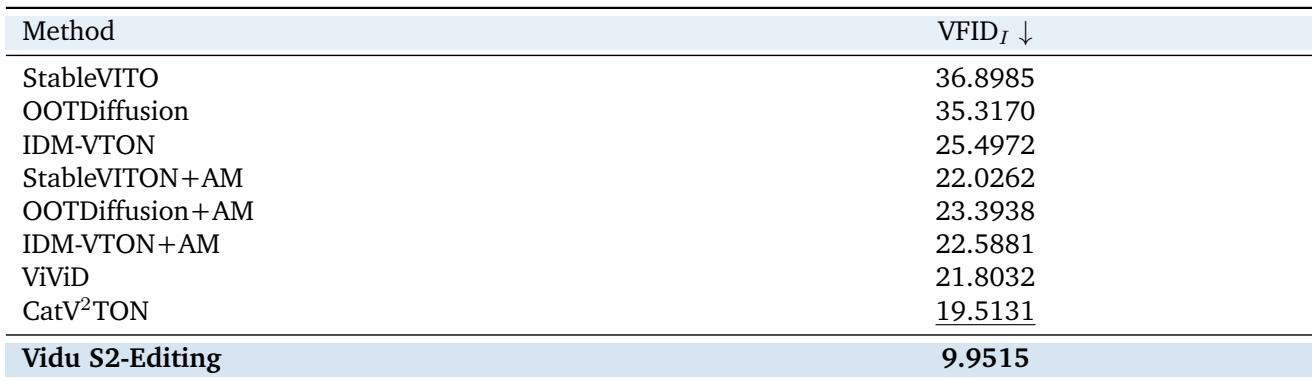
Vidu S2-Avatar 和 Vidu S2-Editing 在四个基准上始终优于所有离线和流式基线方法。在 StreamAV-Bench 上,Vidu S2-Avatar 在所有视觉、音频、对齐和稳定性指标上均取得最佳分数,表明提升均衡。在 Sparkle-Bench 和 OpenVE/RefVIE 联合评估上,Vidu S2-Editing 在每项指标上均领先,其中全局风格和背景变化的提升最大。在 ViViD 试穿基准上,Vidu S2-Editing 将 VFID 相比最强基线降低超过一半,显示出明显更好的分布对齐。