Command Palette
Search for a command to run...
X-AuT:基于跨尺度蒸馏的语音大语言模型渐进式音频编码器压缩
X-AuT:基于跨尺度蒸馏的语音大语言模型渐进式音频编码器压缩
Haojun Zhang Yi Zou Min Chen Qize Yu Lianrui Fan Xini Ding Hao Li Shuchang Zhou Xianming Liu Shiyu Huang
摘要
降低音频编码器深度可减少语音大语言模型的推理成本,但移除完整模块会扰动解码器所消费的嵌入表示,并可能导致删除错误和序列提前终止错误。我们提出 X-AuT,一个渐进式框架,通过短行为探针选择层组合,并通过表示对齐、跨尺度蒸馏、调度式学生策略监督和 LoRA 微调来恢复剪枝后的模型。语言模型主干保持冻结,而注意力 LoRA 适配器和绑定的输出嵌入在蒸馏过程中进行适配。训练使用来自转录一致性流水线中一致性最高的层级的数据,随后在微调阶段进行源重加权。在十个公开的中英文基准测试上,将 Qwen3-ASR-0.6B 的音频编码器从 18 层压缩至 16 层,宏观平均错误率从 5.61% 降至 5.27%。14 层模型在音频塔参数减少 20.7% 的情况下,错误率达到 5.75%。在匹配的方案下,1.7B 教师模型产生的平均错误率为 5.55%,而自蒸馏为 8.45%;渐进式 18→14 层剪枝优于直接剪枝(5.75% 对比 6.73%)。这些单次运行结果确立了两种实用的工作点,并表明准确率影响在不同基准测试间存在差异。
一句话总结
小鹏汽车的研究人员提出X-AuT,一个面向语音大语言模型的渐进式音频编码器压缩框架,通过行为探针选择层组合,借助跨尺度蒸馏、调度学生策略监督和LoRA微调恢复剪枝模型,在Qwen3-ASR-0.6B上将宏平均错误率从5.61%降至5.27%(使用18→16层),并以20.7%更少的音频塔参数实现5.75%错误率,优于直接剪枝。
核心贡献
- X-AuT是一个渐进式剪枝框架,通过简短的行为探针选择音频编码器层组合,并通过表示对齐、跨尺度蒸馏、调度学生策略监督和LoRA微调恢复剪枝模型,同时保持语言模型主干冻结。
- 恢复方案使用转录一致性流水线,从外部ASR假设中分配一致性等级并应用源重加权,结合调度蒸馏策略,混合教师强制与在线策略监督以稳定训练。
- 在十个中英文基准上,将Qwen3-ASR-0.6B从18层压缩至16层,宏平均错误率从5.61%降至5.27%;14层模型以20.7%更少的音频塔参数达到5.75%错误率;渐进式剪枝优于直接剪枝(5.75%对6.73%)和自蒸馏(5.55%对8.45%,使用1.7B教师模型),确立了两种实用操作点。
引言
语音大语言模型结合深度音频编码器与自回归文本解码器,但编码器必须处理每一帧输入,其深度成为流式、移动和车载系统中首token延迟的关键因素。训练后深度缩减颇具吸引力,因为它移除整个Transformer块并产生规整、易于部署的模型,然而直接丢弃层会改变馈入解码器的音频嵌入,可能触发过早的序列结束预测和大量删除错误。先前的ASR压缩工作探索了蒸馏、低秩分解、稀疏化和超网训练,但并未充分解决在预训练解码器保持冻结且固定预算下,哪些层组合可以被移除和恢复,以及如何处理隐藏状态不匹配和学生自身解码历史引起的错误。作者引入X-AuT,一个渐进式剪枝与恢复框架,使用简短行为探针评估候选层集,然后通过来自更大教师的跨尺度蒸馏、调度学生策略训练和解码器注意力的低秩适配重新对齐剪枝后的编码器,同时保留预训练语言模型主干。该方法产生一个14层模型,在车载加速器上匹配基线准确率,同时减少音频塔参数20.7%,实测编码器延迟降低21.4%。
数据集
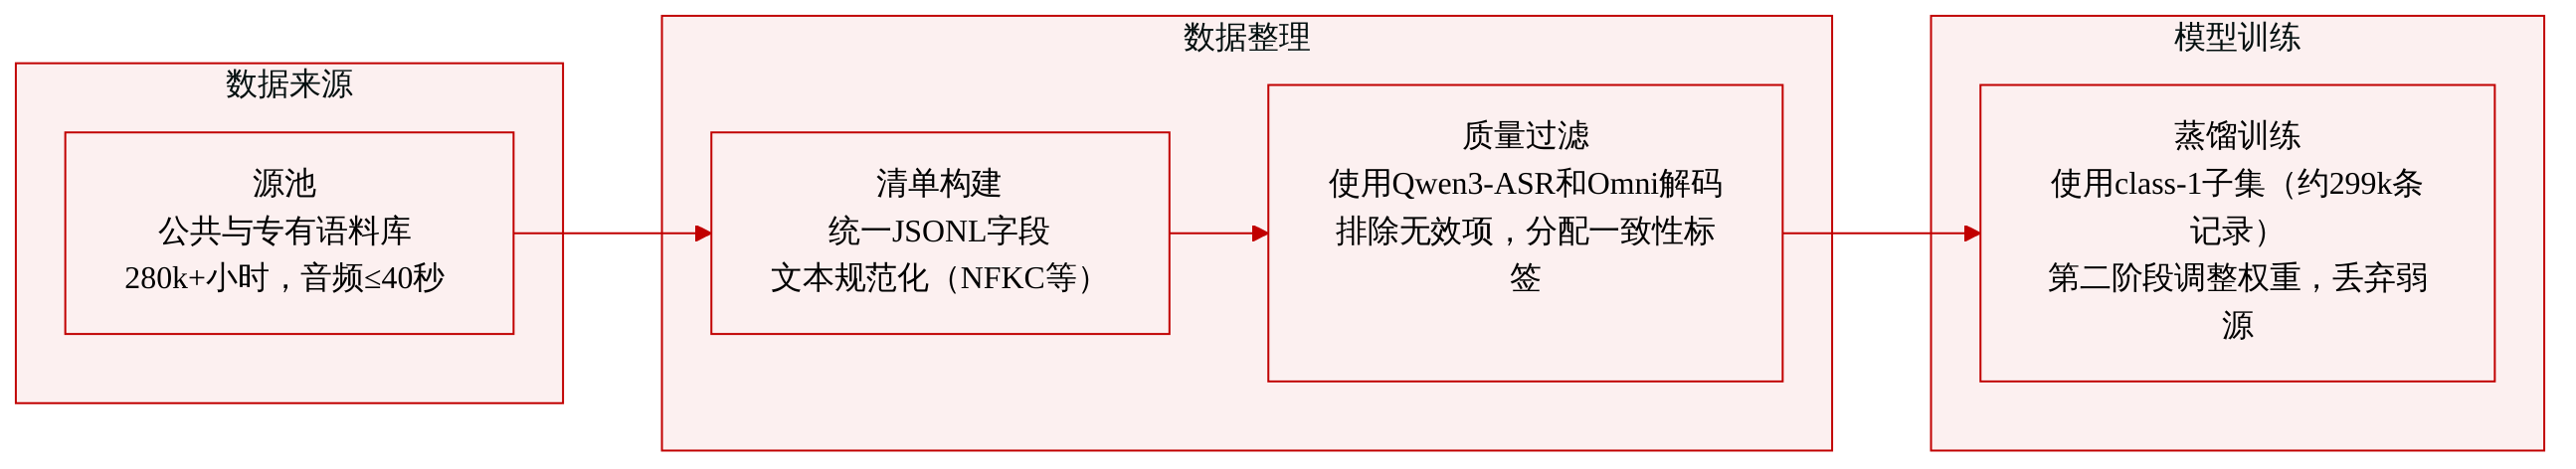
作者通过组合公开和专有语料库构建了一个大型多语言ASR数据集,然后进行过滤和标注以用于蒸馏训练。关键细节:
- 来源池:公开和专有ASR语料库,包括AISHELL-1/4/5、CommonVoice、Emilia、GigaSpeech、KeSpeech、LibriSpeech、WenetSpeech和座舱域语音。质量过滤前池规模超过28万小时。所有音频截断至40秒。
- 清单构建:每个语料库转换为统一的JSONL清单。每条记录包含话语标识符、音频引用、源转录、语言和划分标签、时长、采样率和通道数。文本规范化应用Unicode NFKC规范化、全半角转换、中文繁转简、移除不可见字符和数字分隔符、破折号规范化以及空白规范化。原始和规范化转录均被保留。
- 过滤:带有参考的语音由Qwen3-ASR-1.7B和Qwen3.5-Omni离线解码。缺少推理结果、有效音频引用或非空监督的记录被排除。剩余记录获得一致性标签(如第3.2节所述)。
- 训练数据使用:蒸馏运行仅使用清单的class-1子集。第一跳日志每epoch产生约29.9万条加权目标记录;第二跳日志产生约29.2万条。在阶段2中,保留class-1数据但调整了语料权重:增加了AISHELL-4/5和座舱查询的贡献,同时丢弃了几个弱匹配的网络语音来源。这些数字代表实际加载器索引,而非完整的28万小时源池。
方法
作者利用输入嵌入条件架构,其中输入波形 x 由 N 层音频编码器 Eθ 和桥接器 Bϕ 编码为音频嵌入 e=Bϕ(Eθ(x))。这些嵌入被放置在token嵌入序列中的音频占位符位置,因果语言模型解码器 Dψ 通过绑定的输出投影 Hω 预测转录token。剪枝操作保留有序子集 I⊂{1,…,N},并从这些块中形成 Eθ,I。目标是在目标深度下找到可恢复的子集和参数,以最小化聚合文本错误率(TER):
I,θ′,ϕ′,ω′minTER(Eθ′,I,Bϕ′,Dψ,Hω′)s.t.∣I∣=M<N.Dψ 的预训练权重保持冻结。附加在其q/k/v/o注意力投影上的LoRA参数可训练,Hω 在初始阶段可训练,之后冻结。
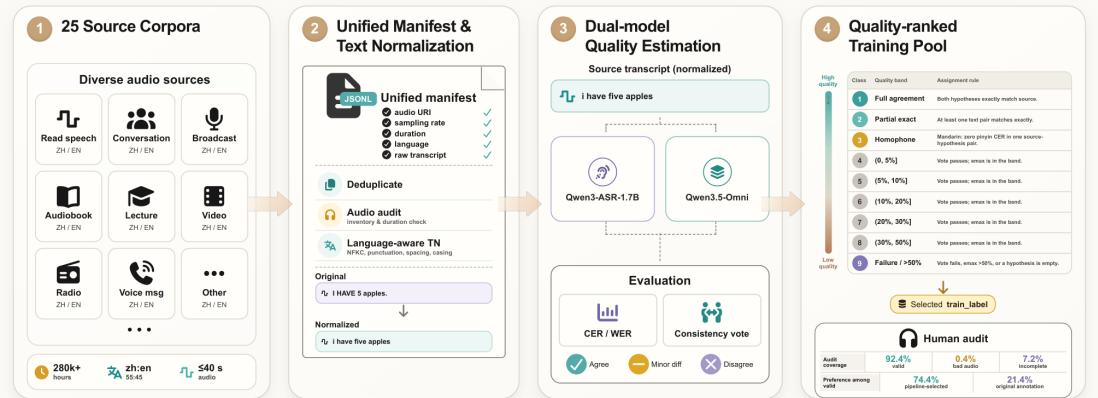
为处理源池中的异构监督,作者采用转录一致性过滤机制。对于每个带有参考的语音,两个强ASR系统产生离线假设。经过语言感知的规范化后,计算源转录与两个假设之间的三个成对编辑率,中文使用CER,英文使用WER。最大编辑率 emax 衡量最大分歧。完全一致、中文同音字一致和一致性投票分配九个等级之一,等级编号越低表示转录一致性越强。报告配置在两个蒸馏阶段均使用class 1。
如下图所示,完整的数据流水线包括语料统一、文本规范化、双模型质量估计和质量排序标签选择,以构建最终训练池。
剪枝过程分两跳进行,将编码器从18层减至16层,再减至14层。第一跳移除原始层{1, 18}。第二跳中,每个候选模型从同一个恢复的16层检查点开始,并进行简短的LoRA预热训练。作者将每个剩余层作为单次移除进行评估,然后评估一组固定的相邻和非相邻层对。候选选择基于在固定开发集上的最低聚合TER。该过程直接衡量在可用恢复预算下的移除后行为,认识到移除多个层后的恢复无法从相应的单层分数可靠预测。
参考框架图以全面了解X-AuT流水线,它集成了转录一致性过滤、用于层选择的行为探针、渐进式剪枝和三阶段恢复过程。
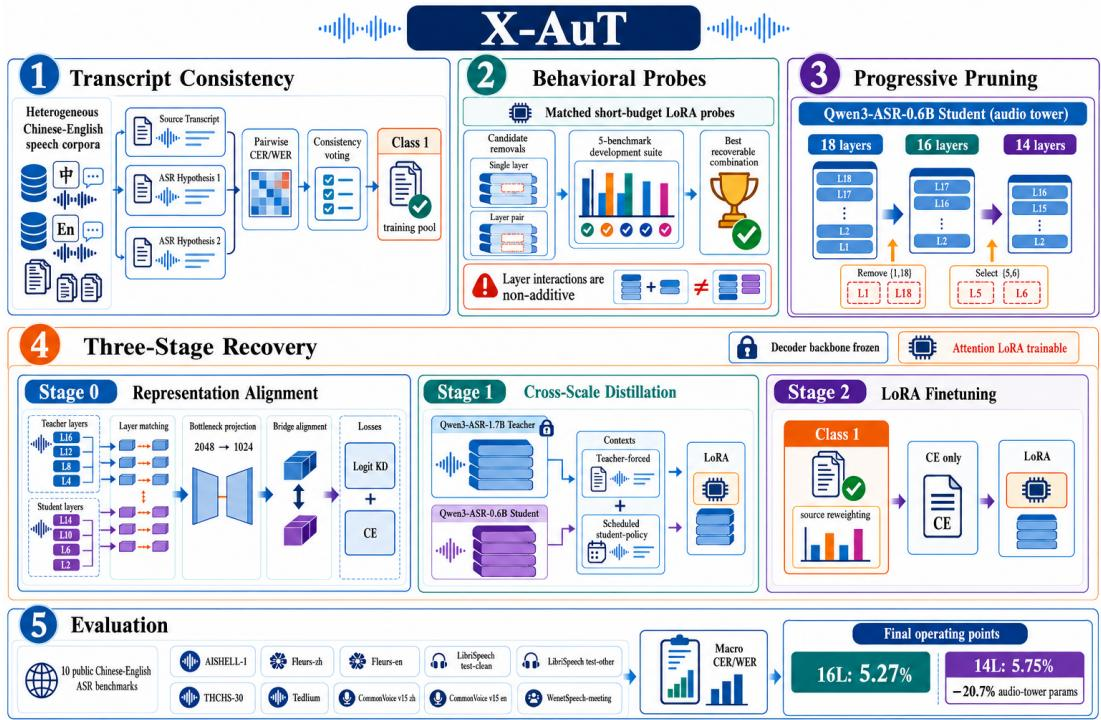
每个剪枝跳使用三阶段恢复方案。学生是剪枝后的模型,教师是拥有更深音频编码器的更大模型。教师参数冻结,推理时丢弃。
阶段0占据蒸馏epoch的前5%,结合中间层、桥接器、logit和转录损失:
LS0=λlayerLlayer+λbridgeLbridge+λlogitLlogit+λceLce.两种表示损失均求和均方误差和余弦距离。教师层均匀划分为 M 个有序组,学生层 m 与组 m 中的最后一个教师层对齐。一个学习的两层MLP,具有256维瓶颈,将教师隐藏和桥接特征投影到学生空间。Logit KD在黄金前缀下使用温度缩放的KL散度。剪枝后的音频编码器和桥接器完全可训练,而解码器基础权重保持冻结。
阶段1禁用中间层损失,使用桥接对齐、教师强制logit KD和黄金转录CE:
Loff=λbridgeLbridge+λlogitLlogit+λceLce.阶段1经过20%后,每第五个优化器步骤安排学生策略监督。学生贪婪地生成前缀,学生和教师在同一生成上下文中评估。它们的分布在每个模型的top-k支持的并集上进行比较。展开保护措施通过强制最小token生成、时长感知的最大值,并拒绝预算耗尽或重复的展开,防止退化前缀进入KD损失。
阶段2从最佳阶段1检查点初始化,并针对黄金转录CE优化一个epoch。音频编码器、桥接器和解码器LoRA适配器保持可训练,而绑定的输出嵌入被冻结。数据索引向目标域来源重新加权。此阶段不包含教师损失:
LS2=Lce(ygold,y^).实验
评估将深度缩减的ASR模型(从更大的跨尺度教师蒸馏而来)与原始0.6B基线进行比较,使用多阶段恢复过程,并以五个开发子集的宏平均进行检查点选择。结果显示,16层模型平均优于基线,而14层模型以微小的错误增加换取了更大的参数节省;更强的教师至关重要,因为自蒸馏会降低性能。层移除实验表明,层对交互和渐进式剪枝比单层重要性更重要,并且表示恢复可以部分但无法完全补偿编码器容量的损失。
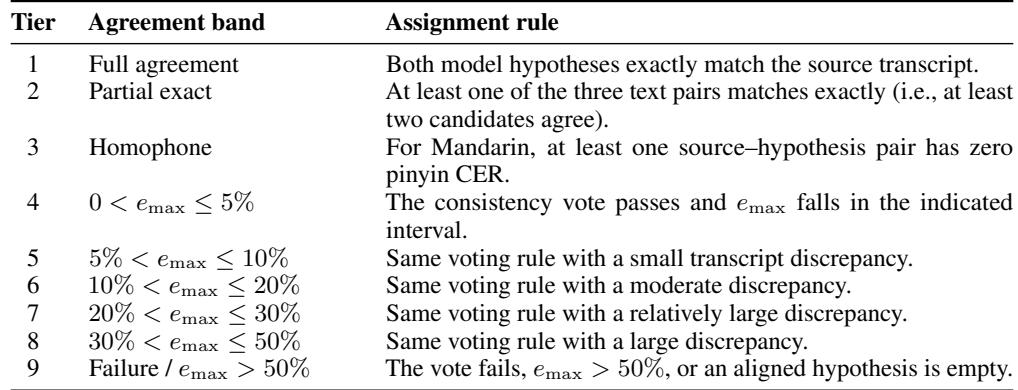
一个九级层次结构通过测量源转录与两个ASR假设之间的最大成对编辑率来对转录一致性进行排名。较低等级表示更强的一致性,从完全精确匹配到20–30%编辑率区间,并有一个单独的中文同音字等级。报告设置在两个蒸馏阶段仅保留Tier-1转录,将严格一致性过滤与阶段特定的源重加权解耦。Tier 1(完全一致)用于两个蒸馏阶段,仅保留两个ASR假设均与源完全匹配的转录。该层次从精确匹配到最大编辑率30%,并包含一个专门的中文同音字等级,其中拼音字符错误率为零。
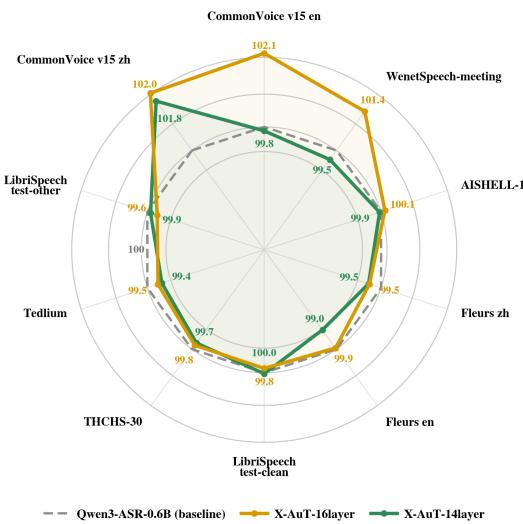
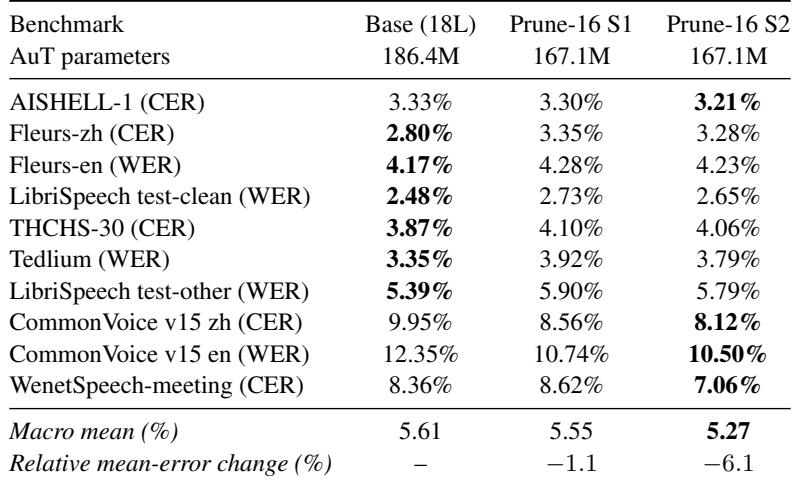
从18层音频编码器移除两层产生一个16层模型,参数约减少10%,宏平均错误率降低6.1%。阶段2微调在阶段1检查点基础上改善了所有基准,其中CommonVoice zh、CommonVoice en和WenetSpeech-meeting增益最大,而Tedlium出现小幅回归。16层模型的宏平均错误率低于18层基线,相对错误率降低6.1%。阶段2微调在所有评估基准上均优于阶段1,包括AISHELL-1、Fleurs、LibriSpeech、THCHS-30和Tedlium。
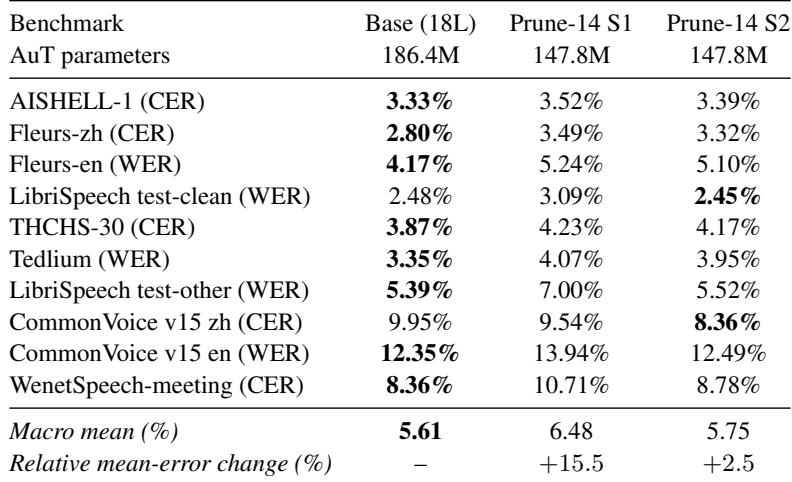
14层音频编码器参数减少20.7%,而宏错误率仅比18层基线增加0.14个百分点。阶段2恢复改善了所有基准,LibriSpeech test-clean几乎恢复到基线性能。最大退化发生在Fleurs-en(0.93个百分点),从18层到16层再到14层的渐进式剪枝对于实现这一微小错误增加至关重要。14层模型使用1.478亿音频塔参数,比1.864亿基线减少20.7%,而宏错误率升至5.75%,仅比基线高0.14个百分点。阶段2恢复改善了所有基准;LibriSpeech test-clean WER从3.09%降至2.45%,几乎与基线2.48%持平。Fleurs-en WER退化0.93个百分点(5.10%对4.17%),是单个基准的最大损失。渐进式剪枝(18→16→14)实现了5.75%的平均错误率,远优于直接18→14剪枝(6.73%),凸显了剪枝计划的重要性。微小的宏错误增加表明了一个有利的权衡:显著减少参数,平均准确率成本最小。
使用九级转录一致性层次过滤训练数据,仅保留两个ASR假设均与源完全匹配的Tier-1转录。将音频编码器从18层剪枝至16层,参数减少约10%,宏平均错误率降低;进一步剪枝至14层,参数减少20.7%,仅带来微小的错误增加,渐进式剪枝被证明对于避免更大退化至关重要。阶段2微调在所有基准上均优于阶段1,在大多数集合上恢复到接近基线的性能,表明严格的一致性过滤与渐进的编码器压缩相结合,可在最小的准确率成本下实现显著的参数节省。