Command Palette
Search for a command to run...
Benchmark Radar:面向 AI 基准与评估的活态数据库与搜索引擎
Benchmark Radar:面向 AI 基准与评估的活态数据库与搜索引擎
Koutian Wu Junjie Zhou Ergan Shang Jiayu Wang Pengqian Han Junkai Wang Wanghan Xu
摘要
大语言模型(LLM)及其他 AI 系统的基准研究者和开发者需要找到相关评测,定位其基准数据集与代码,并理解所报告分数背后的实验设置。我们提出 Benchmark Radar,一个用于检索和发现 AI 基准的活态数据库与搜索引擎,覆盖 LLM 评估、智能体与工具使用基准、编程、推理、安全以及领域特定评测。该系统将基准论文、代码仓库、数据集和发布版本的每日发现,与可搜索的基准目录、模型卡和技术报告中的提及以及分数历史相结合。它保留来源标识和引用信息,使读者能够审查候选基准及其评估证据。每日发现依托 37 个来源:13 个直接连接器和 24 个第一方研究与工程信息流。目录包含来自 4 个基准目录的 1,283 条来源记录,以及针对 790 条记录的 12,916 条数值观测。我们描述了采集与检索方法,对整个目录进行了审计,并考察了基准饱和现象、采用趋势以及分数比较的局限性。通过一个完整的工作示例,我们逐步展示了如何查询目录并在设计新评估时审查基准证据。我们发布了包含基准排行榜、分数与实测使用量的帕累托前沿视图、饱和与趋势视图、每日信息流、可下载证据、用于离线查询的命令行界面(CLI)以及可复现分析的 Web 仪表盘。
一句话总结
一个由卡内基梅隆大学和清华大学等多机构组成的联合团队推出了Benchmark Radar,这是一个持续更新的动态数据库与搜索引擎,汇集来自37个来源的AI基准测试,并提供网页仪表板,包含分数历史、帕累托前沿视图、趋势分析,以及用于可复现评估设计和现有技术搜索的命令行界面。
核心贡献
- Benchmark Radar是一个动态搜索引擎与数据库,整合了从37个来源每日发现的AI基准测试论文、代码库和发布,提供了一个可搜索的目录,包含1,283条来源记录、模型卡提及以及分数历史,并保留来源身份和引用信息。
- 对该目录进行了全面审计,涵盖790条记录中的12,916项数值观察,检查基准测试的饱和程度、采用趋势和分数比较局限,并附有可复现分析和可视化支持。
- 一个现有技术搜索的完整示例展示了系统如何通过支持对目录的查询以及对基准证据和报告设置的检视来助力评估设计。该版本提供网页仪表板,包括基准排行榜、分数与实测使用量的帕累托前沿视图、饱和度和趋势视图、每日推送、可下载证据、用于离线查询的命令行界面以及可复现分析。
引言
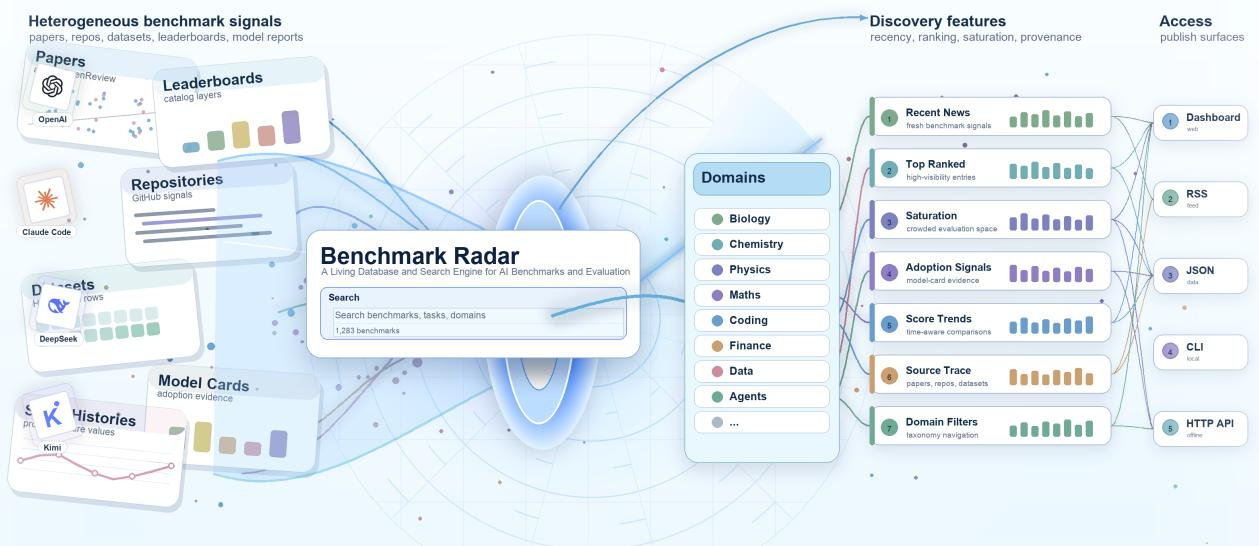
大语言模型的评估依赖衡量编程、推理和领域特定能力的基准测试,但查找某个基准的资料、使用历史和报告分数通常需要在论文服务器、代码仓库、排行榜和厂商博客之间进行手动搜索。现有的目录和排行榜覆盖范围有限,然而将新基准与其数据集关联起来,或追踪其在后续模型报告中的使用方式,这一过程依然支离破碎。作者推出Benchmark Radar,这是一个动态搜索系统,聚合来自公开来源的基准记录,通过共享标识符关联相关条目,并展示每日发现、模型报告提及以及附有文档化评估设置的分数历史,使模型性能声明背后的证据更易于发现和检视。
数据集
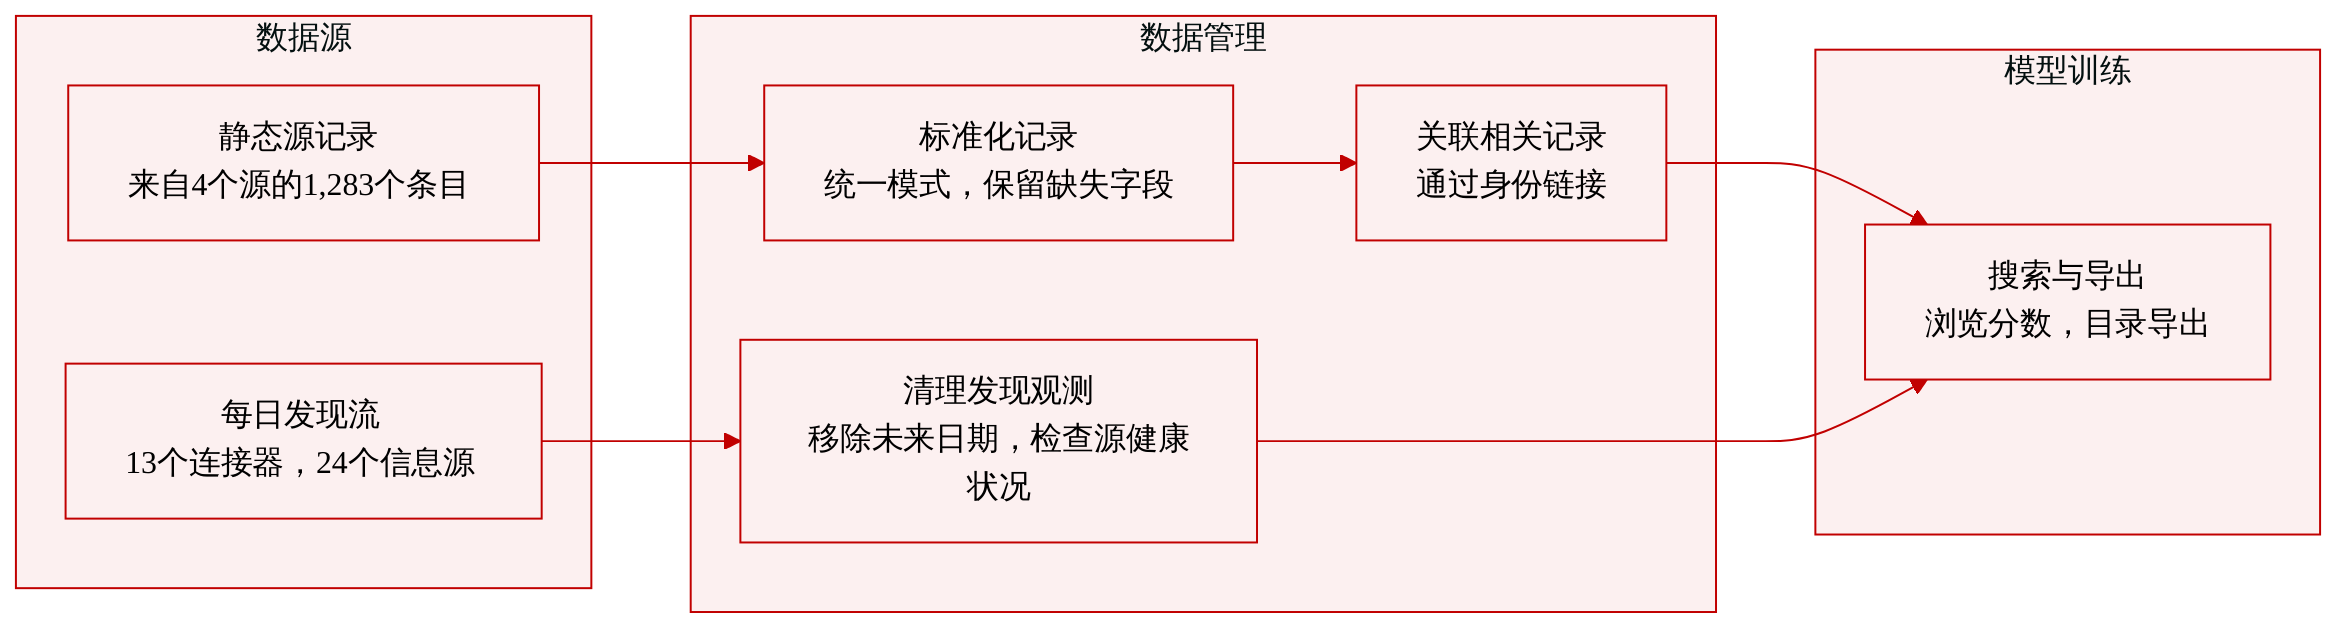
作者构建了一个基准目录数据集,将静态来源记录与每日发现观察相结合。该数据不用于训练预测模型,而是构成搜索系统的底层知识库。
数据集构成与来源
- 来源记录是从四个核心上游来源(arXiv、Hugging Face Hub、GitHub搜索,再加其他学术索引、数据集托管平台、仓库发布和机构信息流)采集的基准条目。
- 发现观察每天从13个直接连接器和24个第一方信息流中采集,记录在公开来源中发现的提及、发布和更新,并通过精确标识符(DOI、arXiv ID、仓库URL)关联到相关对象。发现观察与基准记录计数分开保存。
各子集的关键细节
- 来源记录(静态目录)
- 来自四个来源的1,283条记录;两个来源可能指向同一基准,两者均被保留。
- 790条记录包含12,916项数值分数观察;493条记录没有数值分数,但其中464条仍至少链接到一篇论文、一个代码仓库或一个数据集。
- 在整个目录中,475条记录链接到论文,506条链接到代码库,293条链接到数据集(一条记录可包含多种链接类型)。
- 记录被规整到统一的字段(名称、标识符、对象链接、分数观察、模型身份、引用文献),即使分数、日期或引用缺失,依然被保留。经过审核的标识链接将相关记录关联起来,而不合并它们各自的观察内容。
- 发现观察(每日流)
- 每次采集运行扫描48小时窗口,并要求核心来源健康后再发布。未来日期的行会被移除。
- 观察不会增加基准计数,而是填充通过标识符关联的并行历史记录。
处理管线
- 记录规整:将来源记录映射到统一模式,规范化名称、标识符、对象链接、模型身份和引用文献。目录保留带有缺失字段的条目。
- 发现清洗:每日采集过滤掉未来日期的观察,并在发布前验证核心来源(arXiv、Hugging Face Hub、GitHub搜索)的健康状态。
- 标识链接:通过经审核的标识链接将相关记录关联起来,同时保持其观察和计数与原始发现流分离开来。
数据使用方式
- 经处理的来源记录和发现观察输入一个搜索界面,该界面支持完整目录导出和特定视图的显示过滤器(表2)。
- 生成的目录可按日期、报告分数和评分模型数量进行浏览(图3和图4),作为基准追踪系统的参考数据集,而非训练语料。
方法
作者设计Benchmark Radar来系统性地收集、保存和检索来自公开来源的基准记录与发现观察。系统架构将基准目录与发现历史分开,确保评估指标与时间性提及和发布更新保持区分。
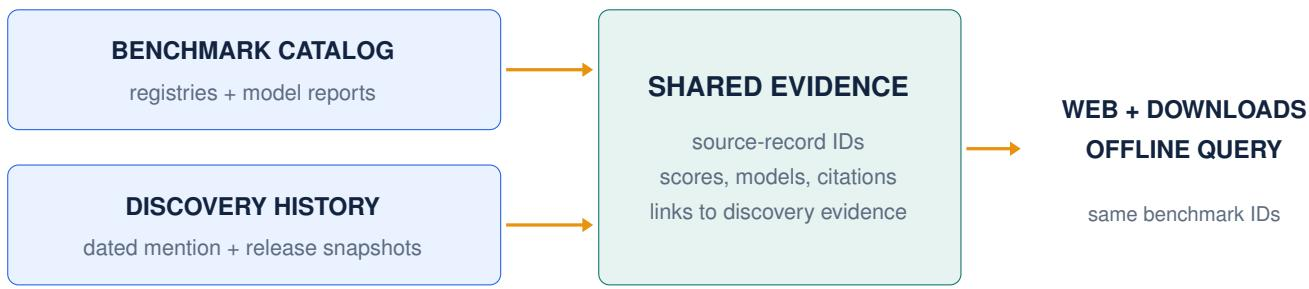
如框架图所示,两条主要的输入路径支撑着系统发布管线。基准目录从注册库和模型报告(包括模型卡、技术报告、系统卡和发布帖)中采集数据。这些输入通过统一的记录结构汇入。与此同时,发现历史捕获标注日期的提及和发布快照。两条路径汇聚到一个共享的证据层,维护来源记录ID、分数、模型身份、引用和指向发现证据的链接。这个共享层随后使用稳定的基准ID为网页界面、下载和离线查询客户端提供服务。
每日发现采集通过在多个公开来源中搜索48小时窗口来运作。系统依赖核心来源,如arXiv、Hugging Face Hub和GitHub搜索,并辅以学术索引、数据集托管平台和机构信息流等额外路径。每次采集运行记录计数和错误,移除未来日期行,并在发布前要求核心来源状态健康。发现观察,如采集到的提及和更新,使用DOI、arXiv ID和仓库URL等精确标识符关联到对象。这些观察与目录一起保存,以提供历史背景,但不会增加基准目录总数。
为确保在比较测量前的数据完整性,作者将来源记录规整到统一字段中。这一过程标准化了名称、标识符、对象链接、分数观察、模型身份和引用文献。经审核的标识链接将相关记录关联起来,同时保留各自的观察和计数。
在候选检索方面,系统使用一个共享查询服务,以一致的响应格式同时提供给CLI和HTTP接口。词汇搜索采用BM25F,即一种字段加权词匹配得分,对名称和短语匹配施加有限增强。每个搜索结果会暴露匹配和缺失的查询词、它们出现的字段以及得分成分,确保来源成员身份不会改变排序。这一设计让分析师或agent能够检视记录的任务、分数设置和引用,为适用性判断保留必要的证据。
最后,系统对全量数据进行全面审计。普查过程遍历重建目录索引中的每一条记录,计算有限的数值分数观察、评分模型和引用文献,而不使用日期或分数过滤。摘要计算的资格取决于特定的测量标准,例如声明的百分比单位和已知的分数方向,确保重新缩放或聚合器声明不会错误地建立测量尺度。
实验
评估设置将重建的包含1,283条基准记录的目录与包含超过11,000项观察的每日发现采集结合起来,以描绘整体图景。基准记录被归入一个多维度分类体系,将能力与交互范式分开,揭示出agent性评估分布在编程和其他领域,而非局限于单一类别。发现流以五个来源为主,通过追踪一段时间内的新发布和更新来补充目录。一个完整的例子展示了系统如何让研究人员或agent高效地检查现有工作,避免提出重复的评估。
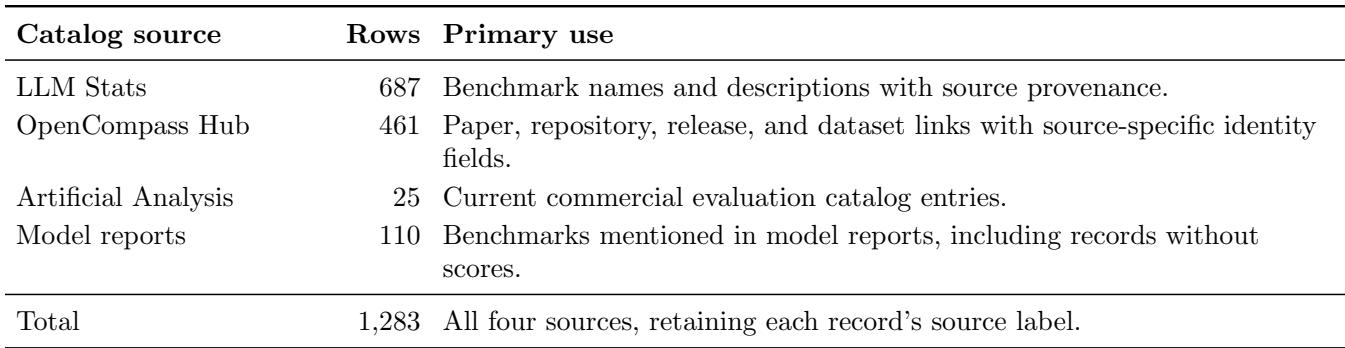
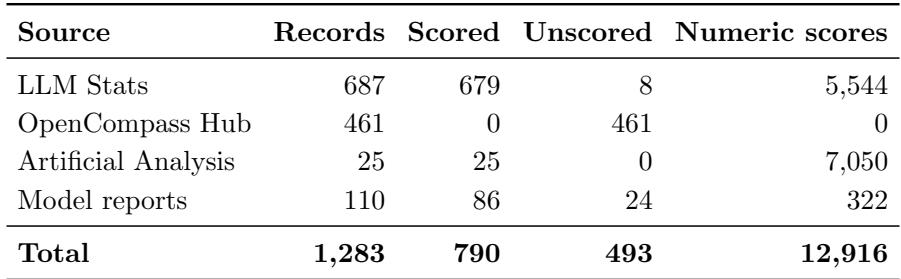
v0.11.0基准目录从四个不同来源收集了1,283条记录。LLM Stats贡献了最大份额(687条记录),提供基准名称和出处;模型报告贡献了110个条目,其中一些没有分数;此外还有来自OpenCompass Hub的461条记录,以及来自Artificial Analysis用于商业评估的25条记录。LLM Stats以1,283条记录中的687条占据主导地位,提供基准名称、描述和来源出处。模型报告新增110条记录,其中包括即使没有分数报告也被提及的基准。
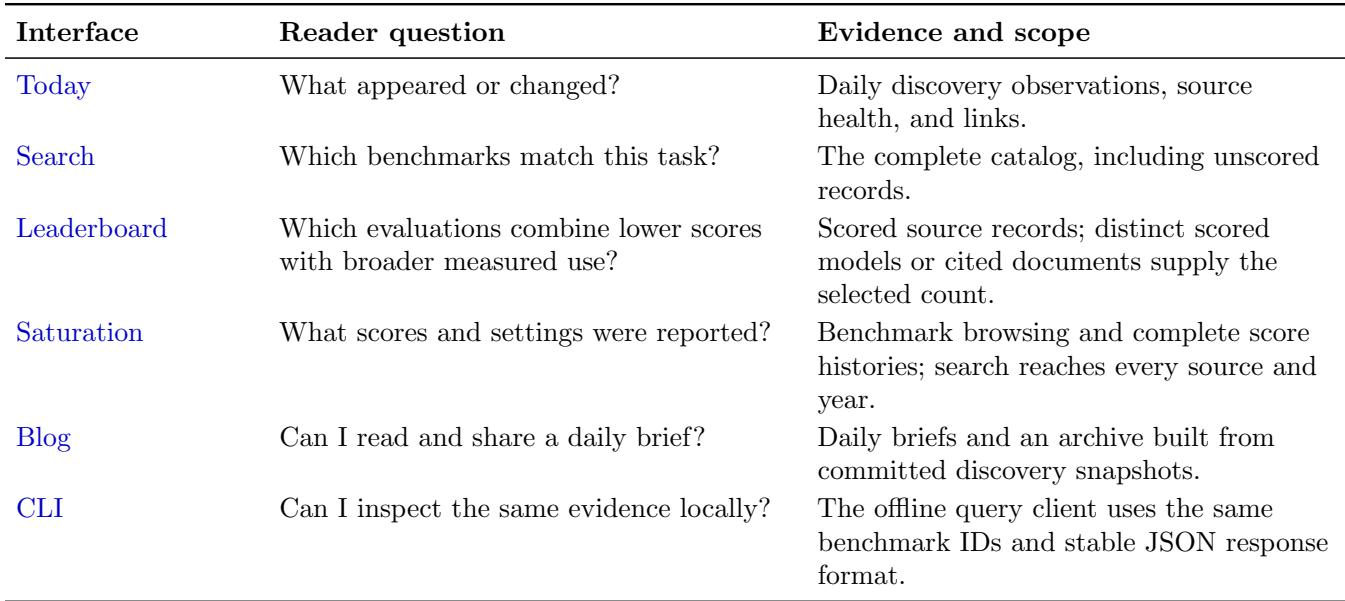
平台提供六个界面,每个对应一个特定的读者问题和一个明确的证据范围。Today界面展示每日发现观察和来源健康状态,Search提供对完整目录(包括无分数记录)的访问。Leaderboard和Saturation服务于不同的分析需求:前者将证据限制在有分数记录且包含不同模型或文档计数的范围内,后者则暴露所有来源和年份的完整分数历史与基准浏览。Leaderboard仅考虑有分数的来源记录,并计算不同评分模型或引用文献数量,以回答哪些评估结合了较低分数和更广泛的实测使用。Saturation绘制全部可用N分数观察,无论来源或年份。CLI离线客户端依赖相同的基准ID和稳定的JSON响应格式,支持对证据的本地检视。
基准目录包含来自四个来源的1,283条记录,其中790条带有数值分数,总计12,916项观察。三个来源混合了有分数和无分数的记录,而OpenCompass Hub贡献了461条完全没有分数的记录。Artificial Analysis提供了每条记录最密集的分数,以目录中极小部分贡献了全部数值观察的一半以上。OpenCompass Hub占461条记录,但没有一项数值分数,12,916项数值分数中为零。Artificial Analysis仅贡献25条记录,却提供了全部数值分数观察的一半以上(7,050项)。
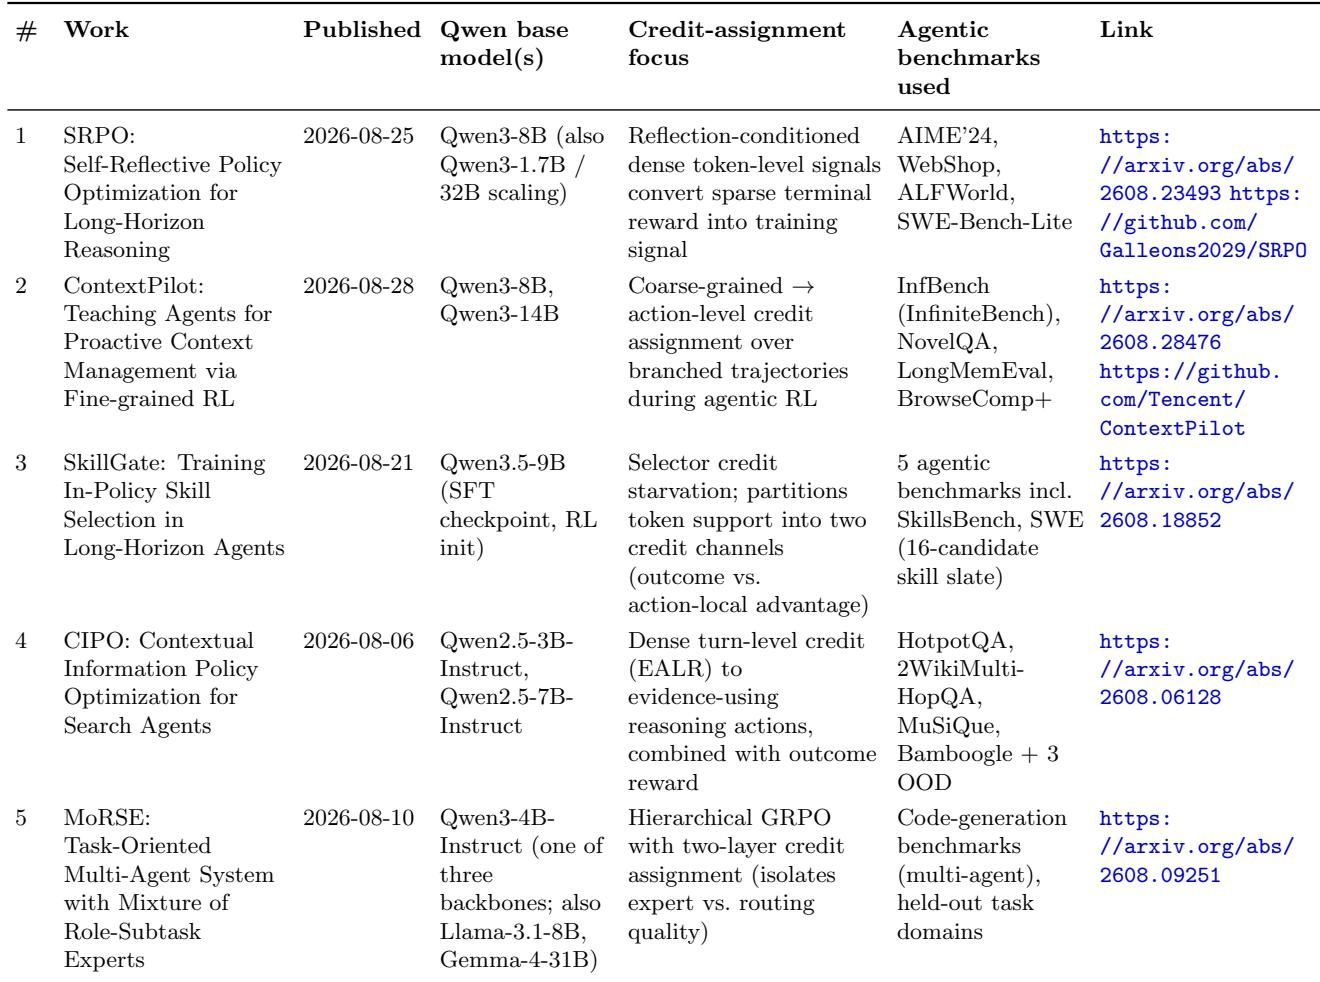
一系列近期关于agent性训练中贡献分配的工作(均发表于2026年8月,并采用小型Qwen系列基础模型)展示了一种超越稀疏终局奖励、转向更细粒度奖励信号的趋势。技术包括基于反思的密集token级贡献、动作级分支、选择器贡献划分、回合级证据奖励以及分层两级分配,每项技术在不同的agent基准上进行评估。所有被调研的工作使用参数量从3B到14B的Qwen基础模型,其中8B模型出现最为频繁。贡献分配策略从稀疏终局奖励转向token、动作或回合级的密集信号。这些工作集中在2026年8月下旬三周内,表明对该问题的同时且积极的研究。评估基准覆盖长上下文问答、网页导航、多跳推理、代码生成和多agent任务。
基准目录评估汇总了来自四个异构来源的1,283条记录,揭示绝大多数数值分数来自极小一部分记录,而许多条目完全没有分数。六个平台界面服务于不同的分析需求,从每日发现到完整的历史分数浏览。对当代agent性训练中贡献分配工作的调查显示,在紧凑的2026年8月时间窗口内,从稀疏终局奖励向token、动作或回合级密集细粒度信号的明显转变,并以小型Qwen系列模型在多种agent基准上进行评估。