Command Palette
Search for a command to run...
NCP-ArchPreview 技术报告:通过下一概念预测迈向隐空间语言模型
NCP-ArchPreview 技术报告:通过下一概念预测迈向隐空间语言模型
摘要
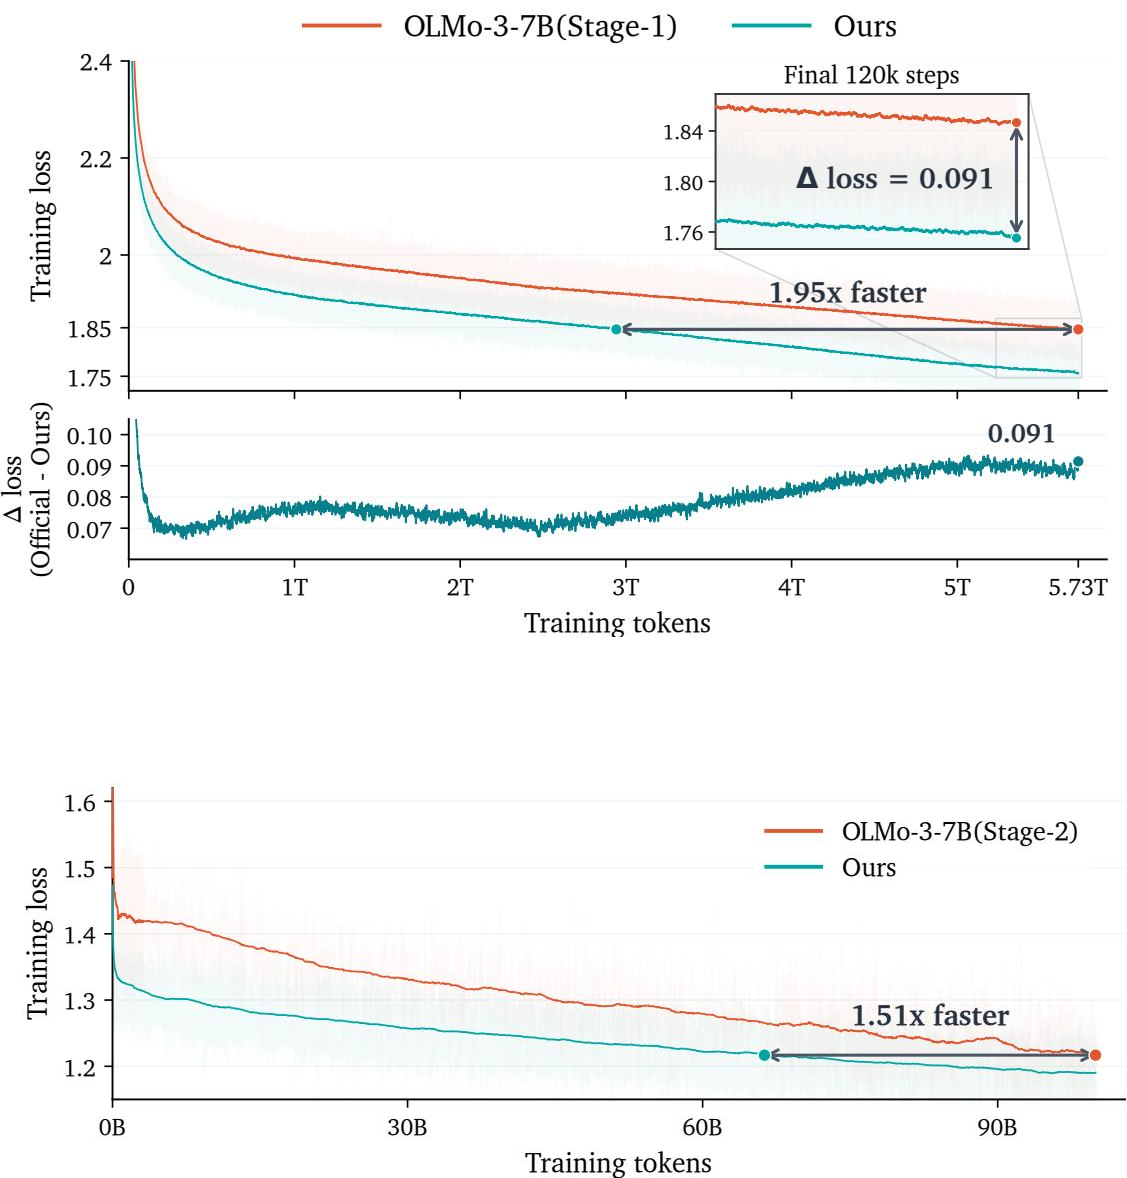
我们提出 NCP-ArchPreview,一种隐空间语言模型,将自回归预训练推进到超越标准下一词元预测(NTP)的层面。在 NTP 之外,该模型通过下一概念预测(NCP)学习预测跨越多个词元的离散概念,引入了一个显式且更具挑战性的概念级目标,同时保留了标准的词元级自回归生成。NCP-ArchPreview 通过直接从其隐藏状态构建乘积量化概念词汇表来建立隐空间,随后通过一个专用的概念模块学习预测未来概念。这些预测的概念随后被反馈到词元级以指导后续生成,NTP 与 NCP 以端到端方式联合训练。我们将该架构扩展到 89 亿参数,并在 Dolma-3 数据集的 5.73 万亿词元上进行训练,这是迄今为止隐空间语言模型的最大规模演示。值得注意的是,仅消耗总训练词元的 51.3%,NCP-ArchPreview 就达到了 OLMo-3-7B 的最终预训练损失。在完整预训练后,其下游任务宏平均性能超越 OLMo-3-7B 达 2.45 分,其中在 GSM8K 上取得了显著的 5.99 分提升。受控实验分离出由隐架构和 NCP 目标带来的清晰性能增益递进。此外,仅使用标准计算量的 85%,NCP-ArchPreview 就接近了严格参数对齐的 89 亿参数基线的训练损失。学习到的隐空间在预训练阶段后仍极具价值:仅更新 1700 万参数的 VQ 模块即可为领域自适应提供一种新颖的轻量级接口,而将概念表示简单注入 DFlash2 草稿器则可将平均接受长度提升 4.17%,且开销可忽略不计。通过证明词元与概念联合建模在大规模下的可行性,这些结果将隐空间预测定位为不仅是辅助目标,更是下一代基础模型的高效且可扩展的架构蓝图。我们发布了每 10 万训练步获得的 Stage-1 检查点、相应的草稿器模型,以及最终的 Stage-1 / Stage-2 检查点。
一句话总结
来自上海人工智能实验室、LUMIA实验室和上海交通大学的研究者提出了NCP-ArchPreview,一个8.9B参数的隐空间语言模型,该模型使用从隐藏状态导出的乘积量化概念词汇表,联合训练next-token预测和Next Concept Prediction(NCP),实现了卓越的预训练效率和下游性能,同时支持轻量级领域适应和推测解码改进。
核心贡献
- NCP-ArchPreview是一个8.9B参数的隐空间语言模型,联合学习next-token和next-concept预测,首次将隐空间建模扩展到万亿token预训练。
- NCP-ArchPreview仅用51.3%的训练token就达到了OLMo-3-7B的最终预训练损失,并且在完整预训练后,下游宏观平均分比该基线高出2.45分,其中GSM8K上提升了5.99分;它还以85%的计算量接近参数对齐的8.9B Transformer,并在缩放定律实验中展示了1.74倍的计算效率提升。
- 学习到的概念空间通过仅更新17M参数的VQ模块实现高效的领域适应,将概念表示注入DFlash2起草器可将推测解码的平均接受长度提升4.17%,且开销可忽略不计。
引言
在生成式AI中,模型学习的表示空间可能与其参数数量一样关键。尽管语言模型自然地在隐藏状态中形成高层抽象,但标准的next-token预测将其视为副产品:监督仅限于单个表面token,没有明确的目标来指导语义结构如何在更长跨度上展开。以往的层次化和隐空间架构要么固定了隐单元的粒度,要么引入了与token级损失绑定的新预测目标,使得大规模的直接隐空间建模在很大程度上未经测试。作者提出了NCP-ArchPreview,一个8.9B参数的基础模型,该模型联合预训练next-token预测和一种新颖的next-concept预测目标。通过从预训练一开始就预测多token跨度上的离散概念,并扩展到5.73万亿个token,该工作表明,与强大的纯token基线相比,隐空间语言建模可以显著提高训练效率、下游性能和计算帕累托最优性。
方法
作者提出了NCP-ArchPreview,一个隐空间语言模型,它通过在学习的离散隐空间中运行的概念级预测通路来增强标准的next-token预测。该模型将token序列压缩为连续的概念表示,通过乘积向量量化将其离散化,并自回归地预测未来的概念。这些预测随后被融合回token流中,以指导token生成。分层残差连接进一步混合跨层和跨模块的信息,而整个系统通过联合目标进行端到端训练。
骨干网络被组织为三个模块:Token编码器、概念模块和Token解码器。给定输入序列x1:T,Token编码器产生token级隐藏状态h1:T。一个平均池化算子将每k个连续的token状态分组为一个连续的概念表示cm,产生长度为M=⌊T/k⌋的概念序列。然后,这些连续概念通过向量量化映射到有限的离散词汇表,形成用于预测的结构化目标空间。概念模块消费概念历史,并将下一个概念预测为码本条目的可微组合。预测的概念序列被重复到token分辨率,进行因果偏移以防止信息泄露,并在Token解码器执行next-token预测之前加到token级状态上。
为了学习离散的概念词汇表,作者采用了乘积量化。每个概念向量cm被分割成S个等维度的段,每个段被分配给专用码本Es={e1s,…,eNs}中最近的条目。量化后的概念是所选码字的拼接。乘积量化产生了NS种可能的组合,同时保持各个码本较小,极大地扩展了离散概念空间的容量。向量量化损失LVQ使用编码器侧的停止梯度将所选码本条推向连续表示,使得码本跟踪隐分布而不直接改变token级隐藏状态。
概念模块从概念历史c<m自回归地预测下一个概念。一堆Transformer层产生隐状态um,对于每个乘积量化段s,一个段特定的预测头输出码本条上的概率分布πms。不是硬离散选择,预测的段形成为期望c^ms=∑nπm,nsens,完整的预测概念c^m是这些段的拼接。这使得预测路径完全可微,同时将输出限制在学习到的码本的线性张成空间中。next-concept预测由c^m和分离的连续目标cm之间的均方误差损失LNCP监督,该损失通过前面的概念表示同时更新概念模块和Token编码器。
预测的概念通过将每个c^m重复k次并应用因果偏移Δ=k注入到token流中。对于token位置t≥Δ,概念信号bt取自适当偏移的概念索引;较早的位置接收零向量。这确保了没有未来token信息泄露到预测中。概念信号逐元素地加到token隐藏状态上:ht=ht+bt。然后Token解码器从融合状态建模next-token分布p(xt+1∣x≤t),使用标准的因果next-token预测损失LNTP进行训练。
为了增强跨不同深度和粒度的信息流,模型结合了分层残差连接,包含两种互补机制。模块内残差连接(IRC)通过允许每一层组合来自多个先前深度的表示来泛化标准残差加法。在模块中的第ℓ层,候选集Xℓs收集初始状态和所有先前的残差更新状态。一个轻量级MLP应用于当前块输出,产生未归一化的系数,下一个隐藏状态是候选的加权和。MLP被初始化为仅选择最近的残差更新状态,恢复标准残差连接,而训练可以学习纳入更早的表示。
跨模块残差连接(CRC)在模块之间传递信息。当源模块和目标模块以不同的序列粒度运行时,源表示首先通过分块或重复进行对齐。对目标状态应用softmax归一化MLP产生深度方向的系数,层归一化的源状态的加权和被加到目标流上,并用学习到的对角矩阵进行缩放。使用了三条CRC通路:TokenEncoder → ConceptModule、TokenEncoder → TokenDecoder和ConceptModule → TokenDecoder。最后一条连接遵循与预测概念通路相同的因果偏移。对角缩放被初始化为小值,因此模型最初表现得像原始骨干网络,并逐渐学习利用跨模块信号。
训练是端到端进行的,联合优化Token编码器、概念模块、Token解码器和码本。总损失结合了next-token预测损失、next-concept预测损失和向量量化损失:
Ltotal=LNTP+αLNCP+βLVQ,其中α和β控制辅助目标。NTP损失为所有参数提供密集监督,NCP损失鼓励编码器保留对概念预测有用的信息,VQ损失将码本拟合到概念分布,而不通过编码器反向传播。优化对矩阵值参数使用Moonlight Muon,采用按max(din,dout)缩放的正交化更新、权重衰减,以及从6×10⁻⁵开始的余弦学习率调度。嵌入、偏置和其他非矩阵参数使用AdamW优化。
实验
该论文评估了NCP-ArchPreview,即OLMo-3-7B的一个概念预测变体,使用两阶段课程和涵盖知识、推理和代码的30个基准测试的综合套件。NCP-ArchPreview始终产生比基线更低的训练损失和更强的下游结果,缩放实验证实了明显的计算效率优势。消融实验表明,概念模块、分层残差连接和next-concept预测损失各自都有重要贡献,而基于VQ的适应仅更新一小部分参数即可实现有竞争力的领域迁移,且遗忘更少、吞吐量更高。概念表示还被证明对多token预测和块并行推测起草有益,并且每头归一化被确定为基线配置中训练不稳定性的补救措施。
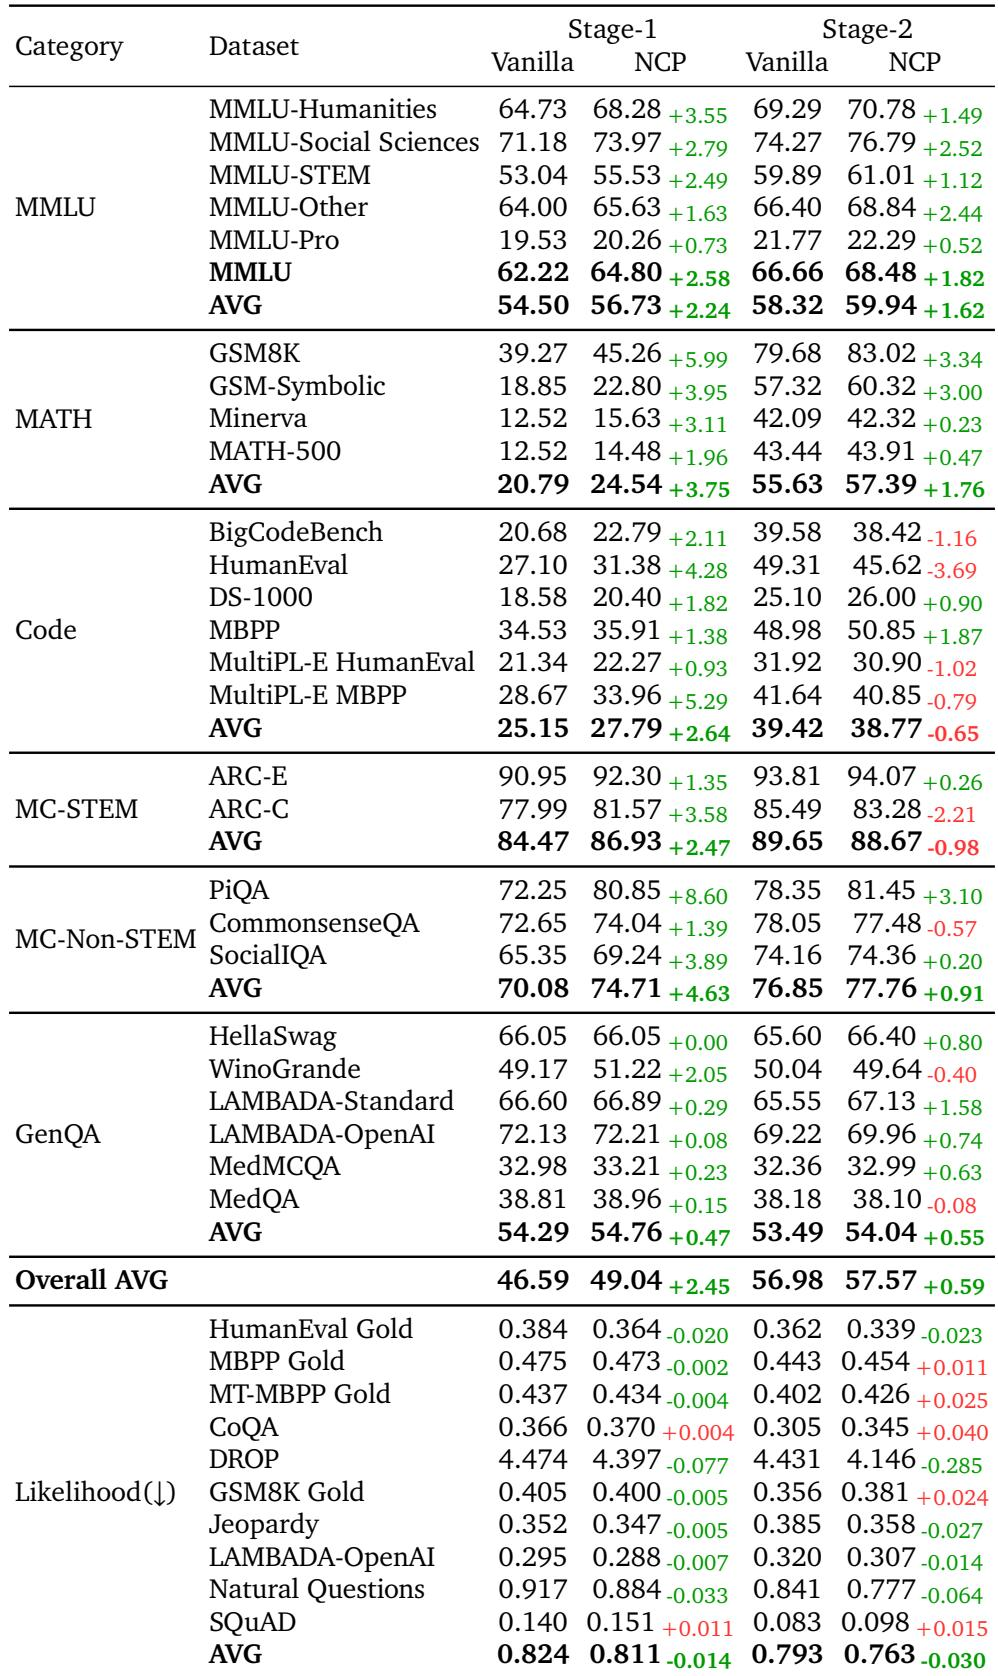
NCP-ArchPreview在两个训练阶段的所有MMLU子集上始终优于vanilla OLMo-3模型,Stage-1的提升大于Stage-2。整体MMLU分数在Stage-1提高了2.58分,在Stage-2提高了1.82分,这得益于人文学科和社会科学方面的特别强劲的进步。NCP-ArchPreview在Stage-1的整体MMLU比vanilla模型提高了2.58分,在Stage-2提高了1.82分。最大的绝对增益出现在MMLU-人文学科(Stage-1 +3.55)和MMLU-社会科学(Stage-1 +2.79),所有子集都显示出正向改进。
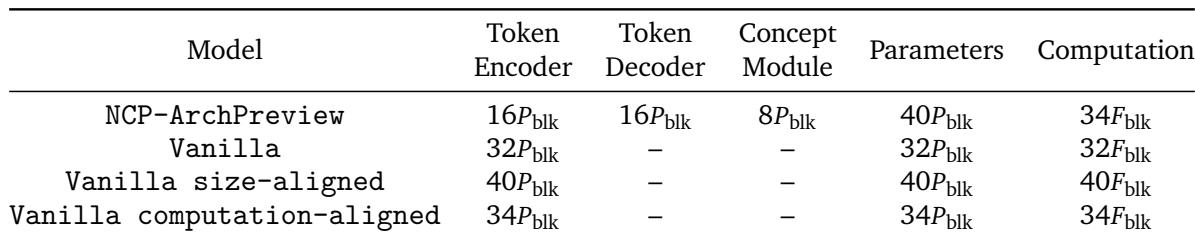
NCP-ArchPreview结合了token编码器、token解码器和概念模块块,达到40个块等效参数,同时仅使用34个块等效计算单元。它优于计算量匹配的vanilla Transformer,并接近参数匹配的vanilla模型的性能,尽管所需计算量减少了15%。这些收益源于架构,而不是简单地增加参数或计算量。NCP-ArchPreview超越了使用相同总计算量(34F_blk)的vanilla Transformer。它几乎与参数相等(40P_blk)的vanilla Transformer持平,而只使用了85%的计算量。每个概念模块块增加的参数与标准块相当,但产生的计算量不到四分之一,从而实现了高效扩展。
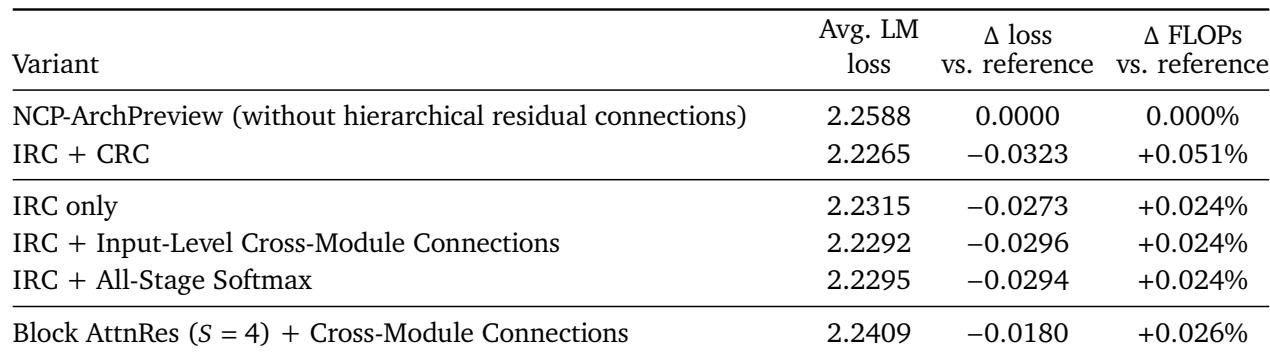
仅添加模块内残差连接(IRC)就能显著降低语言建模损失,同时分析训练FLOPs的增加非常小。将IRC与跨模块连接相结合,在不增加额外计数的张量收缩的情况下进一步改善了损失,而完整的IRC + CRC设计以更高的FLOPs成本实现了最大的损失降低。基于块的注意力残差变体在可比的计算预算下表现不如所有基于IRC的配置。IRC单独提供了0.0273的损失降低,仅增加0.024%的额外分析FLOPs,提供了强大的效率权衡。IRC + CRC产生了最佳损失(降低0.0323),但需要0.051%的额外FLOPs,是IRC单独开销的两倍多。在IRC上添加输入级跨模块连接,与仅IRC相比损失改善了0.0023,同时保持分析FLOPs不变,为0.024%。在所有阶段应用softmax归一化,在相同FLOPs下与跨模块变体产生几乎相同的损失(差异0.0003)。带有跨模块连接的Block AttnRes仅实现了0.0180的损失降低,FLOPs为0.026%,显著小于任何基于IRC的变体。
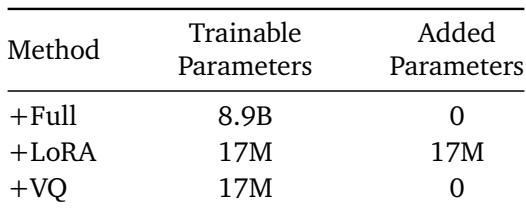
VQ训练通过仅更新码本和概念预测头来适应模型,使用17M可训练参数而不添加任何新参数。相比之下,LoRA引入17M额外参数以达到相同的可训练数量,而全参数训练更新所有8.9B现有权重。这使得VQ成为一种参数高效的策略,避免了模型大小的增加。VQ训练更新17M现有参数,添加零个新参数。LoRA匹配17M可训练参数数量,但向模型添加了17M新参数。全训练更新所有8.9B参数,不添加任何新参数。
仅更新VQ码本和概念预测头产生了最高的代码平均分,并且是唯一一种改善所有四个编程基准的适应方法。全参数和LoRA微调都在MBPP+上遭受大幅退化,这使其整体代码性能低于VQ结果。在所有适应设置中,NCP-ArchPreview模型保持了比相应的OLMo-3-7B变体更高的通用基准平均分。VQ适应改善了每个代码任务,并在适应的变体中取得了最高的代码平均分。全参数训练和LoRA都在MBPP+上导致严重下降,使全训练代码平均分低于其Stage-1基线。经过全训练或LoRA适应的NCP-ArchPreview在代码和通用基准上都优于匹配的OLMo-3-7B对照组。
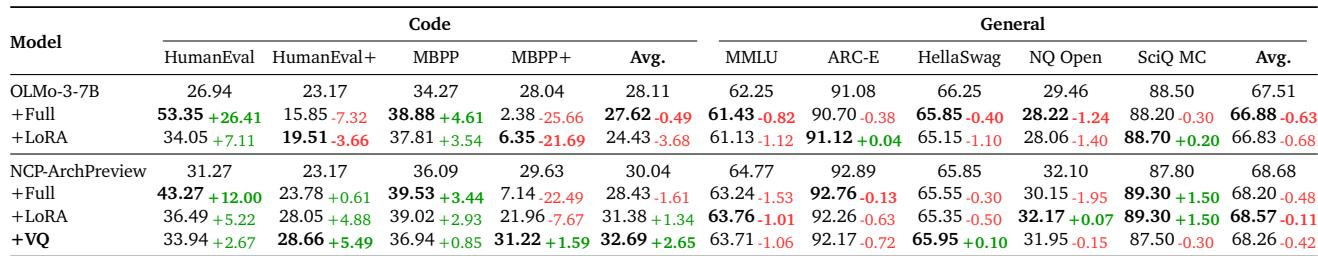
NCP-ArchPreview模型在MMLU基准上始终优于vanilla Transformer,特别是在人文学科和社会科学方面,同时由于高效的概念模块块,以少15%的计算量实现了参数匹配的性能。模块内残差连接以可忽略的开销显著降低了语言建模损失,添加跨模块连接进一步改善了损失。参数高效的VQ适应仅更新现有码本和概念预测头而不添加新参数,产生了最佳的代码基准结果,并避免了全参数或LoRA微调中出现的退化,同时NCP-ArchPreview在所有适应设置中保持了更高的通用基准平均分。