Command Palette
Search for a command to run...
AuK 技术报告:一个用于语音生成与编辑的开源基础模型
AuK 技术报告:一个用于语音生成与编辑的开源基础模型
摘要
我们介绍了 AuK,一个开源基础模型,通过自然语言指令和音频上下文的统一接口,将语音生成与编辑功能整合于一体。为支持这一广泛的能力集,我们构建了约 30.3 亿条指令-音频实例,以及跨五个任务族(语音生成、内容编辑、增强与分离、副语言编辑和声学编辑)的 195 万小时有效监督数据。AuK 结合了用于语义条件的多模态大语言模型、在语音、通用音频和音乐上联合训练的 VAE 用于声学条件,以及一个混合整流流 Transformer,该 Transformer 执行双流 MMDiT 块,随后是统一的单流 DiT 块用于生成。训练从仅生成的热身阶段开始,然后进行联合生成-编辑预训练。随后,我们应用互补的后训练策略:针对开放式编辑的人类反馈偏好优化,以及针对语音生成的基于奖励的强化学习。为降低推理成本,我们进一步通过一致性初始化和任务路由的解耦 DMD 对模型进行蒸馏。由此得到的 AuK-Flash 在无分类器引导的情况下执行 4 步推理,并在匹配条件下实现了相比完整模型 4.5 倍的墙钟加速。实验表明,在零样本和指令控制的语音生成以及通用指令引导编辑方面,AuK 表现出领先性能,同时在信号级恢复任务上保持竞争力。我们发布了源代码和模型权重,以支持可复现性和进一步研究。
一句话总结
AuK 是一个由作者提出的开源基础模型,通过自然语言指令和音频上下文统一语音生成与编辑任务,利用 3.03×10⁹ 条指令-音频样本和 1.95×10⁶ 小时的跨五个任务族监督数据进行训练。模型结合了多模态大语言模型、联合训练的 VAE 以及混合整流流 Transformer(包含双流 MMDiT 和单流 DiT 模块),随后通过人类反馈偏好优化和基于奖励的强化学习进行后训练,并推出蒸馏变体 AuK-Flash,实现 4-step 推理和 4.5× 墙钟加速。该模型在零样本和指令控制的语音生成与编辑任务上处于领先水平,同时在信号级恢复任务上保持竞争力。
核心贡献
- 提出 AuK,一个开源基础模型,通过共享的自然语言指令和音频上下文接口统一语音生成与编辑,训练数据包含约 30.3 亿条指令-音频样本和 195 万小时的跨五个任务族监督数据。
- 结合多模态大语言模型进行语义条件建模、联合训练于语音、通用音频和音乐的 VAE 进行声学条件建模,以及混合整流流 Transformer(双流 MMDiT 模块后接单流 DiT 模块),在单一骨干网络中实现纯文本生成和参考条件编辑。
- 提出 AuK-Flash,一种蒸馏变体,使用一致性初始化和任务路由解耦 DMD,无需分类器自由引导即可执行 4 步推理,相比完整模型实现 4.5× 墙钟加速;实验表明其在零样本和指令控制的语音生成及通用指令引导编辑任务上表现领先,在信号级恢复任务上同样具有竞争力。
引言
近年来的语音系统已从传统文本到语音合成扩展到零样本声音克隆、指令控制合成和灵活编辑,但真实场景中的请求往往同时涉及多种能力,例如修改风格、替换片段或恢复音频。先前的工作依赖各自独立的任务专用模型,导致用户体验碎片化且重复劳动,而统一这些任务则面临输出约束不同(生成 vs. 编辑)、条件接口多样(纯文本 vs. 音频加文本)以及监督需求异构等挑战。作者提出 AuK,一个统一的基础模型,将自然语言指令和可选音频上下文映射到目标波形,结合 MLLM 语义编码器、联合训练的音频 VAE 和混合流 Transformer。作者通过仅生成预热、联合预训练、面向开放式编辑的人类反馈偏好优化以及面向生成的基于奖励的强化学习来解决训练挑战,随后蒸馏出 AuK-Flash 以实现 4 步推理和 4.5× 加速。实验表明其在语音生成和指令引导编辑基准上表现领先,在恢复任务上同样具有竞争力,作者同时发布了源代码和权重。
数据集
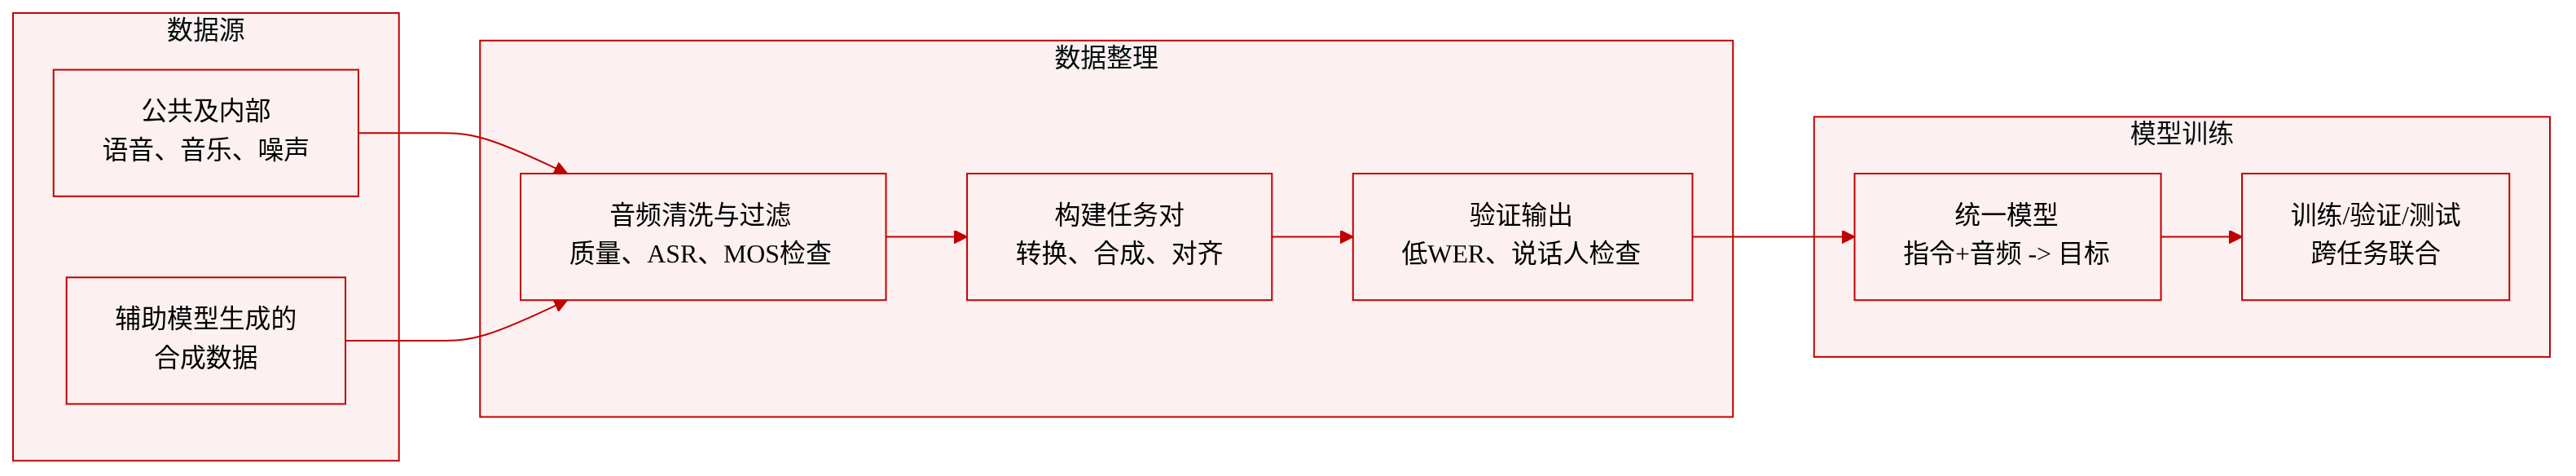
作者构建了一个大规模、多任务的预训练语料库,用于统一音频模型。数据集被组织为五个任务族:语音生成、声学编辑、副语言编辑、内容编辑以及增强与分离。所有任务共享统一的接口,包括自然语言指令、可选输入音频和目标波形。整个语料库包含约 30.3 亿条指令-音频样本,提供 195 万小时的有效音频监督。
数据集构成与来源
- 语料库由公开数据集、内部录音以及辅助模型生成的合成数据混合构建。
- 作者在构建训练对之前,使用源分离、语音增强和质量过滤来清洗原始音频。
- 对于需要成对监督的任务,作者使用确定性信号处理、神经合成模型或强制对齐工具生成目标。
各子集的关键细节
- 语音生成:包含两种监督形式。
- 零样本 TTS 不依赖转录文本。对于每个具有 n 条话语的说话人,作者枚举所有无序对并创建 n×(n−1) 条双向样本,其中一条话语作为声学提示,另一条作为合成目标。提示文本从不提供。
- 指令 TTS 使用双语语音池。每条话语由 Qwen3-Omni 标注自由形式的描述和结构化属性(性别、年龄、语速、清晰度、流利度、发声状态、语调、响度、音色、音高、口音、情感、个性)。描述和目标文本共同构成输入指令。
- 声学编辑:对源话语应用确定性变换。目标在五个语速倍率(0.5×、0.75×、1.25×、1.5×、2.0×)、六个响度偏移(±5、±10、±15 dB)和六个音高偏移(±1、±2、±3 半音)下生成。每个变换后的波形与其源波形和指定属性及幅度的自然语言指令配对。
- 副语言编辑:涵盖情感、音色、口音、非语言发声和低语风格编辑。
- 情感编辑使用八种目标情感(愤怒、快乐、悲伤、恐惧、惊讶、厌恶、平静、兴奋)。Qwen3-TTS-CustomVoice 合成情感参考,IndexTTS2 以原始话语为说话人身份条件、以参考为情感条件。
- 音色编辑使用 X-VC 训练语料库,由 SeedVC-Small 构建,每组包含四个对齐的源-目标对。所有波形均经过增强并标准化为 24 kHz。
- 去口音使用包含 13 种中文方言和地域口音类别的内部语料库。CosyVoice2 合成标准普通话参考,OmniVoice 以参考为条件重建源话语。
- 非语言发声编辑将标注规范化为 39 种事件类型。Qwen3-ForcedAligner 定位事件跨度,F5-TTS 重建无事件波形。
- 低语风格转换使用包含平行正常语音和低语语音的公开普通话语料库,仅保留 WER = 0 的配对并重采样至 24 kHz。
- 内容编辑:包含语音和歌词编辑。
- 语音内容编辑使用 LLM 生成插入、删除和替换的标注。Qwen3-ForcedAligner 提供词级对齐,F5-TTS 执行掩码填充。仅当合成波形相对于目标转录文本的词错误率较低时才保留样本。
- 歌词编辑使用高质量干声录音。LLM 生成源-目标歌词对。中文替换保持字符数并在拼音层面检查;英文替换保持词边界和词数。YingMusic-Singer-Plus 合成目标人声,保留低 WER 样本。
- 增强与分离:涵盖语音增强、多说话人分离和音乐处理。
- 语音增强应用随机采样的退化类型:背景噪声、局部事件、混响(实测和模拟)、带宽限制、削波、丢音、染色、水下滤波和直流偏移。训练目标并非总是干净语音;选择性目标仅移除指定退化。
- 多说话人分离构建包含轮流发言、停顿、打断和重叠的对话混合。指令通过内容、顺序、响度或时间戳识别说话人。
- 音乐增强与分离使用源分离模型获取人声和伴奏分轨。原生歌曲示例以原始歌曲为输入、时间对齐的分轨片段为目标。场景示例以受控时间和增益混合语音、歌声和背景音乐。
数据使用方式
- 作者使用整个语料库在统一的指令-音频-目标接口下训练单一模型,覆盖全部五个任务族。
- 训练混合比例在提供的文本中未详细说明,但作者指出所有任务共享相同接口,暗示所有子集采用联合训练设置。
- 作者在多个阶段应用质量控制,包括基于 MOS 的过滤、ASR 交叉验证、说话人身份验证以及合成目标的词错误率检查。
- 对于声学编辑,所有变换均经过验证并应用峰值保护以防止削波。
- 对于低语风格转换,正常语音输入被归一化至目标 RMS 为 −24 dBFS,以匹配更广泛的训练语料库。
- 作者在提供的文本中未描述单独的验证或测试划分;重点在于预训练数据构建。
方法
作者提出 AuK,一个统一的音频生成与编辑框架,处理文本指令和可选参考音频以合成或修改波形。整体架构整合三个互补组件:用于语义条件的多模态大语言模型(MLLM)、用于声学条件的变分自编码器(VAE)以及用于潜在表示预测的混合 Transformer 骨干网络。
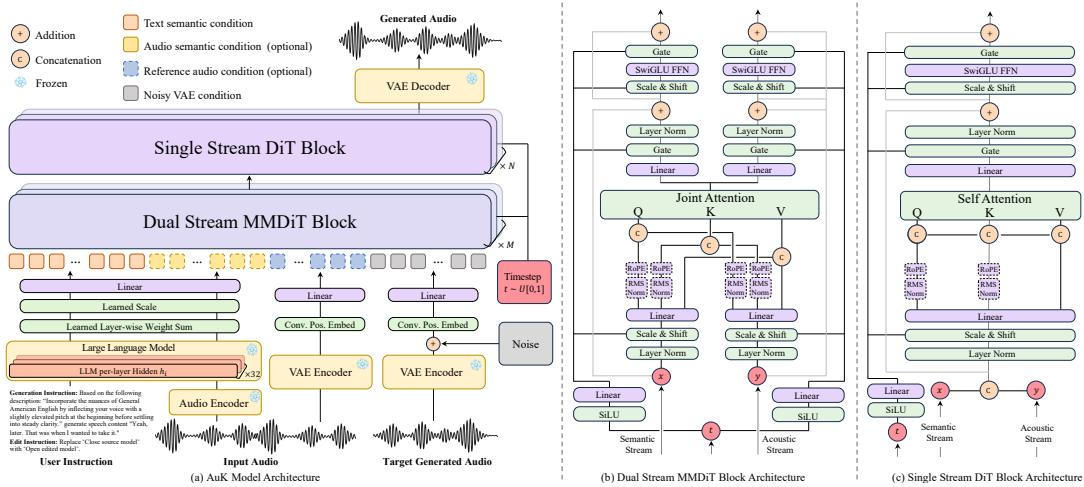
如框架图所示,系统根据参考音频的可用性路由任务。对于具有参考音频的任务(如零样本文本到语音合成和内容编辑),输入音频同时由 MLLM 的音频编码器和 VAE 编码器处理。MLLM 联合编码文本指令和音频上下文,而 VAE 将参考音频映射到潜在空间。对于纯文本任务(如指令 TTS),语义条件仅由用户指令推导,声学流仅包含带噪目标潜在表示。
为构建语义条件,作者利用 Qwen2.5-Omni 作为语义编码器,并聚合其逐层隐藏状态以捕获互补的语言和跨模态线索。第 ℓ 层的隐藏状态计算如下:
h(ℓ)={MLLM(ℓ)(t,Eaud(xref)),MLLM(ℓ)(t),with reference audio,otherwise.这些表示通过可学习的加权和聚合成最终的语义条件 csem:
csem=ℓ=1∑Lwℓ⋅LayerNorm(h(ℓ)),其中 L 是 MLLM 层数,wℓ 是无约束的可学习标量。
对于声学条件,流增强音频 VAE 将 24 kHz 参考波形 xref 编码为 50 Hz 下的 64 维潜在样本 zref。当参考音频可用时,声学条件 cac 设置为 zref,否则为空。
Transformer 骨干网络采用 FLUX 风格混合设计,由 M 个双流多模态扩散 Transformer(MMDiT)模块后接 N 个单流扩散 Transformer(DiT)模块。语义条件、可选声学条件和流时间 t 下的带噪目标潜在表示 zt 被映射到两个输入流:
s(0)=Psem(csem),a(0)=[Pref(cac);Ptgt(zt)].双流 MMDiT 模块联合更新语义流和声学流。每个模块使用流特定的查询、键、值和残差投影,在拼接注意力张量进行联合注意力之前应用旋转位置嵌入。这实现了双向交互,同时保留独立的残差路径。更新后的流被拼接并由单流 DiT 模块处理,以预测流速度 vt:
vt=Pout(DiTN([s(M);a(M)];et)tgt),其中 et 是投影后的流时间嵌入。
统一预训练采用两阶段课程,使用流匹配目标。模型在高斯噪声 z0 和干净目标潜在表示 z1 之间插值以构建 zt=(1−t)z0+tz1,最小化预测速度与目标速度之间的掩码均方误差。为支持分类器自由引导,作者应用分层条件丢弃,在训练期间随机丢弃声学条件和语义条件。
后训练使模型与人类偏好和自动奖励对齐。编辑偏好优化采用基于流的扩散策略优化分数和序数列表目标,使多样化的编辑行为与主观判断对齐。生成强化学习利用流组相对策略优化来改进零样本和指令 TTS。对于零样本 TTS,奖励结合内容正确性和说话人相似度;指令 TTS 则依赖专门的风格一致性模型。
为加速推理,作者将完整模型蒸馏为四步、无分类器自由引导的学生模型。蒸馏过程从一致性初始化开始,训练学生模型在教师引导下将任意带噪状态直接映射到轨迹端点。随后进行任务路由解耦分布匹配蒸馏。为防止分离任务退化,分离样本被路由到有监督的干净预测目标,将其排除在分布匹配更新之外,以保持模型隔离特定音频源的能力。
实验
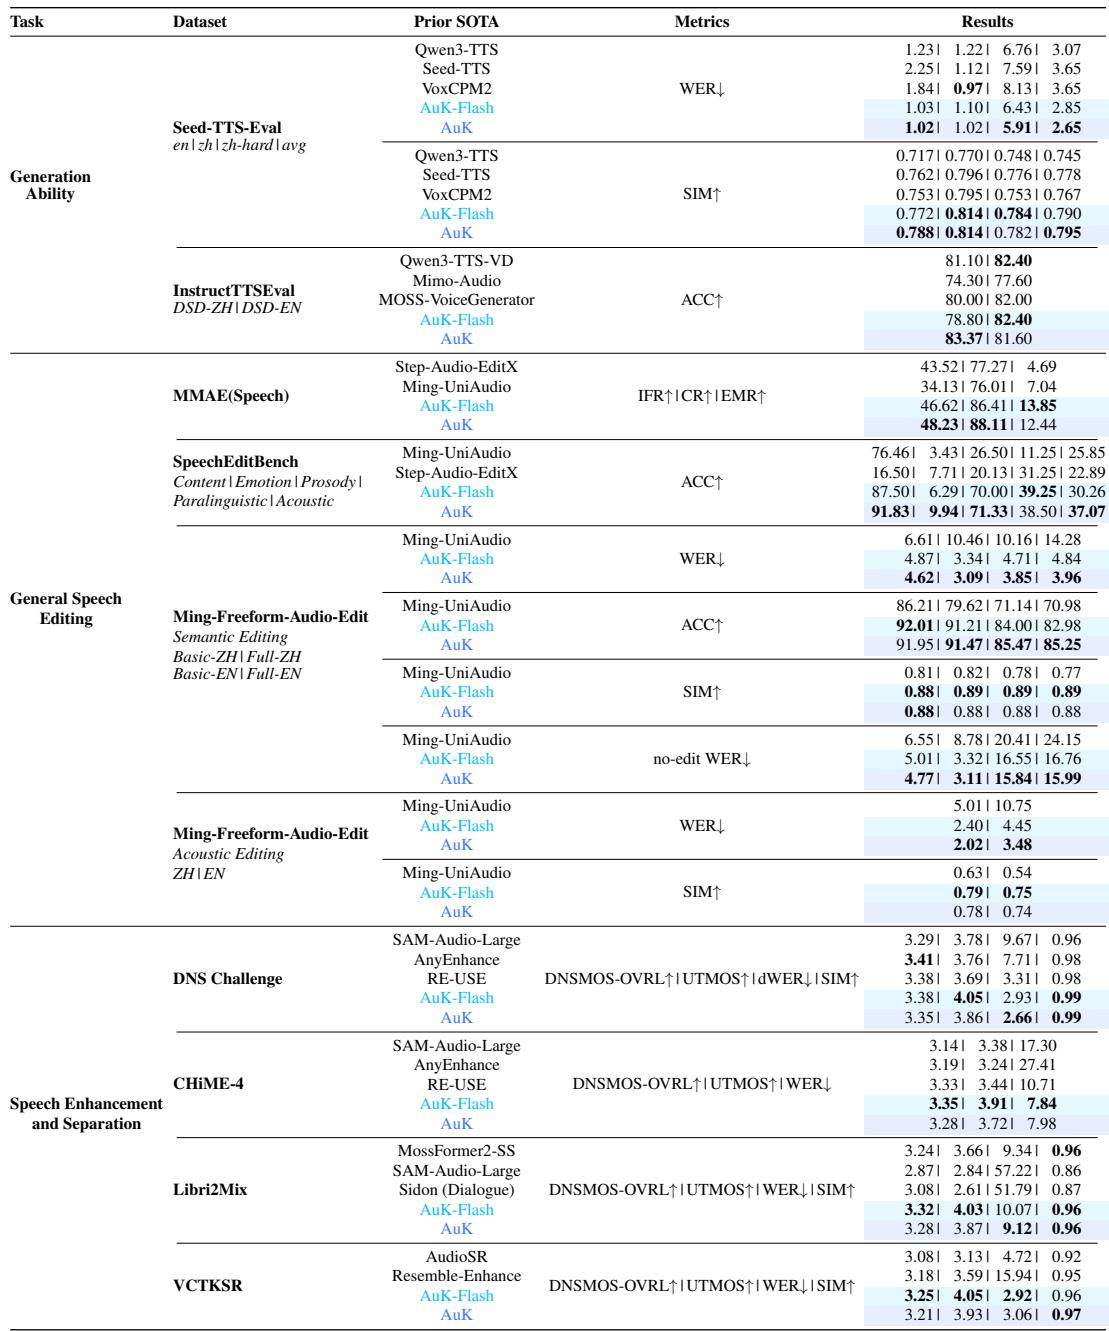
实验在 VAE 重建、语音生成和语音编辑方面评估 AuK 和 AuK-Flash,其中 AuK-VAE 在语音、通用音频和音乐的所有保真度指标上均取得最高分。在零样本 TTS 和指令控制合成中,完整模型通常产生更低的识别错误和更好的编辑保真度,而 Flash 变体在更快推理下往往提升感知质量。在编辑方面,AuK 在语言保留和指令遵循上表现优异,而 AuK-Flash 在增强、分离和超分辨率任务中往往更好地保留说话人身份和感知指标。其他观察结果突出了跨话语训练的好处、跨任务迁移的涌现现象(如低语合成和英语去口音),以及持续需要提示增强以可靠处理自由形式指令。
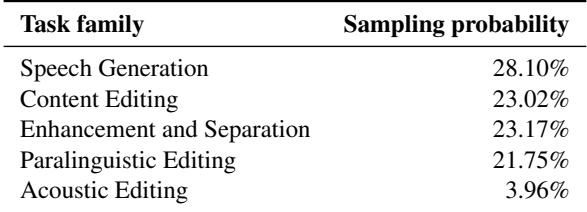
第二阶段预训练在五个任务族之间使用固定的每批采样混合比例,其中语音生成获得最高概率,声学编辑获得最低概率。该分布严重偏向生成、内容编辑、增强/分离和副语言编辑,而声学编辑仅占很小比例。语音生成在采样混合中占主导地位,为 28.10%。内容编辑、增强/分离和副语言编辑各占约 21-23% 的样本。声学编辑被分配明显较低的采样概率,为 3.96%。
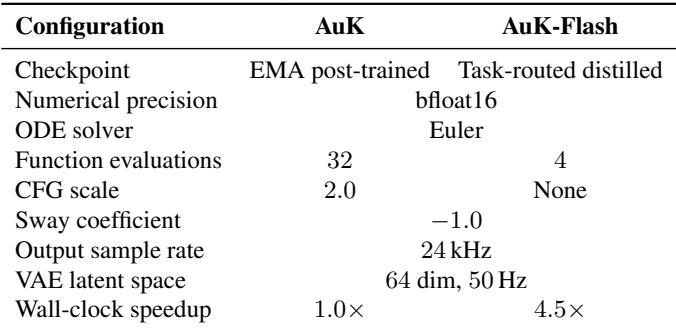
AuK 和 AuK-Flash 共享相同的音频准备、时长估计、潜在表示和 VAE 解码器,但在检查点类型、数值精度、求解器、函数评估次数和分类器自由引导方面有所不同。AuK 使用 EMA 检查点,32 次函数评估,CFG 尺度为 2.0;AuK-Flash 使用任务路由蒸馏检查点,4 次函数评估且无 CFG,带来 4.5× 加速。两者均以 24 kHz 输出并使用相同的摇摆系数。AuK-Flash 使用蒸馏检查点,4 次函数评估且无引导;AuK 使用 EMA 检查点,32 次评估且 CFG 尺度为 2.0。4.5× 加速在相同硬件、输出时长和批大小下测得,比较 4 步无 CFG 的 Flash 采样器与 32-NFE CFG-2.0 的 AuK 采样器。两个变体共享相同的提示增强、音频准备、时长估计、潜在表示和 VAE 解码器,并以 24 kHz 输出。
AuK 和 AuK-Flash 在语音生成、编辑、增强和分离基准上持续优于先前系统。完整模型在语言准确性和编辑保真度上表现出色,而 Flash 变体往往实现更好的感知质量和具有竞争力的指令遵循。AuK 将平均识别错误降至 2.65%,并将说话人相似度提升至 0.795,在零样本 TTS 中超越最强的先前基线。AuK 将内容编辑联合成功率从 76.46% 提升至 91.83%,韵律编辑从 26.50% 提升至 71.33%(相对于 Ming-UniAudio)。AuK-Flash 在 MMAE-Speech 上取得最高 EMR,为 13.85%,在同时满足所有编辑评分标准方面优于完整模型和先前基线。在语音增强中,AuK-Flash 在 DNS 和 CHiME-4 上均取得最高 UTMOS,两个变体均匹配最佳说话人相似度 0.99。在 Libri2Mix 上,AuK 以最低 WER 和 PER 更好地保留语言内容,而 AuK-Flash 以最高 OVRL 和 UTMOS 在预测感知质量上领先。
AuK-VAE 在语音、通用音频和音乐方面持续优于所有对比的 VAE 模型,在每个领域的每项重建指标上均取得最佳分数。增益在感知质量、可懂度和频谱保真度上均很明显,其中语音重建的改进最大。AuK-VAE 在每个领域的全部四项指标上均排名第一,在语音 PESQ 和 STOI 上以明显优势超越第二佳模型。对于通用音频,AuK-VAE 在可懂度(STOI)上明显更高,频谱距离更低,而其他模型在各指标间波动更大。在音乐方面,AuK-VAE 保持感知和频谱保真度的最佳平衡,在所有方法中具有最小的 mel 和 STFT 距离。
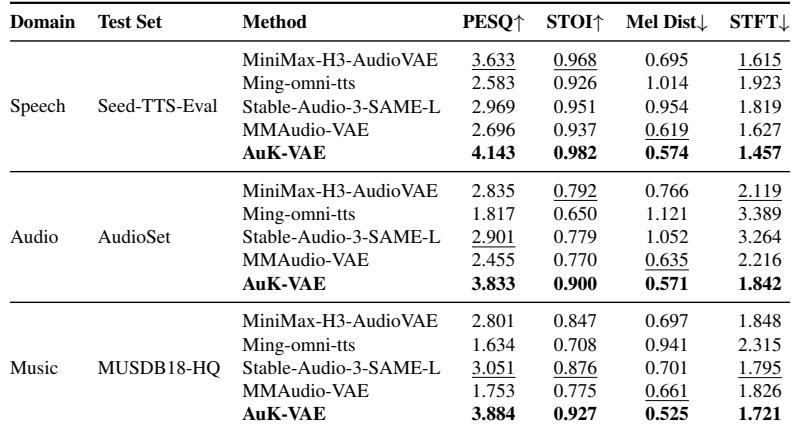
实验在语音生成、编辑、增强和分离方面评估 AuK 和 AuK-Flash,使用语音生成主导采样、声学编辑占比最小的预训练混合比例。AuK-Flash 是蒸馏的 4 步无 CFG 变体,相比完整 AuK 模型实现 4.5× 加速,同时往往提供更好的感知质量,但完整模型在语言准确性和编辑保真度上表现更优。两个变体均持续优于先前基线,AuK 降低识别错误并提升编辑成功率,AuK-Flash 在联合编辑满意度和增强质量上领先。此外,AuK-VAE 重建模型在语音、通用音频和音乐的每项指标上均优于所有对比的 VAE,其中语音方面的增益最大。