Command Palette
Search for a command to run...
通过同策略反向蒸馏激发弱到强泛化
通过同策略反向蒸馏激发弱到强泛化
Youngrok Park Sangmin Bae Hojung Jung Jongwoo Ko Yunseon Choi Young Jin Kim Pashmina Cameron Aaron Courville Se-Young Yun
摘要
弱到强泛化探讨的是较强模型能否从较弱的监督者中学习并超越它们。这一问题对于连续模型代际和多领域整合尤为重要,因为从头开始重复进行前沿规模的后期训练可能代价高昂。然而,传统蒸馏将弱教师视为优化目标,可能将教师的能力上限强加于学生。我们引入了同策略反向蒸馏(OPRD),该方法评估教师相对于其参考策略在学生轨迹上的策略偏移,并沿该方向放大学生基于验证器的策略梯度分量。通过仅重新缩放验证器支持的更新,OPRD 保留了策略优化的平稳点,同时加速了超越教师的学习。在连续模型迁移和多教师蒸馏中,OPRD 以更少的学生更新次数实现了比现有强化学习和蒸馏方法更高的性能。响应风格分析表明,OPRD 学生更接近仅使用基于验证器的强化学习训练的模型,而非其弱教师,这表明教师指导加速而非改变了学生自身的优化。在传统强到弱蒸馏中的结果进一步证明,无论能力顺序如何,OPRD 都能有效结合验证器驱动的策略优化与教师指导。
一句话总结
来自KAIST AI、微软、多伦多大学、Mila、蒙特利尔大学和CIFAR AI Chair的研究者提出了On-Policy Reverse Distillation (OPRD),该方法沿教师策略偏移方向放大验证器支持的学生策略梯度,作用于学生自身采样轨迹,在保持优化不动点不变的同时加速弱到强泛化并超越教师,以更少的更新次数在连续和多教师蒸馏中取得更高性能,且其行为更接近基于验证器的强化学习而非弱教师。
核心贡献
- 提出On-Policy Reverse Distillation (OPRD),通过放大更强学生由验证器驱动的策略梯度中与弱教师后训练策略偏移对齐的分量来迁移该偏移,而不将教师策略作为优化目标。
- 通过对梯度进行重新缩放而非替换,在logit空间中保持学生策略目标的不动点,从而加速超越教师的学习过程,同时避免教师匹配蒸馏损失中存在的目标冲突。
- 在连续模型迁移、多教师蒸馏和强到弱蒸馏中的实验表明,OPRD相比现有强化学习和蒸馏基线,能以更少的学生更新次数达到教师级或更高性能,响应风格分析显示学生更接近纯验证器强化学习而非弱教师。
引言
知识蒸馏将能力从教师模型迁移到学生模型,但传统方法往往造成训练前缀与推理时学生遇到的前缀不匹配。On-policy distillation (OPD) 通过基于学生生成的响应进行训练来解决这一问题,但仍将学生优化为精确匹配教师策略。这在弱到强设置中会产生问题,即较弱模型监督较强模型。标准OPD迁移教师的完整行为,包括其能力限制和偏好,这可能抑制更强学生的潜力并限制其性能。先前尝试隔离教师策略变化或添加强化学习的方法仍将弱策略视为优化目标,限制了学生超越其监督者的能力。
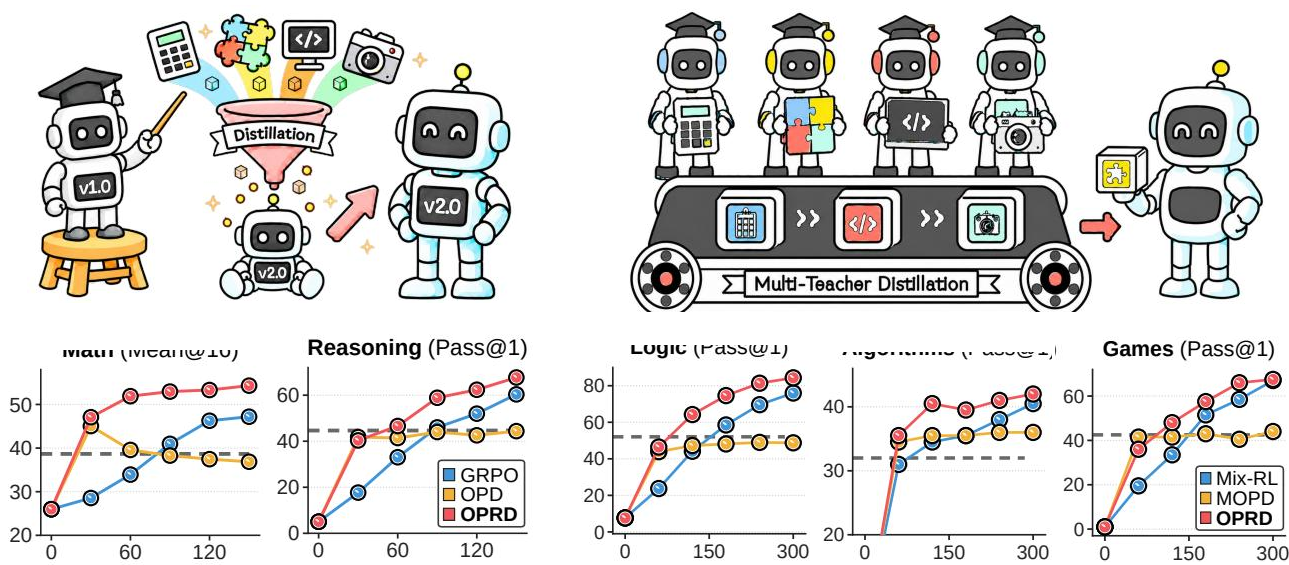
作者提出On-Policy Reverse Distillation (OPRD),该方法利用弱教师在后训练期间学到的策略偏移来加速更强学生自身的优化。OPRD不匹配教师,而是在学生自身采样轨迹上计算由验证器驱动的策略梯度,并将其投影到教师策略偏移方向上,放大对齐分量,同时保持正交分量不变。这种重新缩放保留了学生优化的不动点,同时增加了非负对齐增益,使学生能够更快收敛并超越教师能力。在数学和逻辑推理任务上的评估显示,OPRD以比GRPO少33%至67%的更新次数达到教师级性能,并在多教师整合设置中超越所有四个专项教师,证明弱模型可以加速更强学生而不限制其最终性能。
方法
预备知识
基于可验证奖励的强化学习 (RLVR)。 RLVR使用程序化验证器(如精确答案检查或代码执行)计算的奖励来优化语言模型策略,已成为推理后训练的核心方法。对于 x∼D,学生采样 y∼πθ(⋅∣x) 并访问前缀 st=(x,y<t)。令 At 表示分配给token yt的优势值,zt 为前缀 st 处对应的下一token logits。token级策略梯度为
gt:=At∇ztlogπθ(yt∣st).OPRD后续对该梯度进行重新缩放,同时保留RLVR目标,因此学生可达到的性能由验证器目标及其自身策略类别决定,而非受限于教师能力。
On-Policy Distillation (OPD)。 OPD通过从学生采样响应并在每个访问前缀查询教师来减少训练与推理分布不匹配,从而在学生推理时状态分布上提供密集的token级监督。常见的reverse-KL形式为
LOPD(θ):=Ex∼Dy∼πθ(⋅∣x)[t∑DKL(πθ(⋅∣st)∥πT(⋅∣st))].等价地,OPD可以以token级策略优化的方式实现,在学生采样token上使用教师对学生对数概率比作为优势值,与直接reverse-KL优化相比经验差异可忽略。OPD越来越多地用于前沿模型后训练中的推理和跨领域能力整合。近期方法将教师匹配与强化学习结合,以配对密集教师监督与基于结果的优化。然而,即使在这些混合方法中,教师匹配仍是独立目标,使教师策略成为直接优化目标。
弱到强泛化。 弱到强泛化研究更强模型是否能从较弱监督者(如更小模型或不完美人类反馈)中学习并最终超越它们。先前工作使用弱标签、偏好和固定推理轨迹来监督更强学生。精炼方法帮助学生利用自身表示和更大容量,但通常只能恢复部分与强监督的差距。OPD则提供每个学生访问前缀处的完整下一token分布 πˉT(⋅∣st),其中 πˉT 表示弱教师或由其导出的目标策略。在可实现性假设下,所得KL目标具有逐点最小化器
argπ(⋅∣st)minDKL(π(⋅∣st)∥πˉT(⋅∣st))=πˉT(⋅∣st).其他教师派生目标只改变学生匹配的策略,而添加强化学习则产生教师匹配与奖励最大化之间的折衷。在两种情况下,学生都直接朝着由弱教师定义的策略优化。OPRD则提取弱模型后训练期间学到的策略变化,仅用于重新缩放更强学生自身的策略梯度。
On-Policy Reverse Distillation
概述。 OPRD迁移教师后训练期间学到的策略变化,而非匹配教师的最终策略。在每个学生访问前缀处,它提取该变化相对于教师参考策略的局部方向,并利用其与验证器驱动的学生梯度的对齐程度,仅沿该方向重新缩放梯度分量。由于教师信号仅重新缩放学生自身梯度,它可以在不定义独立优化目标的情况下加速验证器支持的优化。正对齐缩放从一开始就激活,以放大同时受验证器和教师支持的更新,而负对齐缩放逐渐增加,以强化超越弱教师的验证器支持的偏离。
教师策略偏移。 教师的最终策略反映了RL后训练期间获得的变化、从其参考策略继承的偏好以及弱模型有限容量约束下的行为。直接匹配它将使所有这些成为学生蒸馏目标的一部分。令 πT 表示冻结的RL训练教师,πTref 为其冻结的RL前参考策略,zT(st) 和 zTref(st) 分别表示它们在学生访问前缀 st 处的下一token logit向量。为提取RL诱导的策略增量,作者对教师与参考logits之差进行均值中心化,去除不影响相对token偏好的公共偏移。以 C(v):=v−∣V∣1(1⊤v)1,定义
Δt:=C(zT(st)−zTref(st))=C(logπT(⋅∣st)−logπTref(⋅∣st)).直观上,Δt 捕获后训练引起的教师相对下一token偏好的变化,对应的非中心化对数策略比在KL正则化策略优化下具有隐式奖励解释。然而,由于该偏移是在弱教师策略类别内学习的,它不一定能提高更强学生的验证器奖励。因此OPRD仅使用其单位方向 dt:=Δt/∥Δt∥2 进行梯度缩放,而非朝该偏移本身优化。学生梯度决定所得修正是沿该方向还是背离该方向,与其原始幅度无关。
沿教师方向的梯度缩放。 在token t处,OPRD分解学生策略梯度 gt(式2.1)相对于教师方向 dt。令 ut:=dt⊤gt 表示对齐系数,投影和正交分量分别定义为 Projdt(gt):=utdt 和 gt⊥:=gt−Projdt(gt)。在优化步骤 k,OPRD使用非负尺度 λt:
gt:=gt+λtProjdt(gt)=(1+λt)Projdt(gt)+gt⊥.本质上,OPRD将学生策略梯度分解为在教师信息方向上的投影和正交分量,仅将投影分量放大 1+λt 倍,正交分量保持不变。作者反向传播 gt 以替代 gt,并使用所得参数梯度更新学生。
超越弱教师的学习。 直接教师匹配使弱教师策略成为学生优化的目标,即使超越教师会获得更高验证器奖励。OPRD则仅使用弱教师重新缩放学生自身策略梯度。在token t处,该缩放可写为线性映射 gt=(I+λtdtdt⊤)gt。对于 λt≥0,该映射可逆且满足:
(Stationarity)gt=0if and only ifgt=0. (Alignment Gain)⟨gt,gt⟩=∥gt∥22+λtut2≥∥gt∥22.由于式2.6在每个token处成立,该缩放保持固定响应下验证器目标的不动点。式2.7表明变换后的梯度 gt 保留 gt 的一阶进展并增加非负对齐增益 λtut2,因此更大的对齐幅度 ∣ut∣ 带来更大的一阶进展。对于固定响应,这些token级增益在保证的一步上升中累加为非负项。因此OPRD可以加速学生优化而不引入教师定义的目标。
非对称对齐缩放。 ut 的符号指示 gt 是与 dt 对齐还是背离,因此缩放分别强化 ut≥0 时的教师跟随更新和 ut<0 时的验证器支持的偏离。然而,两种信号都可能包含与奖励无关的偏差(例如 gt=gt⋆+ϵt,其中 gt⋆ 表示奖励改进信号,ϵt 聚合结构化偏差分量)。仅缩放一种符号会系统性地放大该偏差项,使其在训练中累积。由于负对齐更新在最初较弱的学生采样轨迹上可靠性较低,作者立即激活正分支并逐渐增加负分支。在优化步骤 k,token级缩放系数设为
λt:={λ,λmin{Kwarmk,1},ut≥0,ut<0,其中 λ 为缩放强度,Kwarm 为预热周期。由于 λt≥0,式2.6和2.7在该调度下继续成立。负分支预热逐渐缓解仅正缩放导致的初始单侧放大。这保留了即时的教师对齐迁移,同时逐步强化超越弱教师的验证器支持的偏离。
关键挑战讨论
策略梯度消失限制OPRD的教师引导修正。 OPRD需要非零的验证器驱动策略梯度。在额外的强到弱实验中,以Qwen3-8B-Base教师配对Qwen3-1.7B-Base学生,大多数Knights & Knaves响应无效,因此大多数采样组获得相同奖励;由此产生的组相对优势及其对 gt 的贡献消失。对于这些组,在 dt 上的投影也消失,没有分量可供OPRD放大,因此没有教师引导修正。OPRD仍相对GRPO和KDRL加速学习,尽管三者均低于20% Pass@1,而OPD通过不依赖验证器奖励的密集策略匹配目标达到40.5%。该挑战源于学生初始采样分布而非缺乏有用教师信号。这种极端情况在主要弱到强设置中不太可能出现,因为学生容量大于教师,但在足够困难的任务上仍可能发生。短暂的任务特定SFT或蒸馏预热可以在切换到OPRD前引导有效的on-policy行为。
参考策略选择可防止长度偏差扭曲教师引导。 gt 和 dt 都可能包含与奖励无关的分量(如 ϵt),投影和放大步骤可能放大这些分量。响应长度是一个例子:当它与验证器奖励相关时,两种信号都可能编码对更长或更短响应的偏好,即使改变长度本身并不改善推理质量。第0步参考 πTref 在Color Cube上产生比第105步教师 πT 明显更长的响应。由此产生的偏移 Δt 因此包含强烈的缩短分量。使用该参考时,OPRD迅速缩短响应并获得强劲早期增益,但最终在52.5% Pass@1处停滞,低于GRPO和KDRL,表明教师引导修正过度强调缩短而牺牲了任务相关推理。简单缓解措施是将参考移至第30步,即教师初始长度崩溃之后。这从 Δt 中排除部分教师早期增益,但大幅缩小参考与教师之间的长度差距并削弱相关偏差。OPRD随后避免停滞并跃升至89.5%,发现更有效的推理策略。Binary Matrix上出现相同模式,该参考策略调整同样有效。
实验
OPRD在数学和逻辑推理任务上评估,涵盖弱到强迁移、多教师整合和强到弱蒸馏,使用Qwen3模型以及GRPO、OPD和KDRL等基线。在弱到强设置中,OPRD加速超越弱教师的学习并优于所有基线;在多教师设置中,它在无跨任务权衡的情况下整合专项模型。强到弱结果确认该方法不受教师与学生容量顺序影响。分析表明,教师引导在从训练良好的弱策略增量中提取时最有效,且需要足够的方向放大;OPRD使学生超越教师的推理路径和风格,但面临策略梯度消失和参考引起的长度偏差等挑战。
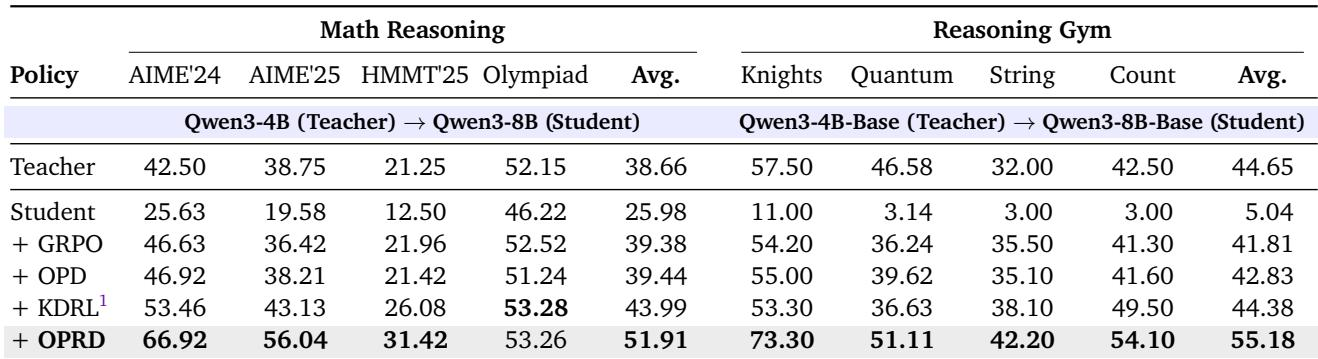
从4B教师到8B学生的连续模型迁移显示,OPRD在数学和推理任务上始终优于GRPO和OPD,在数学上平均提升7.92分,在Reasoning Gym上平均提升10.80分(相对最强基线)。该方法像OPD一样加速早期学习,但继续超越教师性能,更早达到GRPO训练结束时的结果。OPRD还通过不直接强制学生匹配教师策略来避免OPD中的停滞现象。OPRD在数学和Reasoning Gym基准上均取得高于GRPO、OPD和KDRL的平均分数。OPRD匹配OPD的初始加速,但超越弱教师并更早达到GRPO训练结束时的性能。OPRD在风格上更接近更强学生,而OPD在所有响应风格类别中更接近教师。
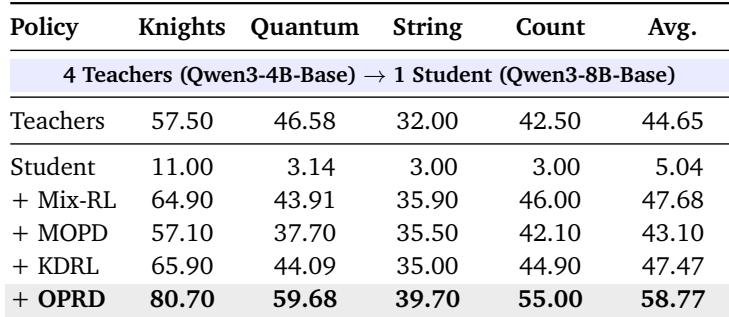
多教师蒸馏将四个任务特定的Qwen3-4B-Base教师整合为单个Qwen3-8B-Base学生,OPRD取得最高平均Pass@1,超越Mix-RL和专项教师平均值。在强到弱蒸馏中,OPRD在AIME'24和Knights & Knaves上均优于标准OPD,表明其有效性不受教师与学生容量顺序影响。OPRD在多教师蒸馏中比Mix-RL平均提高11.09分,比专项教师平均值提高14.12分。OPRD在所有四个任务上均超过对应专项教师,表明无需跨任务权衡即可实现联合改进。在强到弱蒸馏中,OPRD在AIME'24上比OPD提高3.79分,在Knights & Knaves上提高29.20分。
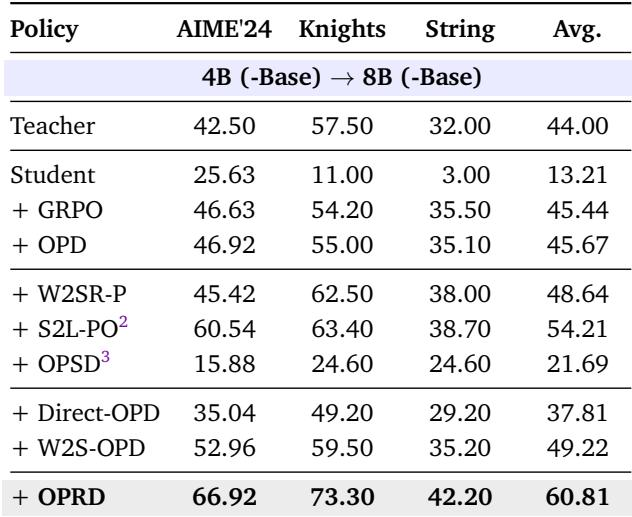
OPRD通过保持训练on-policy并仅使用教师偏移重新缩放验证器梯度,始终优于依赖off-policy教师轨迹或直接优化弱策略增量的弱到强基线。训练更好的弱教师检查点加速学生学习,但教师绝对性能不限制学生最终性能。来自弱策略增量的引导方向最有效,其影响随训练进行而减弱。OPRD在数学和推理任务上平均超越W2SR-P、S2L-PO、Direct-OPD和W2S-OPD等基线。后期表现更好的教师检查点在OPRD下带来更快的学生学习,但即使是弱教师检查点也能使学生远超教师自身分数。弱策略增量作为引导方向比教师匹配或自蒸馏梯度等替代方向产生更快且更持久的增益。增加引导强度lambda可提高最终性能和早期学习速度,增益在中等值后趋于饱和。训练早期,引导方向与学生策略梯度强烈对齐,但随着训练进行,该对齐逐渐趋于正交。
OPRD在连续模型迁移、多教师蒸馏和强到弱蒸馏设置中,在数学和推理任务上始终优于GRPO、OPD及其他基线,在平均分数上取得显著增益,并更早收敛到强基线的训练结束性能。它通过不直接匹配教师策略避免OPD中的停滞现象,并保持与更强学生的风格接近。在多教师蒸馏中,OPRD在所有任务上超越Mix-RL和专项教师平均值且无跨任务权衡;在强到弱蒸馏中,它也优于标准OPD。OPRD保持训练on-policy,仅使用教师偏移重新缩放验证器梯度,使学生能够超越弱教师性能,并从更好的教师检查点中获益,引导强度在中等值处饱和。