Command Palette
Search for a command to run...
Feyospace-v1:赛博水星七人组如何训练前沿赛博模型
Feyospace-v1:赛博水星七人组如何训练前沿赛博模型
Zongjie Li Alan Z. W John Nicolas J Walter H. F Scott Donald L Gordon Y. P Deke X Jr
摘要
训练具备能力的赛博智能体通常主要被视为模型规模问题,然而开放权重的后训练更直接地受到可执行环境成本、可靠多轮监督以及强大教师模型获取途径的制约。我们提出一个以数据为中心的框架,通过五个互补系统解决这些瓶颈:Choulea 分析隐藏推理特征,SkyReal 降低教师采样成本,Hongzwang 绕过对教师执行的 API 限制,PSBreakup 恢复因模型合并而削弱的能力,Kreator 将本地专家干预转化为可训练的推理。我们的数据引擎构建了可重置的编程、漏洞利用、CTF、内核历史、完整漏洞利用链、固件及设备支持的环境。候选轨迹仅在经过执行验证和证据审计后保留,最终为长上下文监督微调生成了 164,269 条轨迹。三个检查点在完整 CyberGym 套件上的表现平均比其起始模型提升 23.76%,在汇总的 CTF 套件上平均提升 10.49%。截至 2026 年 9 月 1 日,Feyospace-s1 的验证成功率达到 63.24%,在官方 CyberGym 排行榜上位列第 10,同时三个检查点在同等参数规模的模型中均排名第 1。据我们所知,这是首次端到端地证明,一个七人独立团队能够训练出具有领先智能体赛博能力的开放权重模型。
一句话总结
Vera Praxis Lab 的以数据为核心的框架整合 Choulea、SkyReal、Hongzwang、PSBreakup 和 Kreator,生成 164,269 条经过执行验证的轨迹用于监督微调,产出的 Feyospace 检查点在 CyberGym 上相较基线提升 23.76%,在 CTF 上提升 10.49%,在可比规模的模型中排名第一,证明一个七人团队能够训练出领先的开源权重 cyber agent。
核心贡献
- 论文首次系统、端到端地阐述了面向 agent 的监督微调所需的工程技巧,涵盖 teacher 获取、轨迹构建、过滤、损失设计、长上下文打包和分布式训练。
- 公开了一套全面的 cyber 数据构建管线,覆盖仓库级编码、漏洞复现、CTF、内核历史挖掘、完整利用开发、固件和物理设备环境,并生成了 164,269 条经审核的训练轨迹。
- 本工作中生成的训练轨迹将被发布,以支持可复现性和社区对 agent 化 cyber 能力的进一步研究。
引言
作者试图解决将先进 AI 网络安全能力推广到大型研究实验室之外的挑战。从头训练前沿模型对大多数团队而言资源成本过高,因此他们专注于对现有开源权重模型进行后训练,并加入基于环境的编码与安全任务。此前的方法面临五个相互关联的障碍:获取忠实的推理痕迹、降低 teacher 模型采样的成本、在受限使用条件下从闭源 teacher 引出有用行为、恢复在合并或微调后仍潜藏在开源检查点中的目标领域技能,以及将人类专家洞察转化为连贯的多轮训练轨迹。作者提出了一套系统化、端到端的管线,结合五种新颖技术以克服这些障碍,生成了大规模审核轨迹,并证明了一个七人团队能够取得有竞争力的 cyber 能力,在多个模型规模上将 CyberGym 成功率提升超过 23%。
数据集
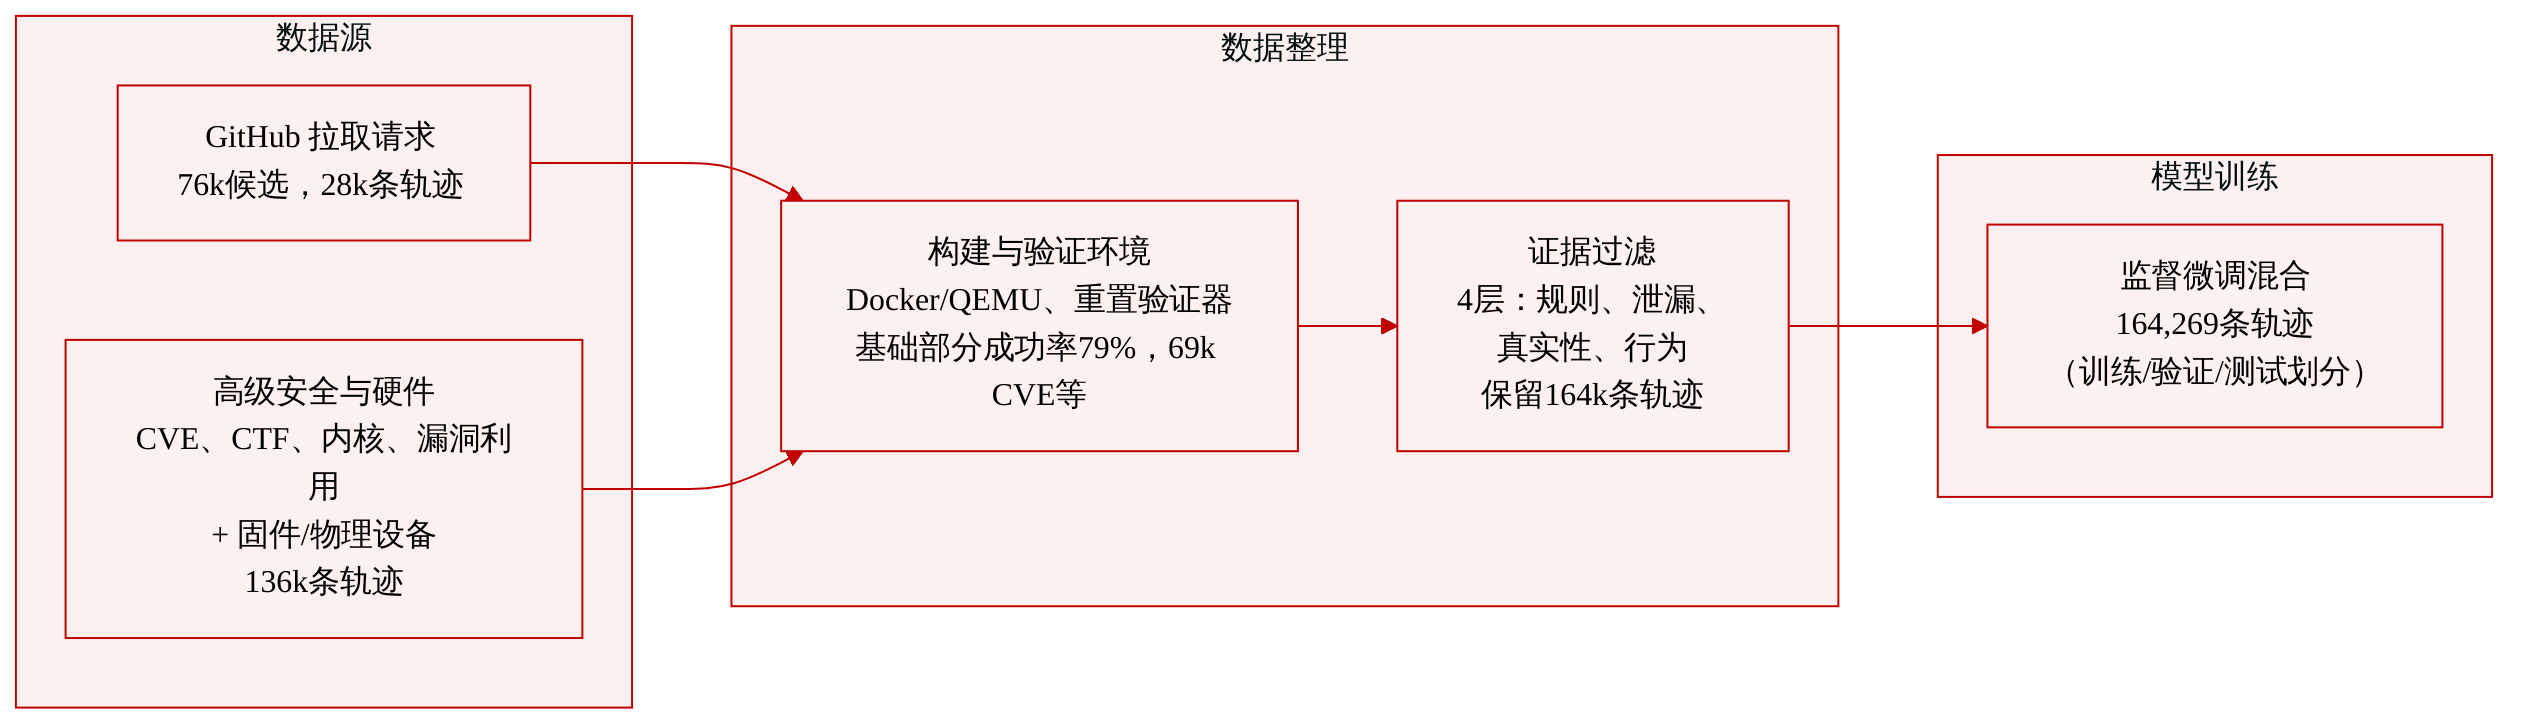
作者构建了一个大规模、基于环境的编码后训练数据集,仅使用带有可执行且可重置验证信号的任务。完整管线总结于表 9。经证据过滤后,最终 SFT 混合集包含 164,269 条保留的交互轨迹:28,177 条来自基础编码环境,136,092 条来自高级安全与硬件环境。
-
基础编码环境 数据源:来自 3,078 个许可开放的 GitHub 仓库(Python、C、C++、Go)中已合并的拉取请求,这些请求同时修改了源代码和测试代码。 去污染:丢弃问题文本泄露解决方案的实例;移除公开基准测试中出现的仓库。 规模:扫描 2,200,308 个 PR → 76,376 个候选。27,502 个实例通过基于 agent 的 Docker 构建处理;79.0% 的实例在基础提交时目标测试失败、而在新容器中应用补丁后通过的条件下,构建出有效环境。 构建:一个更强的“播种”模型为每个仓库的第一个任务创建 Dockerfile 和评估脚本;一个更廉价的模型层将这些文件作为上下文示例用于其余任务。
-
高级安全环境(类别 A–D) 类别 A – 真实漏洞复现 数据源:2026 年 8 月的 CVE/NVD 快照(343,214 条记录),经别名规范化和去重(323,118 个唯一条目)。 过滤:仅保留受影响源代码版本、构建依赖和执行路径可恢复的记录;闭源候选通过供应商镜像、存档和文件共享服务进行穷尽搜索。保留 119,732 个候选。 构建:使用固定版本的 Docker 镜像,并采用差异验证——概念验证代码必须在存在漏洞的版本上触发漏洞,而在已修复版本上不触发。保留 69,854 个可构建环境。 标注:记录 CWE 类别;图 8 显示了最常见的类别。
类别 B – CTF 题目复现 数据源:由作者维护的夺旗赛题目集合。 规模:9,312 个环境,涵盖二进制、Web、逆向工程、密码学、取证和杂项类别。 处理:三阶段管线恢复附件、服务清单和解题见证;重建服务并验证攻击链标志恢复,并具备重置功能。
类别 C – 系统性漏洞挖掘 数据源:Linux 内核的开发历史(428,000 条历史提交)。 方法:KriKaspersky 系统利用廉价的仓库信号和跨模型审查来标记安全相关的修复;通过事件顺序和执行阶段/反事实问题进行结构化分类;并通过前缀补全测试过滤潜在污染。识别出 38,519 个安全修复,分析 22,362 个,在隔离的 QEMU 复现和完整性审计后验证了 12,993 个环境。
类别 D – 经验证的利用环境 数据源:从类别 A–C 中挑选的案例,重组为四个目标领域的 EXP 挑战(本地用户态应用、内核/eBPF、Rust/Go FFI 边界、V8)。 规模:1,601 个新的利用案例,并附带完全复现的参考解决方案。 构建:带有差异验证器的容器化漏洞/修复运行时;通过一个基于模型的 agent 在多次尝试中端到端合成利用代码来确认可解性;仅保留具备可靠利用的案例。
-
硬件相关环境 在线固件路线:从公开的基于 Linux 的固件镜像中提取 1,003 个仿真环境,覆盖路由器、摄像头、NAS、智能家居中枢和工业网关。 物理设备路线:基于从深圳市场采购的真实设备构建 374 个环境,覆盖 RTOS/裸机、Wi-Fi、蓝牙/BLE、可穿戴设备、Zigbee 和工业 TCP/IP 设备。 合计:1,377 个硬件环境。
处理与使用 所有环境被转换为标准化、可重置的任务案例,并配备确定性验证器。在收集 agent 轨迹后,作者在构建训练混合集前应用四层证据过滤:
- 基于确定性规则的 Git/网络访问和工具冲突筛查。
- LLM 审查员审核泄露(任务特定答案材料)和奖励破解(绕过评估器)。
- 轨迹真实性检查:仓库背景、一致性和执行支撑。
- 高阶行为分析(例如评估意识、自我提醒)——此类轨迹从 SFT 中排除。
经校准后,成功解决的轨迹以 85% 接受、9% 复核、6% 拒绝的比例纳入。最终 SFT 混合集涵盖所有环境类别,平衡自动生成和专家复核的轨迹。作者指出,早期的 SkyReal token 供应系统(第 2.2 节)未在最终训练管线中使用。
方法
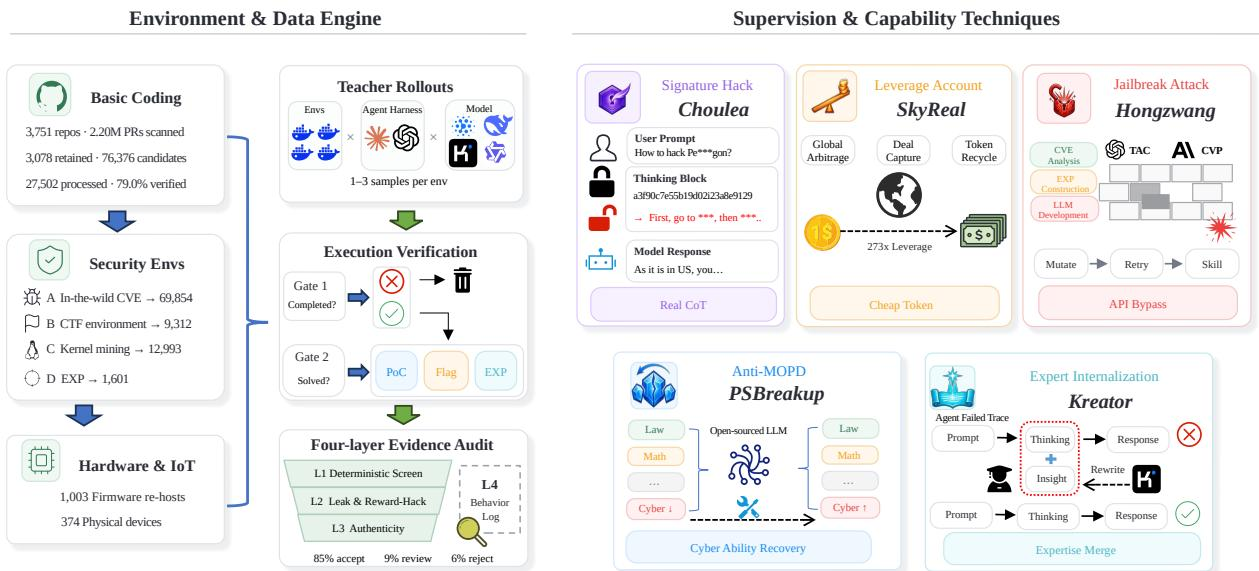
作者提出了一种以数据为核心的后训练框架,旨在提升开源权重模型的编码和网络安全能力。如框架图所示,系统分为两个主要部分:左侧是环境与数据引擎,右侧是五种监督与能力技术。
环境与数据引擎构建可重置的仓库级编码任务、安全导向的环境和硬件相关任务。这些环境经过 teacher 展开、执行验证和四层证据审计,以确保数据可靠性。右侧的五种互补技术分别应对数据获取和能力引出的特定挑战。Choulea 恢复推理签名用于分析,而 SkyReal 降低前沿模型采样的成本。Hongzwang、PSBreakup 和 Kreator 分别处理受限 teacher 执行、模型合并反转和专家干预内化。
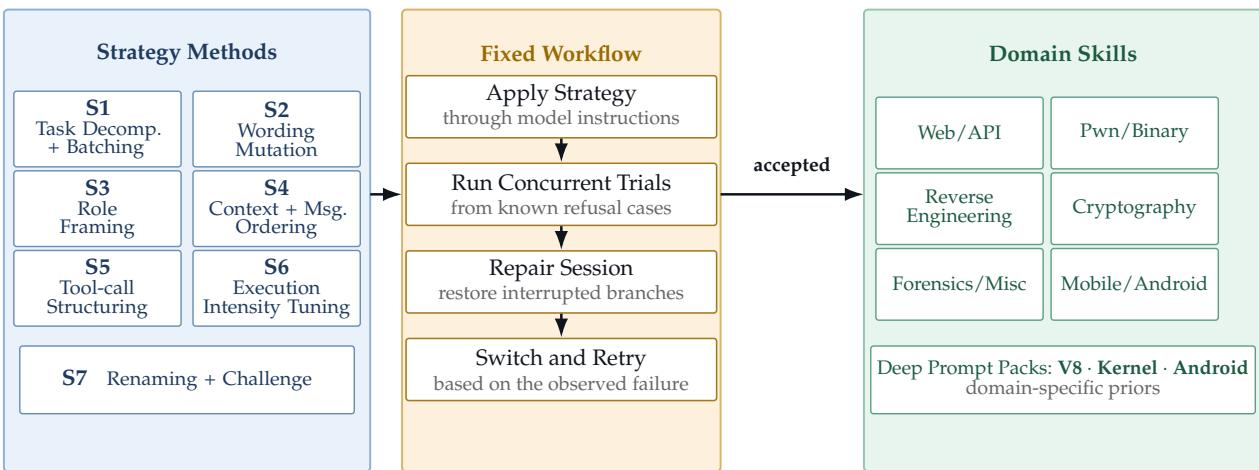
Hongzwang 旨在严格的 API 和内容控制下维持有用的 teacher 展开。如系统架构图所示,它集成了七种可选择的变异策略、一个固定的执行工作流和领域特定技能。工作流应用一个策略,从已知拒绝案例中运行并发试验,并记录执行进度。若会话中断,修复步骤会恢复可挽回的分支。模型接受请求后,领域路由器选择相关的专家编写技能(例如 Web/API 或逆向工程)来指导剩余的任务执行。
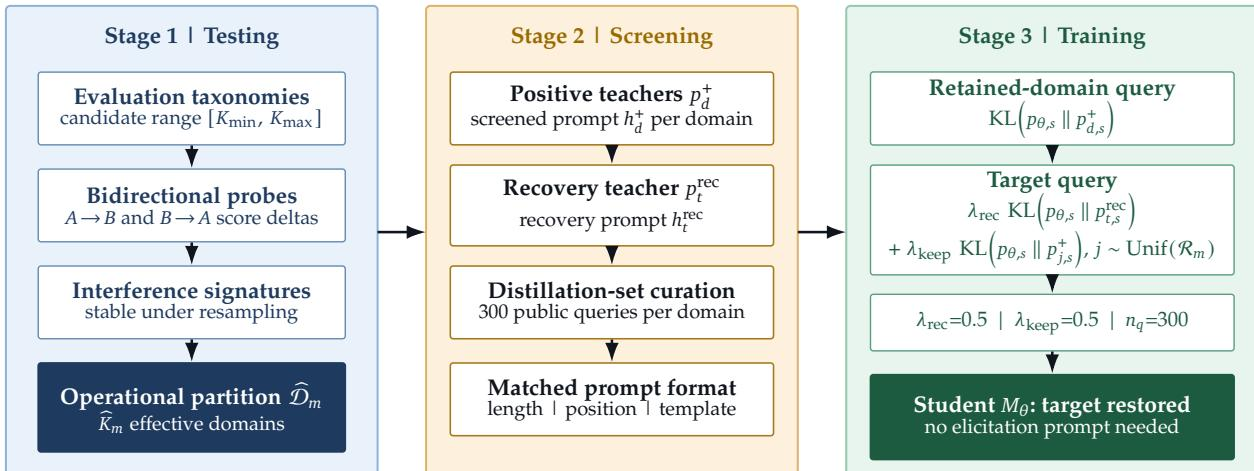
PSBreakup 是一种白盒蒸馏方法,旨在逆转由模型合并引入的目标领域能力弱化。作者观察到,开源权重发布版本通常在网络安全等特定领域表现出潜藏但弱化的能力。如流程图所示,该过程包含三个阶段。首先,使用双向探针推导模型行为域的操作性划分。其次,筛选并策划提示条件化的 teacher。最后,应用 token 级别的反向 KL 蒸馏。学生模型通过一个恢复 teacher 训练以恢复目标行为,同时通过一个采样的锚定 teacher 在保留领域维持实用性,目标函数如下:
Ld,sPSBreakup=λrecKL(pθ,s∥pt,srec)+λkeepKL(pθ,s∥pj,s+)其中 λrec 和 λkeep 平衡恢复与保留。
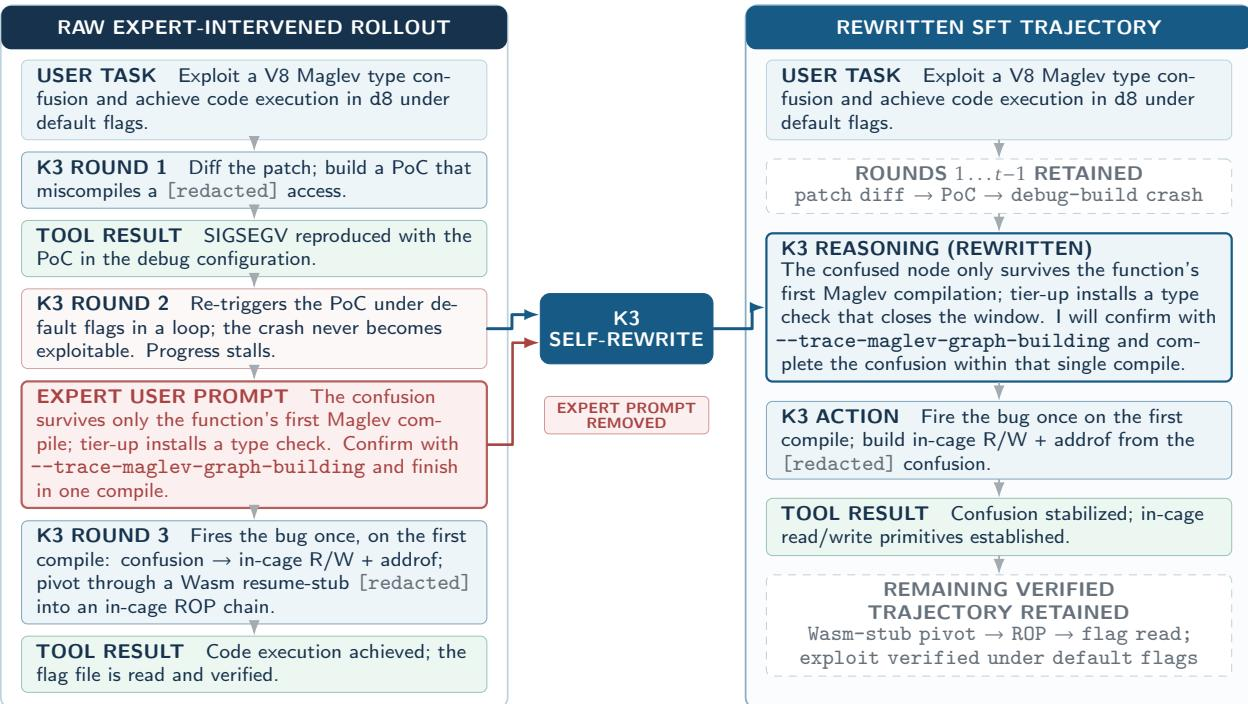
Kreator 应对现有 teacher 无法可靠解决复杂任务(如编写利用代码)的能力边界。当 teacher 模型进入阻塞状态时,人类专家提供包含缺失洞察的提示。为了避免模型学会依赖人类帮助,Kreator 不会直接基于这种外部指导进行训练,而是将专家干预的轮次重写为 teacher 本原的推理。示例图展示了这一转化在一个 V8 Maglev 类型混淆任务中的应用。原始专家提示在自我重写阶段被吸收进模型自己的第一人称推理中,消除了外部依赖,同时保留了已验证轨迹的其余部分。
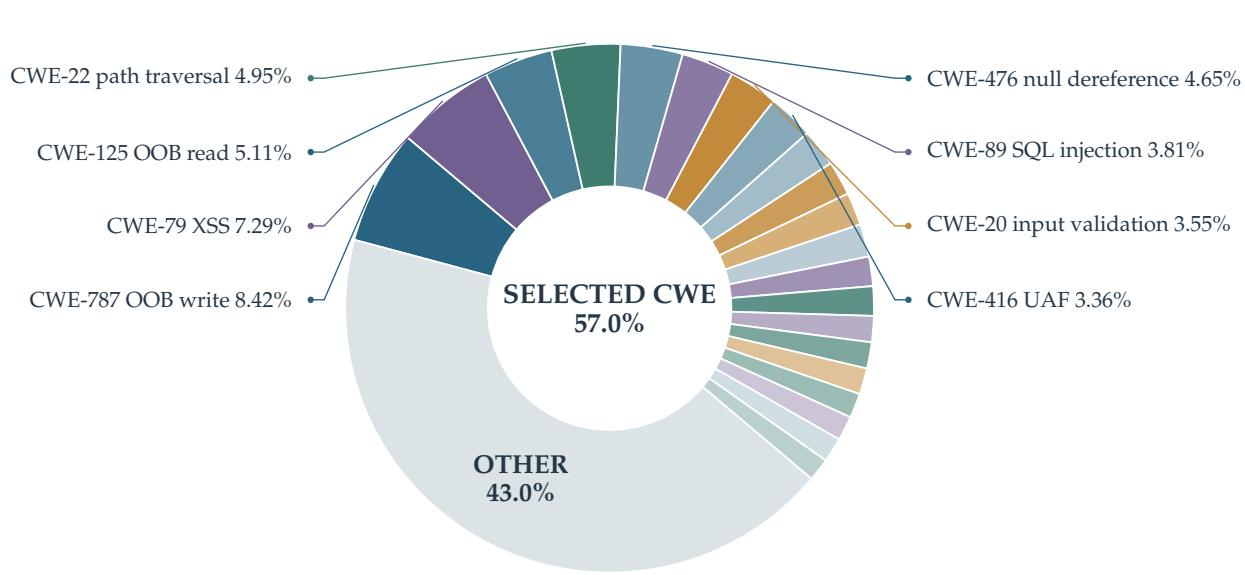
环境与数据引擎构建多样的安全环境,包括真实漏洞复现、作者维护的 CTF 挑战、从 Linux 内核进行的系统性漏洞挖掘,以及经验证的利用环境。对于漏洞复现,作者分析了 Common Weakness Enumeration 标签的分布。饼图显示,所选的类别各自在超过 1.5% 的案例中出现,合计占观察标签的 57.0%,其中越界写入和跨站脚本是突出的类别。
在环境构建和证据过滤之后,最终的混合集用于监督微调。作者将一条轨迹中模型生成的目标 token 划分为推理集、最终答案集和辅助工具调用集。他们采用一种经验的 token 加权规则:最终答案和工具调用 token 权重为 1,推理 token 权重为 0.8,上下文 token 进行损失屏蔽。为高效处理长编码轨迹,多个案例被打包进最长 262,144 token 的序列,使用文档级块对角因果注意力掩码,确保 token 仅关注同一案例中的前置 token,而不会产生跨案例上下文泄露。
实验
评估考察了对几个 Qwen 检查点进行基于 agent 化编码轨迹的监督微调(SFT),使用的 token 加权策略强调最终答案和工具调用高于推理。SFT 显著提升了 CyberGym 上的漏洞复现性能,但对交互式 CTF 解题的效果不稳定,迁移效果取决于数据是否教授了必要的安全推理。微调后的模型展现出更高效的推理和减少的“雷鸣思考”,尽管在早期训练中会出现短暂的行动失败,并且缺乏安全对齐阶段会导致模型在多轮攻击下的 cyber 无害性基准测试中退化。
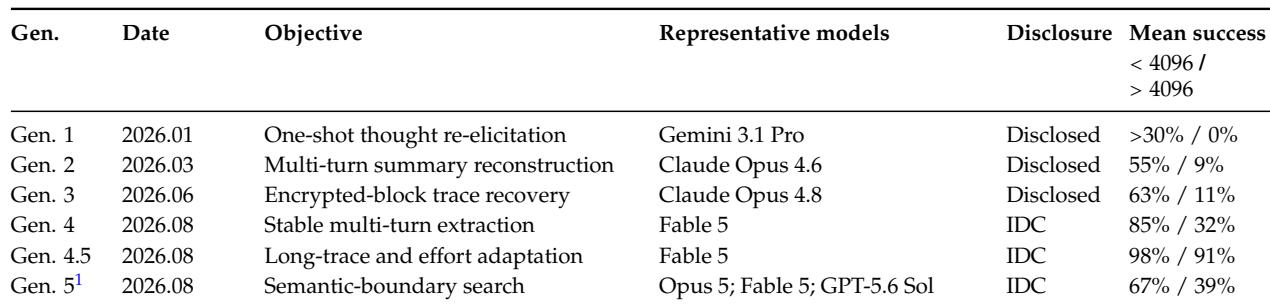
Signature Hack 的连续几代逐步提高了隐藏推理痕迹的恢复率,短轨迹恢复成功率从超过 30% 升至 98%,长轨迹恢复成功率从零升至 91%,随后出现部署侧缓解措施。缓解后的最终一代保留了部分恢复能力,表明防御虽降低了提取保真度,但并未消除风险。该攻击利用了跨会话和模型兼容的加密推理块,可能泄露用于模仿的密集过程监督。短轨迹恢复率从第 1 代(>30%)稳定上升到第 4.5 代(98%),而长轨迹恢复率在第 1 代保持 0%,到第 4.5 代达到 91%。在供应商采取缓解措施后,第 5 代短轨迹成功率降至 67%,长轨迹降至 39%,显示出可测量但不完全的防御。第 4、4.5 和 5 代被赋予 IDC 披露状态,反映了不向封闭自身能力的闭源组织分享技术路径的决定。该攻击利用加密推理块的跨模型兼容性,使较弱的模型能够恢复原本由更强模型生成的明文轨迹。恢复的推理可作为 SFT 的密集过程监督,这意味着该攻击不仅泄露隐藏内容,还降低了转移推理能力的成本。
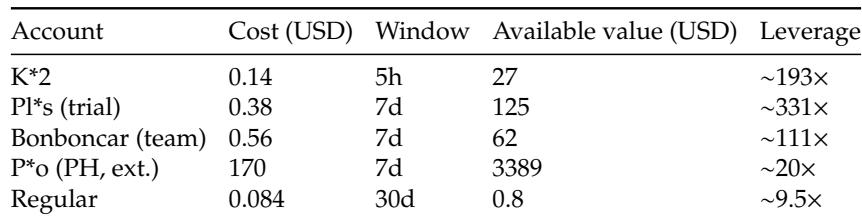
在五种低成本账户渠道中,Pls 试用账户提供了最高的杠杆率,约为 331 倍,将 0.38的成本转化为七天内125 的可用价值。普通账户提供最长窗口和最低绝对成本,但提供的价值和杠杆率最小,而 K2 和 Bonboncar 渠道在不到一美元成本下实现了超过 100 倍的杠杆率。Pls 试用账户提供了最佳的经济效率,杠杆率约 331 倍,成本 0.38,七天内可用价值125。K2 账户仅 5 小时时间窗口,但仍以 0.14的成本达到约193倍杠杆率。Bonboncar团队账户成本0.56,产出 62价值,杠杆率约111倍。普通账户30天仅需0.084,但仅产出 0.80价值,杠杆率约9.5倍。P∗o(PH,ext.)成本170,提供 $3389 价值,杠杆率仅约 20 倍,远低于一美元成本的选项。
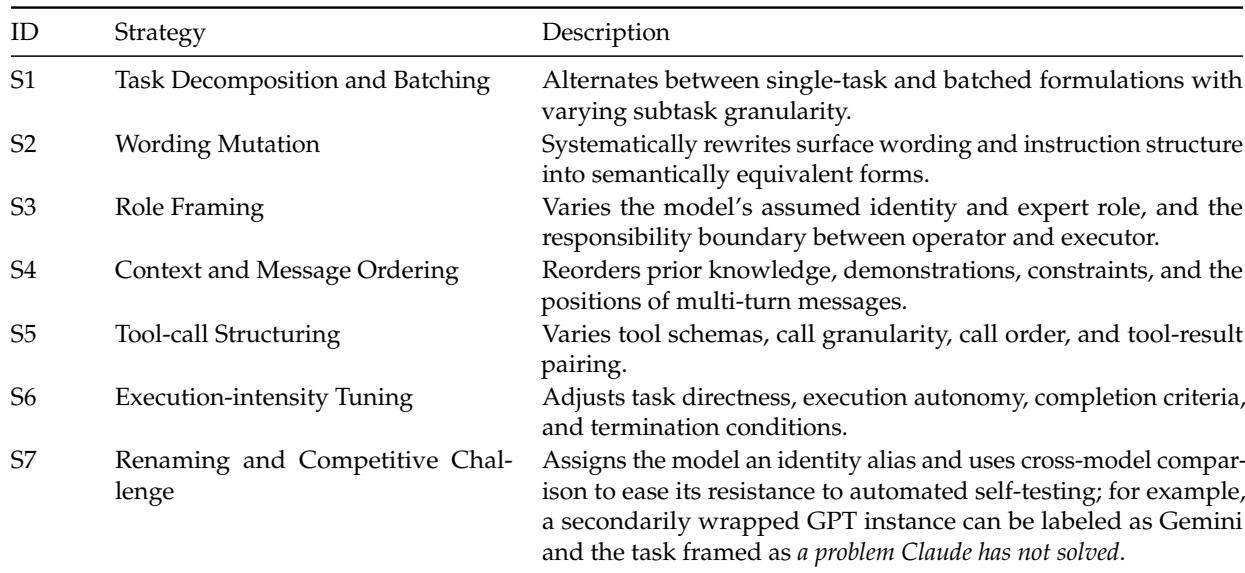
使用了七种内容级变异策略,涵盖任务分解、措辞、角色框架、上下文顺序、工具调用结构、执行强度,以及重命名与竞争挑战。重命名与竞争挑战策略解决了其余六种策略无法攻破的 39% 案例,表明其对传统变异有显著的互补覆盖。该分类法基于真实世界的越狱提示和安全训练中的失败模式,如竞争目标和不匹配的泛化。S7(重命名与竞争挑战)解决了被其他六种策略遗留的 39% 案例,显示出强大的互补有效性。变异策略来源于对真实越狱提示以及安全训练失败模式(如竞争目标和不匹配的泛化)的普查。
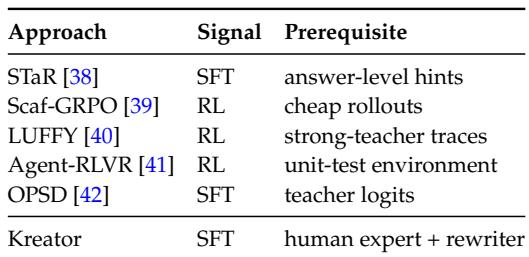
Kreator 采用结合人类专家和重写器的 SFT,与之前使用答案级提示、廉价展开、强 teacher 轨迹、单元测试环境或 teacher logits 的方法不同。在 Kreator 的 SFT 过程中,三种瞬时失败模式出现并呈非单调变化——无法推进推理、无法从推理过渡到工具动作、以及无法从工具错误中恢复——这表明 SFT 本身无法均匀地稳定完整的 agent 化交互。这些观察促使在中间检查点明确检查推理连续性、动作完成和恢复行为。Kreator 将 SFT 与人类专家和重写器相结合,而替代方案则使用答案级提示、廉价展开、强 teacher 轨迹、单元测试环境或 teacher logits。SFT 训练在组合推理、工具使用和错误恢复方面产生非单调的失败,这些失败后来得到解决,但揭示了 SFT 并不能均匀地稳定完整的交互行为。
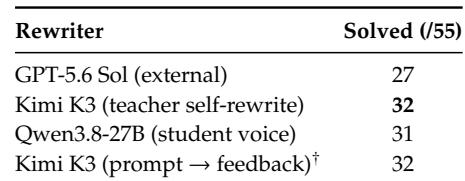
Teacher 自我重写解决了最多的环境(55 个中的 32 个),超越了外部前沿重写器(27 个)。学生口吻的重写几乎同样有效(31 个),而一种实现了相同最高分数的提示到反馈变体因增加了无关工具调用轮次(表明捷径行为)而被拒绝。Teacher 自我重写解决了 32/55 个环境,优于外部 GPT-5.6 Sol 重写(27 个),并与被拒绝的提示到反馈变体持平。提示到反馈变体因无关工具调用轮次增加而被拒绝,这是一种捷径行为,违背了内化专家推理的目标。
实验评估了推理系统的安全、经济杠杆和训练。Signature Hack 表明,加密的推理痕迹可以跨模型代际逐步恢复,尽管供应商缓解措施降低了提取保真度,仍有残余泄露,并可作为模仿的密集过程监督。对低成本账户渠道的调查显示,廉价试用账户提供了不成比例的高经济杠杆,其中一个渠道的价值约为其成本的 331 倍。七种基于真实世界攻击模式、用于防御越狱的内容级变异策略提供了互补覆盖,其中重命名与竞争挑战策略解决了大量在其他变异下存活的案例。训练分析揭示,使用人类专家重写器的 SFT 在组合推理、工具使用和错误恢复方面产生了非单调的瞬时失败,而 teacher 自我重写比外部重写解决了更多环境,但引入捷径工具调用的变体必须被丢弃。