Command Palette
Search for a command to run...
NeoHorse-1:通过带路由控制的智能体后训练实现递归自我改进
NeoHorse-1:通过带路由控制的智能体后训练实现递归自我改进
摘要
递归自我改进(RSI)需要一个具体机制,使人工智能系统能够观察自身能力并将该证据转化为下一轮学习。我们认为,已部署的路由控制框架已包含这样的机制:除了任务输出之外,智能体交互还留下了执行轨迹以及模型当前能与不能做的可观察证据。我们提出了 NeoHorse-1,一个通过智能体后训练探索此路径的智能体原生模型系列。我们的系统将异构模型池与智能路由相结合,记录每一轮的能力需求预测、所选服务层级以及后续交互。这些记录被转换为保留交错推理、工具调用和框架上下文的用户轮次训练示例,并通过结构验证、六维语义评估和子场景级标注进行筛选。路由信号提供能力需求的估计:它们将监督微调组织为三阶段课程,并自然扩展到路由引导的在线策略蒸馏,其中教师在同一阶段进展下监督学生生成的响应。最后,能力引导的分配步骤将评估反馈转化为下一轮训练混合,闭环了评估-选择-更新循环,其中系统学习的内容塑造了其下一步学习的内容。在涵盖基于框架的智能体、工具使用、编码和指令遵循的十个基准测试中,后训练将 4B 模型的宏观平均分从 58.94 提升至 64.87,将 9B 模型从 65.60 提升至 69.04,显著缩小了后训练 4B 模型与 9B 基础模型之间的总体差距。NeoHorse-1 构成了这一反馈驱动过程的初步原型,我们概述了如何跨迭代维持该过程,以将框架介导的 RSI 从设计推向实践。
一句话总结
来自 TokenRhythm Technologies、Infinigence AI、清华大学、北京大学等机构的研究者提出了 NeoHorse-1,一个 agent 原生模型家族,其路由调度框架将执行轨迹和能力需求信号转化为训练数据,通过三阶段课程学习和路由引导的在线策略蒸馏实现递归自我改进,后训练将 4B 和 9B 模型在十项基准上的宏平均分数分别从 58.94 提升至 64.87、从 65.60 提升至 69.04,从而缩小了 4B 与 9B 模型之间的差距。
核心贡献
- 提出 NeoHorse-1,一个 agent 原生模型家族,将路由调度框架的交互记录(包括能力需求预测、服务层级选择和后续轨迹)通过结构验证、六维语义评估和子场景级标注转化为用户轮次训练样本。
- 将这些样本组织为由路由分数驱动的三阶段监督微调课程,并将该阶段性扩展至路由引导的在线策略蒸馏,通过能力引导的评估反馈分配将评估-选择-更新循环闭环,反馈进入下一轮训练数据混合。
- 在涵盖基于框架的 agent、工具使用、编码和指令遵循的十项基准上,后训练将 4B 模型的宏平均分数从 58.94 提升至 64.87,将 9B 模型从 65.60 提升至 69.04,且后训练的 4B 模型大幅缩小了与 9B 基础模型之间的总体差距,为循环可驱动后续迭代提供了初步证据。
引言
AI 中的递归自我改进(RSI)要求系统观察自身能力并将该证据转化为后续学习循环。尽管已有工作探索了基于轨迹的监督微调、在线策略蒸馏和课程学习,这些方法往往依赖固定的教师策略、显式难度标签或数据集特定的启发式规则,获取成本高昂。此外,现有 agentic 训练方法通常将交互记录视为静态监督,错失了利用表征能力需求的路由信号和揭示模型弱点的记录结果的机会。
作者提出了 NeoHorse-1,一个 4B 和 9B 规模的 agent 原生模型家族,利用路由引导的 agentic 训练流水线。其核心贡献是一个闭环反馈回路,部署框架产生三种可复用信号:执行轨迹、路由派生的能力需求分数和任务结果。这些信号将训练数据组织为三阶段监督微调课程,并扩展至路由引导的在线策略蒸馏,其中教师在同一阶段性推进下监督学生生成的响应。随后,能力引导的分配步骤将评估反馈转化为下一轮训练数据混合,闭环了评估-选择-更新循环。作者在十项基准上展示了一致的提升,将宏平均分数在 4B 规模从 58.94 提升至 64.87,在 9B 规模从 65.60 提升至 69.04,且后训练的 4B 模型大幅缩小了与 9B 基础模型的差距。
数据集
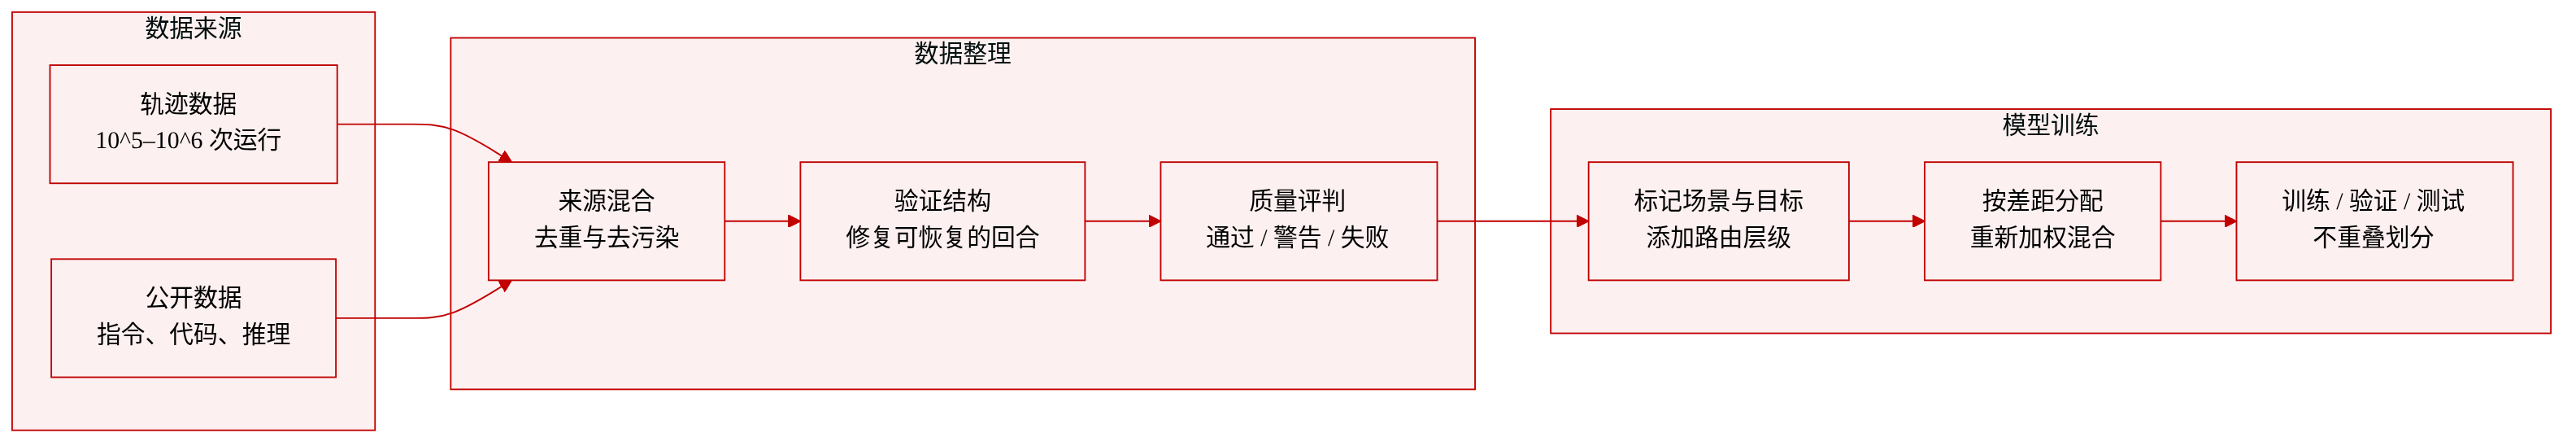
作者围绕部署框架生成的执行轨迹构建后训练语料,而非静态的指令-响应对。每条轨迹捕获完整的交互链:用户请求、模型推理、工具调用、环境观察、恢复尝试和最终结果。指令遵循、推理、工具使用、代码、agent 交互和偏好方面的公开数据补充了框架生成的数据,以拓宽能力覆盖范围。
语料组织
- 数据按三个粒度进行结构化:
- 轨迹:由框架执行的完整交互,保留所有事件和结果。
- 用户轮次:以用户请求开始,以下一个请求或任务终止结束;这是基本的序列化训练单元。
- 子场景:将共享局部目标的相邻用户轮次分组,作为语义表征的单元。
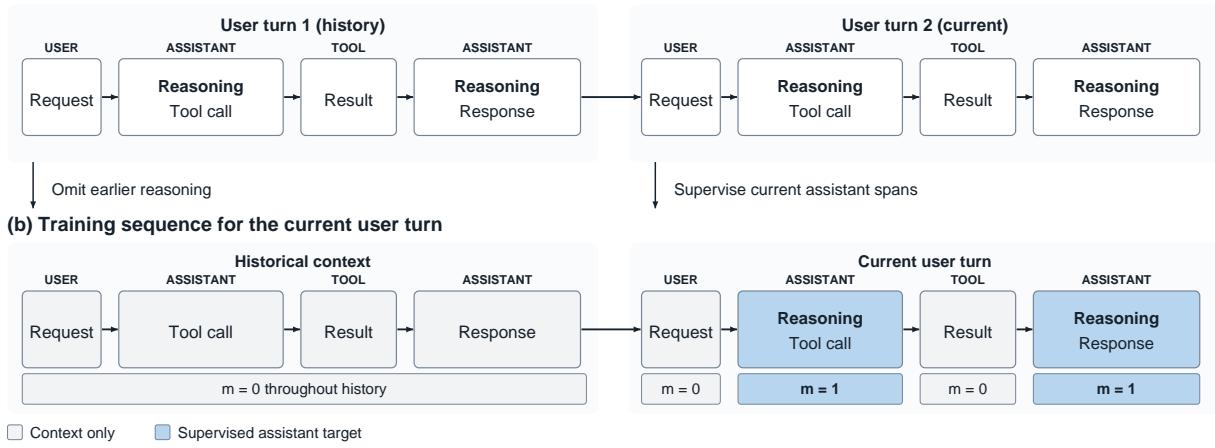
- 每条用户轮次记录保留当前请求、交错的推理、工具调用和观察,而先前可见的响应和工具交互保留为上下文。早期轮次的推理被省略。
- 主要语料包含约 105 至 106 条框架生成的轨迹。规模以统一序列化、去重和 tokenizer 冻结后的轨迹数量和 token 数量报告。
质量控制
- 去重移除完全重复和近似重复的记录。同一匹配基础设施将所有候选数据与评估套件进行筛查,移除与评估条目重叠的任何记录,确保训练数据和评估数据不相交。
- 结构验证使用基于规则的检查来重建请求、响应、工具调用、观察和终止事件。它验证负载可读性、消息结构、因果事件顺序以及工具调用/结果对的闭合性。该阶段检测缺失响应、孤立观察、冲突标识符、未解析调用和歧义终止分支。
- 结构门控产生三种结果:内部完整、部分可恢复和隔离。完整轨迹进入语义评估;可恢复轨迹仅贡献因果闭合的子轨迹;歧义轨迹被隔离。
- 语义评估考察六个维度:目标达成、指令遵循、工具使用、证据一致性、错误恢复和终止。高确定性失败通过确定性规则检测,而任务级解释使用仅限于轨迹中证据的语义评判器。每个维度获得 PASS、WARN、FAIL 或 NOT_EVALUATED,覆盖度单独存储。缺失证据不会转化为正面判定。
表征
- 每个子场景沿三个轴进行表征:
- 场景:用户在做什么以及处于何种上下文,使用任务类型和应用领域的封闭分类体系。
- 目标:用户期望实现什么以及成功如何判定,包括验收标准和跨轮次关系(新建、延续、修改、恢复、歧义)。
- 结果:针对目标的可验证尝试结果。
- 每个属性保留其推导方法和置信度。由来源或确定性规则建立的结构性事实不能被语义评判器覆盖。
路由信号
- 框架路由器在用户轮次级别运行,从当前请求、近期对话、先前路由决策和执行状态估计能力需求。
- 每个轮次被分配到四个服务层级之一:C0 用于受限低风险请求,C1 为通用默认层级,C2 用于多步推理和执行,C3 用于最大能力或可靠性。策略控制可调整分配结果。
- 对于每个轮次,语料保留路由器的原始预测、策略调整后的决策和实际服务的层级,使预测需求、策略约束和执行动作可独立分析。
数据分配
- 在每次迭代中,当前模型检查点在分层评估套件上评估,该套件与训练数据不相交。结果按属性、质量维度、结果状态和路由层级聚合,形成模型缺陷画像。
- 该画像将下一轮训练数据混合向表现不佳的区域倾斜,同时保持广泛覆盖。已验证成功的轨迹提供正向监督;信息性失败标识需要额外或重新平衡覆盖的区域。
- 在迭代之间,框架持续添加经同一流水线处理的新轨迹。现有数据和新数据一起重新分配,因此语料跟随使用模式和系统能力的变化。
- 路由派生的分数通过两种调度机制影响优化:它们对三阶段 SFT 课程中的用户轮次样本进行排序,且相同的推进顺序调度在线策略蒸馏的起始上下文。
方法
作者从部署框架生成的执行轨迹构建训练数据。用户轮次定义为一条用户请求及其后的助手响应和工具交互。为准备监督微调(SFT),作者使用特定聊天模板序列化每个轮次。早期推理被省略,而可见响应和工具交互保留为历史上下文。在当前用户轮次内,助手目标跨度(包括推理、工具调用和响应)接收预测损失,而用户消息和工具结果不接收。如下图所示:
SFT 目标在掩码后的助手目标跨度上最小化负对数似然。对于一批 B 逻辑序列,损失定义为:
LSFT(θ;B)=−∑i∈B∑t=2Timi,t∑i∈B∑t=2Timi,tlogpθ(xi,t∣xi,<t)其中 mi,t 是二进制 token 级损失掩码,对保留的助手目标跨度中的 token 设为 1。
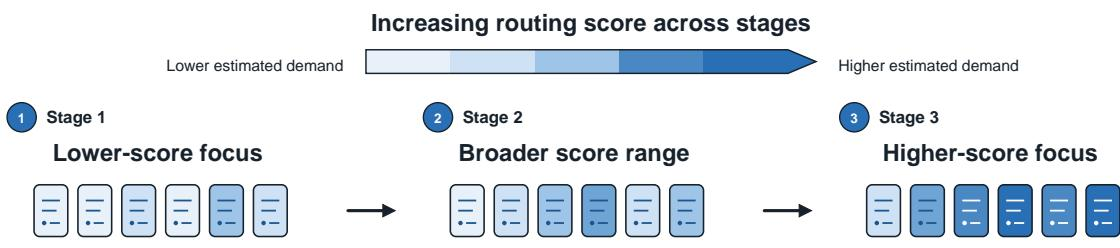
Agentic 交互在能力需求上各不相同,从常规响应到复杂规划。作者利用路由估计将 SFT 样本组织为渐进式课程。不依赖实际服务的模型,而是从请求和交互历史重新估计能力需求。路由器分配层级索引 ki∈{0,1,2,3} 和归一化分数向量 πi,k。作者使用软排序分数:
si=k=0∑3kπi,k该分数决定样本在三个训练阶段中的呈现顺序。课程逐步引入更高分数的样本,同时保留一些低分数样本用于后期阶段,以防止训练末尾完全被高需求交互主导。参见框架图:
为解决 SFT 固有的分布偏移,作者采用在线策略蒸馏(OPD),其中学生模型生成前缀并接收教师监督。路由引导的课程被扩展为调度蒸馏的起始上下文。在每个阶段 j,学生检查点从由路由分数诱导的分布 ρj 中抽取上下文并生成响应。完整训练过程如下图所示:
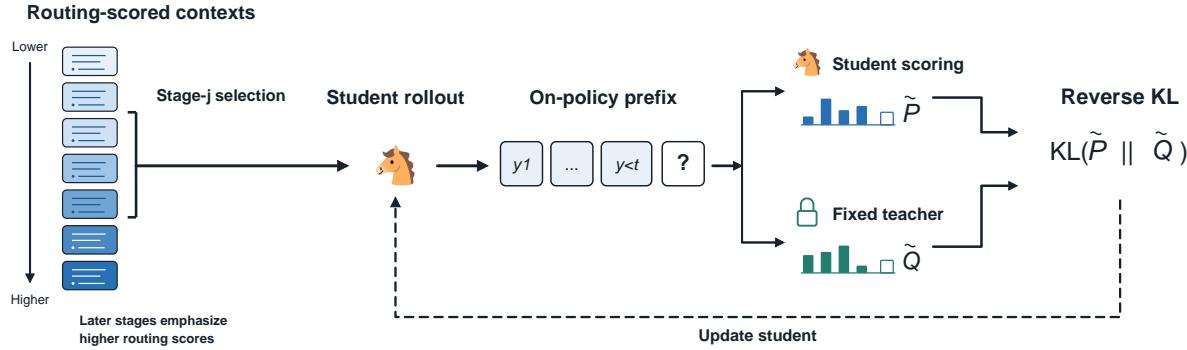
固定教师提供以上下文和学生先前 token 为条件的下一 token 分布。为高效计算损失,作者在每个位置保留学生的前 K 个候选 token,并将剩余概率质量聚合为单个分箱,创建粗化分布 Pθ,r,t 和 Qr,t。蒸馏目标最小化响应归一化的反向 KL 散度:
LOPD(θ;R)=∑r∈Rwr1r∈R∑Lrwrt=1∑LrDKL(Pθ,r,t∥Qr,t)阶段级目标结合上下文分布与学生生成:
LR−OPD(j)(θ)=EC∼ρjR∼pθˉ(⋅∣C)[LOPD(θ;R)]滚动检查点随训练推进而刷新,确保后期上下文基于更新的学生行为接收教师监督。
实验
评估涵盖三个互补分析:基准性能、agent 轨迹行为和训练数据。在 agentic、编码和指令遵循基准上,NeoHorse-1 在 4B 和 9B 规模均优于其基础模型,增益集中在交互型和执行密集型任务上;9B 变体进一步优于 4B 变体,尤其在多步交互和执行失败恢复方面。轨迹分析表明,训练有助于闭合端到端执行循环,而规模带来更稳健的迭代验证、策略适应以及在反馈和失败下对交互预算的高效利用。数据分析表明,在匹配的训练条件下,路由框架轨迹比公开合成 agent 数据具有更强的迁移效果,且扩展高质量路由框架监督在所评估范围内产生一致的总体性能提升。
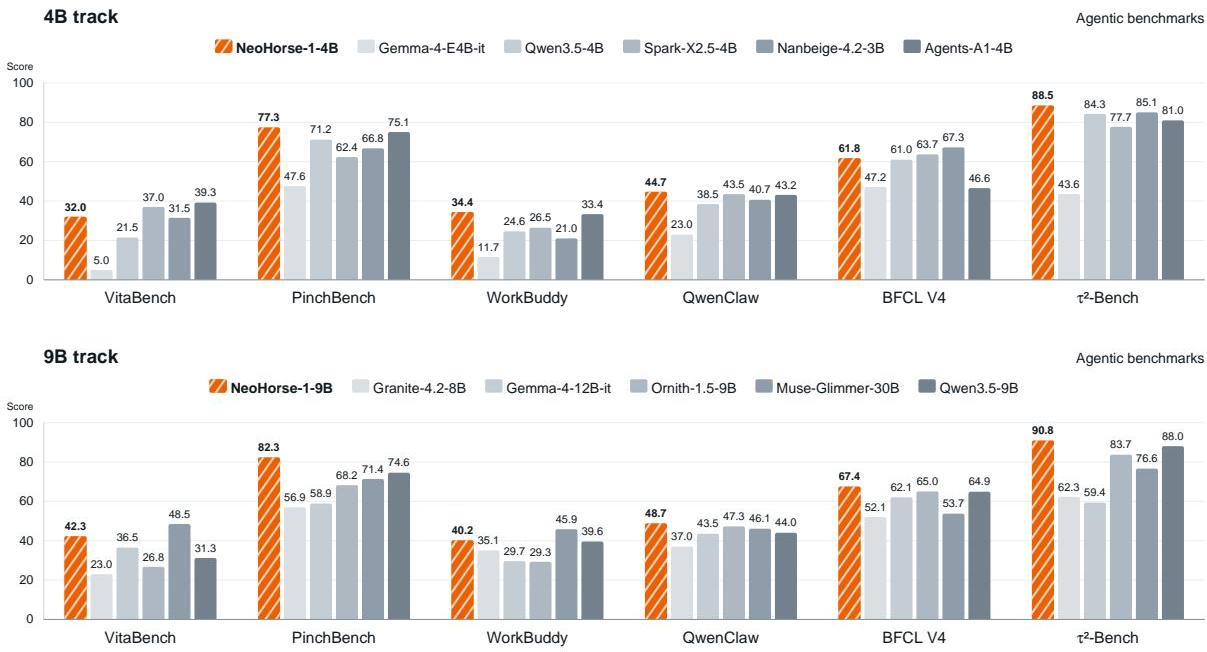
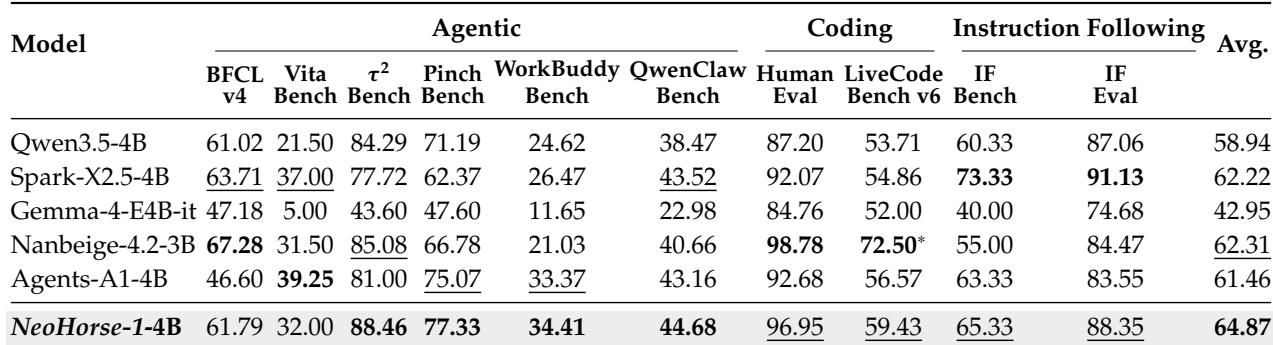
NeoHorse-1-4B 在 agentic、编码和指令遵循基准上展现出与代表性 4B 规模开源模型相当或更优的性能。它在比较模型中取得最高平均分数,在多轮工具使用和指令遵循方面表现突出,但在某些编码特定任务上稍显落后。NeoHorse-1-4B 在所有基准上相比其他 4B 规模模型取得最佳平均分数。它在指令遵循指标上领先,在 IF Bench 和 IF Eval 上均获最高分。其 agentic 性能强劲,尤其在 VitaBench 和 PinchBench 上优于大多数同类模型。编码结果参差不齐:在 HumanEval 上排名第二,但在 LiveCodeBench v6 上相对于部分竞争者排名较低。
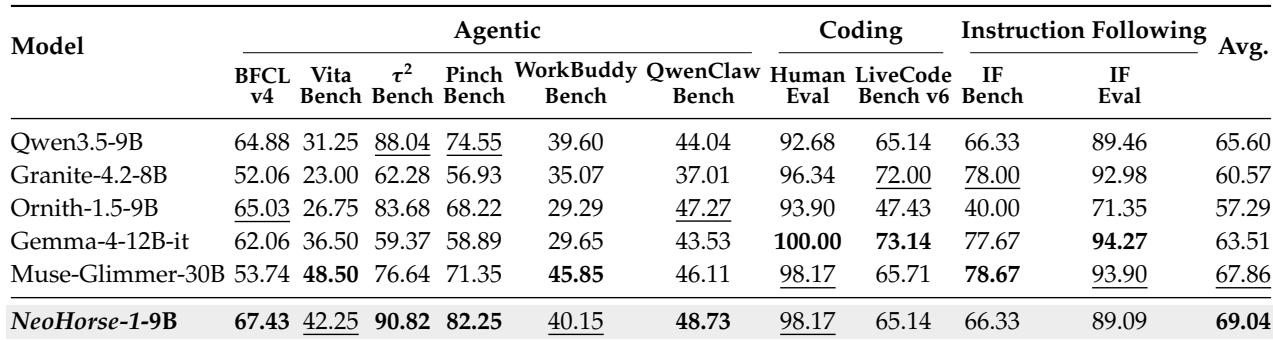
NeoHorse-1-9B 在大多数 agentic、编码和指令遵循基准上优于更大规模的模型,在比较模型中取得最高平均分数。它在 agentic 任务和指令遵循方面尤为突出,同时尽管规模更小,编码性能仍具竞争力。NeoHorse-1-9B 在所有基准类别中取得最佳平均分数,超越 Muse-Glimmer-30B 等更大模型。它在 agentic 基准上领先,包括在 BFCL v4、VitaBench 和 WorkBuddyBench 上获得最高分,并在 PinchBench 上并列最佳。在指令遵循方面,它取得最高的 IFBench 分数和强劲的 IFEval 结果,优于所有更大模型。在编码方面,它仅在 HumanEval 和 LiveCodeBench 上落后于更大的 Muse-Glimmer-30B,同时仍超过多个其他更大模型。
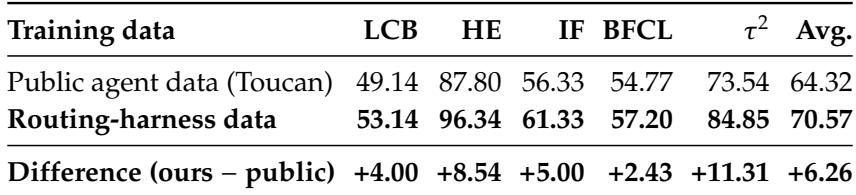
在相同训练配置下,路由框架轨迹优于公开工具 agent 数据,在全部五项基准上产生一致的增益。最大提升出现在代码生成和多轮工具使用上,而函数调用和指令遵循也出现较小但正向的增益。路由框架数据将平均基准分数比公开 agent 数据提升 6.26 分。最大增益出现在 HumanEval(+8.54)和 τ²-Bench(+11.31),表明更强的编码和多轮工具使用监督。函数调用、指令遵循和编码基准也均有提升,显示路由框架轨迹的广泛迁移性。
NeoHorse-1-4B 在 agentic、编码和指令遵循基准上达到或超过其他 4B 规模模型,取得最高平均分数,尤其擅长多轮工具使用和指令遵循,但在某些编码任务上稍显落后。NeoHorse-1-9B 在大多数基准上优于更大模型,在 agentic 任务和指令遵循方面领先,同时尽管规模更小,编码性能仍具竞争力。此外,在相同训练条件下,路由框架轨迹始终优于公开工具 agent 数据,最大增益出现在代码生成和多轮工具使用上,平均分数提升 6.26 分。