Command Palette
Search for a command to run...
OpenWAM:面向系统性世界-动作模型预训练的开源模块化探索
OpenWAM:面向系统性世界-动作模型预训练的开源模块化探索
摘要
世界-动作模型从视频生成先验中继承世界知识,并通过具身经验将其转化为可执行的控制信号。然而,现有系统是单体式的:生成骨干、视觉表示、架构、信息流、推理过程以及训练数据紧密耦合,掩盖了哪些设计选择至关重要及其原因。我们提出 OpenWAM,一个开源研究栈,将世界-动作预训练转变为受控的实验程序。OpenWAM-Infra 将 WAM 设计空间分解为可组合的模块,并统一训练、推理、部署和评估。在此基础之上,OpenWAM-Study 通过受控实验探讨三个问题:继承什么、世界学习与动作学习如何交互,以及它们的协同如何扩展;并提炼出三个原则:上游知识通过足够强大的生成骨干和紧凑且信息丰富的潜在空间进行迁移;世界-动作协同需要专门的动作容量、显式的世界到动作信息流以及同步的联合去噪;具身预训练主要改善域外泛化,其中对自我中心人类数据和机器人数据进行单阶段联合训练,整合了世界覆盖与动作基础。综合这些原则,我们构建了 OpenWAM-α,一个在约 6,400 小时的自我中心人类和机器人数据上预训练的开源 WAM,并在仿真和真实世界基准上进行了评估。在八个仿真基准和真实机器人实验中,涵盖了从单臂和双臂操作到灵巧手的多种具身形态,OpenWAM-α 始终表现出色,从仿真到物理世界均保持顶级水平。我们发布了完整栈,包括基础设施、评估协议、预训练模型和数据配方,以促进未来研究。
一句话总结
来自新加坡国立大学、清华大学、北京大学和香港大学等机构的研究者提出了 OpenWAM,一个开放模块化技术栈,将世界-动作模型预训练分解为可组合模块,提炼出三项设计原则,并构建了在 6400 小时第一人称和机器人数据上预训练的 OpenWAM-α,在八个仿真基准和涵盖单臂、双臂及灵巧手操作的真实机器人任务中均达到顶尖性能。
核心贡献
- 提出 OpenWAM,一个开放研究技术栈,将世界-动作预训练分解为可组合模块(OpenWAM-Infra),支持在八个仿真基准和真实机器人上对架构家族、训练、推理、部署和评估进行受控实验。
- OpenWAM-Study 通过受控实验提炼出三项设计原则:知识迁移需要具备紧凑潜空间的有能力生成骨干网络;世界-动作协同需要专用动作容量、显式信息流和同步联合去噪;具身预训练主要通过在第一人称和机器人数据上进行单阶段联合训练来提升域外泛化能力。
- OpenWAM-α 在约 6,400 小时的第一人称人类和机器人数据上预训练,在八个仿真基准以及真实世界的单臂、双臂和灵巧手任务上均表现稳定优异,完整技术栈、评估协议、预训练权重和数据配方均已公开发布。
引言
具身智能需要的不仅仅是感知;一个 agent 必须预测世界如何变化并采取行动去影响它。虽然视频生成模型能从海量数据中捕捉丰富的视觉动态,但带有可执行动作标签的机器人轨迹却十分稀缺,这造成了根本性的数据不对称。以往的方法要么仅从示范中学习控制(如 ACT 和 Diffusion Policy),要么继承视觉语言模型的语义知识,但都没有利用视频生成中固有的时间演化先验。世界-动作模型(WAM)通过继承视觉动态的生成先验并经由具身体验进行适配来解决这一问题,然而现有系统是整体式的,将架构、数据和训练紧密耦合,模糊了究竟哪些组件驱动了成功。
作者提出了 OpenWAM,一个将 WAM 设计空间分解为模块化组件并支持受控实验的开放研究技术栈。通过 OpenWAM-Study,他们识别出三项关键原则:有效的世界知识迁移需要具备能力的生成骨干网络和紧凑的视觉潜空间;世界-动作协同需要充足的动作专用容量、显式信息流以及联合去噪调度,而非仅仅联合预测;具身预训练主要提升域外泛化能力,而人类第一人称视频和机器人轨迹的联合训练提供了最强的整合效果。他们将这些发现实例化为 OpenWAM-α,一个在统一 80 维动作空间下扩展到 5.18 亿帧异构数据的预训练模型,在八个仿真基准和真实机器人平台上展现出稳定性能。完整技术栈(包括基础设施、评估协议和权重)均已发布,以支持可复现研究。
数据集
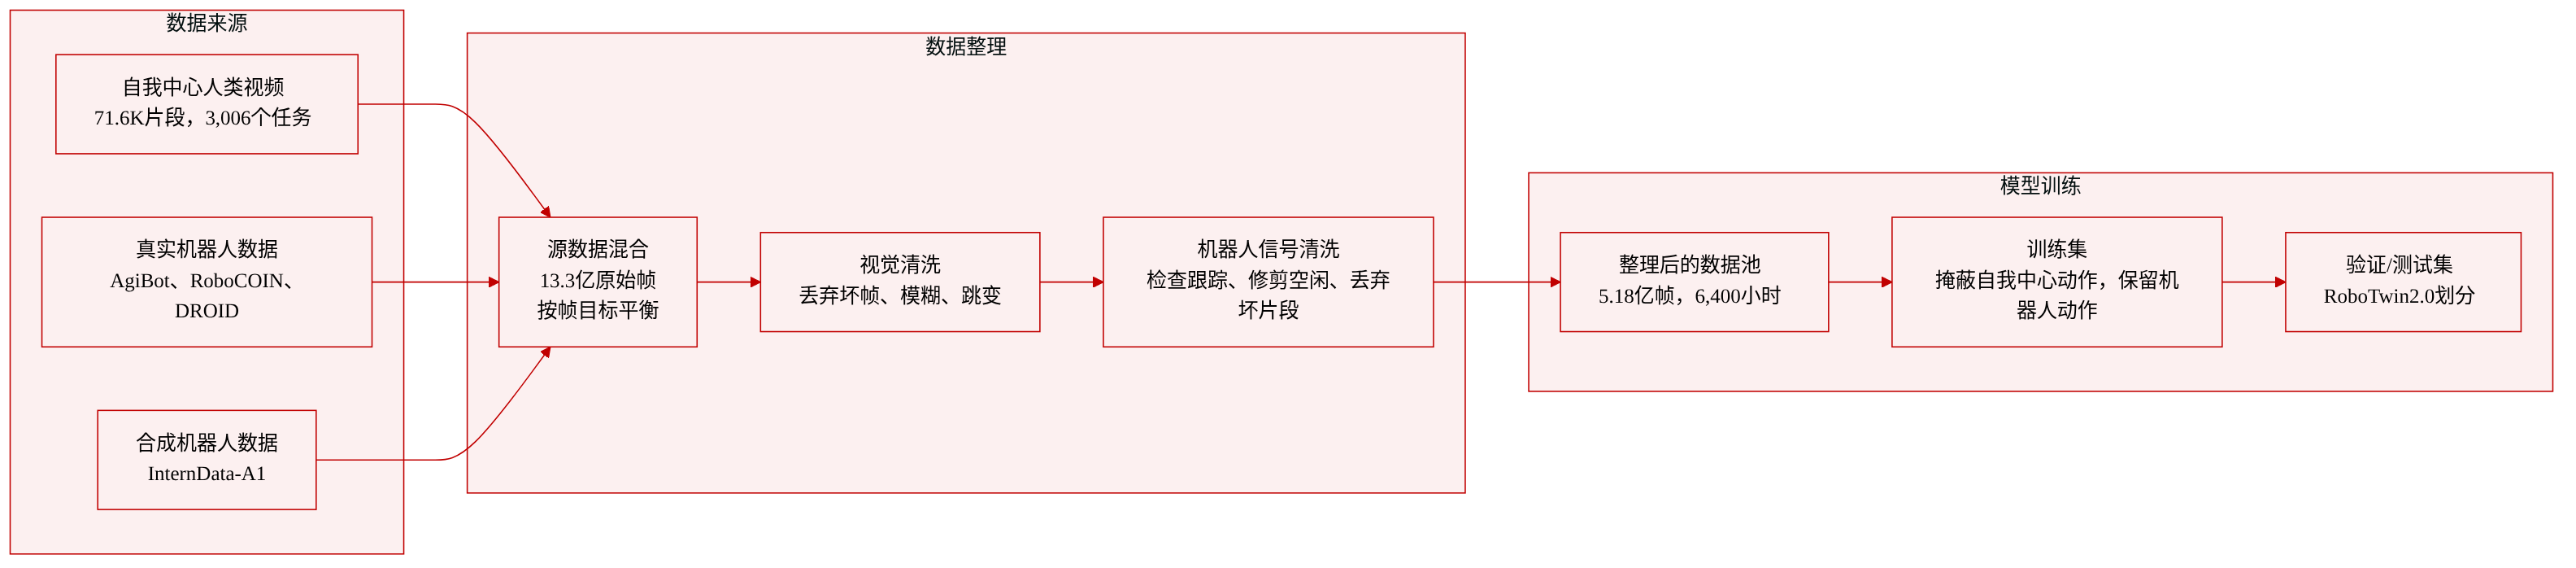
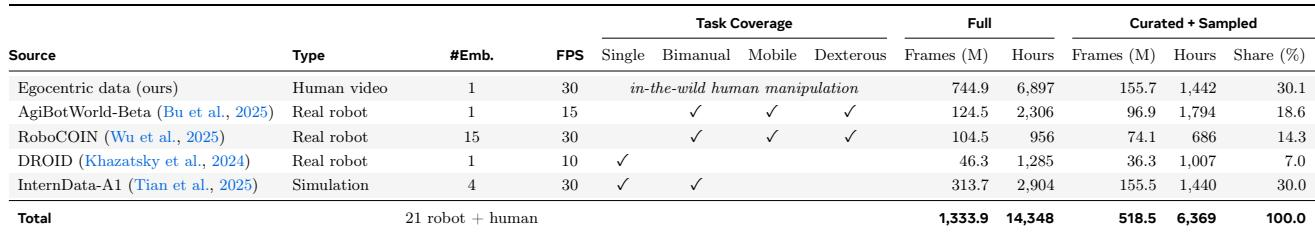
作者从覆盖三种数据类型的五个来源构建了 OpenWAM-α 的预训练数据集:第一人称人类视频、真实世界机器人数据和合成机器人数据。从约 13.3 亿帧(约 14,300 小时)的原始数据池中,通过清洗和按来源子采样的组合,筛选出约 5.18 亿帧(约 6,400 小时)的训练集。
数据集组成与来源
- 第一人称人类数据:自建数据集,包含 71.6K 段长时程第一人称录像,每段时长 0.25 至 6 分钟,覆盖 3,006 种日常操作任务。该来源提供了丰富的视觉和交互多样性,但不含机器人动作标签。
- 真实世界机器人数据:来自 AgiBotWorld-Beta、RoboCOIN 和 DROID,该数据以 17 个物理平台上的可执行轨迹为动作流提供支撑,并提供机器人在物理环境中的真实视觉观测。
- 合成机器人数据:来自 InternData-A1,该来源扩展了多种环境变化下单臂和双臂操作技能的覆盖范围。
数据预算与采样
- 作者基于帧数目标分配各来源的小时预算:第一人称和合成来源各贡献总训练帧数的 30%,其余 40% 按各真实机器人来源筛选后有效帧数的比例分配。
- 这种平衡考虑了各来源不同的原生帧率。
- 在每个来源内部,小时预算在各子数据集间按水位线方式分配,并在固定随机种子下从筛选后的数据池中对完整片段进行子采样,直至达到预算。
- 训练按各来源实际样本数比例进行采样,因此每个保留样本在每个 epoch 中恰好被访问一次。
数据筛选
清洗协议在两个层面进行:针对所有来源的视觉层面清洗,以及针对机器人数据的信号层面清洗。
视觉层面清洗
- 移除无法解码的视频、冻结或重复帧、黑屏、白屏和纯色帧、过曝和欠曝及曝光闪烁、模糊帧以及突变的视觉跳变。
- 对于第一人称数据,特别移除手部离开视野的片段,并丢弃语言标注为空或无效的录像。
信号层面清洗(仅机器人数据)
- 信号完整性:如果末端执行器状态未能跟踪指令动作(幅度比至少 3 倍且各轴相关性低于 0.5),或视频-信号错位影响超过 2% 的帧,则该片段被丢弃。
- 状态优先的静止检测:使用根据单帧差分 p99.5 校准的各机器人运动阈值,修剪首尾状态静止的片段,当平均末端执行器平移和测地线旋转速率分别低于 2 cm/s 和 5 度/s 时予以确认。片段中间暂停从不裁剪。使用稳健的 median-MAD 阈值筛选状态不连续(如突变和尖峰异常值)。
- 视觉交叉验证:当状态在运动但所有相机视角保持视觉静止时,该运动被归因于传感器抖动并予以修剪。若冻结相机观察到真实移动的机械臂,则标记为采集缺陷,该片段被移除。
- 片段级删除:若某片段因上述步骤丢失超过 70% 的帧,或其视频在 90% 及以上时长内冻结,则整个片段被丢弃。
数据在模型中的使用方式
- 第一人称人类数据的动作和本体感受通道被完全掩蔽,因此仅监督世界流。
- 真实世界机器人数据以可执行轨迹为动作流提供支撑。
- 作者在相同的 600 小时数据预算下比较了从零开始的监督微调与三种预训练策略:仅机器人数据(全部预算用于机器人数据),以及两种混合变体(350 小时第一人称数据 + 250 小时机器人数据),分别采用两阶段(先第一人称后机器人)或单阶段联合(第一人称 + 机器人联合训练)方式。
- 所有变体采用相同的下游微调,双系统联合自注意力架构和同步去噪保持固定。
- 评估使用两种协议:RoboTwin2.0-Clean2Random 在 Clean 上微调并在 Clean(域内)和 Randomized(域外)上评估;RoboTwin2.0-Full 在完整训练集上微调,并报告两种条件下的平均成功率。
方法
作者利用模块化基础设施 OpenWAM-Infra,将世界-动作建模分解为具有显式接口的解耦组件。该设计解决了现有系统中常见的紧密耦合和特化实现问题。该基础设施的核心是可组合的模型架构、统一的训练运行时、灵活的部署运行时和标准化的评估协议。
可组合模型架构 OpenWAM-Infra 将世界-动作模型(WAM)组织为三类可互换模块,通过组合规则 C(E,S,M) 进行组装。视觉编码器 E 将观测映射为世界流预测的潜序列,并在训练期间保持冻结。流骨干网络 S 处理模型的 token 流,包括用于视觉状态预测的世界流、用于动作块预测的动作流,以及可选的语义理解流。可见性注意力掩码 M 指定流和 token 之间的注意力关系,通过模态内和跨模态块控制信息流。
参见框架图。
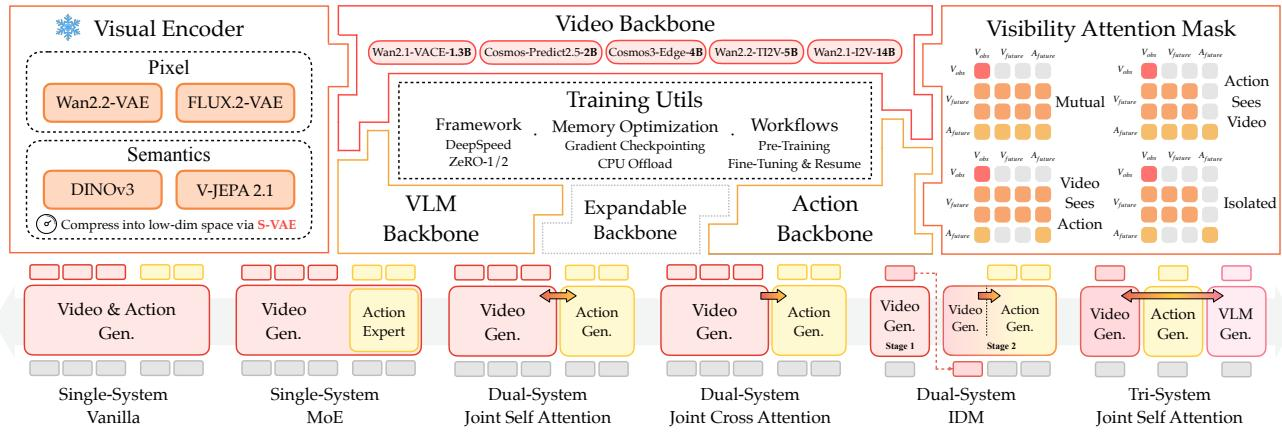
组合规则 C 对各参与骨干网络的准备阶段、逐层块和收尾阶段进行排序。它创建了三个架构家族:单系统(Single-System),视频和动作 token 共享一个 transformer;双系统(Dual-System),使用通过自注意力或交叉注意力连接的独立视频和动作骨干网络;三系统(Tri-System),在双系统布局基础上扩展一个冻结的视觉语言模型,为独立可训练的理解流提供输入。
训练运行时 作者在单一训练器下使用联合流匹配目标训练所有架构。一个样本由语言指令、视频窗口、动作块、可选的本体感受状态和有效性掩码组成。视觉编码器将视频编码为潜变量,每个流被噪声化到各自的时间步。架构执行联合前向传播以预测两个流的速度。目标函数最小化预测速度与目标速度之间的加权差异,有效性掩码将动作项限制在已填充的坐标上。由于时间步独立采样,训练覆盖了整个联合噪声平面,确保任何推理调度都保持在分布内。训练运行时集成了 DeepSpeed ZeRO、混合精度和梯度检查点等内存优化工具。
部署运行时 每个检查点由策略服务器提供服务,该服务器从自包含记录中重建架构。服务器将推理模式与去噪调度解耦。
如下图所示:
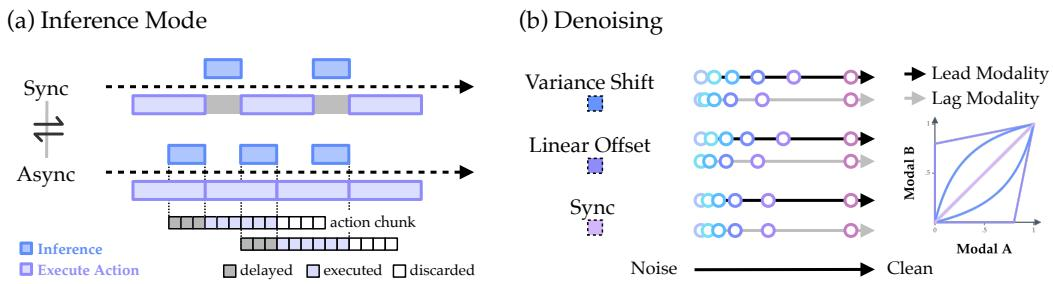
推理模式决定推理何时运行。在同步模式下,当动作缓冲区为空时,服务器阻塞等待新的推理结果。在异步模式下,后台工作线程在当前缓冲区执行期间预取下一个块,将该块拆分为延迟前缀、执行窗口和丢弃尾部。去噪调度定义通过联合噪声平面的路径。同步调度使两个流同步推进。异步调度使用方差偏移或线性偏移函数让一个流领先,使模型能够遍历训练期间覆盖的噪声平面上的不同路径。
评估协议 OpenWAM-Infra 通过客户端-服务器流水线评估训练好的检查点。基准测试作为瘦客户端通过持久 WebSocket 连接接入,以物理原生单位发送观测并接收动作。
参见下图。
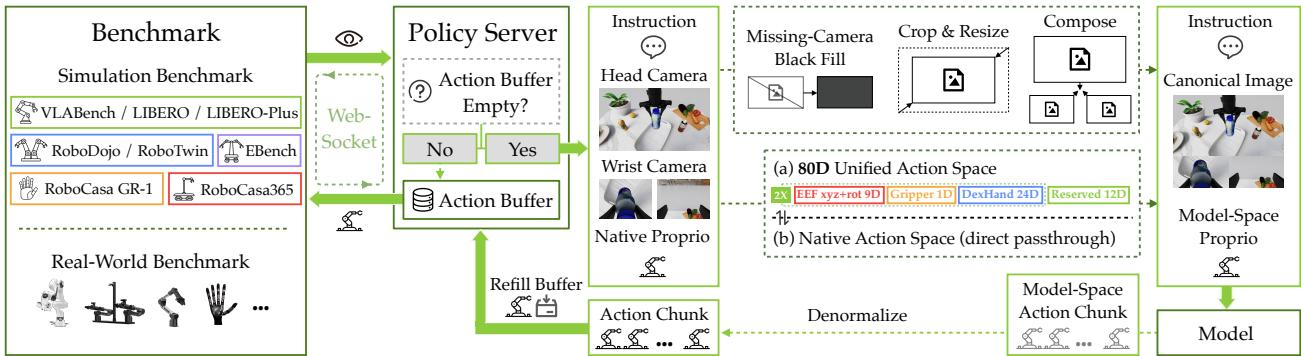
策略服务器处理所有面向模型的转换。它对相机视角进行规范化,归一化本体感受状态,并将其映射到模型的动作表示中。为支持跨具身训练,作者定义了一个统一的 80 维动作空间,对末端执行器位置、旋转、夹爪和灵巧手具有固定的槽位语义,并为具身特定通道保留预留槽位。每个数据集声明一个索引映射,将其原生动作散布到该统一空间中,有效性掩码确保未映射的坐标不接收梯度。预测的动作块在返回机器人之前被映射回并反归一化。
OpenWAM-α 实例化 基于受控研究中提炼的设计原则,作者实例化了 OpenWAM-α。该架构采用带联合自注意力的双系统,使用冻结的 Wan2.2-VAE 作为视觉编码器,预训练的 Wan2.2-TI2V-5B DiT 作为世界流,以及专用的 1B 参数 ActionDiT 作为动作流。可见性掩码使用互见模式,视频内部注意力采用首帧因果方式。模型在第一人称人类数据、真实世界机器人数据和合成机器人数据的混合数据上以单阶段端到端方式训练,使用独立采样时间步的联合流匹配目标。在部署时,OpenWAM-α 遵循同步去噪调度,沿联合噪声平面对角线同步推进两个流,并利用提示嵌入缓存和编译联合去噪循环等加速技术实现实时控制速度。
实验
评估协议通过客户端-服务器流水线在八个仿真基准上提供检查点服务,统一动作空间支持跨具身训练。RoboTwin2.0 上的受控研究表明,更强的生成骨干网络和紧凑表示编码器能提升性能,训练期间显式的世界到动作信息流配合同步去噪是必要的,而具身预训练主要提升域外泛化能力,并将首选注意力掩码转向互见模式。在八个基准套件上,OpenWAM-α 在大多数任务中达到顶尖水平,并在 EBench 上刷新了最优结果,但在 LIBERO-Plus 等分布外分割上因单臂预训练数据有限和像素级预测敏感性而落后于 VLA。跨单臂、双臂和灵巧手具身的真实机器人测试证实了强劲性能,包括在完全未见过的灵巧手平台上,而 VLA 与 WAM 的对比表明,WAM 更适配分布内任务,但 VLA 在分布偏移下泛化能力更强。
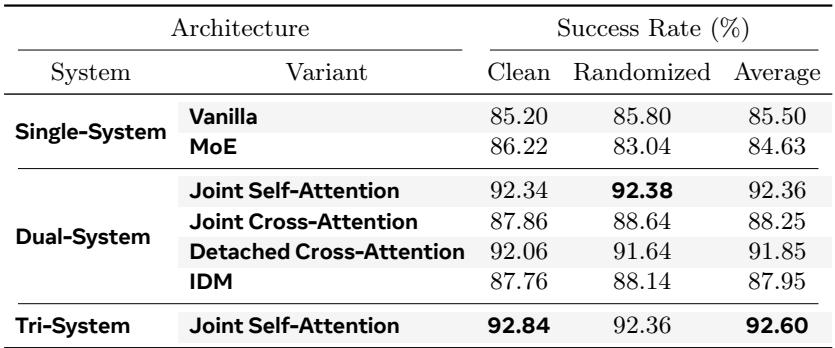
架构消融研究评估了单系统、双系统和三系统变体,表明性能随架构容量增加而提升。在双系统变体中,联合自注意力表现最佳,而三系统模型取得了最高的总体成功率。双系统联合自注意力被选用于后续实验,以平衡性能与复杂度。性能从单系统到双系统再到三系统架构持续提升。联合自注意力是最强的双系统变体,优于联合交叉注意力和分离交叉注意力。三系统模型取得了最佳总体成功率,但后续实验选择了双系统联合自注意力。
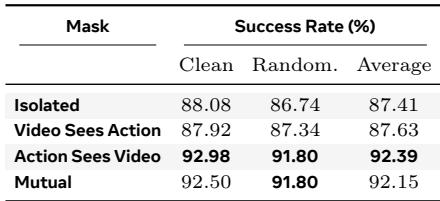
该表比较了训练期间世界流与动作流之间信息流的四种注意力掩蔽策略。允许动作流访问世界特征的策略比不允许的策略取得了显著更高的成功率,而反向流动的额外影响很小。隔离掩码和视频可见动作掩码比向动作流暴露世界特征的掩码低约五个百分点。动作可见视频和互见掩码取得了相近的强劲成功率,其中动作可见视频在干净和平均指标上略占优势。增加动作到世界路径(互见)相对于动作可见视频仅带来微小变化,表明世界到动作的信息流才是关键方向。
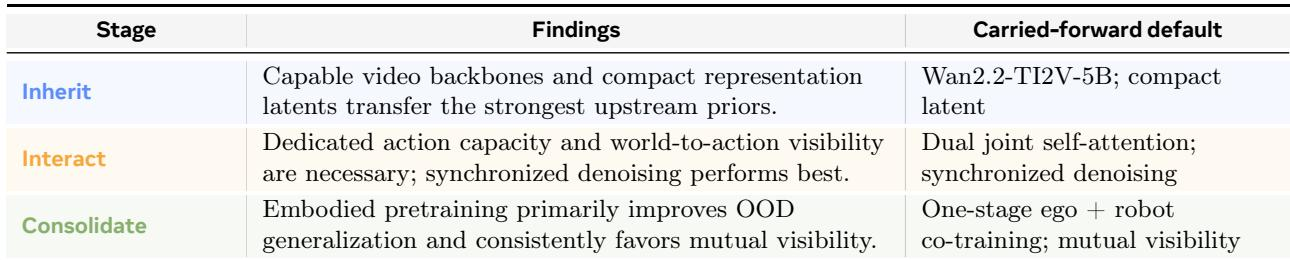
该表概述了从系统研究中得出的 OpenWAM-α 设计选择。它表明,继承具有紧凑潜表示的有能力视频骨干网络、使用带同步去噪的专用动作流,以及在联合训练期间采用互见模式,是带来强劲性能的关键组件。具有紧凑潜表示的有能力视频骨干网络是首选起点。带世界到动作可见性和同步去噪的专用动作流是必要的。带互见模式的具身预训练提升了域外泛化能力。
OpenWAM-α 在精选的多域数据集上预训练,该数据集结合了第一人称人类视频、真实机器人数据和合成机器人数据,通过清洗和子采样将约 13.3 亿帧的原始数据池缩减至 5.18 亿帧。混合数据通过比例采样平衡各来源,其中最大的份额来自第一人称人类视频和仿真数据,而真实机器人来源贡献了较小但有意义的部分。预训练数据涵盖三种数据类型:第一人称人类视频、真实机器人示范和合成机器人数据。筛选和各来源子采样将原始数据集从约 14,300 小时缩减至约 6,400 小时。第一人称人类视频和仿真数据各占最终训练份额的约 30%,真实机器人来源合计贡献其余 40%。数据覆盖了不同来源下的单臂、双臂、移动和灵巧手操作场景。最终训练集包含 21 种不同具身,结合了人类和机器人具身。
OpenWAM-α 在大多数基准上达到顶尖性能,在移动双臂 EBench 上刷新了最优结果,同时在单臂和双臂任务上与领先 VLA 保持竞争力。它还展示了在未见具身(如灵巧手)上的强泛化能力,优于代表性 VLA 基线。OpenWAM-α 在移动双臂基准上以约 4 分的优势领先第二名(成功率和得分均如此)。在具有 clean-to-random 和真实机器人设置的双手基准上,OpenWAM-α 是最强的世界-动作模型,但 VLA 仍占据榜首。在具有未见具身的灵巧手任务上,OpenWAM-α 在所有任务和设置上以明显优势优于代表性 VLA。
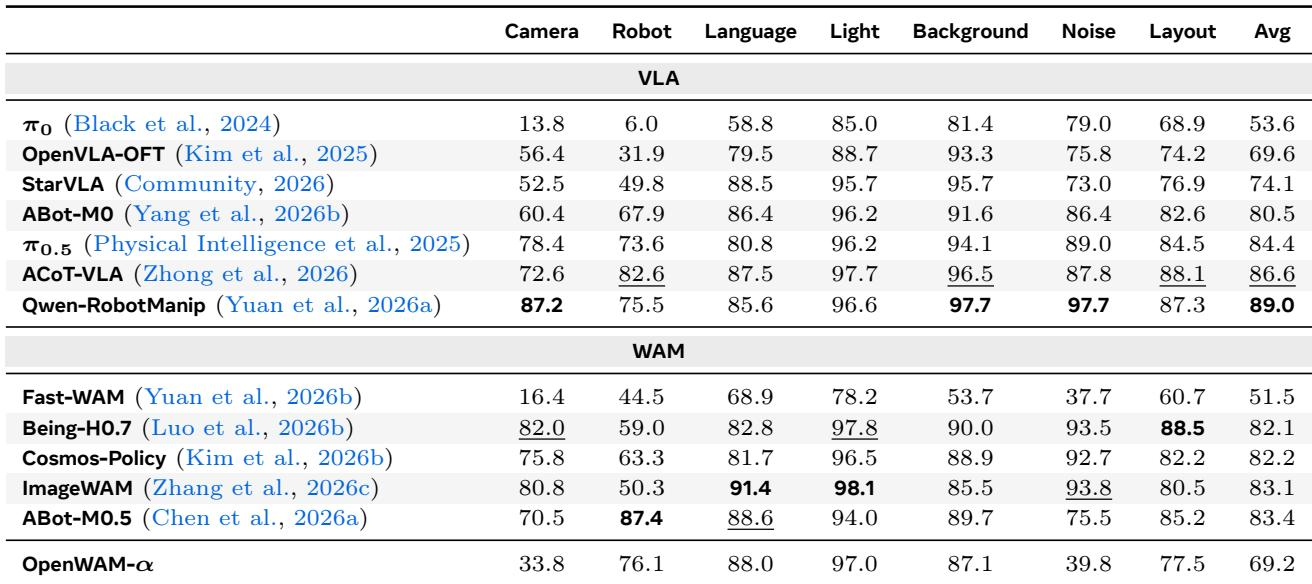
消融研究表明,性能从单系统到双系统再到三系统架构持续提升,联合自注意力是最强的双系统变体,但最终以双系统联合自注意力替代三系统模型以平衡复杂度。掩蔽实验表明,允许动作流访问世界特征是关键的信息流方向,动作可见视频和互见掩码表现相近,且远优于阻断该方向的策略。最终的 OpenWAM-α 设计结合了具有紧凑潜表示的有能力视频骨干网络、带同步去噪的专用动作流,以及联合训练期间的互见模式,在精选的多域数据集(第一人称人类视频、真实机器人和合成数据)上预训练。在各基准上,OpenWAM-α 在移动双臂任务上刷新了最优结果,在单臂和双臂设置上与领先 VLA 保持竞争力,并展示了在灵巧手等未见具身上的强泛化能力。