Command Palette
Search for a command to run...
SpatialBlock:通过合成积木堆叠问题增强大视觉语言模型的空间智能
SpatialBlock:通过合成积木堆叠问题增强大视觉语言模型的空间智能
Soohyun Ryu Sohee Kim Eunho Yang
摘要
大视觉语言模型(LVLMs)在多种视觉任务上取得了强劲的性能,但其从二维图像中重建并推理场景三维结构的能力——即空间智能——仍然有限。现有方法试图通过使用需要密集几何标注的真实场景空间问答数据集来弥补这一差距。然而,构建此类标签成本高昂、耗时,且因依赖外部感知模块而常常包含噪声。在本工作中,我们受人类认知发展启发,提出了一种新范式:通过结构化的积木操作任务来学习基础空间技能。我们引入了 SpatialBlock-15k,一个包含 15,000 个积木堆叠问题的合成数据集,涵盖三维到二维投影、视角变换和结构组合。该数据集进一步融入受控的颜色调制作为视觉线索,以鼓励在视觉复杂条件下的锚点推理。实验表明,尽管我们的数据集具有合成性和紧凑性,但通过直接回答或基于推理的预测方式在该数据集上训练的 LVLMs 显著优于基线模型,并能泛化到真实世界的空间任务。代码和数据可在 https://github.com/rsoohyun/SpatialBlock 获取。
一句话总结
受人类认知发展启发,KAIST 与 AITRICS 的研究人员提出 SpatialBlock-15k,一个包含 15,000 个积木堆叠问题的合成数据集,通过受控颜色调制训练 LVLM 掌握 3D 到 2D 投影、视角变换和结构组合,使其显著超越基线并泛化到真实世界空间任务,尽管数据集本身为合成性质。
核心贡献
- 一种新视角,从依赖密集标注的真实场景监督转向通过结构化合成任务学习基础空间技能。
- 提出 SpatialBlock-15k,一个可扩展的合成数据集,涵盖 3D 到 2D 投影、视角变换和结构组合的积木堆叠问题,并引入受控颜色线索以促进基于锚点的推理。
- 在 SpatialBlock-15k 上通过直接回答(SpatialBlock-direct)或基于推理的预测(SpatialBlock-reason)训练 LVLM,能显著提升空间推理能力并泛化到真实场景,超越现有空间专家模型。
引言
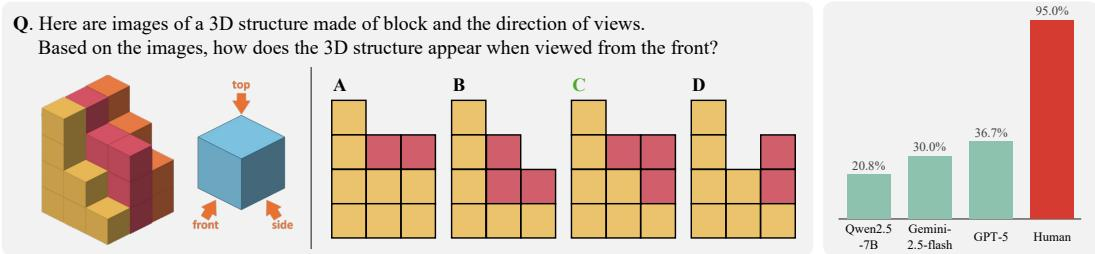
大型视觉语言模型(LVLM)在 2D 图像理解方面表现出色,但在空间智能上存在困难,即从 2D 视图在脑中重建 3D 结构的能力。这一差距限制了它们在需要稳健空间推理的机器人和自动驾驶中的应用。此前尝试解决该问题的方法要么在模型架构中添加专用 3D 模块,要么设计空间推理任务,但两条路径都依赖真实场景数据集,这些数据集需要外部模块提供密集、昂贵且常带噪声的几何标注。作者们打破这一标注密集的范式,从人类发展中获得灵感,积木游戏能构建基础空间技能。他们提出 SpatialBlock-15k,一个完全合成的积木堆叠问题数据集,涵盖 3D 到 2D 投影、视角变换和结构组合,并辅以受控颜色线索以促进基于锚点的推理。在此紧凑的合成数据集上训练 LVLM 能显著提升空间推理能力,并有效迁移到真实场景,为真实场景监督提供了一种可扩展且干净的替代方案。
数据集
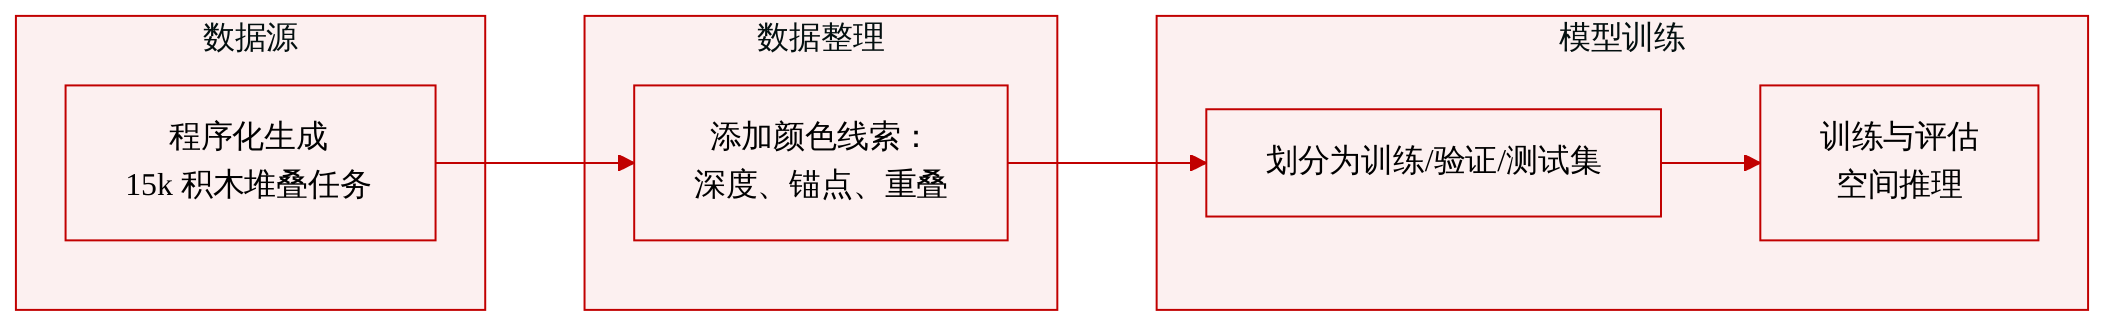
作者提出 SpatialBlock-15k,一个完全合成的 15,000 个积木堆叠问题数据集,旨在评估和提升大型视觉语言模型(LVLM)的空间推理能力。该数据集摆脱了依赖密集标注的真实场景 3D 标签,通过程序化生成任务来探测核心空间能力:空间组合、心理模拟和空间整合。
数据集组成与来源
- 数据集完全由程序生成,不使用真实世界图像或人工标注。
- 包含三种问题类型,每种 5,000 个样本。每个样本将颜色作为功能性视觉线索,而非仅仅是装饰性变化。
各子集关键细节
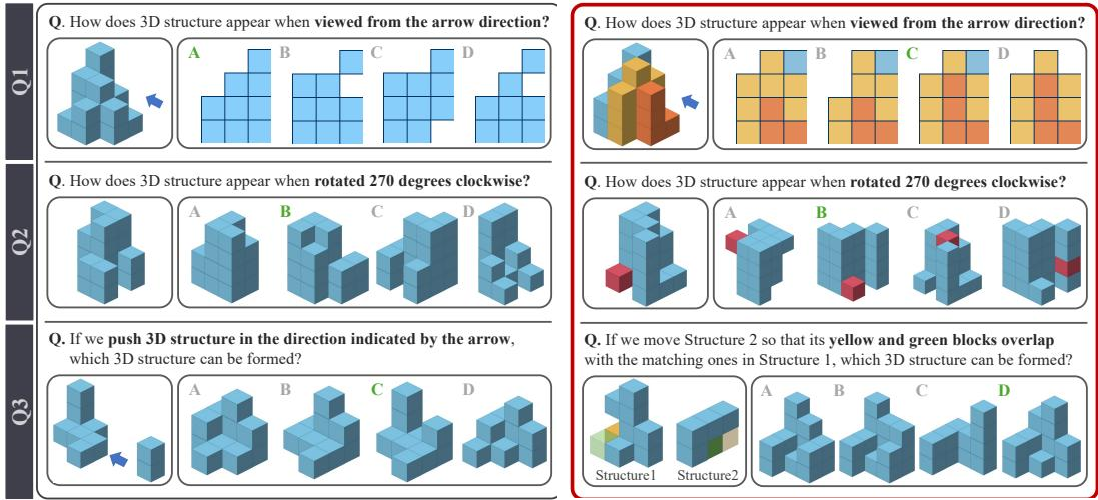
- Q1:带深度线索的 3D 到 2D 投影 – 颜色编码给定视角下的深度顺序。模型需预测 2D 外观,要求其重建 3D 结构、进行心理旋转,并利用颜色作为显式深度指示来解决遮挡。
- Q2:带锚点积木的视角变换 – 一个积木被赋予独特颜色作为锚点。模型必须在自旋转或视角变化下保持锚点的结构角色以及所有积木的相对位置。
- Q3:带重叠积木的结构组合 – 两个结构以独立图像展示;附着位置由重叠的彩色积木(透明区域)指示。颜色充当共享参考点,迫使模型跨图像对齐同色积木并推断组合后的全局结构。
论文如何使用数据
- 数据集为训练和评估 LVLM 的空间推理提供了结构化框架。段落未明确说明训练/测试划分;可能用作微调的训练语料,或作为衡量空间智能提升的基准。
处理与构建细节
- 所有问题均基于积木堆叠配置,要求理解被遮挡的积木、模拟变换以及整合组件。
- 颜色根据任务特定规则应用:Q1 采用基于深度的着色,Q2 使用单一锚点颜色,Q3 为重叠区域匹配颜色。这一设计鼓励模型将视觉线索作为关系推理的参考点,类似于人类利用显著对象解释复杂场景的方式。
方法
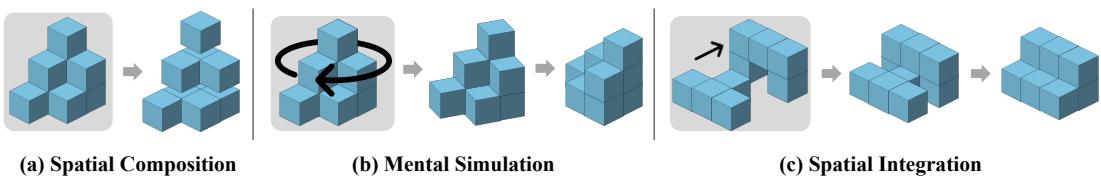
为培养大型视觉语言模型(LVLM)的空间智能,作者提出一个基于积木堆叠问题的框架,这些问题需要结构化的空间理解。如下图所示,解决这些问题需要核心空间能力:(a) 空间组合,从可见配置重建完整 3D 结构;(b) 心理模拟,预测变换的结果;(c) 空间整合,预测组合多个组件时的结果。
基于这些能力,作者定义了三种针对空间推理不同方面的问题类型,并进一步扩展视觉线索以模拟真实世界的复杂性。有关这些任务的示例,包括 3D 到 2D 投影、视角变换和结构组合,以及有无基于颜色的功能性引导(用于深度排序和锚点相对关系),请参考框架图。
为在这些任务上训练 LVLM,作者提出两种针对模型能力不同方面的训练策略:直接答案预测和基于推理的预测。
对于直接答案预测模型,作者专注于通过将视觉输入直接映射到对应答案来培养快速推理能力。给定文本查询 q 和图像 v,模型参数 θ 通过最小化标准交叉熵损失来优化,以预测下一个 token yi,给定前文 y(1:i−1):
Lce(θ)=−i∑logP(yi∣y(1:i−1),q,v).该策略直接优化答案精度,为高保真空间问题求解奠定基础。
对于基于推理的预测模型,作者使模型能够表达其内部逻辑路径。为确保坚实基础,首先使用低秩适应(LoRA)而非全参数微调来初始化模型,这保留了模型固有的思维链推理能力,避免了使用大型教师模型合成轨迹的冷启动阶段,这些轨迹在这些空间任务上通常准确率较低。
在基于 LoRA 的初始化之后,通过群体相对策略优化(GRPO)使用强化学习优化模型。作者设计了一个多目标奖励函数来评估响应正确性和推理轨迹质量:
R(y,o)=Racc(y,o)+Rformat(o)+Rlen(o),其中 o 是模型对问题 c=(q,v) 生成的预测,真实答案为 y。准确率奖励 Racc 验证最终答案是否与 y 匹配。格式奖励 Rformat 强制要求所需结构,最终答案包含在特定标签中。长度奖励 Rlen 确保响应长度 L 满足 50<L<1024。所有组件均实现为二元奖励。
基于此奖励,对于每个问题 c,旧策略模型 πθold 采样一组候选响应 {o1,o2,...,oG}。每个响应 oi 获得奖励 ri=R(y,oi),从中计算优势 Ai。然后通过最大化 GRPO 目标来更新模型:
JGRPO(θ)=Ec,{oi}[G1i=1∑Gmin(πθold(oi∣c)πθ(oi∣c)Ai,clip(πθold(oi∣c)πθ(oi∣c),1±ε)Ai)−βKL[πθ∣∣πref]],其中 ε 和 β 是超参数,KL[πθ∣∣πref] 是策略模型与参考模型之间的 KL 散度。
实验
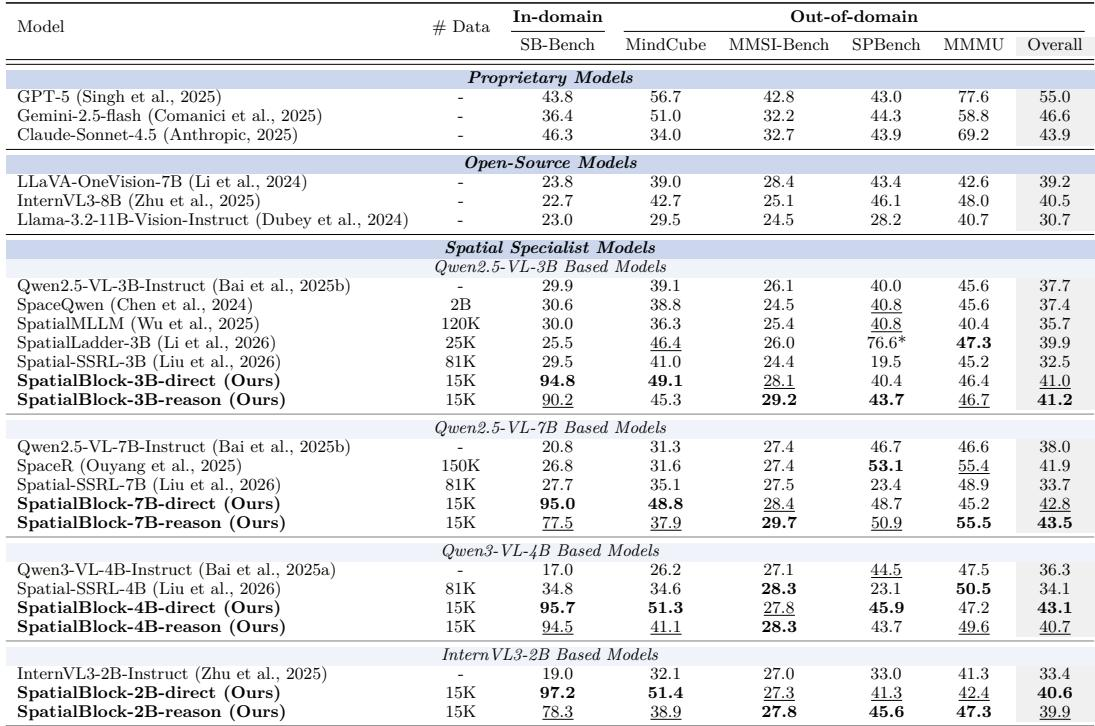
评估在合成数据集 SpatialBlock-15k 上微调视觉语言模型,并在域内和真实场景空间推理基准上测试。直接模型改进了心理旋转和视角任务,而推理增强变体能更好地处理复杂的多图像推理,所有模型均未降低通用视觉理解能力。消融实验揭示,互补的问题类型组合、基于颜色的视觉线索以及积木堆叠任务设计对稳健性能至关重要,且该形式化比传统空间问题格式产生更具迁移性的空间推理。
仅在 15K 合成积木堆叠样本上训练,模型就能在真实场景基准上超越现有空间专家模型,推理变体在复杂逻辑推理上表现优异,直接变体在心理模拟任务上取得最佳开源性能。专有模型仍然挣扎,域内准确率低于 47%,而积木堆叠任务比传统空间问题类型更有效地实现域外泛化。该方法还保持了通用视觉理解能力,MMMU 分数保持稳定。GPT-5 在专有模型中总体得分领先,但所有专有模型在域内基准上均未达到 47%。SpatialBlock-direct 模型在 MindCube 上带来大幅提升,4B 变体比其骨干网络提高 25.1%,达到 51.3%,为最佳开源结果。推理增强模型在 MMSI-Bench 上仅使用 15K 合成训练样本即超越 SpaceR 和 Spatial-SSRL。积木堆叠合成数据比传统的相对方向和距离问题更好地泛化到域外空间基准。未使用真实场景图像训练的模型保持稳定的 MMMU 性能,表明通用视觉理解未退化。
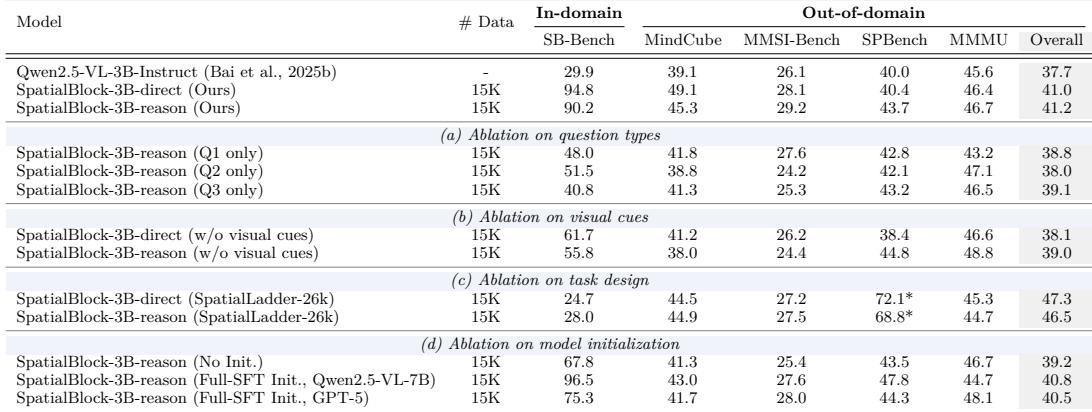
消融实验表明,积木堆叠任务设计、在所有三种互补问题类型上训练、基于颜色的视觉线索以及基于 LoRA 的初始化各自对稳健空间推理有贡献。移除任何组件都会降低性能,仅使用单一问题类型或省略视觉线索时下降最大。这些发现凸显了多样化空间监督、任务特定设计以及有效模型初始化对泛化的重要性。组合所有三种问题类型获得最高总体准确率(41.2),而单一类型变体降至 38.8 和 38.0,表明互补的空间监督。移除颜色视觉线索使直接模型在 MindCube 上的准确率最多下降 7.9 个百分点,推理模型下降 7.3 个百分点,强调其在复杂场景理解中的作用。所提出的积木堆叠任务设计在域外基准上优于替代空间 QA 数据集,证实任务形式化驱动泛化超越域内数据。
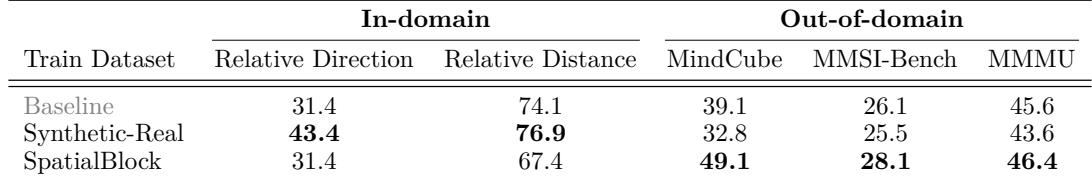
在 Synthetic-Real 上训练提高域内准确率,但损害大多数域外基准,而 SpatialBlock 保持域内性能并增强了四个域外数据集中的三个的泛化能力。这表明积木堆叠任务比传统相对方向和距离问题产生更具迁移性的空间推理。Synthetic-Real 大幅提升域内准确率,但相比基线降低了 Relative Distance、MindCube 和 MMMU 的性能。SpatialBlock 与基线域内准确率持平,并在 Relative Distance、MindCube 和 MMMU 上有所提升,仅在 Relative Direction 上略有下降。SpatialBlock 在三种训练条件中取得最高的总体域外准确率。
仅使用 15K 合成积木堆叠样本,该方法在真实场景基准上超越现有空间专家模型,推理变体擅长逻辑推理,直接变体在心理模拟上取得最佳开源结果。消融实验确认,组合三种互补问题类型、基于颜色的视觉线索以及 LoRA 初始化对稳健空间推理至关重要,且积木堆叠任务比传统相对方向问题更好地泛化到域外基准。尽管专有模型在域内准确率仍低于 47%,该方法保持了通用视觉理解能力,证明任务特定的合成数据能有效迁移到真实世界空间推理。