Command Palette
Search for a command to run...
持续学习机制组合用于长时程记忆
持续学习机制组合用于长时程记忆
Zheyuan Zhang Alvin Zhang Daniel Khashabi Tianmin Shu
摘要
语言模型可能需要内化随时间到达的信息,并在多次后续更新中保留这些信息。为了研究这一挑战,我们引入了长时程记忆(long-horizon memorization)这一设置,其中模型通过持续的有监督微调学习100个查询-答案任务,而不保留早期的训练示例或在推理时接收任务标识符。顺序更新会导致灾难性遗忘,而我们评估的单一持续学习机制中,没有一种能够在该时间跨度上保持较强的记忆保持能力。我们假设,针对互补遗忘来源的机制在组合使用时将更加有效。我们沿着两个设计维度组织这些组合。数据锚、函数锚和权重锚指定了每次更新应保留的先前信息,而低秩分配规则决定了后续更新在何处被保留。为了系统地检验这一假设,我们构建了三个不同的100任务记忆数据集。我们引入了任务级连续减半(task-level successive halving)来搜索组合设计空间,并使用因子实验来测量个体效应和交互效应。我们最好的方法结合了三种锚与合并的LoRA,在所有数据集中排名前三,并将平均最终保留率从朴素顺序微调下的1.2%提高到34.9%,提升了28倍。数据锚和合并的LoRA提供了最大的平均增益,并在所有三个数据集上表现出超加性交互。总之,这些结果表明,组合互补机制显著超越了任何单一机制所能达到的长时程记忆效果。
一句话总结
约翰霍普金斯大学的研究人员提出了长期记忆(long-horizon memorization)这一概念,即语言模型通过持续监督微调学习100个查询-答案任务,并证明将数据锚、函数锚和权重锚与合并LoRA组合,同时使用任务级逐次减半进行搜索,可将平均最终保留率从朴素顺序微调下的1.2%提升至34.9%,实现28倍的改进。其中数据锚与合并LoRA贡献了最大的平均增益,并在全部三个数据集上表现出超加性交互,从而在记忆效果上显著超越任何单一机制。
核心贡献
- 提出长期记忆(long-horizon memorization)作为一个不包含任务标识符的100任务持续监督微调设定,并构建了三个自然度递增的新型查询-答案数据集,用于研究语言模型中的知识保留。
- 将持续学习机制归纳为数据、函数和权重三类锚,并与合并LoRA组合,使用任务级逐次减半及因子实验对组合设计空间进行系统搜索与评估。
- 实验表明,将三类锚与合并LoRA全部组合的最优方法在全部数据集上均位列前三,将平均最终保留率从朴素顺序微调下的1.2%提升至34.9%,实现28倍改进,且数据锚与合并LoRA之间存在超加性交互。
引言
语言模型在从新数据中顺序学习时面临核心挑战:当参数为新任务更新时,可能覆盖先前获得的知识,从而导致灾难性遗忘。这一问题被称为长期记忆(long-horizon memorization),在持续监督微调中尤为突出,因为模型必须在推理时无法访问原始样本或任务标识符的情况下,保留来自数百个历史任务的关联信息。先前的方案(如基于蒸馏的重放)已展现出一定潜力,但尚未系统探索不同记忆保留机制之间的交互。现有基准的局限也使评估更加复杂;这些基准往往侧重于跨异构任务的迁移或针对性编辑,而非对连续多个任务中事实的持续回忆。
作者通过提出一个用于组合机制的结构化设计空间来解决该问题,该空间沿两个维度组织:锚(anchors),用于指定保留哪些先前信息(通过数据、函数或权重正则化);以及低秩分配规则,用于决定LoRA更新如何在任务间存储(共享式或合并式)。为验证其组合假设,作者引入了三个新的100任务数据集和一种因子实验方法。其主要贡献在于证明将三种锚与合并LoRA相结合能显著提高保留效果,将平均最终准确率从朴素微调下的1.2%提升至100个任务后的34.9%,实现28倍增益,并优于所有单一机制。分析进一步表明,数据锚与合并LoRA是最大的贡献因素,且二者之间存在超加性交互。
数据集
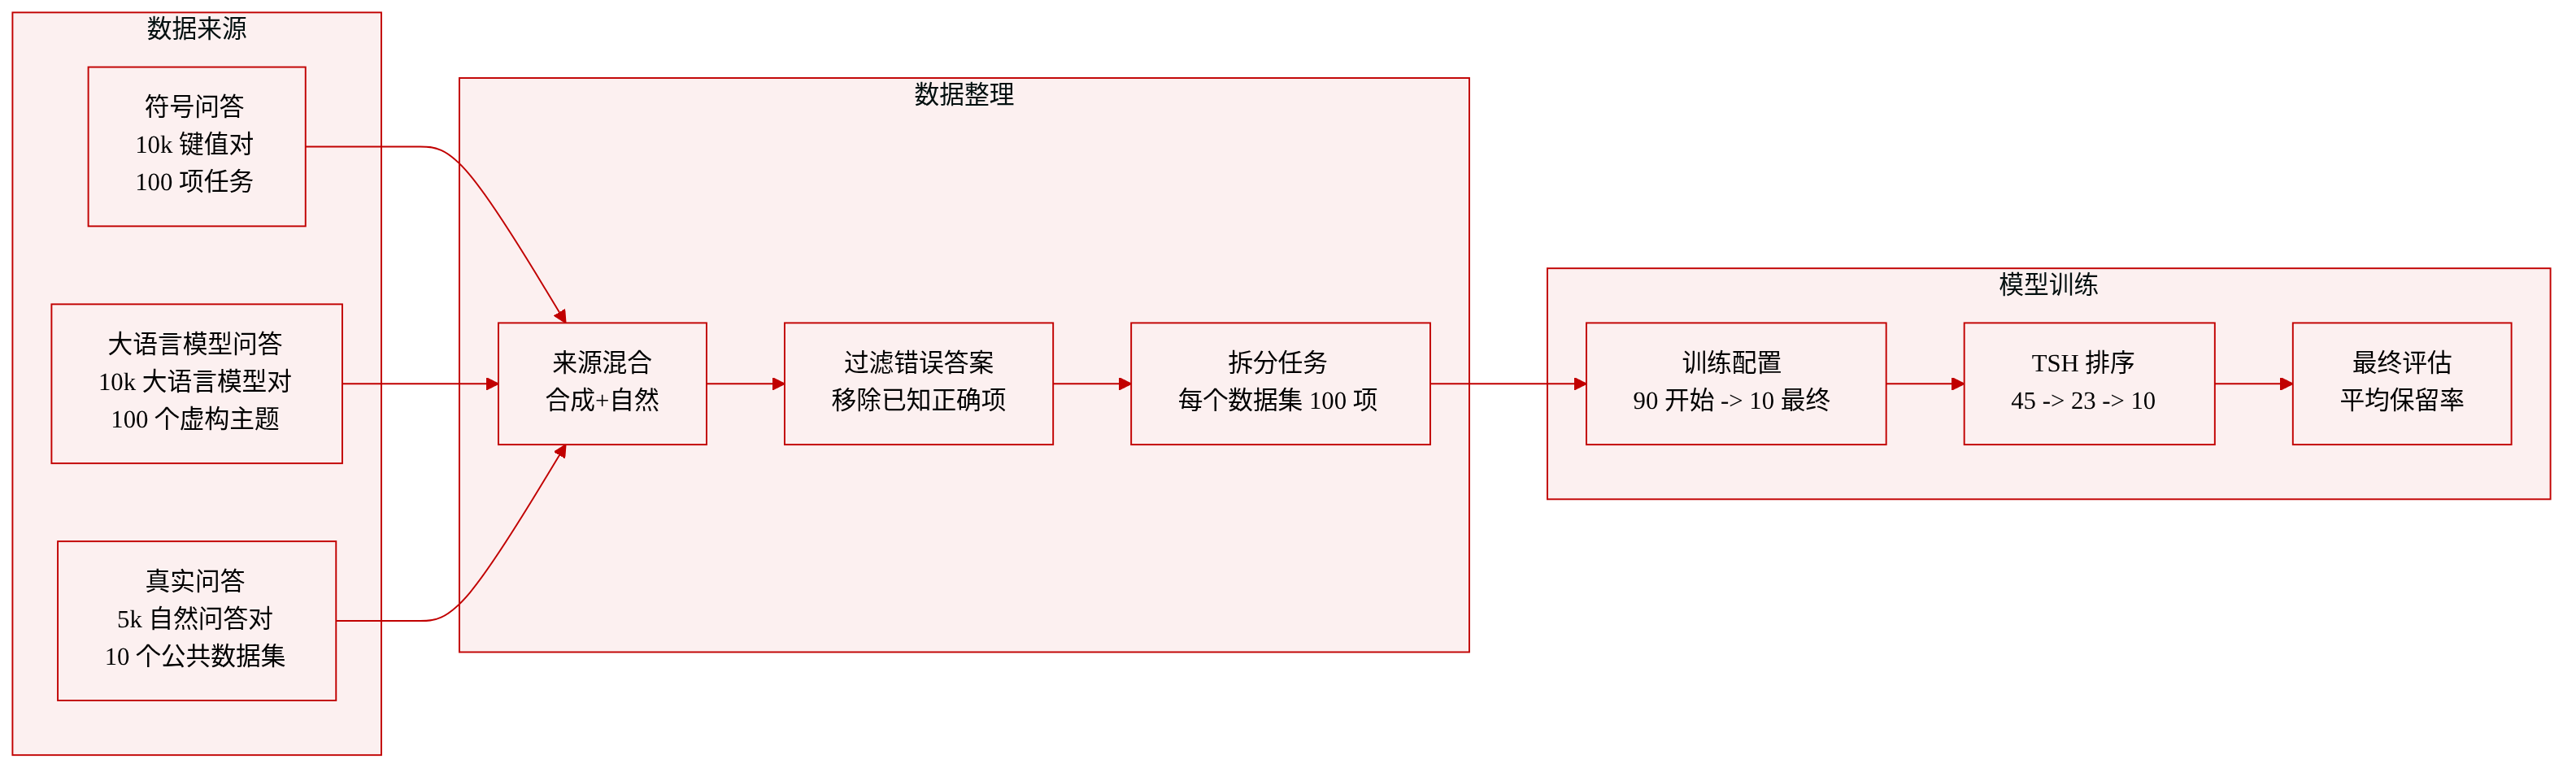
作者构建了三个语义真实性递增的记忆数据集,每个数据集均用于评估模型在顺序任务中对特定知识的保留能力。
-
数据集构成与来源:
- Symbol-QA: 10,000条随机键值关联,包含100个任务,每个任务100个样本。
- LLM-QA: 由大语言模型在100个虚构主题下生成的10,000条查询-答案对,同样包含100个任务,每个任务100个样本。对于这两个合成数据集,每个查询在所有任务中均唯一对应一个目标答案。
- Real-QA: 来自十个公开QA数据集的5,000条自然查询-答案对,经过筛选以排除模型在五次采样补全中任一运行下能正确回答的样本。该子集包含100个任务,每个任务50个样本。
-
筛选与构建细节:
- Real-QA通过移除模型已能正确回答的查询进行过滤,确保数据集聚焦于对新的、此前回答错误的信息的记忆。
- 所有数据集的来源列表及完整构建流程见附录C,方法定义与实验设置见附录B.1至B.8。
-
在模型搜索中的使用:
- 作者使用这些数据集对持续学习方法的组合设计空间进行搜索。完整搜索空间包含90种配置,涵盖锚类别(如在线EWC、SI)与低秩分配规则(共享LoRA、合并LoRA)、自蒸馏损失权重以及重放设置(不同的损失权重与生成温度)的交叉组合。
- 为控制计算成本,作者采用任务级逐次减半(TSH)。从全部90种配置出发,在10个任务后保留前45种,20个任务后保留前23种,50个任务后保留前10种,这些配置继续运行至全部100个任务。
- 每种配置按训练种子上的平均最终保留率评分,并使用固定任务顺序(开发任务顺序)以将训练随机性与任务顺序敏感性分离。
- TSH的早期排名与最终100任务评估结果高度一致,尽管使用了不同的任务顺序,这支持了该搜索策略的高效性。
-
处理与元数据:
- 除被变化的组件外,所有优化设置均保持固定,完整设置见附录B.8。
- 资源统计与排名比较分别见附录D.1与D.5。
方法
3. 组合持续学习机制
作者针对自回归语言模型的长期持续监督微调(SFT)问题展开研究。在每个任务中,模型接收一个新的监督数据集并继承先前的模型状态,但无法保留或重新访问早期任务的原始训练样本。核心目标将当前任务的SFT损失与三种互补的保留机制相结合,每种机制针对学习系统中不同层面。
3.1. 通过持续SFT实现长期记忆
给定依次到达的T个任务序列,由Θ参数化的模型在任务t上使用当前任务数据Dt的标准SFT目标进行训练:
LSFTt(Θ)=−E(x,y)∼Dt[logpΘ(x,y)].作者在损失计算中不对查询token进行掩码,因为在测试时训练等实际应用中,区分查询与答案较为困难。任务t的完整目标将SFT损失与三个正则化项相结合:
Θt=ΘargminLSFTt(Θ)+RDt(Θ)+RFt(Θ)+RWt(Θ),其中RDt、RFt和RWt分别对应数据锚、函数锚和权重锚。这些锚提供互补的约束:数据锚重放过去的信息,函数锚强制当前输入上的输出一致性,权重锚则惩罚重要参数的变化。作者还引入了低秩分配规则,用于决定每个任务更新哪些参数以及如何将学习到的更新延续到后续任务中。
3.2. 三种锚
数据锚。 数据锚重放代表早期任务的序列。令Qt−1表示重放序列的分布,ℓD(Θ,z)表示对采样序列z施加的损失。数据保留项的形式为:
RDt(Θ)=Ez∼Qt−1[ℓD(Θ,z)].作者不存储原始样本,而是使用先前模型的冻结副本,从单一的任务无关重放token生成伪序列。在第一个任务之后的每个任务开始前,作者生成固定数量的序列并丢弃空输出。训练过程中,每个当前任务小批量与一个重放小批量配对使用。重放权重用于平衡当前任务损失与重放损失,而生成温度控制重放采样的随机性;两者均通过后文所述的任务级逐次减半过程进行调优。此外,冻结模型为重放序列提供软化的下一token目标,这些目标仅在学习当前任务期间使用。
函数锚。 函数锚通过将当前模型在当前任务输入上的预测与参考分布进行比较来施加约束。令μt表示当前任务输入的分布,qt−1(⋅∣x)表示输入x的参考分布,d表示散度度量。保留项为:
RFt(Θ)=Ex∼μt[d(qt−1(⋅∣x),pΘ(⋅∣x))].在实现中,作者使用先前模型定义参考分布,遵循无遗忘学习(Learning without Forgetting)范式。该自蒸馏目标仅适用于当前任务数据,而数据锚则将软目标应用于生成的重放序列。因此两种锚是互补的:函数锚限制模型在新数据上的行为变化,数据锚则提醒模型旧数据的存在。
权重锚。 权重锚根据模型参数对先前学习行为的重要性累积来约束参数更新。令ϑ表示被跟踪的参数,ϑt−1⋆表示其在任务t之前的取值,Ht−1为半正定重要性矩阵。其一般形式为:
RWt(Θ)=21(ϑ−ϑt−1⋆)⊤Ht−1(ϑ−ϑt−1⋆),Ht−1⪰0.该二次惩罚是多种经典持续学习方法的推广。EWC对每个先前任务分别施加该惩罚,并使用对角Fisher信息作为重要性权重。在线EWC维护一个以最新参数为中心的运行Fisher矩阵,避免惩罚项数量不断增长。SI则根据优化轨迹上累积的贡献估计重要性。作者将在线EWC和SI视为权重锚的实例化,具体估计器作为配置选项。
3.3. 低秩分配
锚约束了更新方向,但低秩分配规则决定了每个任务更新哪些参数以及如何保留学习到的更新。对于预训练权重矩阵W0,LoRA将更新参数化为ρBA,其中A∈Rr×din,B∈Rdout×r,ρ=αLoRA/r。令At和Bt表示任务t期间优化的LoRA矩阵,上标⋆表示训练后的取值。作者考虑两种在任务间延续这些矩阵的方式:
Wt={W0+ρBtAt,Wt−1+ρBtAt,shared LoRA,merged LoRA.共享LoRA 在所有任务中持续优化同一对矩阵A和B,因此BtAt表示学习任务1至t后的单一完整LoRA适配器。合并LoRA 为每个任务分配一对新的LoRA矩阵。在任务t结束后,将ρBt⋆At⋆折叠进稠密权重矩阵Wt−1,然后为下一个任务初始化一对新的LoRA矩阵(以及新的优化器状态)。该方法将ReLoRA的合并再初始化模式适配到持续学习场景。两种方法均保留单一稠密模型及每个被适配权重矩阵对应的一对LoRA,因此随着任务数量增长,保留状态大小保持不变。这一常数内存特性使其区别于O-LoRA或顺序OSRM等方法,后者的状态随任务数量增长而增加。
4.3. 搜索组合设计空间
将三类锚与两种低秩分配规则交叉组合,会产生一个庞大的持续学习方法组合空间。在全部任务上评估所有组合在计算上不可行,而短时程评估可能无法可靠预测长时程性能。作者引入了任务级逐次减半(TSH)来解决这一权衡。
与标准逐次减半(将递增的训练迭代分配给有潜力的超参数)不同,TSH增加顺序任务的数量,并根据每个任务时程上的保留率对配置进行剪枝。令A1表示初始候选集,S表示训练种子集合。对于配置a∈A1和种子s∈S,定义时间准确率矩阵Mi,ja,s,其中Mi,ja,s表示学习任务1至i后任务j上的准确率。所有种子共享相同的任务顺序,因此对S取平均可捕捉训练随机性但不含任务顺序敏感性。在r个任务之后,每种配置按其平均最终保留率评分:
Fr(a)=∣S∣1s∈S∑r1j=1∑rMr,ja,s.初始候选集由锚选项与分配规则的笛卡尔积构成:
A1={∅,online EWC, SI}×{∅,SD1,SD2}×{∅,Replay1,…,Replay4}×{shared LoRA, merged LoRA},其中∅表示该锚不存在,SD1和SD2分别使用自蒸馏损失权重1和3,重放变体枚举了重放损失权重{0.5,0.75}与生成温度{1.0,1.5}的笛卡尔积。由此得到n1=3×3×5×2=90种初始配置。
从全部90种配置出发,TSH在10个任务后保留前45种,20个任务后保留前23种,50个任务后保留前10种。最终这10种配置继续运行至全部100个任务。作者验证了10任务时程上的排名与两个阶段均被评估的配置在100任务最终排名上具有高度一致性,这表明尽管使用了不同的任务顺序,早期剪枝仍能识别出最有潜力的组合。
实验
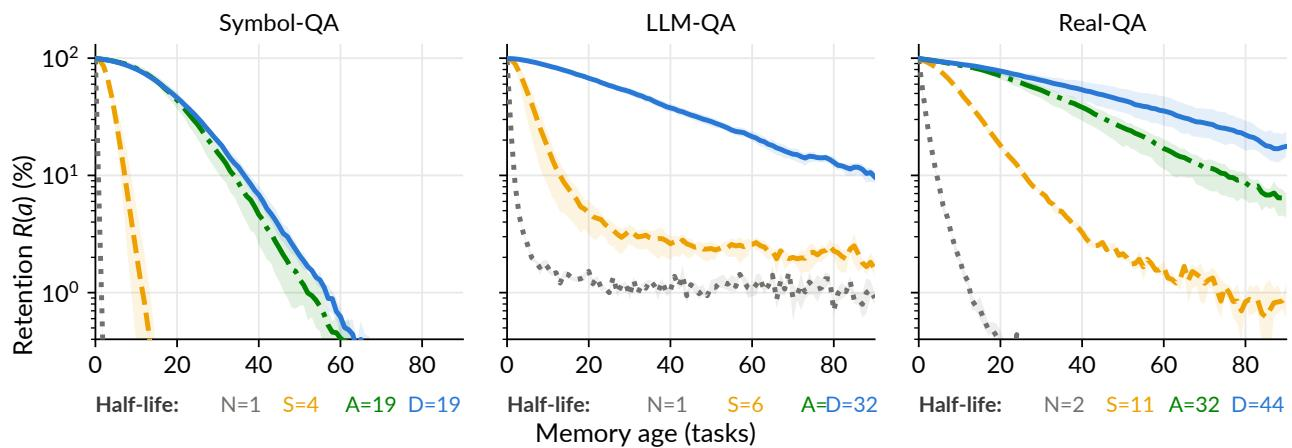
评估使用三个语义真实性递增的数据集(Symbol-QA、LLM-QA、Real-QA),在包含100个任务的域增量协议下进行,衡量最终保留率、即时获取率和遗忘程度。对90种方法组合进行任务级逐次减半搜索后发现,没有任何单一机制能通过50任务阶段,而所有表现最佳的组合均将数据锚与合并LoRA相结合,最优方法还包含权重锚。在完整的因子评估中,组合方法显著优于单一机制,结合三种锚与合并LoRA的最优方法在全部数据集上取得了最高的平均最终保留率(34.9%)。重放与合并LoRA产生了最大的主效应和强协同交互,而权重锚与函数锚(SI和SD)带来较小且依赖数据集的增益;将合并LoRA替换为任务增长型替代方案(O-LoRA或顺序OSRM)并未稳定提升保留率,且常常降低通用能力。记忆半衰期分析表明,组合方法能延缓遗忘(从朴素微调的1-2个任务延迟至最强组合的19-44个任务),但无法完全阻止最终的记忆丧失。
重放与合并LoRA是主导机制,在所有数据集上均表现出最大的主效应以及正向且统计显著的交互,其组合增益远超各自效应之和。SI和SD提供依赖数据集的收益,SD的正向主效应在存在重放时有时会减弱,而SI在Symbol-QA上无效果且在该数据集上与合并LoRA存在负向交互。重放与合并LoRA在全部数据集上始终提供最大的平均保留增益。重放与合并LoRA之间的交互为正向且显著,产生超加性的保留改进。SD在所有数据集上均有正向主效应,但在两个数据集上当重放已激活时其收益会减弱。SI在自然语言数据集上呈现正向主效应,但在Symbol-QA上无可检测效果,并在Symbol-QA上与合并LoRA存在负向交互。
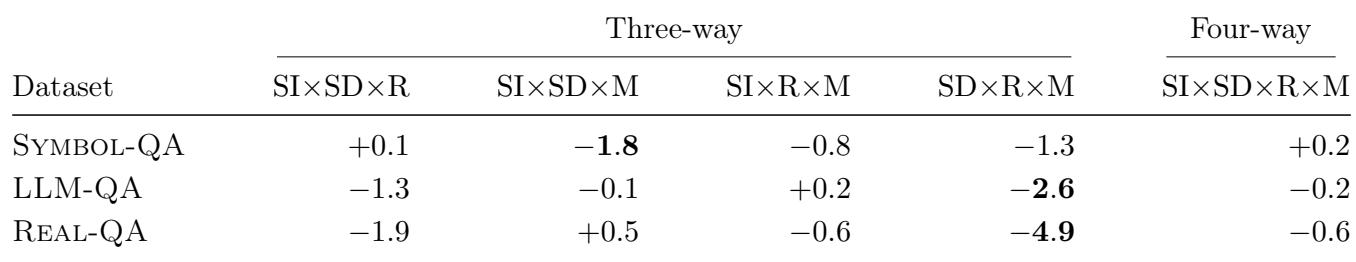
该评估在多个数据集上测试重放、合并LoRA、SI和SD,以衡量其对保留率的单独及交互影响。重放与合并LoRA是最强的机制,展现出较大的正向主效应和显著的超加性交互,因此两者组合带来的保留增益远超单独效应之和。SD提供一致但较小的收益,尽管在重放已存在时其效果常常减弱。SI在自然语言数据集上有帮助,但在Symbol-QA上无明显收益,且在该数据集上甚至可能与合并LoRA产生干扰。总体而言,研究结果表明重放加合并LoRA是最有效的策略,SD作为有用的备选方案,而SI更适合用于语言密集型任务。