Command Palette
Search for a command to run...
DataFlex-RL:面向 RLVR 数据策略的评估平台
DataFlex-RL:面向 RLVR 数据策略的评估平台
Hao Liang Mingrui Chen Hengyi Feng Meiyi Qiang Wentao Zhang
摘要
基于可验证奖励的强化学习(RLVR)的数据策略会改变所使用的 rollout、其加权强度或提供下一批数据的领域。我们引入了 DataFlex-RL,一个用于在相同 GRPO 配方下比较这些选择的评估平台。我们的主要实验在 Qwen2.5-7B-base 上,使用 12 个匹配种子,在 12 个数学、逻辑和科学基准上评估了 13 种配置。均匀 GRPO 将领域平衡的平均准确率(Overall)较未训练检查点提升了 7.76 个百分点。八种选择或重新加权方法中,没有一种相对于均匀采样具有排除零的配对 95% 置信区间;三种自适应混合方法中,也没有一种在该精度下优于固定的等比例混合。一项经校正的 12 种子 Llama-3.1-8B-base 扩展实验将额外方法置于与原始对照组相同的分数尺度上,但在其观测均值中未产生共同的优胜者。我们还通过重新计算九个 Qwen2.5-7B-Instruct 运行结果来量化评估敏感性,分别使用偏重数学的六基准汇总(五个数学基准加 GPQA-Diamond,不含逻辑基准)和领域平衡的十二基准汇总。它们的排名呈负相关(ρ = -0.33),而保留全部十二个基准的汇总结果基本一致。在本研究所涉及的控制设置下,改变数据策略可测量地改变训练过程,但并未带来相对于均匀训练的可复现改进。
一句话总结
DataFlex-RL 是一个评估平台,用于在相同 GRPO 配方下系统比较使用可验证奖励进行强化学习的数据策略。在 Qwen2.5-7B-base 上,跨 12 个数学、逻辑和科学基准,经过 12 个匹配种子的实验表明,没有任何选择、重加权或自适应混合策略显著优于均匀采样。
核心贡献
- DataFlex-RL 是一个评估平台,它在共享的 GRPO 配方下,分离并比较了用于可验证奖励强化学习的数据处理策略(选择、重加权、混合优化)。
- 在 Qwen2.5-7B-base 上进行的一项受控实验,使用 12 个种子和 12 个数学、逻辑、科学基准显示,均匀 GRPO 将领域平衡准确率提升了 7.76 个百分点,但八种选择/重加权方法中,无一在与均匀采样比较时,配对的 95% 置信区间排除零值;三种自适应混合方法在同等精度下也未优于固定等比例混合。
- 重新计算了九个 Qwen2.5-7B-Instruct 运行,使用一个数学偏重的六基准摘要,其排名与领域平衡的 12 基准摘要呈负相关(ρ = -0.33),而保留全部 12 个基准的摘要则基本一致,这量化了基准构成如何影响结论的稳定性。
引言
使用可验证奖励的强化学习(RLVR)后训练推理模型,通过对每个提示生成多个回答并构造组相对优势来进行,通常通过组相对策略优化(GRPO)。这鼓励了多样的干预措施,如过滤、重加权或调整训练数据的混合比例,以突出策略决策边界附近的提示。挑战在于,先前的方法通常嵌入自定义的配方变化中 — 改变基座模型、验证器或优化设置 — 因此不清楚所报告的增益是来自数据策略本身还是周围的混杂因素。在线策略评估使这一问题更加复杂:效用信号带有噪声,并随着策略的学习而偏移,而小的评估基准差异或种子变化就可能逆转表面的胜者。作者构建了 DataFlex-RL,一个受控评估平台,它固定 GRPO 配方并在匹配种子和统一的基准套件下比较 13 种数据策略(选择、重加权和混合自适应)。他们发现,在达到的精度下,这些策略均未显示出优于均匀采样的可重复改进,并记录了基准覆盖范围的选择如何改变哪种方法看起来最佳。
数据集
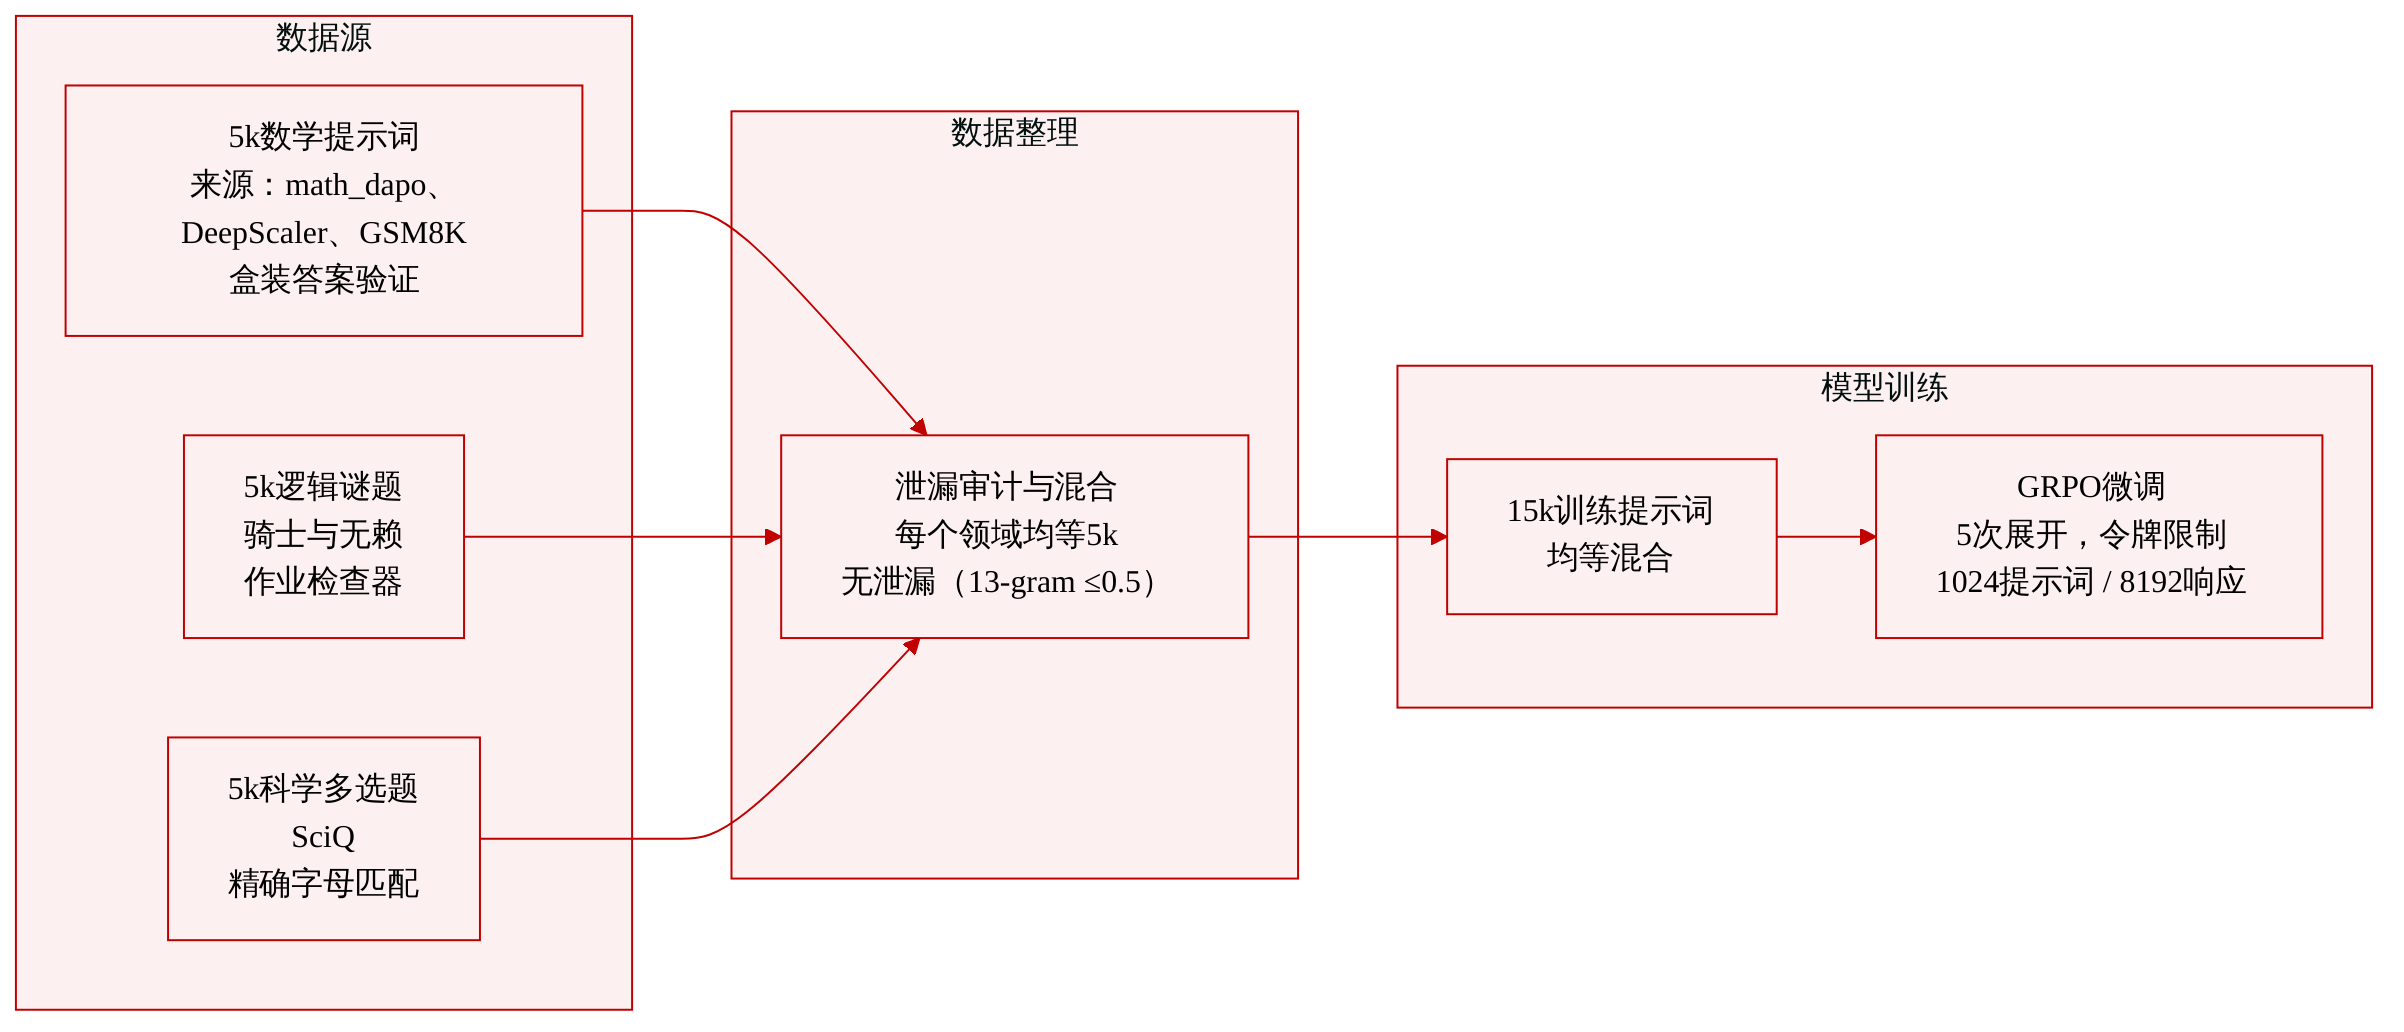
作者构建了一个清洁的训练语料库,包含 15,000 个提示,涵盖三个领域,在数学、逻辑和科学之间均等分配。所有提示都经过验证,确保没有泄漏到评估基准中。
- 数学(5,000 个提示): 来源于 math_dapo、DeepScaler 和 GSM8K。每个提示都格式化为 盒装答案验证(预期输出包含在
\boxed{}中)。 - 逻辑(5,000 个提示): 程序化生成的 骑士与无赖谜题。每个谜题都有一个 赋值检查器 来验证解的正确性。
- 科学(5,000 个提示): 取自 SciQ 多项选择数据集。验证依赖于与正确选项的 精确字母匹配。
去污染和元数据
- 训练提示已针对所有 12 个评估基准进行审计。未发现精确或规范化匹配,且没有任何一个提示对的 13-gram Jaccard 相似度高于 0.5。
- 每个提示记录保留 来源和领域元数据 以确保透明度。
训练中的使用
- 完整的 15,000 提示语料库被用作基于 GRPO 的实验的训练集。
- 训练期间,每个提示被展开 5 次,生成受 1024 token 的提示限制 和 8192 token 的回答限制 约束。
- 三个子集以 等比例 混合;除原始等量划分和每个领域的验证格式外,未应用进一步的裁剪或重新平衡。
方法
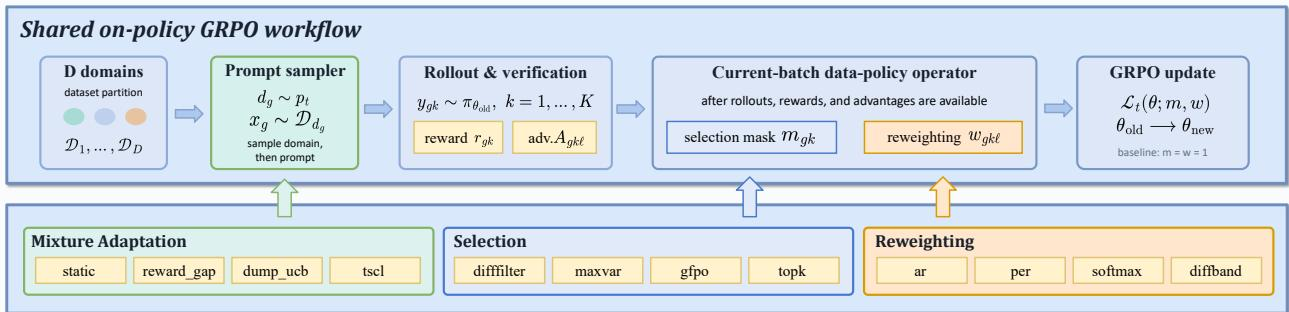
作者引入了一个灵活的框架,用于可验证奖励强化学习(RLVR)训练,将标准的 GRPO 更新分解为三个干预点:选择、重加权和混合自适应。基线训练过程简单直接:以等概率采样数学、逻辑和科学提示,每个提示生成 K=5 个回答,验证其奖励,并对每个有效回答 token 应用标准 GRPO 损失。每个干预族改变流水线中的一个独立部分,其余保持不变,从而实现了对不同 RLVR 数据策略如何改变学习的受控比较。
选择 决定哪些生成的回答参与当前更新。在展开和奖励验证之后,为每个提示 g 的回答 k 分配一个二值掩码 mgk∈{0,1};掩码为零将该回答从损失计算中移除。选择后的损失为
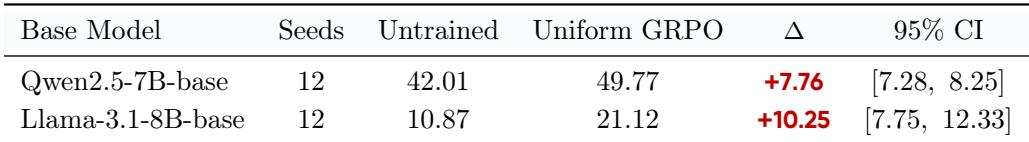
Lsel=GK1g=1∑Gk=1∑KLgkmgkℓ=1∑LgkℓgkℓGRPO,其中 Lgk 是回答长度,ℓgkℓGRPO 表示每个 token 的 GRPO 损失。基线方法简单地将所有 mgk=1。实现的选择变体包括 difffilter、maxvar、gfpo 和 topk,它们使用不同的启发式来决定保留哪些回答或整个提示组。
重加权 保留所有生成的回答,但调整它们对损失的影响。每个 token(或整个回答)分配一个权重 wgkℓ≥0,重加权后的损失为
Lrew=GK1g=1∑Gk=1∑KLgk1ℓ=1∑LgkwgkℓℓgkℓGRPO.实践中,权重在相关批次单元上被归一化为均值为一。该族包括 ar(优势重加权)、per、softmax 和 diffband 等方法,它们将如平均绝对优势等信号转化为连续的重要性权重,而非硬性的保留/丢弃决策。
混合自适应 操作在不同的时间粒度上:它不改变当前更新,而是调整从中采样未来提示的领域分布。设 Dd 为领域 d(例如数学、逻辑、科学)的提示集合,并设 pt(d) 为时间步 t 的采样概率,满足 ∑dpt(d)=1。在此混合下的训练目标为
Lmix,t(θ)=d=1∑Dpt(d)Ex∼Dd,y1:K∼πθold(⋅∣x)[K1k=1∑KLk1ℓ=1∑LkℓkℓGRPO(θ)].固定基线在整个训练中使用 pt(d)=1/D,对应于三个领域的均匀 (1/3,1/3,1/3) 混合。混合方法基于在滚动窗口近期观测上计算的领域级信号动态更新 pt。例如,它们可能跟踪每个领域的平均奖励 rˉt,d、平均绝对优势 aˉt,d 或奖励的斜率 st,d,然后重新分配采样概率,以偏向学习仍有前景的领域。实现的混合策略从 DoReMi、DUMP 和 Teacher–Student Curriculum Learning 中获得灵感。
三个干预族是互补的:选择和重加权在展开后起作用,以过滤或重新缩放损失信号,而混合自适应在下一次展开前操作,以控制模型接下来看到的数据。此设计使作者能够比较,例如,当用于硬选择(topk)或软重加权(softmax)时,如平均绝对优势 agk 的信号哪种更有效。这些信号本身从易于获取的展开统计量中计算,例如组解题率 qg=K1∑k=1K1[rgk>0.5]、回答级的平均绝对优势 agk=Lgk1∑ℓ=1Lgk∣Agkℓ∣,或展开策略的 token 概率。通过系统性地改变干预点而保持信号不变,该框架提供了一个受控测试平台,以理解数据策略设计如何塑造 RLVR 训练。
实验
该评估在 GRPO 训练期间,在基座模型上使用匹配种子和多领域基准套件,比较了数据选择、重加权和自适应混合策略。主要实验使用 Qwen2.5-7B-base 与 12 个种子,发现尽管 GRPO 本身有效,但这些策略中,无一相比于均匀采样或固定数据混合产生可重复的准确率增益。在 Llama 和各种 Qwen 规模上的跨模型检查未显示出一致的胜者,聚合分析揭示,表面上的最佳方法在很大程度上依赖于包含哪些评估领域,这提醒人们不要进行领域遗漏的比较。
十三种来自三个族 — 选择、重加权和混合自适应的配置显示,没有单一方法占主导。相对性能随模型规模和评估领域而变化:在较小模型上表现逊于基线的过滤器,在较大模型上可能改进;当评估覆盖范围减少一个领域时,排名最靠前的方法发生变化。difffilter 在 1.5B 和 3B 模型上可能低于基线,但在 7B 和 14B 模型上略高于基线。maxvar 在所测试的每个模型规模上均低于基线。tscl 在 1.5B 时落后于静态混合,但在更大的 Qwen 模型和 Llama-3.2-3B 上表现优于后者。数学偏重的基准套件将 topk 和 diffband 排在最前,而领域均衡的套件将 gfpo 和 difffilter 排在最前,两者之间存在负秩相关。
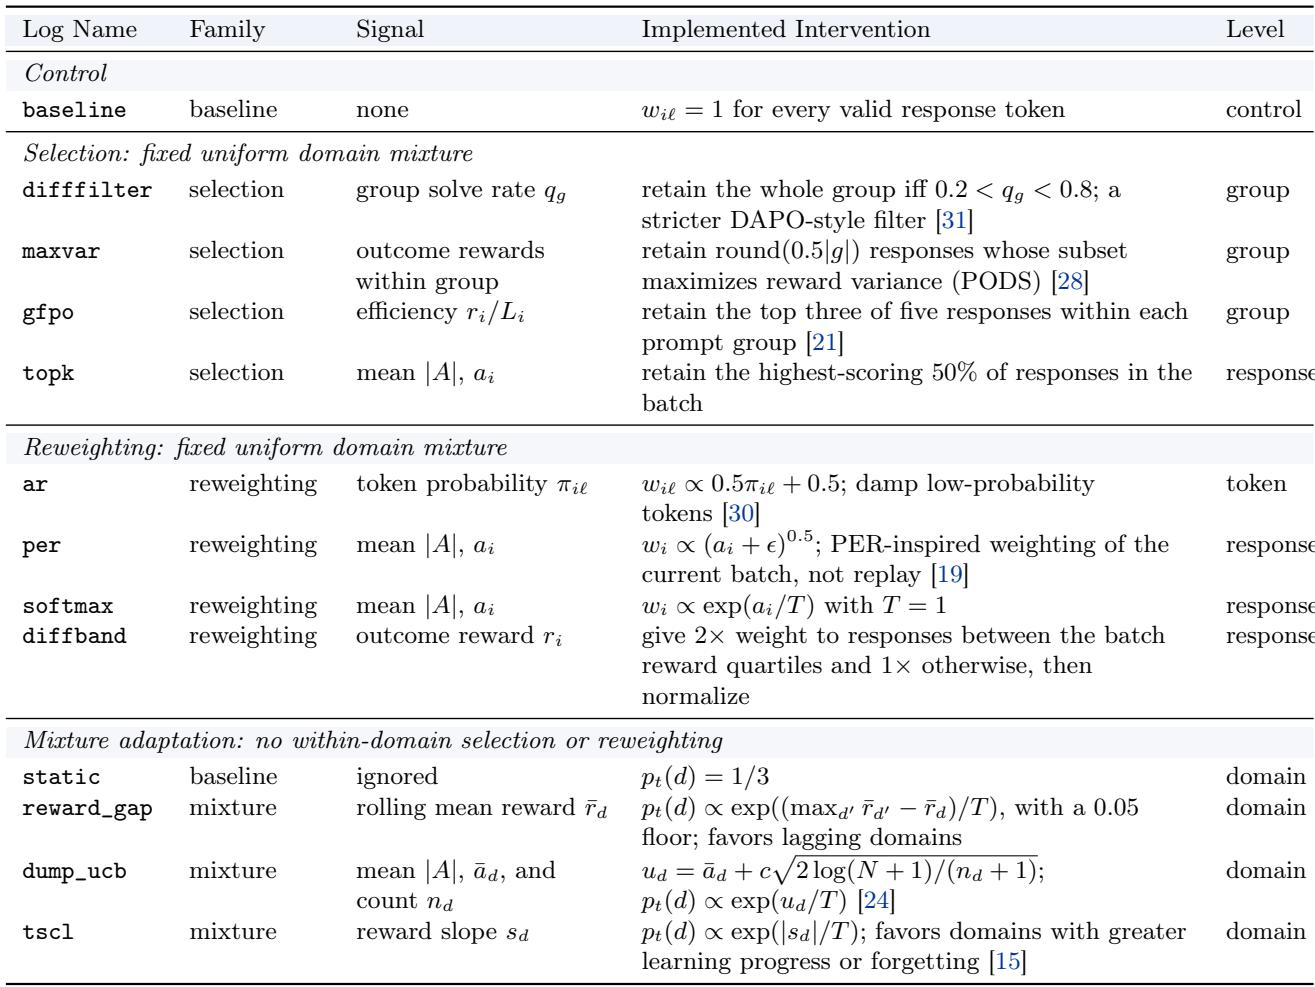
均匀 GRPO 训练在两种基座模型上均大幅提升了未训练检查点的性能,证实了可观的训练提升空间。Qwen2.5-7B-base 的提升巨大且估计精确,因此成为主要的推断场景。这些结果排除了所检验的数据策略显示零效应仅仅因为模型无法学习的可能性。均匀 GRPO 将 Qwen2.5-7B-base 提升了超过 7 个点,95% 置信区间较窄,而 Llama-3.1-8B-base 提升了超过 10 个点但区间较宽。由于 Qwen2.5-7B-base 的提升可观且估计比 Llama-3.1-8B-base 更精确,它被用作全方法和全种子比较数据策略的主要测试模型。
六种数据过滤方法在 Qwen2.5-7B-base 上取得了相似的整体得分,差异微小且置信区间广泛重叠。在数学、逻辑和科学领域的相对优势各不相同,因此没有一种方法在所有领域都持续领先。这种领域敏感性意味着,省略逻辑的摘要可能以不同于完整 12 基准比较的方式对方法进行排名。所有方法的总体得分落在一个狭窄区间内(48.9 到 49.9),95% 置信区间大量重叠。最佳整体均值(difffilter,49.85)仅略高于基线(49.77),而 maxvar 和 gfpo 略低于基线。没有一种方法在所有领域都是最强的:逻辑基准上的相对优势不能预测数学或科学上的相对优势。当从摘要中排除逻辑基准时,表面领先的方法可能发生变化,与领域均衡的排名不同。
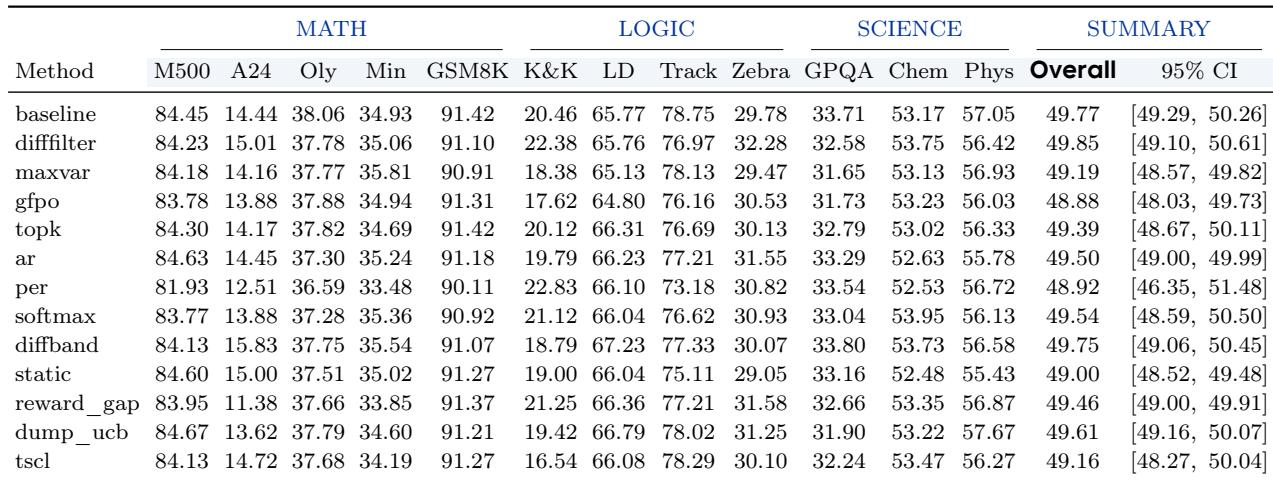
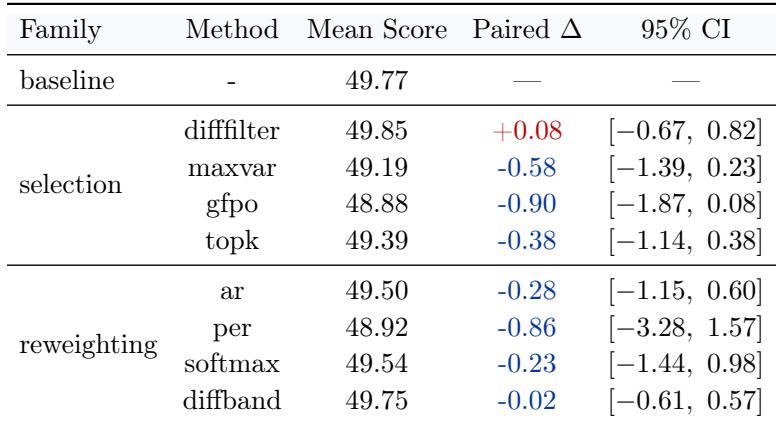
当用 12 个匹配种子进行评估时,选择和重加权方法均未在 Qwen2.5-7B-base 上产生相对于均匀采样的可重复增益。九种策略的均值聚集在一个点内,仅为大规模均匀 GRPO 提升的一小部分,且每个配对的置信区间都轻松包含零。所有八种选择和重加权相对于均匀采样的差异的置信区间均跨过零,因此没有任何方法可靠地优于基线。策略均值跨度仅为 0.97 个点,而均匀 GRPO 本身的增益为 7.76 个点,表明数据过滤策略的选择几乎不增加收益。将比较从三个种子扩展到十二个种子反转了选择器的顺序:topk 从第一位降到低于基线,difffilter 升至最高均值,尽管仍不显著。重加权方法产生的点估计低于均匀,范围约从 -0.9 到接近零,但都没有排除零效应。
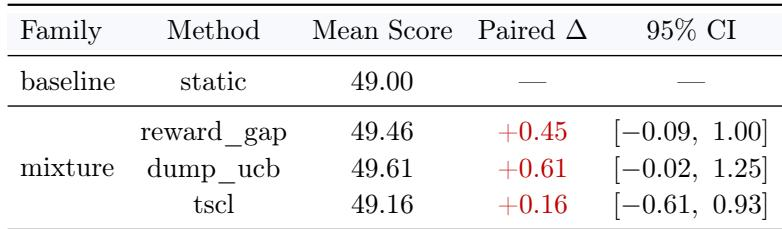
在一个 7B 基座模型上,三种在训练过程中改变数学、逻辑和科学提示比例的自适应混合方法,其平均得分均略高于固定等比例混合,但每个配对的 95% 置信区间都包含零,且均值最多相差 0.61 个点。改变训练领域混合在此设置下并未产生可重复的准确率提升。所有自适应混合(reward_gap、dump_ucb、tscl)相对于静态等比例混合都有正点估计,但无一达到统计显著性,因为每个置信区间都跨过零。得分差异很小:自适应方法的均值跨度仅为 0.61 个点,最大提升为 +0.61,其置信区间包含零效应。
该研究比较了在 GRPO 训练中跨数学、逻辑和科学基准的数据选择、重加权和混合自适应策略。尽管均匀训练相比基座模型产生了巨大提升,但没有一种过滤或混合方法持续优于均匀采样:性能差异很小,方法排名随模型规模和基准领域而变化,并且在使用多个种子测试时,所有成对置信区间都包含零。这些发现表明,在本次设定下,所检验的数据策略相比于均匀训练,仅提供可忽略且不可重复的增益。