Command Palette
Search for a command to run...
DriveZero:超越人类演示的端到端驾驶
DriveZero:超越人类演示的端到端驾驶
摘要
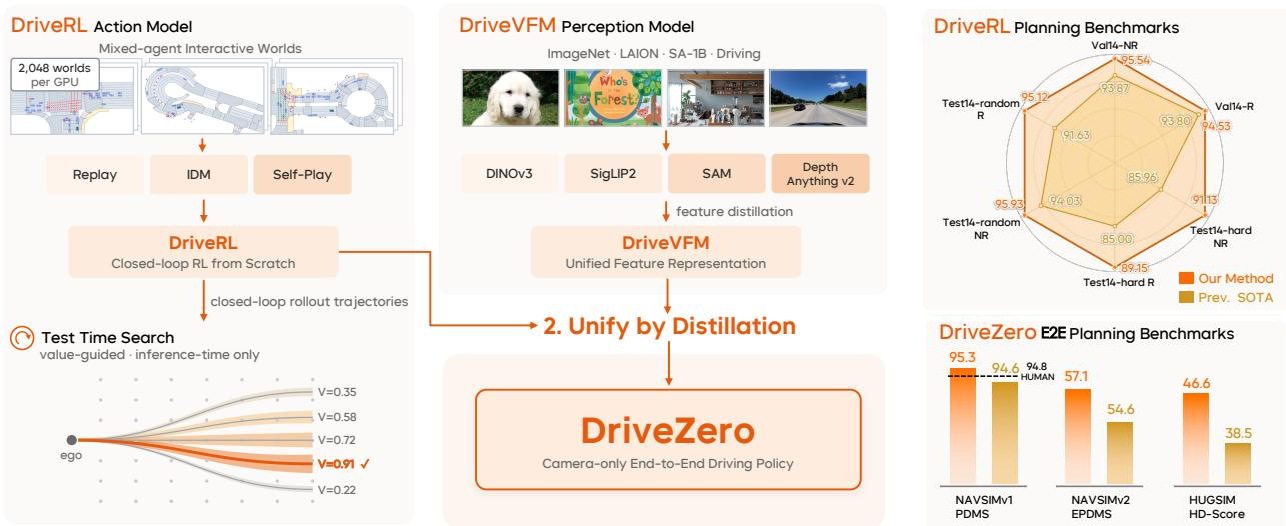
大多数端到端自动驾驶系统通过模仿人类驾驶日志进行学习,这使其学习到的行为受到记录轨迹质量和行为覆盖范围的限制。本报告介绍了 DriveZero,一个端到端系统,其学习驾驶行为的能力超越了人类演示。它将驾驶分解为感知模型和动作模型,分别在最适合各自的机制下进行预训练,并将它们组合成一个端到端规划器。这两个模型需要不同的学习方案:感知必须理解世界,并受益于海量多样的视觉数据;动作必须与世界交互,并需要闭环反馈。在动作方面,我们引入了 DriveRL,一个混合智能体闭环强化学习框架。它将真实驾驶日志转换为交互式世界,在其中通过闭环轨迹采样,使用 PPO 训练一个特权教师策略。对于感知模型,DriveVFM 将多个冻结的视觉基础模型(包括 DINOv3、SigLIP2、SAM 和 Depth Anything V2)整合到一个仅基于原始图像的单骨干网络中,无需任务特定的标注。DriveZero 随后将两者统一:一个仅依赖摄像头的规划器,通过其展开的轨迹蒸馏冻结的 DriveRL 教师。此外,目标条件化的教师可以在增强的驾驶意图下进行查询,从而产生日志数据无法提供的多样化、目标一致的监督。在 nuPlan 上,带有价值引导的测试时动作搜索的 DriveRL 在 Val14、Test14-hard 和 Test14-random 社区划分的非反应和反应模式下,平均得分达到 93.57,在所有三个划分上均超过了 Log-Replay 专家。DriveZero 在 NAVSIMv1、NAVSIMv2 和闭环 HUGSIM 基准上实现了最先进的性能,且无需任何人类轨迹监督:在 navtest 上达到 95.3 PDMS,超过了人类驾驶员(94.8),在 navhard 上达到 57.1 EPDMS,在 HUGSIM 上零样本达到 46.6 HD-Score。
一句话总结
小米汽车的研究人员提出了 DriveZero,一种端到端的纯视觉自动驾驶系统,通过将驾驶分解为 DriveVFM(一个整合了冻结视觉模型(DINOv3、SigLIP2、SAM、Depth Anything V2)的感知主干)和 DriveRL(一种在交互式世界中训练并通过目标条件化 rollout 蒸馏的混合 agent 闭环 PPO 教师策略),超越了人类示范,在 nuPlan(93.57)、NAVSIMv1/v2(95.3 PDMS,超过人类驾驶员的 94.8)和 HUGSIM(46.6 HD-Score)上取得了最先进的成绩,且无需任何人类轨迹监督。
核心贡献
- DriveZero 将端到端驾驶分解为感知模型(DriveVFM)和动作模型(DriveRL),在各自最合适的场景下进行预训练,并通过轨迹蒸馏统一为纯视觉规划器,无需人类轨迹监督。
- DriveRL 将真实驾驶日志转换为交互式世界,使用 PPO 训练目标条件化的特权教师策略,并通过价值引导的测试时动作搜索,在 nuPlan 的三个社区划分上,无论非反应式还是反应式模式,均以 93.57 的平均分超越 Log-Replay 专家。
- DriveVFM 仅从原始图像中将冻结的视觉基础模型(DINOv3、SigLIP2、SAM、Depth Anything V2)蒸馏为单一主干,避免了任务特定的标注,DriveZero 在 NAVSIMv1、NAVSIMv2 和 HUGSIM 上取得了最先进的结果,包括 navtest 上 95.3 PDMS(超过人类驾驶员的 94.8)、navhard 上 57.1 EPDMS,以及 HUGSIM 上 46.6 HD-Score 的零样本成绩。
引言
端到端自动驾驶系统通常通过模仿人类驾驶日志,学习将传感器输入和导航目标直接映射为车辆控制。这种方法具有可扩展性和稳定性,但完全依赖记录轨迹作为监督,这限制了行为的上限,使其受限于日志的质量和覆盖范围。每个记录场景只捕捉一种可能的未来,即使多种动作都是有效的;安全关键事件和恢复操作很少见;而学习策略引发的状态在离线数据中不存在,导致策略一旦偏离示范分布,误差便会累积。
强化学习(RL)提供了一种替代方案,通过闭环交互优化显式目标,使策略能够观察自身动作的后果并从失败中学习。然而,该领域的先前工作面临挑战:将 RL 扩展到真实驾驶的计算成本高昂,许多方法需要将视觉策略置于渲染的闭环环境中,而将在特权或向量化仿真中学到的行为迁移到基于摄像头的策略通常会引入领域差距。此外,用于驾驶的视觉表示通常继承自通用主干或使用任务特定标签训练,可能无法捕捉驾驶场景的完整结构。
作者提出了 DriveZero,一种行为不受人类示范约束的端到端驾驶系统。他们将驾驶分解为感知模型和动作模型,各自在最适合的场景下进行预训练。DriveVFM 通过蒸馏冻结的视觉基础模型(包括 DINOv3、SigLIP2、SAM 和 Depth Anything)从原始图像中学习视觉表示,消除了任务特定感知标签的需求。DriveRL 通过在日志初始化的交互式世界中进行闭环 RL 从零学习驾驶行为,不依赖人类轨迹监督。两者通过轨迹蒸馏重新统一,冻结教师策略的 rollout 被蒸馏为纯视觉规划器,避免了将摄像头学生置于渲染的闭环训练环境中的需求。
数据集
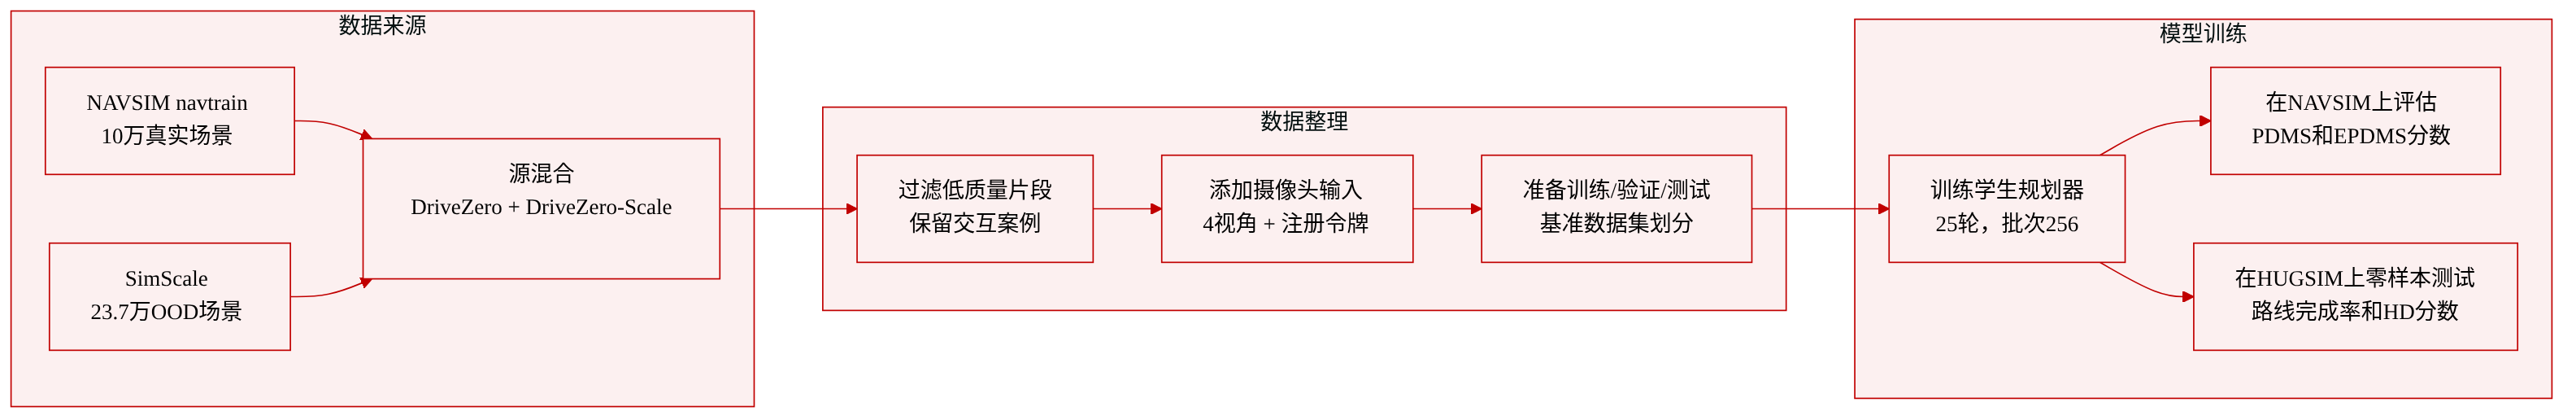
作者从两个主要来源构建 DriveZero 训练数据集。第一个是 NAVSIM 中的 navtrain 划分,基于 nuPlan,包含 100K 个交互式真实世界场景。学生模型不使用记录的人类驾驶轨迹作为监督,而是使用 DriveRL rollout 中累积的轨迹进行训练。第二个来源增加了 来自 SimScale 的 237K 个分布外(OOD)仿真场景 用于数据扩展;由此产生的变体称为 DriveZero-Scale。
在输入方面,DriveZero 使用四个摄像头视角:CAM_F0、CAM_B0、CAM_L0 和 CAM_R0。规划器由 64 个轨迹提议、256 维规划表示 和 4 层提议解码器 组成。摄像头特征通过每摄像头 16 个寄存器 token 进行压缩,遵循 DrivoR 方法。训练期间,DriveVFM 主干保持冻结,仅 秩为 32 的 Q/V LoRA 适配器 可训练。模型使用 AdamW 优化器,以 256 的批量大小训练 25 个 epoch。
论文在三个基准上评估了纯视觉学生模型。NAVSIMv1 navtest(基于 nuPlan 构建,作为 OpenScene 的子集)和 NAVSIMv2 navhard 在标准传感器输入协议下提供伪闭环评估。在 navtest 上,作者报告了预测驾驶员模式分数(PDMS)及其组成部分:无碰撞、可行驶区域合规性、碰撞时间、舒适度和自车进度。在 navhard 上,他们报告了两阶段扩展预测驾驶员模式分数(EPDMS),包含安全性、合规性、进度和规划质量组件;第二阶段测试对基于高斯溅射的自车状态扰动的鲁棒性。他们还在 HUGSIM 上评估了零样本迁移,这是一个从 KITTI-360、nuScenes、PandaSet 和 Waymo 场景重建的真实闭环基准,报告了 Easy、Medium、Hard 和 Extreme 场景下的路线完成率和 HD-Score。零样本意味着不使用 HUGSIM 特定的微调。
方法
作者提出了一种分解式端到端自动驾驶框架,将感知、动作学习和部署分离。该方法由三个核心组件组成:DriveRL 用于通过闭环强化学习学习特权教师策略,DriveVFM 用于在无任务特定标注的情况下预训练鲁棒的视觉主干,DriveZero 用于将教师行为蒸馏为可部署的纯视觉规划器。
DriveRL 作为特权动作模型。它处理结构化场景观察,包括自车运动学、周围交通参与者和局部矢量地图。作者使用基于真实驾驶日志构建的混合 agent 仿真器,通过近端策略优化(PPO)训练教师策略。策略输出纵向加加速度和转向角速度的有界 Beta 分布,直接控制车辆,无需轨迹细化。这种闭环训练使教师能够超越人类示范优化行为,并从扰动状态中恢复。
为了弥合特权结构化状态与可部署摄像头输入之间的差距,作者引入了 DriveVFM。DriveVFM 不依赖手动标注的辅助感知任务,而是将冻结的视觉基础模型(如 DINOv3、SigLIP2、SAM 和 Depth Anything V2)整合为单一驾驶主干。通过聚合式蒸馏过程匹配这些异构模型的特征,主干从多样化的网络规模和驾驶图像语料中获取驾驶相关的语义、几何和空间结构。
最后一个组件 DriveZero 通过多模态轨迹蒸馏重新统一感知和动作模型。如下图所示:
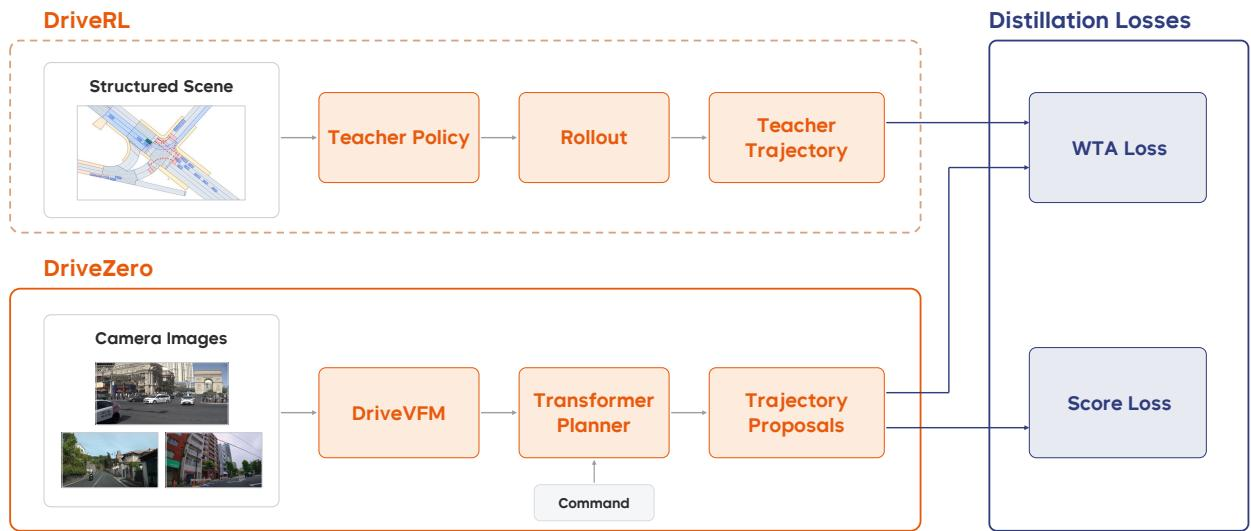
DriveZero 是一个纯视觉端到端规划器,在记录帧上以开环方式训练。它接收多视角摄像头图像、自车运动学和导航命令作为输入。经过低秩适配微调的 DriveVFM 主干对图像进行编码,生成的视觉 token 通过 3D 位置嵌入进行增强。可学习的寄存器将这些 token 压缩为一组紧凑的场景 token。自车运动学和导航命令被嵌入到自车 token 中,该 token 被添加到多个可学习的轨迹查询中。轨迹解码器随后通过交叉注意力将这些查询映射为 M 个候选轨迹提议。
训练期间,冻结的 DriveRL 教师接收结构化状态和目标点,在背景 actor 遵循驾驶日志的情况下 rollout 一条轨迹。该教师轨迹作为学生的回归目标。作者采用赢家通吃的轨迹蒸馏目标。每个候选提议与教师轨迹进行比较,只有最接近的提议贡献轨迹损失:
Ltraj=mmindist(τ^m,τT)其中 τ^m 是第 m 个提议,dist(⋅,⋅) 是逐点平均的 L1 距离。
与此同时,一个独立的评分解码器评估每个候选轨迹。它预测六个驾驶质量组件,涵盖碰撞避免、可行驶区域合规性、进度、碰撞时间、舒适度和行驶方向合规性。这些组件通过对应的基于 Planning Metric 的目标使用二元交叉熵损失进行监督:
Lscore=M1m=1∑Mk=1∑6BCE(σ(s^mk),smk)完整训练目标结合了两种损失:
LDriveZero=λtrajLtraj+λscoreLscore推理时,系统选择预测聚合分数最高的候选。此外,由于教师是目标条件化的,作者在训练期间增强路线意图以生成多样且目标一致的监督信号,显著扩展了可用训练数据,超越了人类日志中单一实现轨迹的限制。
实验
评估验证了所提出的分解方案,即强化学习的动作模型、无任务标注预训练的感知模型,以及将它们统一为纯视觉规划器的蒸馏步骤。DriveRL 在 nuPlan 上以混合 agent 世界进行闭环训练,在所有六种评估设置中均超过 Log-Replay 专家,测试时动作搜索进一步提高了平均分。DriveZero 作为纯视觉学生模型,在无任何人类轨迹监督的情况下,在 NAVSIMv1、NAVSIMv2 和 HUGSIM 上取得了最先进的结果,而使用分布外仿真数据进行扩展进一步提升了性能,在 navtest 上超越人类驾驶员。消融实验证实,视觉基础模型、累积教师贡献以及来自 RL 教师的目标增强蒸馏均提供一致的增益,其中后者超越了人类轨迹监督。
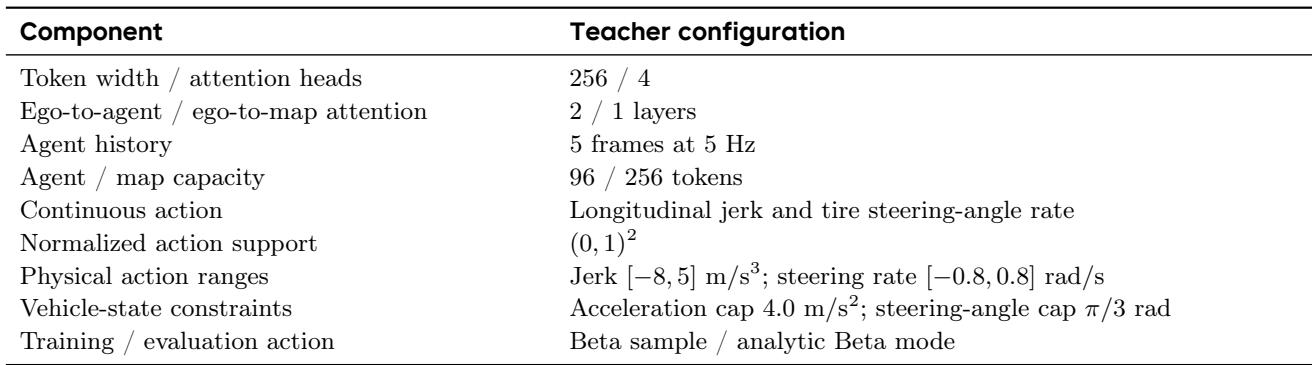
DriveRL 使用基于 transformer 的策略,具有 256 token 宽度和 4 个注意力头,包含自车到 agent 和自车到地图的注意力层,通过纵向加加速度和转向角速度输出连续控制。训练在 96 块 GPU 上进行,并行 2,048 个世界,使用日志回放和 IDM 场景的混合,策略通过 PPO 训练 2,400 次更新,约 21 小时。模型使用 256 token 宽度、4 个注意力头、2 层自车到 agent 和 1 层自车到地图的注意力层。agent 历史覆盖 5 帧,频率为 5 Hz,容量为 96 个 agent token 和 256 个地图 token。控制输出为连续值,加加速度限制在 [-8, 5] m/s³,转向角速度限制在 [-0.8, 0.8] rad/s。训练使用日志回放和 IDM 场景的 1:1 混合,rollout 为 5 Hz 下的 110 步。策略通过 PPO 优化,每次更新 4 个 epoch,折扣因子为 0.99。
DriveRL 在全部六种 nuPlan 评估中取得最高的未加权平均分,在大多数设置中优于基于人类数据训练和无人类数据的基线。加入价值引导的测试时动作搜索进一步将平均分提高了 0.56 分,在六种设置中的五种取得增益,在最困难的反应式场景中变化极小。DriveRL 在每种非反应式和反应式设置中均超过 Log-Replay,表明闭环 RL 可以超越示范初始化的行为。DriveRL 在所有报告设置中也优于此前两种无人类数据训练的方法 CaRL 和 GigaFlow。价值引导的测试时动作搜索将平均分从 93.01 提升至 93.57,改善了六种设置中的五种,同时使最困难的反应式场景基本保持不变。
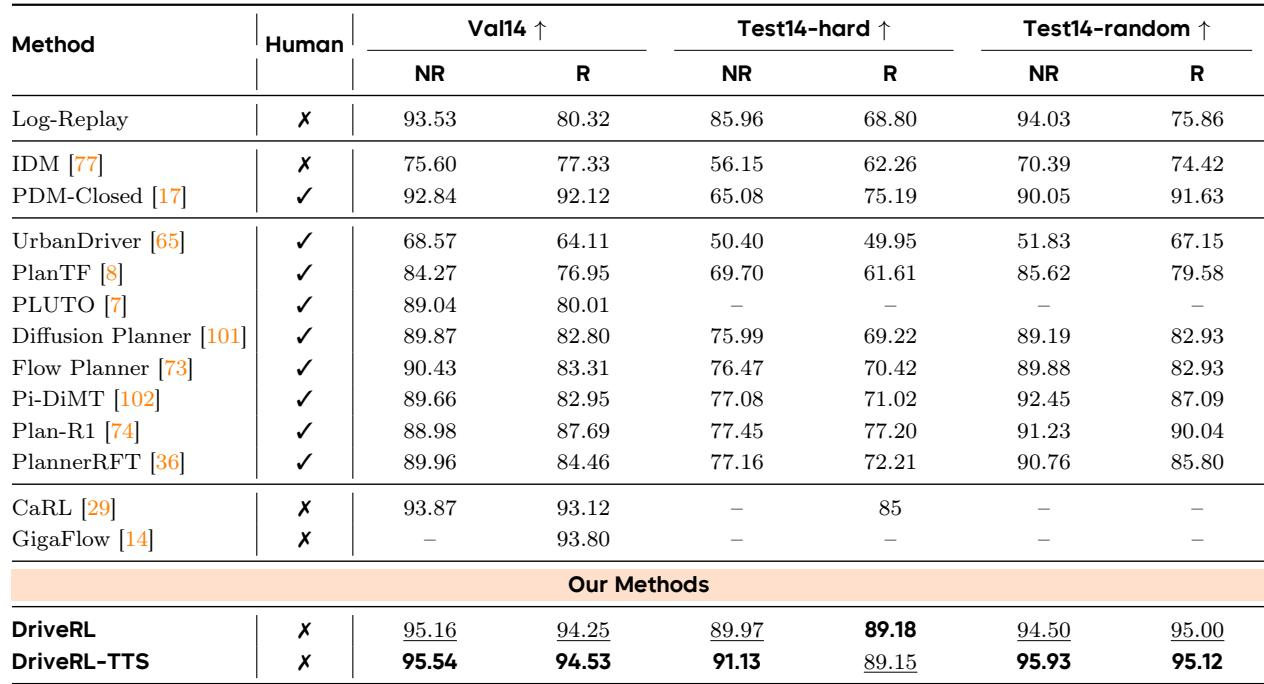
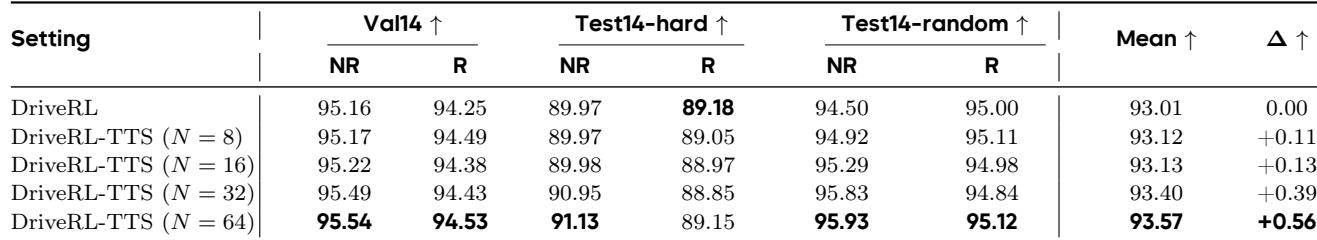
测试时搜索中动作候选数量的扩展提高了固定检查点的平均驾驶分数,在非反应式 hard 和 random 划分上增益最大。改进在大多数设置中一致,确认额外推理计算充当局部策略改进算子。将候选预算从 8 增加到 64 使平均分从 93.12 提升至 93.57。最大增益出现在非反应式 Test14 划分上,分别提高了 1.16 和 1.43 分。反应式划分的变化较小或混合,而非反应式划分从更大的候选集中获益更一致。
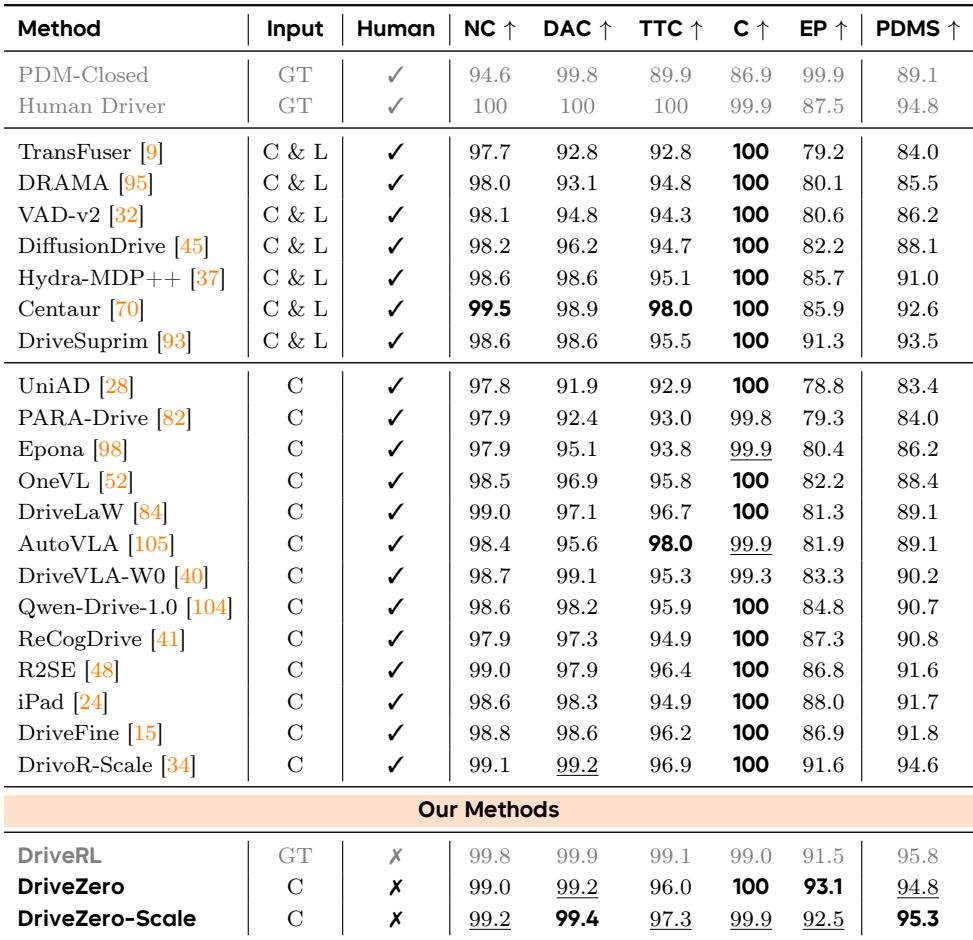
DriveZero 使用 DriveRL 的 RL 监督进行训练,仅凭摄像头输入在 NAVSIMv1 navtest 基准上取得了强大的伪闭环性能,优于先前的纯视觉和融合方法。使用额外仿真数据进行扩展进一步提高了其 PDMS 分数,同时保持了高安全性和效率指标。RL 训练的 DriveRL 在 PDMS 上超越人类驾驶员和 PDM-Closed,具有接近人类的安全性和更高的驾驶效率。纯视觉 DriveZero 在无人类轨迹监督的情况下达到 94.8 PDMS,击败了所有先前的纯视觉和摄像头-激光雷达融合方法。加入 OOD 仿真数据(DriveZero-Scale)将 PDMS 提升至 95.3,安全指标超过 99,效率也有所提高。
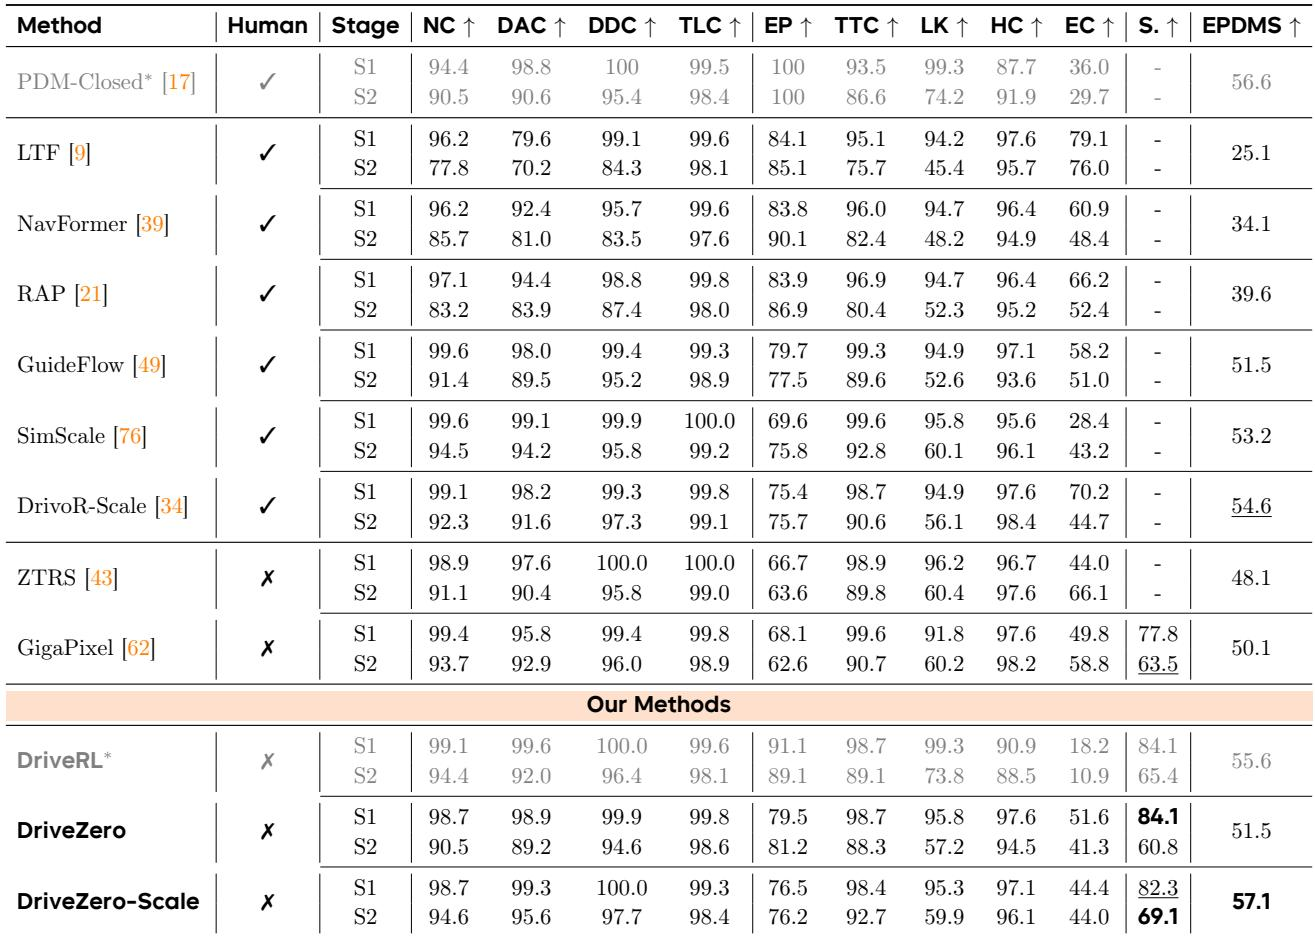
DriveZero 作为纯视觉方法,在 NAVSIMv2 navhard 基准上取得了 51.5 的 EPDMS,优于所有仅在 navtrain 划分上训练的方法,并超过了一种可比较的基于 RL 教师的方法。使用 SimScale 数据进行扩展将综合分数提升至 57.1,主要得益于第二阶段分数的大幅提高,并建立了新的最先进水平,甚至超过了使用真值符号输入的方法。DriveZero 优于所有仅在 navtrain 划分上训练的方法,包括一种可比较的基于 RL 教师的方法。使用 SimScale 数据进行扩展将综合 EPDMS 提高了 5.6 分,其中第二阶段分数提高了 8.3 分,而第一阶段略有下降。扩展模型超过了使用 SimScale 的基线方法和依赖真值符号输入的方法。
DriveRL 是一种基于 transformer 的闭环 RL 策略,在大规模并行仿真中使用 PPO 训练,在全部六种 nuPlan 设置中取得最高平均分,优于基于人类数据训练和无人类数据的基线,价值引导的测试时动作搜索进一步提供了 0.56 分的提升。搜索期间动作候选数量的扩展一致地提高了固定检查点的分数,尤其在非反应式划分上,确认额外推理计算充当局部策略改进算子。蒸馏为纯视觉学生模型后,DriveZero 在 NAVSIMv1 navtest 上超越了先前的纯视觉和融合方法,而使用额外仿真数据进行扩展进一步提高了性能,同时保持了高安全性和效率。在更困难的 NAVSIMv2 navhard 基准上,DriveZero 也建立了新的最先进水平,扩展在第二阶段分数上带来大幅提升,甚至超过了使用真值符号输入的方法。