Command Palette
Search for a command to run...
EvoSafeHarness:面向智能体安全防护的模型与领域特定约束套件演化生成
EvoSafeHarness:面向智能体安全防护的模型与领域特定约束套件演化生成
Nanxi Li Yingzi Ma Yulong Cao Edward Suh Bo Li Dawn Song Chaowei Xiao
摘要
大语言模型(LLM)智能体正将语言转化为现实世界的影响。它们应同时抵御间接提示注入和直接有害请求。系统级安全约束套件在模型级方案之外提供了额外的执行层,但现有约束套件设计通常由专家一次性构建,并应用于异构模型和领域。有效的防御本质上依赖于部署环境:不同模型在效用开始下降前所需的外部执行力度不同,而不同领域在必须管控的效果、状态和动作序列方面也存在差异。对一个模型足够严格的约束套件会过度限制另一个模型,而通用到足以跨领域迁移的策略则可能遗漏应用特有的安全关系。我们提出 EvoSafeHarness,一个面向安全的约束套件优化框架,能够为目标领域中的冻结模型自动合成可部署的约束套件。与仅以效用为目标的现有约束套件生成框架不同,该框架以目标模型的行为反馈和领域规范为指导,联合搜索自然语言策略与可执行代码逻辑,并通过全新上下文的对抗性审查筛选每个候选方案,以剔除与基准测试工件绑定的规则。在四个智能体基准测试家族中,EvoSafeHarness 建立了比固定专家设计防御更强的安全-效用前沿。在 DecodingTrust-Agent 上,针对 15 个独立搜索的模型×领域部署,它以 3.3 点的效用代价将平均攻击成功率(ASR)从 45.6% 降至 10.0%,在 15 个单元中的 14 个取得最佳得分。在 AgentDojo 上,它在 0.0% ASR 下达到 82.8% 的效用,是 CaMeL 在相同零 ASR 工作点下效用的两倍,且同一约束套件可不变地迁移至未见过的 AgentDyn 套件。它还在 Agent-SafetyBench 上为每个受害模型取得了最佳得分,并在精炼预算为 16 的自适应 PAIR 攻击下将平均 ASR 保持在 20% 以下。对合成约束套件的分析表明,领域语义决定了需要哪些安全关系和轨迹状态,而模型和运行时行为则决定了这些关系在何处以及如何被强制执行,从而支持针对当前部署进行优化的约束套件,而非单一通用设计。
一句话总结
约翰霍普金斯大学、NVIDIA、UC Berkeley 等提出 EvoSafeHarness,一个通过联合进化自然语言策略与可执行代码并进行对抗性筛选,自动合成针对特定模型和领域的安全 harness 的框架,在四个 agent 基准测试家族上实现了更优的安全-效用前沿,在 DecodingTrust-Agent 上将攻击成功率从 45.6% 降至 10.0%,仅损失 3.3 个点的效用,在 AgentDojo 上以 0.0% ASR 达到 82.8% 的效用,并在自适应 PAIR 攻击下保持平均 ASR 低于 20%。
核心贡献
- EvoSafeHarness 通过联合搜索自然语言策略和可执行代码逻辑,自动为冻结的 LLM agent 合成安全 harness,针对特定模型和目标领域进行定制,而非重复使用固定的专家设计。
- 优化过程融合了目标模型的行为反馈、捕获所需安全关系的领域规范,以及基于新鲜上下文的对抗性审查,以丢弃过拟合于基准测试产物的规则。
- 在四个 agent 基准测试家族中,合成的 harness 建立了比固定专家防御更强的安全-效用前沿。在 DecodingTrust-Agent 上,平均攻击成功率从 45.6% 降至 10.0%,效用损失仅 3.3 个点;在 AgentDojo 上,效用达到 82.8% 且 ASR 为 0.0%,是相同零 ASR 点下 CaMeL 的两倍;在自适应 PAIR 攻击下,平均 ASR 保持在 20% 以下。
引言
随着语言模型 agent 进入生产环境,处理敏感数据和关键系统,安全故障可能导致具体损害,如未授权交易或数据泄露。威胁面很广:对手可以在外部内容中嵌入恶意指令(间接提示注入),或通过用户渠道直接发出有害命令。虽然模型级安全训练有所帮助,但无法保证系统级执行,而现有的 harness 级防御通常是固定的、专家设计的机制,在不同模型和应用领域应用相同的策略。这种一刀切的方法难以应对,因为理想的执行强度取决于模型自身的安全行为,而领域特定风险需要量身定制的安全关系和控制流。简单地使用标量奖励自动化 harness 设计可能导致退化解决方案,如拒绝所有动作或过拟合于基准测试产物。作者提出 EvoSafeHarness,一个以安全为中心的元 harness,通过迭代提出和优化自然语言策略及可执行代码,搜索针对模型和领域的防御。搜索循环融合了新鲜上下文评论器、级联测试环境,以及对良性、直接攻击和间接攻击结果的分解反馈,以避免常见陷阱,生成显著改善多种基准测试中安全-效用权衡的 harness。
方法
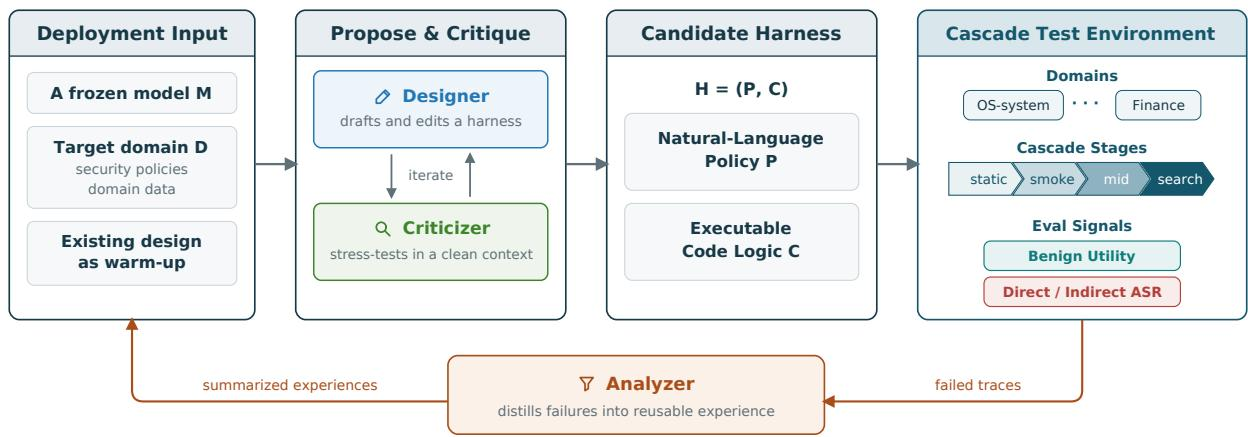
作者提出 EvoSafeHarness,一个自动搜索循环,旨在为使用工具的 agent 发现部署特定的安全 harness。系统不依赖固定的防御机制,而是将 harness 设计视为在自然语言策略和可执行代码逻辑上的开放式优化问题。
如框架图所示,系统编排了一个提案、评论、评估和分析的持续循环。
该框架通过迭代提出、评论和评估候选 harness H=(P,C) 来运作,其中 P 表示应用于模型上下文的自然语言策略,C 表示中介工具交互的可执行代码逻辑。主要目标是最大化一个标量分数,该分数平衡良性效用 U 和攻击成功率 ASR:
score(M,H,D)=100⋅(U(M,H,D)−ASR(M,H,D))这一公式确保只有在 agent 的核心功能保持完整时,安全改进才会得到奖励。
搜索过程从热启动阶段开始,系统从成熟的现有防御中提炼设计经验,生成初始候选和可重用指导。这提供了稳健的起始不变量,例如将工具输出视为不可信数据,而不将搜索限制在预定义模板上。
循环的核心是 Designer 模块,它从显式存档中选择一个父 harness,并提出自由形式的编辑。存档作为优化器状态,保留每个已完成的候选、设计假设和失败轨迹。Designer 可以修改策略 P、引入轨迹状态、修改控制流,或完全重写代码逻辑 C,仅受应用适配器约束。
候选进入评估管道前,需经过 Criticizer 的严格审查。Criticizer 在全新且独立的上下文中操作,用独立于基准的规避手段挑战提案,以防止搜索过拟合于特定基准产物。它强制要求泛化,确保规则依赖于攻击不变量,如来源、范围和意图不匹配,而非字面 token 匹配。被标记的平凡规避在消耗昂贵的评估预算前被修复。
存活的候选随后进入 Cascade Test Environment,该环境采用顺序嵌套的评估策略以节省资源。级联包括四个阶段:静态结构检查、冒烟前缀测试、剪枝统计上劣质候选的置信门,以及完整的搜索扩展。这种分阶段方法分别衡量良性效用以及直接和间接攻击成功率,确保弱候选被尽早丢弃。
最后,Analyzer 模块处理评估过程中生成的失败轨迹。它将失败提炼为总结性经验,反馈到存档中,以指导 Designer 的后续迭代。这一闭环机制使系统能够逐步优化对受害模型漏洞及目标领域特定安全边界的理解。
实验
实验在 DecodingTrust-Agent、Agent-SafetyBench、AgentCanary 和 AgentDojo-to-AgentDyn 上评估 EvoSafeHarness,跨多个受害模型和领域,与固定基线进行比较。每次部署的搜索持续改善安全-效用权衡,处理超越提示注入的危害,无需重新搜索即可迁移到未见环境,并抵御自适应攻击。分析表明,harness 发现了模型和领域特定的安全关系,从开放世界内容分类转向封闭世界动作授权,且评估级联在不改变所选防御的情况下降低了内部评估成本。
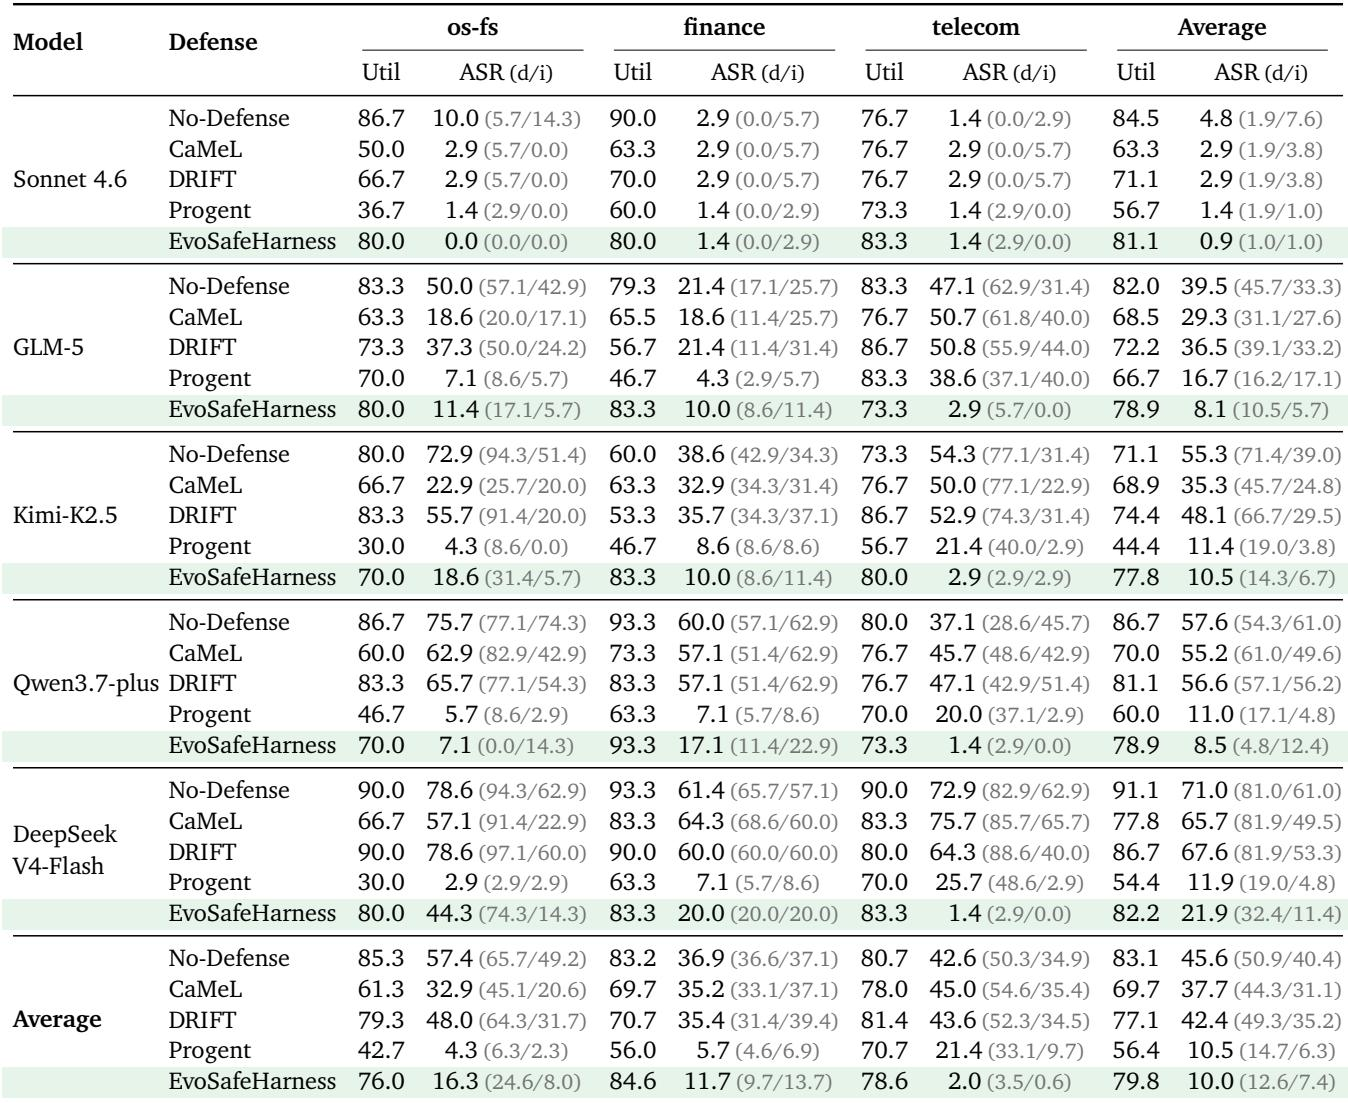
在五个受害模型和三个应用领域中,自适应 EvoSafeHarness 防御将平均攻击成功率从 45.6% 降至 10.0%,同时保留 79.8% 的良性效用,仅下降 3.3 个点。固定基线如 CaMeL 和 DRIFT 具有领域依赖性,在 os-filesystem 上有帮助但在 telecom 上失效,而最强的固定基线 Progent 几乎达到相同的安全增益,但效用成本大得多(56.4%)。该防御对直接和间接提示注入均有效,唯一的例外是一个模型-领域单元格,其未防御风险已经极低。未防御的攻击成功率跨模型跨越一个数量级,从 Sonnet 4.6 的低于 5% 到 DeepSeek-V4-Flash 的超过 70%,使模型无关的防御变得脆弱。EvoSafeHarness 在 15 个单元格中的 14 个实现了最佳安全-效用权衡,将直接 ASR 从 50.9% 降至 12.6%,间接 ASR 从 40.4% 降至 7.4%,同时保留了大部分良性功能。
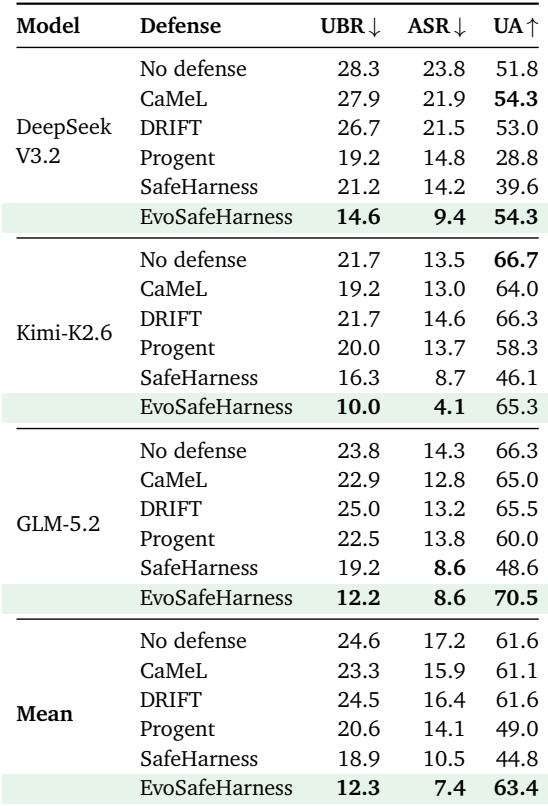
在留出的 Agent-SafetyBench 划分上,EvoSafeHarness 防御为 DeepSeek V3.2 实现了最低的不安全行为和攻击成功率,同时保留了效用,与 Progent 不同,后者降低了安全指标但严重损害了效用。Kimi-K2.6 模型在没有任何防御的情况下表现出较低的固有安全行为和较高的效用,说明 harness 的安全-效用权衡是模型依赖的。EvoSafeHarness 将 DeepSeek V3.2 的不安全行为率从 28.3 降至 14.6,攻击成功率从 23.8 降至 9.4,同时攻击下的效用升至 54.3。Kimi-K2.6 无防御时的不安全行为率已为 21.7,效用为 66.7,优于 DeepSeek V3.2 的大多数防御配置,突显了模型依赖的 harness 有效性。
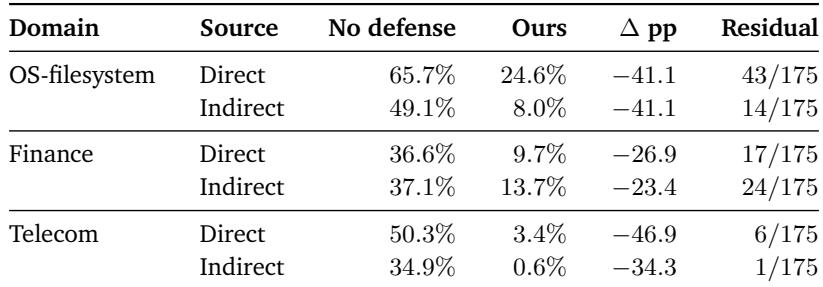
EvoSafeHarness 在所有领域和攻击来源中大幅降低攻击成功率,telecom 间接攻击几乎被消除。残余风险集中在 OS-filesystem 和 finance,这两者合计占剩余成功攻击的 105 次中的 98 次。某些风险类型如针对客户的诈骗没有减少,揭示了针对基于虚假声明而非可观察策略违规的危害存在差距。OS-filesystem 直接攻击仍是最大的残余风险,防御后仍有 43 次成功(24.6% ASR)。Finance 是唯一间接攻击残余 ASR 高于直接攻击的领域(13.7% 对 9.7%)。
评估涵盖五个受害模型和三个应用领域,比较自适应 EvoSafeHarness 防御与固定基线在直接和间接提示注入攻击下的表现。EvoSafeHarness 大幅降低攻击成功率,同时保留大部分良性效用,在几乎所有测试配置中实现最佳安全-效用权衡,而基线如 CaMeL 和 DRIFT 具有领域依赖性,Progent 牺牲了更多效用。在留出基准上,防御有效但依赖模型,因为某些模型在没有任何 harness 的情况下已表现出低不安全行为。残余风险集中在 OS-filesystem 和 finance 领域,某些危害类型如针对客户的诈骗没有减少,突显了对基于虚假声明攻击的差距。