Command Palette
Search for a command to run...
面向智能体智能的基于代码的大规模有依据技能合成
面向智能体智能的基于代码的大规模有依据技能合成
Yongqi Tong Pan Wang Hang Wang Jianshe Li Xin Zhang Jiang-Ming Yang Wei Wu
摘要
可复用技能为智能体系统赋予可迁移的程序性知识,使得可扩展的技能获取对于让智能体超越其累积经验至关重要。现有技能合成方法有两个主要局限:基于轨迹的技能合成与环境固有耦合,而源于文档的产物可能缺乏证据支持和验证。源代码提供了一条不同的路径——它不需要先前的经验,同时保留可执行证据,用于为后续抽象提供依据。因此,我们提出 Code2Skill,这是一个全自动流水线,将选定的代码单元提升为实现锚定的原子操作、复合工作流和重复模式技能记录,并通过在屏蔽源代码主体的情况下进行重构、再进行源代码感知比较来验证这些记录。将 Code2Skill 应用于 19,769 个流行且积极维护的 GitHub 仓库,得到我们的 CodeSkillBank,这是一个有依据的技能库,包含 1,006,822 条被接受的记录,并带有工作流、边界、来源和源代码证据元数据。在涵盖 9 种模型设置和 8 个基准的 72 项协议匹配评估中,通过检索到的 CodeSkillBank 技能增强的模型相较于匹配基线平均取得了 11.7% 的性能增益,并在 57 项中优于基线。在统一下游接口下,Code2Skill 还在全部 7 个共享基准上优于所比较的基于轨迹的技能库,表明仓库派生的技能可以在智能体通过自身交互积累足够经验之前提供有效的程序性知识。此外,广泛分析进一步表明,从经过测试的 AI 生成代码中合成的技能达到 93.50% 的通过率,而源自人类编写代码的技能为 93.00%,这提供了初步证据,表明随着 AI 生成代码日益普及,同一流水线能够持续扩展 CodeSkillBank。综上,Code2Skill 通过将软件仓库中蕴含的专业知识转化为有依据、可验证且可迁移的技能,为在智能体系统中复用人类程序性知识提供了一种新范式。
一句话总结
蚂蚁国际的研究人员提出了 Code2Skill,一条全自动流水线,将选定的代码单元抽取为以实现为锚定的原子操作、复合工作流和重复模式技能记录,并通过源主体盲化重建和源感知比较进行验证;将其应用于 19,769 个 GitHub 仓库后,得到 CodeSkillBank,其中包含 1,006,822 条记录,在 72 项评估中平均性能提升 11.7%。
核心贡献
- Code2Skill 是一条全自动流水线,将选定的源代码单元抽取为以实现为锚定的原子操作、复合工作流和重复模式技能记录,并通过源主体盲化重建和源感知比较进行验证。
- 将 Code2Skill 应用于 19,769 个流行且积极维护的 GitHub 仓库,得到 CodeSkillBank,这是一个有实现依据的技能库,包含 1,006,822 条已接受记录,并带有工作流、边界、来源和源代码证据元数据。
- 在涵盖九种模型设置和八个基准的评估中,检索到的 CodeSkillBank 技能相比匹配基线平均性能提升 11.7%,在 72 项协议匹配评估中有 57 项取得提升。在统一下游接口下,仓库衍生技能还在全部七个共享基准上优于对比的轨迹衍生技能库。
引言
作者探讨了 agentic AI 中的一个实际瓶颈:大型基础模型可以很好地进行推理,但复杂的长时间跨度任务需要存在于模型参数之外的可复用过程性知识,这些知识通常以 agent 框架中的技能形式编码。技能之所以重要,是因为它们可以独立更新、版本化和部署,为添加领域专业知识提供可扩展的方式。先前的技能合成存在局限:基于轨迹的方法从 agent 自身的执行轨迹中提炼技能,因此其质量受限于生成它们的 agent,并且在模型、工具或任务分布变化时可能过时;基于文档的方法避免了这种耦合,但缺乏可执行依据和验证。作者提出了 Code2Skill,这是一条全自动流水线,从大规模源代码仓库中挖掘,将有用的实现抽象为类型化技能记录,并通过仅从技能重建原始实现来验证其实现依据。将其应用于 19,769 个 GitHub 仓库后,它产生了 CodeSkillBank,一个包含 1,006,822 条已接受记录的技能库,并在软件工程、推理和系统交互基准上提升了下游 agent 性能。
数据集
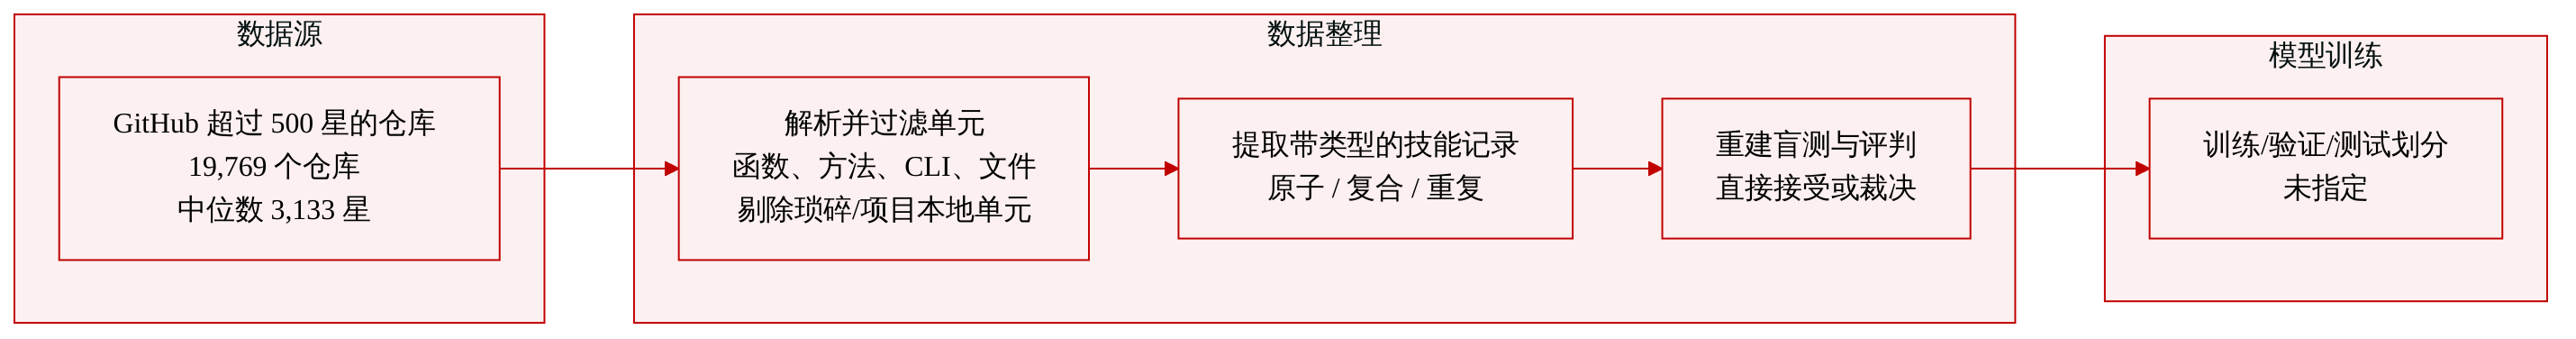
数据来源与规模
- 作者从截至 2026 年 4 月 14 日可用且超过 500 个 star 的 GitHub 仓库构建 CodeSkillBank。
- 来源池包含 19,769 个仓库。
- 仓库池集中在积极维护的公开项目中:
- 中位数:3,133 个 star 和 82 个已合并的 pull request。
- 78.3% 至少拥有 1,000 个 star。
- 46.9% 至少拥有 100 个已合并的 pull request。
- 66.0% 在上一年内有过推送。
- 该池覆盖主要编程语言和软件生态。
数据集组成
- CodeSkillBank 包含三种粒度的类型化技能记录:
- 原子技能:单个函数或方法内的单一明确定义的操作。
- 复合技能:协调多个操作的有序工作流。
- 重复模式技能:超出单个局部操作或工作流的更高层实现。
- 每条记录将操作指南与执行约束和支持证据分离。
- 记录包括以下字段:
- 所捕获的问题
- 使用时机
- 控制规则
- 工作流
- 不变式与失败处理
- 反目标
- 源代码证据
- 来源与构造元数据
处理与过滤
- 流水线从每个仓库解析函数、方法、命令行入口和文件级组件。
- LLM 标注器选择具有可复用意图、操作结构和可见执行约束的单元。
- 琐碎、项目局部和不受支持的轨迹会被拒绝。
- 提取器将选定单元映射为类型化、面向任务的候选记录。
- 源主体盲化重建器仅根据记录重新生成代码。
- 源感知判断器接受足够一致的重建结果,并将其余案例转交给裁决器。
- 已接受记录保留最终状态、理由、重建结果,以及仓库、文件、符号和源代码片段级别的来源信息。
质量与使用
- 对流水线结果抽样进行人工标注后显示:
- 92% 的最终技能描述被判定为准确。
- 80% 的最终记录被判定为值得保留。
- 84% 的直接接受记录支持正确重建。
- 拒绝样本较弱:描述准确率为 32%,保留价值为 28%,并且没有正确重建。
- 论文将 CodeSkillBank 用作过程性知识的大规模技能库。提供的摘录没有给出明确的训练划分或混合比例。
方法
作者将技能构造形式化为从源代码单元(例如函数、方法、命令行入口或文件级组件)及其仓库上下文到候选技能记录的映射。有效记录应说明过程何时适用、要复现哪些行为、执行受哪些前置条件和不变式约束、失败应如何处理,以及哪些源代码片段支持这些声明。该形式化提出三项要求。记录必须具有实现依据,也就是说,可恢复的实现片段支持其过程性声明,并通过源主体盲化重建受到检验。记录必须可迁移,也就是说,项目特定的标识符和集成细节被抽象掉,同时保留可复用的前置条件、步骤、不变式和失败处理策略。记录还必须可维护,即保留来源、支持源代码片段、记录类型和构造状态,以便记录可随代码演进被检查、失效或重新生成。
流水线从选择候选过程性证据开始。Code2Skill 扫描 GitHub 仓库并保留较高质量项目,然后解析函数、方法、命令行入口和文件级组件。LLM 标注器选择具有可复用意图、操作结构和可见执行约束的单元。琐碎、项目局部和不受支持的轨迹会被拒绝。选定单元保持候选状态,直到提取阶段分配记录类型,并由重建和裁决确定是否接受。
技能记录生成将每个选定源代码单元及其结构上下文映射为类型化、面向任务的候选记录。作者使用三种记录粒度,因为过程性知识出现在不同的源码范围内。原子技能捕获单个函数或方法内的单一明确定义的操作。复合技能捕获协调多个操作的有序工作流。重复模式技能捕获超出单个局部操作或工作流的更高层实现。每条记录将操作指南与执行约束和支持证据分离,同时保留来源和构造元数据。模式包括所捕获的问题、使用时机、控制规则、工作流、不变式与失败处理、反目标和源代码证据。这些字段保留了过程性步骤、决策边界、可迁移控制规则、不变式和来源信息,超出了传统代码摘要的范围。
为了防止提取遗漏关键操作细节或引入不受支持的约束,流水线使用源主体盲化重建和一致性检查。重建器仅使用记录重新生成代码,而无法访问源代码主体。源感知判断器直接接受足够一致的重建结果,并将其余案例转交给裁决器,裁决器区分不支持的技能记录与重建过程的失败。这一往返过程使用基于 LLM 的比较来检查记录、重建和源代码实现之间的一致性。已接受记录保留最终状态、理由、重建结果以及仓库、文件、符号和源代码片段级别的来源信息,以支持检查、源感知刷新和可追溯性。
在接受之后,面向检索的特征标注为每条已接受记录创建面向任务的检索视图,同时保持一一对应关系。目的索引单独过滤低价值候选记录,按相似目的对记录进行分组,并选择一条已有记录作为每组的代表。两种转换都保持证据档案不变。
在使用方面,每个证据档案支持审计和维护,因为记录保留了来源、重建状态和接受轨迹。下游使用接口控制何时查询技能库、每条检索到的记录展示多少内容,以及在哪个决策点提供该上下文。这涵盖提示级检索、规划时检索、生成后审查、验证器侧奖励使用和训练时技能条件化。给定任务以及决策步骤前的 agent 或模型状态 ht,如果接口使用 qt 查询技能库,则会构造渲染后的技能上下文,并将其传递给接收者的常规策略或模型调用:
zt={Renderr(TopKk(qt;B)),∅,if a query is issued,otherwise.at∼πθ(s)(⋅∣x,ht,zt).这里 B 表示当前评估可用的面向检索的存储,at 表示该决策点的输出,例如生成步骤、计划、审查、验证器判断或环境动作。无技能对照使用相同协议,并令 zt=∅。对于学习时设置,接口还决定评估哪个检查点 θ(s)。技能可以对验证器或奖励模型可见,同时对被判断的策略轨迹保持隐藏;而仅推理协议保持模型或策略参数固定。
实验
在多个模型系列以及涵盖编程、软件工程、终端与操作系统控制以及推理的八个基准上,作者在草稿-审查-修订 agent 循环中评估了离线代码衍生技能库。实验表明,与无技能对照相比,代码衍生技能持续提高 agent 性能,并在统一接口下优于轨迹衍生技能库;规划时检索和生成后审查是比生成时提示更可靠的接入点。紧凑摘要保留了大部分技能效用,同时大幅减少上下文使用;当集成到强化学习中时,技能仍然有益,尤其是通过生成后审查。最后,所测试的 AI 生成实现产生的技能在性能上与人类衍生技能相当,但产生不同的任务级结果,支持从 AI 代码持续扩展。
所有 CodeSkillBank 集成接口均提高了相对于无技能基线的解决率。策略提示和奖励参考带来中等提升,而生成后审查提供最大改进。这些结果来自单一检查点,并未确立学习速度、收敛性或最终策略表现。每个启用技能的条件都优于无技能对照。策略侧和奖励侧接口产生相当的中等改进。生成后审查产生最大的解决率提升,约为策略侧和奖励侧提升的两倍。这些发现反映的是没有重复随机种子或学习曲线的单一检查点。
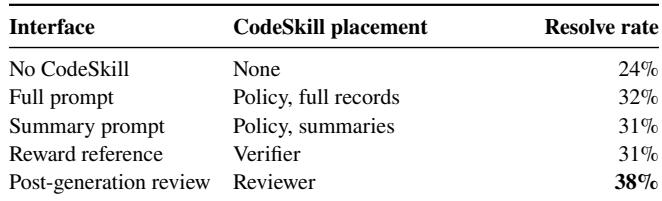
该评估在解决率上比较了 CodeSkillBank 集成接口与无技能基线。策略提示和奖励参考提供相当的中等提升,而生成后审查提供最大改进,约为上述提升的两倍。这些结果来自没有重复随机种子或学习曲线的单一检查点,因此并未确立学习速度、收敛性或最终策略表现。