Command Palette
Search for a command to run...
最后翻译基准
最后翻译基准
摘要
为了科学的进步,我们需要测试最先进模型极限的基准,以及能告知我们失败案例的评估方法。随着模型变得更强,机器翻译的标准基准正接近饱和。此外,自动翻译指标不可靠,容易受到奖励黑客攻击,并提供无法操作的评估。即使是黄金人工评估也并非没有问题,因为它通常缺乏可重复性、客观性和可扩展性。总体而言,这阻碍了我们追踪该领域的客观进展并识别改进路径。我们引入了最后翻译基准,这是一个由人工编写和同行评审的示例(文本、图像、音频、视频)集合,这些示例能够击败领先的机器翻译模型。我们还提出了一种新的评估方法:每个示例都附带手工制作的验证规则,描述该示例上的具体失败案例,从而允许可靠且可操作的未来评估。最后翻译基准是一个实时数据集,接受持续的贡献。最新版本为 LTBv1,包含 2026 年 9 月 1 日之前接受的贡献,随着新数据的持续收集,未来版本将陆续发布。
一句话总结
来自苏黎世联邦理工学院、约翰霍普金斯大学、穆罕默德·本·扎耶德人工智能大学、卡尔斯鲁厄理工学院、阿姆斯特丹大学、卡塔尔大学和查理大学的 researchers 推出了 Last Translation Benchmark(LTBv1),这是一个实时、经同行评审的人工撰写示例集合,涵盖文本、图像、音频和视频,能够击破领先的机器翻译模型,并配以手工设计的验证规则,用于可靠、可操作的评估,以应对基准饱和和指标不可靠的问题。
核心贡献
- 推出 Last Translation Benchmark(LTBv1),一个实时、社区贡献的数据集,包含跨文本、图像、音频和视频的人工撰写并经同行评审的困难示例,能够击破领先的机器翻译模型。
- 提出一种新的评估方法,为每个示例配以手工设计的验证规则,规定具体的成功标准;通过所有规则即视为成功,从而提供可解释的通过率和细粒度失败分析,在不依赖不透明的 LLM 裁判评分的情况下区分劣质翻译。
- 通过示例展示其实用性,例如在严格字符约束下的英译德任务中,验证规则能够暴露通用指标或 LLM 评估器会遗漏的特定失败,如信息丢失;该数据集结构支持持续贡献,并计划未来发布新版本。
引言
机器翻译发展迅速,有时甚至被宣称已达到“普通人类水平”,但公众信任度仍然较低,因为一次关键失败就可能摧毁用户信心。这一差距表明当前研究基准过于简单,且评估方法无法可靠地检测重要错误。静态基准已接近饱和,无法区分强模型,而合成基准往往产生不自然的输入,不能反映真实翻译使用场景。现有指标也存在缺陷:基于重叠的指标与人类判断不一致,训练指标和 LLM 裁判存在偏差且易被攻击,人工评估则不一致、主观且成本高昂。作者推出了 Last Translation Benchmark(LTB),这是一个大规模收集跨文本、图像、音频和视频的难译示例的集合,并配以新的评估方法。每个示例都包含大多数最先进模型难以处理的众包内容,以及针对特定失败模式的验证规则。LLM 裁判充当验证器,翻译必须通过所有规则才算成功,为通用 LLM 评估提供了一种可复现、可解释且成本效益更高的替代方案。该基准目前包含 109 种语言的 3,456 个示例,并被设计为用于长期模型基准测试和诊断的实时数据集。
数据集
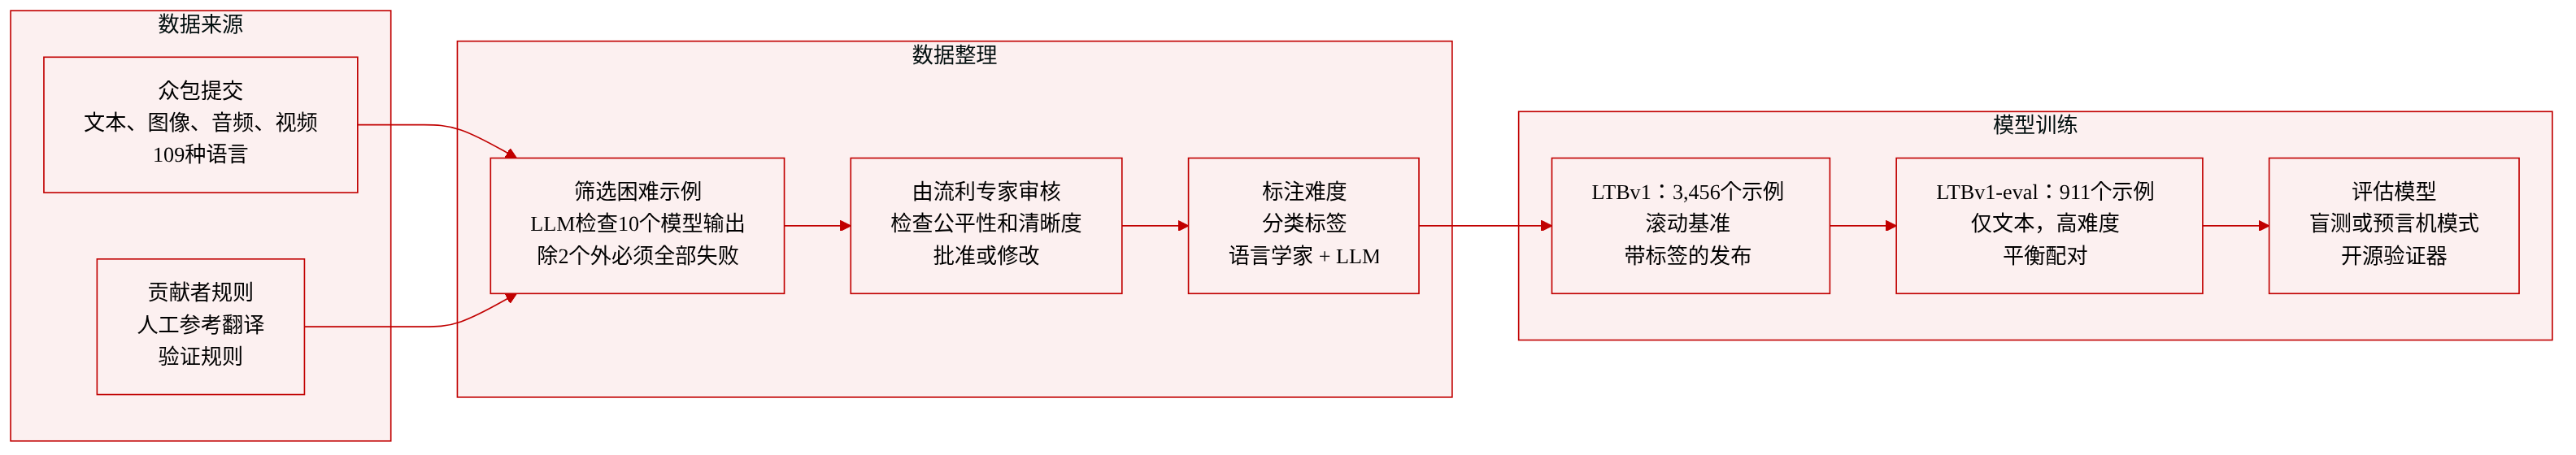
Last Translation Benchmark 是一个众包数据集,旨在收集和评估困难的翻译示例。作者通过一个自定义在线平台构建该数据集,贡献者提交难以翻译的输入,可以是纯文本,也可以包含图像、音频或视频等多模态内容。
数据集构成与来源
- 提交由注册贡献者完成,他们选择源语言和目标语言,可包括用户自定义形式、方言、区域变体或文字系统(例如“瑞士德语(苏黎世)”或“塞尔维亚语(西里尔字母)”)。
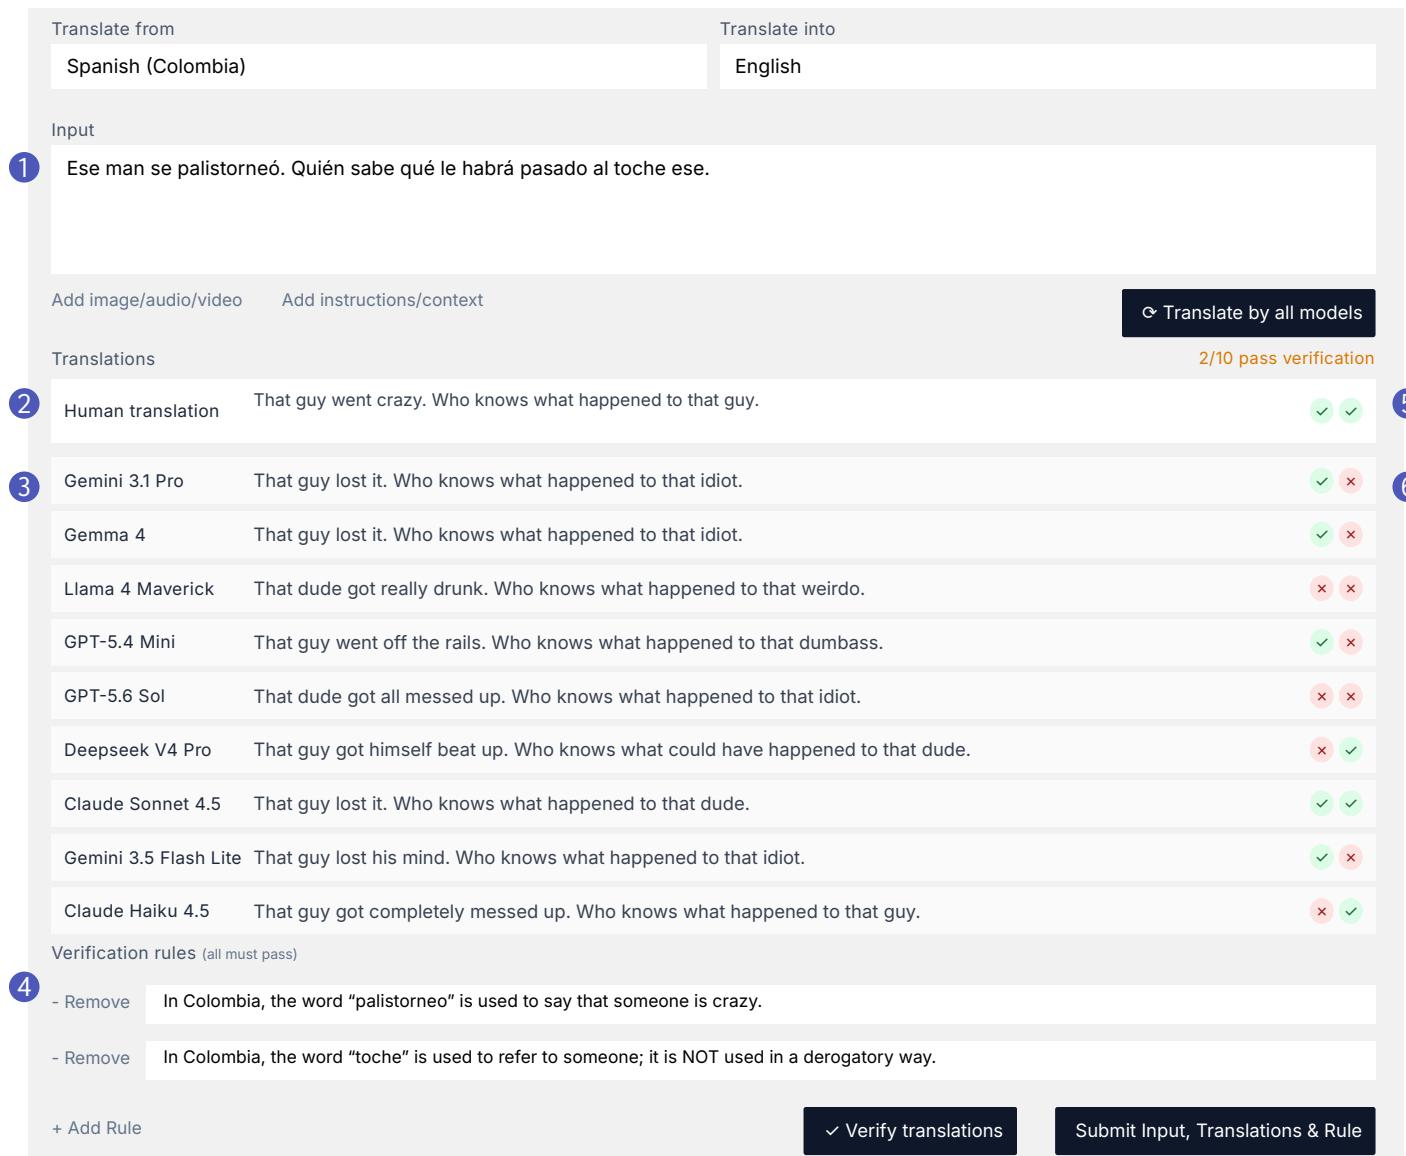
- 每份提交包含输入、人工参考翻译以及贡献者设计的一组验证规则。
- 平台展示来自多种模型的多达 10 个自动翻译结果,贡献者检查这些结果以识别常见失败模式并设计验证规则。
- LLM 根据每条验证规则检查每个候选翻译。要使提交被接受,十个自动翻译中除两个外其余必须至少违反一条规则,而人工翻译必须通过所有规则。
- 每份提交由一名精通相关语言的评审员审核,评审员检查示例是否公平、专家人工翻译者是否能够通过,以及检测到的错误是否可感知且具有实质性。
各子集的关键细节
- LTBv1 包含 3,456 个已接受示例,收集时间为 2026 年 5 月至 2026 年 9 月 1 日,涵盖 109 种主要语言。
- 语言对分布:73% 为非英语到英语,14% 为英语到非英语,13% 为非英语到非英语。
- 大多数提交为文本(94%),平均长度为 19 个词或 104 个字符。
- 示例平均配有 1.9 条验证规则,10% 包含翻译指令。
- 语言资源丰富度(不含英语):30.5% 超高水平,28.3% 高水平,19.0% 中等水平,3.2% 低水平,15.2% 极低水平,3.8% 零水平。
- 语系分布(不含英语):58.9% 印欧语系,8.5% 亚非语系,8.4% 达罗毗荼语系,7.5% 汉藏语系,16.8% 其他。
- 作者还发布了 LTBv1-eval,一个包含 911 个纯文本示例的子集,选取标准为最高难度、输出多样性和语言对平衡。
论文如何使用数据
- 该数据集作为带标记版本的滚动基准使用,随着更多数据收集将发布更多版本。
- 交互式平台上展示的模型集合保持更新,以确保基准持续具有挑战性并包含无污染数据。
- 评估时,作者建议使用开源 LLM 作为验证器以保证可复现性,同时指出不同验证器下结果保持稳定。
- 可在相关子集上报告性能,例如仅文本输入或特定难度类型,这些在发布的数据集中均有标注。
- 公共排行榜支持两种模式:“盲测”模式,模型仅看到输入;“神谕”模式,模型还看到验证规则、正确人工翻译或其他特权信息。推荐使用“盲测”模式来比较现实场景下的翻译模型。
处理与元数据构建
- 多模态示例以两种方式处理:如果媒体未附带文本,则将其作为主要输入直接翻译;如果媒体附带文本,则媒体作为消歧上下文。
- 贡献者可指定翻译指令,例如“使用随意语言”。
- 作者从收集的示例中归纳性地构建了翻译难度分类体系。两位语言学家独立标注了一个子集,并使用 LLM 将标注扩展到 LTBv1 中的所有示例。
- 该分类体系包括以下类别:语义相关挑战(多义词、搭配、风格)、非单语挑战(假朋友、语码混合、目标语空缺)、非组合性或创意性示例(文字游戏、隐喻、元推理、拟声词)、非典型结构(花园路径句、非典型词性)以及语言外技能(文化产物、互联网文化产物、俚语、约束和多模态)。
- 每个示例可标注多个标签,这些标签包含在发布的数据集中,用于筛选和分析。
方法
构建 Last Translation Benchmark
作者通过一个结构化的众包流程构建 Last Translation Benchmark,该流程将人类专业知识与自动验证相结合,确保每个示例对当前翻译系统而言都具有可证明的难度。贡献者注册自定义在线平台并提交他们认为难以翻译的输入。提交可以是文本或多模态形式,包括图像、音频和视频。已接受的提交被聚合到一个持续增长的滚动基准中,并带有标记版本;拥有至少十个已接受提交的贡献者被邀请为数据集共同作者。
提交流程遵循固定流程。首先,贡献者选择源语言和目标语言,可包括用户自定义形式、方言、区域变体或文字系统,例如“瑞士德语(苏黎世)”或“塞尔维亚语(西里尔字母)”。随后贡献者提供示例输入(可以是文本、音频、图像或视频)并撰写正确的参考翻译。平台随后使用多个翻译模型翻译该输入,贡献者检查这些自动翻译以识别常见失败模式。这些观察到的失败作为设计验证规则的基础。LLM 随后根据每条验证规则检查每个候选翻译。为确保提交具有可证明的难度,绝大多数自动翻译(具体为十个中的八个)必须至少违反一条验证规则。同时,提供的人工翻译必须通过所有规则,证明该示例可以被很好地翻译。
每份提交由一名从贡献者池中招募的、精通相关语言的评审员审核。评审员检查提交是否符合指南,并批准或附上评论退回修改。重要的是,评审员验证示例是否公平,即专家人工翻译者在面对相同输入时能够提供通过性翻译。他们还确保验证规则检测到的翻译错误是可感知且重大的失败,而非细微或有争议的问题。
多模态输入需要特殊处理。如果多模态内容未附带文本输入(例如带有文字的标牌图片),则将其作为主要输入直接翻译。如果多模态内容附带文本(例如社交媒体帖子附带的食物图片),则其作为文本输入的消歧上下文。贡献者还可指定翻译指令,例如“使用随意语言”,这些指令被纳入验证过程。
平台交互式展示多达十个模型,使贡献者能够看到模型对其输入的翻译结果,并观察错误和验证判断。这些模型根据流行度、多样性和最先进性能进行选择。特定示例的模型列表可能因语言对以及是否需要多模态支持而有所不同。对于使用 LLM 的翻译,使用专用提示词;对于向贡献者展示的交互式验证,作者使用 Gemini 3.1 Pro 并配以单独的验证提示词。验证针对每条规则与模型的组合单独运行。平均而言,贡献者在提交有效示例前会进行十次翻译尝试。翻译一千个示例的平均成本仅为 0.2 美元,而验证因提示词更长且需针对每条验证规则运行(平均每个示例 1.9 条规则)而更昂贵,每千个示例成本为 1.0 美元。因此,每个被接受示例的平均成本为 0.12 美元。
翻译难度分类体系
基于收集的示例,作者构建了一个翻译难度来源的分类体系。该分类体系与以往翻译评估工作不同,它聚焦于模型输入中困难的来源,而以往工作通常旨在对模型输出中的翻译错误进行分类。该分类体系是描述性的,可被理解为处理对应示例中固有不同难度来源的输入所需的翻译技能集合。
该分类体系是归纳构建的。两位语言学家独立标注了一个示例子集,以理解难以翻译现象的类型,他们使用输入、验证规则以及交互式平台上模型的输出。一个示例可标注多个标签。随后使用 LLM 将标注扩展到基准中的所有示例。
最大的一组困难被标记为“语义相关”,这要求理解意义和上下文并在翻译中加以保留。这包括多义词,即源语言中的某个词在特定领域中具有多个在目标语言中无法对应的义项。例如,领域特定的英语单词“paper”无法正确翻译为德语,因为源词的多义性无法干净映射。模型在保留风格和语气方面仍然困难,示例显示讽刺必须以清晰的方式传达而不能字面化。最常被误译的义项源于对搭配以及意义强度或程度缺乏理解。例如,一个描述暴雨的豪萨语短语被模型误译,未能传达雨势猛烈且持续的特点。
“非单语”组涵盖源语言与目标语言之间交互或语码混合所产生的困难。假朋友是典型示例,即不同语言中形似词被模型混淆。当翻译不应翻译源文本的部分内容、需要将语素转换为词或将词扩展为短语时,模型也缺乏“目标语空缺”技能。例如,土耳其语中表达不确定性的后缀要求英语翻译添加一个表达不确定性的词;日语中表示垃圾账户的借用词需要扩展为西班牙语中的描述性短语。源文本本身也可能要求技能,例如在语码混合文本中区分多种语言,或捕捉语言变体中的细微差异。
“非组合性”或创意性示例要求超越字面意义翻译的技能。即使是最佳模型也难以保持诗性语言的细微差别。文字游戏(如语音双关)要求理解拼写和声音的巧用,而低资源语言中的 tokenization 问题可能使情况更糟。隐喻要求类比推理技能。元推理适用于需要思考示例本身或通过推理处理意义的示例,例如自指句或保留歧义。拟声词是较罕见的情况,要求将词映射到其意义的声音;模型往往无法找到目标语言中等价的拟声词。
最后一类语言困难被标记为“非典型”,涵盖非常见、误导性或对抗性的词、短语或结构选择。示例包括必须同时保留意义和无元音约束的无元音句子、花园路径句,以及非典型词性的词语用法。这些是不寻常但有意义的翻译挑战,与其他语言技能分开处理。
除语言技能外,第二大组需要语言外知识,这类知识不以语言为基础,通常难以在教科书中找到,依赖于实际语言生活经验。大多数是母语者熟知的文化产物,例如韩语中用“奶奶”称呼陌生老人以示尊敬,或习语。互联网文化产物被网络亚文化使用,例如用“面包”表示暗恋对象,或用“印象”加“僵尸”表示垃圾机器人。其他知识技能包括俚语、计量单位等社会惯例以及常见专有名词。
语言外技能还包括处理对翻译输入施加限制的约束。这些在翻译行业中很常见,包括字幕和计算机界面中的长度约束。示例包括保持正确的输出语言、在需要较短释义时保持指定的输出长度、保留输入结构(如对话或菜单布局),以及多模态输入带来的复杂性,这些可能加剧文本困难并要求强大的多模态能力。
实验
评估引入了 Last Translation Benchmark,这是一个众包滚动基准,包含 109 种语言的 3,456 个困难翻译示例,提交必须使大多数自动翻译失败同时通过人工编写的验证规则。结果表明,最先进的模型验证器通过率较低,但当模型获得验证规则时性能大幅提升,表明它们能够满足自己无法独立识别的挑战。基于验证规则的评估在不同 LLM 验证器之间更稳定,与人类判断更一致,且比通用 LLM 裁判或标准指标更不易产生自我偏差。基于实证的翻译难度分类体系揭示了多义词和隐喻等经典挑战,以及元推理、互联网文化产物和语音文字游戏等尚未充分探索的挑战,模型还表现出幻觉、拒绝和指令注入等障碍。
数据集包含 109 种主要语言的 3,456 个已接受示例,以英语为中心的语言对占主导,但值得注意的是 13% 的示例为非英语到非英语。该基准被设计为压力测试,涵盖习语、句法歧义和语用细微差别等多样化语言挑战,并配有验证规则和语言标注以追踪模型失败。英语到非英语语言对占示例的 14%,而非英语到英语语言对占多数,为 73%。非英语到非英语语言对占数据集的 13%,表明有意纳入英语之外的语言对。基准包含带翻译指令的示例(10%),每个示例平均有 1.9 条验证规则。语言挑战涵盖语音、形态、句法、词汇/语义、语用和正字法层面。模型失败包括无关输出、因感知毒性而拒绝、不完整翻译以及指令注入问题。
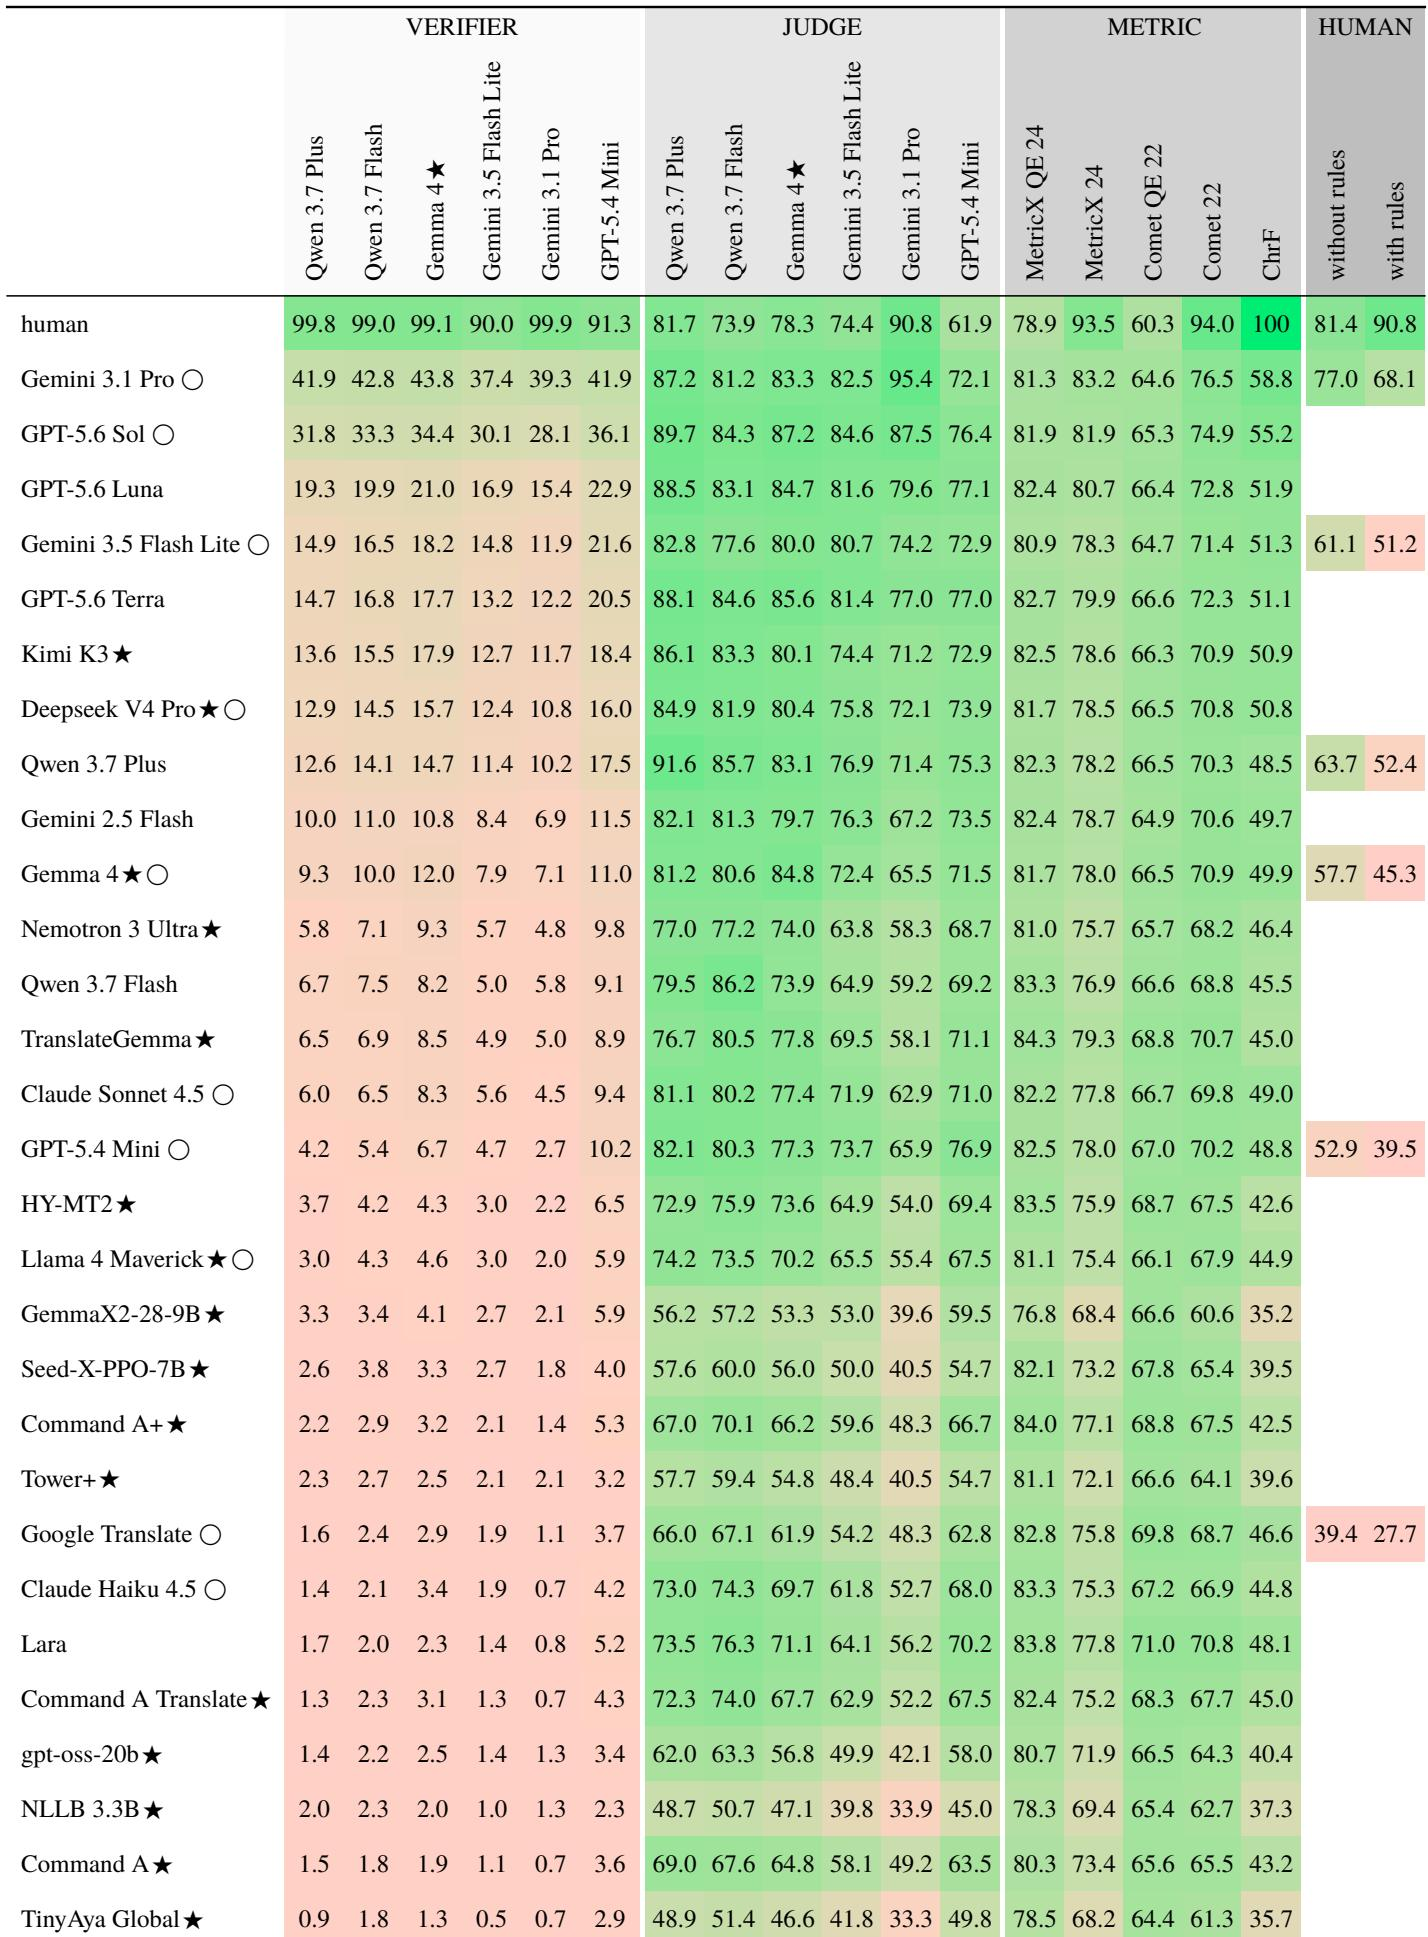
该表使用多种评估方法比较了模型在 Last Translation Benchmark 上的性能,包括基于规则的验证、LLM 裁判、自动指标和人工判断。开放权重模型和展示给贡献者的模型已标记,结果在评估集上取平均。验证器通过率被强调为官方性能指标,而其他指标往往高估翻译质量。验证器通过率是官方指标,且在不同评估器模型选择上比通用 LLM 裁判或神经指标更稳定。通用 LLM 裁判分数对应“良好”翻译,尽管验证器通过率较低,表明感知质量与规则合规之间存在脱节。当模型获得验证规则或人工翻译避免列出的失败情况时,自动指标无法捕捉改进。验证器通过率与人类判断的一致性优于其他评估方法。
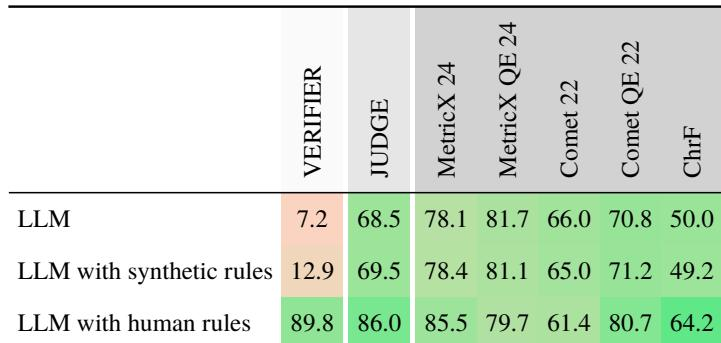
在提示词中为 LLM 提供人工编写的验证规则会显著提升翻译性能(以验证器通过率衡量),而模型自行生成的合成规则仅带来微小改进。这表明 LLM 通常能够满足显式约束,但难以自行识别翻译问题中的具体挑战。人工编写的验证规则相比无规则情况大幅提升验证器通过率。LLM 生成的合成规则仅产生边际改进,远低于人工规则下的性能。人工规则带来的改进表明 LLM 能够遵循显式约束,但无法独立推断所需的翻译挑战。
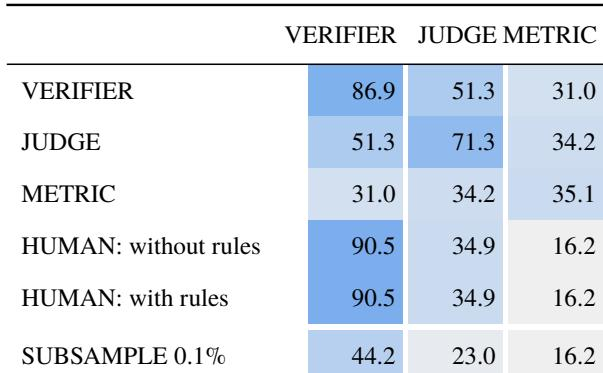
该表比较了三种评估方法的排名相似性:基于验证器、LLM 裁判和神经指标。基于验证器的评估在不同模型选择下高度稳定,且与人类排名高度一致,而通用裁判和神经指标稳定性较低,与人类判断一致性也较差。基于验证器的排名在不同评估器模型下高度稳定,相似度约为 86.9。通用裁判和神经指标排名稳定性较低,自相似度分别约为 71.3 和 35.1。基于验证器的排名与人类排名的一致性(90.5)远高于裁判或指标排名(分别为 34.9 和 16.2)。跨方法一致性较低,表明不同评估方法会产生不同的模型排名。
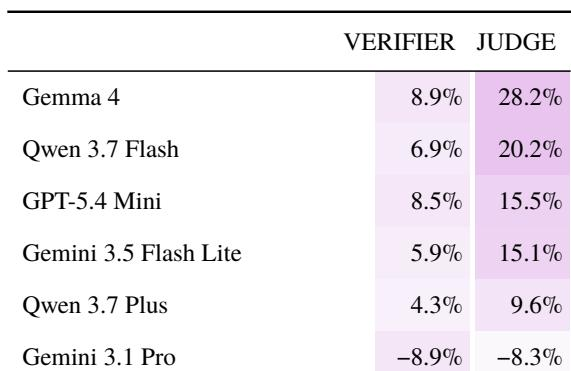
该表衡量模型自我偏差,即模型自身排名与其他 LLM 对其排名之间的差异,正值表示自我偏好。在所列模型中,基于验证器的自我偏差始终低于基于裁判的自我偏差,表明使用验证规则降低了评估器的主观性。最大的自我偏好出现在裁判设置中,而某些模型在两种条件下均表现出轻微自我不偏好。对于所列每个模型,基于验证器的自我偏差值明显低于基于裁判的值。Gemma 4 在裁判设置中表现出最高的自我偏好,而 Gemini 3.1 Pro 是唯一在两种条件下均具有负自我偏差的模型。验证器与裁判自我偏差之间的差距在 Gemma 4 和 Qwen 3.7 Flash 上最大,表明验证规则有助于缓解评估器自我偏好。大多数模型表现出正自我偏好,但使用验证规则时幅度减小,支持验证器方法的客观性。
该基准评估了 109 种语言的 3,456 个翻译示例,以英语为中心的语言对占主导,13% 为非英语到非英语语言对,并包含从语音到正字法层面的语言挑战。基于人工编写验证规则的验证器通过率是官方指标,在不同评估器模型上表现出更强的稳定性,且与人类判断的一致性优于通用 LLM 裁判或神经指标,后者往往高估质量。为 LLM 提供人工编写的验证规则可大幅提升验证器通过率,而合成规则仅带来边际收益,表明模型能够遵循显式约束但难以独立推断挑战。基于验证器的排名也比裁判或指标排名更稳定且与人类排名更一致,基于验证器的自我偏差始终低于基于裁判的自我偏差,表明验证规则降低了评估器主观性。