Command Palette
Search for a command to run...
面向航天器交会与近距离操作的 GPU 加速天体动力学世界模型
面向航天器交会与近距离操作的 GPU 加速天体动力学世界模型
Duncan Eddy Isaac R. Ward Grace Ra Kim Mykel J. Kochenderfer
摘要
世界模型是表示学习中的一种新兴范式,其中智能体从离线轨迹数据中联合学习状态-动作动力学和观测模型,从而能够进行带不确定性估计的多步规划和轨迹预测。世界模型在机器人和游戏环境中已展现出强大的成果,但据我们所知,此前尚未应用于太空领域。本文提出了一种基于世界模型的方法,用于合作与非合作航天器的交会与近距离操作,并做出了三项贡献。首先,我们引入了一个基于 JAX 的开源国际空间站(ISS)对接仿真环境,支持基于 GPU 的并行航天器轨道和姿态动力学仿真,生成世界模型训练所需的数千个状态-动作转移。其次,我们提出了“天外世界模型”,一种基于 Transformer 的世界模型,它将相对运动学状态和星体固定相机图像编码为潜在状态,并使用一步流匹配预测其在受控推力和控制扭矩下的演变。该模型生成未来观测的分布,捕获随机动力学并提供每个时间步的不确定性估计,并且以更少的可训练参数和超参数,实现了优于 DreamerV3 风格后验校正基线的预测性能。第三,我们将该方法应用于在保持区约束下自主对接国际空间站的太空舱,展示了相较于强化学习基线更高的样本效率和任务性能(跨端口对接成功率为 53% 对 29%),显著更好的分布外泛化能力(在保留端口上,世界模型的基线成功率提高了一倍以上,40% 对 17%),以及对对接接近过程中遇到的异常物体的检测,分类准确率达 98%。我们开源了仿真环境和模型架构,以促进对该范式的进一步研究。
一句话总结
斯坦福大学的研究人员提出了 Out-of-this-World-Model,一种基于 JAX 的 transformer 世界模型,用于航天器交会与近距操作。该模型将相对运动学和相机图像编码为潜在状态,通过单步流匹配预测在指令推力作用下的状态演化,实现 53% 对比 29% 的对接成功率,在未见过的停靠端口上的分布外泛化能力提升超过一倍(40% 对比 17%),并在国际空间站对接环境中达到 98% 的异常检测准确率。
核心贡献
- 提出 AstroJAX,一个开源的、基于 JAX 的国际空间站对接仿真环境,可在 GPU 上并行运行航天器轨道与姿态动力学,支持生成 500,000 条状态-动作转移数据用于世界模型训练。
- 提出 Out-of-this-World-Model,一种基于 transformer 的世界模型,将相对运动学状态与船体固定相机图像融合为潜在表示,并通过单步流匹配预测未来观测,在可训练参数和超参数更少的情况下,预测性能优于 DreamerV3 风格基线。
- 将该方法应用于受禁入区约束的太空舱与国际空间站对接任务,结果表明对接成功率优于强化学习基线(各端口综合 53% 对比 29%),在未见过的停靠端口上成功率提升超过一倍(40% 对比 17%),并在接近过程中以 98% 的分类准确率检测异常物体。
引言
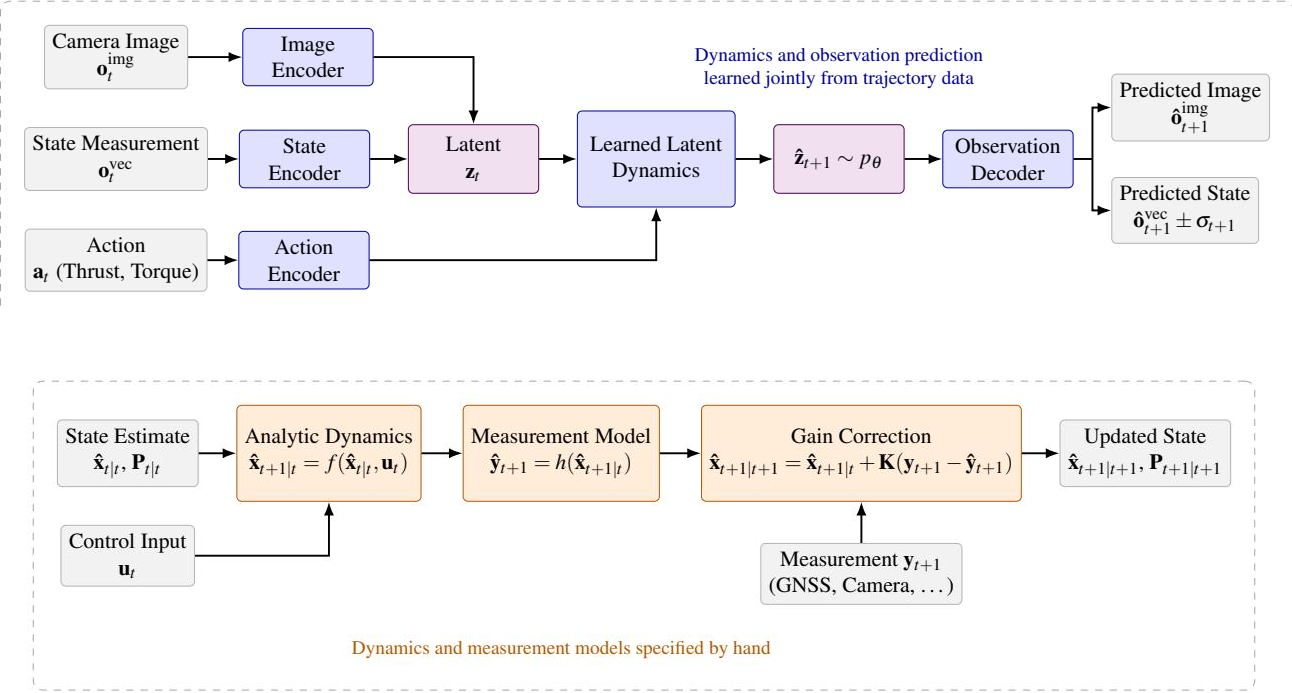
航天器交会与近距操作(RPO)正从罕见的人工监督任务转变为覆盖民用、军事和商业领域的常规任务,应用场景包括国际空间站对接、在轨服务及卫星延寿等。传统制导、导航与控制(GNC)系统依赖卡尔曼滤波和模型预测控制,难以处理相机图像等丰富传感器数据,需要预处理流水线并假设精确的动力学模型。现有基于学习的方法,如直接回归或物理信息神经网络,无法预测传感器观测或在长时间范围内性能退化,而强化学习仅提供反应式策略,缺乏可复用的系统模型。作者引入了一种世界模型方法,从轨迹数据中学习联合状态-动作动力学与观测模型,提出了 GPU 加速仿真框架 AstroJAX 以及基于 transformer 的架构 Out-of-this-World-Model(OWM),融合运动学与视觉数据以预测未来观测。该模型在国际空间站各端口的对接成功率上表现更优,可泛化至未见过的停靠端口,并以 98% 的准确率检测异常,标志着世界模型首次应用于空间操作任务。
数据集
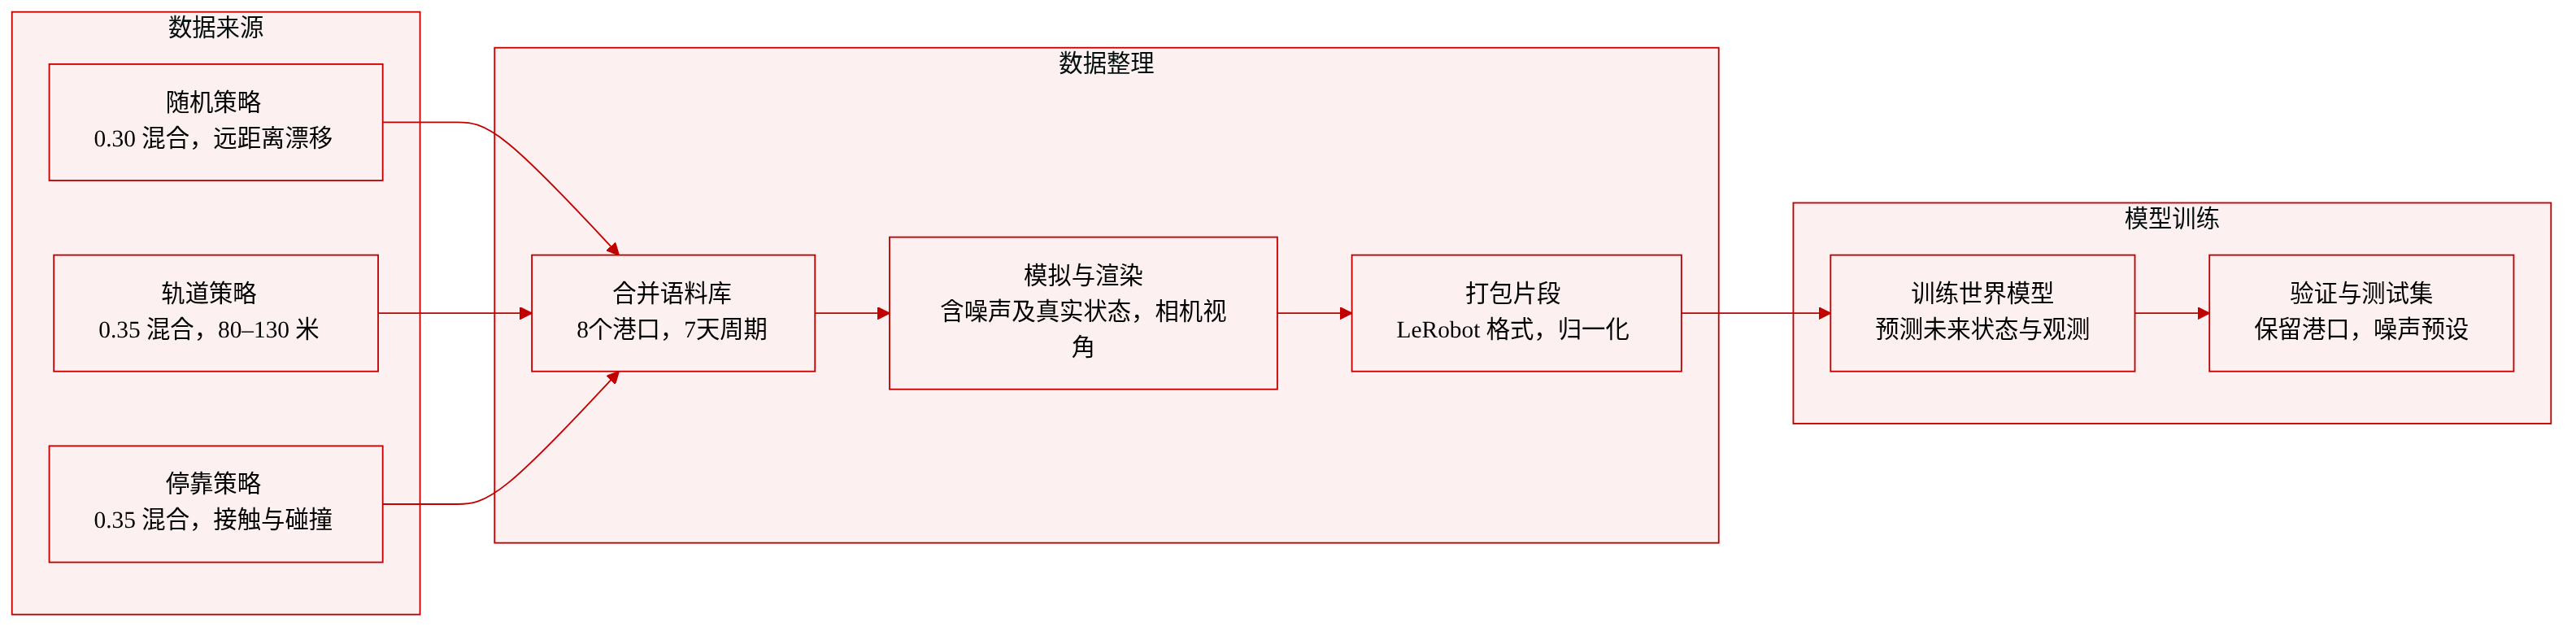
数据集构成与来源
作者构建了一个用于国际空间站对接环境中学习世界模型的数据集。数据由三个共享任务层但方程运动保真度不同的仿真环境合成生成。论文结果使用其中保真度最高的成员 iss-numerical,即 Dragon 级追踪飞行器与国际空间站主星的完整数值仿真。
仿真将两个飞行器分别作为地心惯性系中的独立状态向量传播,包含四阶带状重力谐波、来自太阳和月球的第三体加速度,以及采用 Harris-Priester 密度模型的大气阻力。追踪飞行器的姿态采用四元数运动学和刚体欧拉动力学。完整状态为 21 维,使用四阶 Runge-Kutta 格式以 0.05 秒时间步长积分,每个回合最多 7200 步(360 秒)。
各子集的关键细节
数据集包含由三种行为策略生成的轨迹,训练划分按 0.30/0.35/0.35 的比例混合:
- 随机策略:采样均匀的力和力矩指令,产生无定向漂移,覆盖远离空间站的状态空间。
- 轨道策略:在 80 米至 130 米之间采样的半径上执行比例-微分跟踪的环绕飞行,使模型暴露于持续的横向运动和多样化的观测几何。
- 对接策略:执行临界阻尼比例-微分趋近至采样的对接端口。其中约一半的趋近满足接触条件,其余以记录的碰撞结束,覆盖接触邻近的失效模式。
每个回合将追踪飞行器初始化在距空间站原点 100 米至 225 米之间均匀采样的半径处,机头朝向空间站,历元在七天内均匀采样,从而覆盖太阳β角和光照条件的变化。
训练划分与未见过的停靠端口
训练划分的对接通道目标为八个端口中的五个:Harmony 前向、Harmony 天底、Zvezda 尾部、Pirs 天底和 Rassvet 天底。其余三个端口(Harmony 天顶、Poisk 天顶、Unity 天底)仅出现在评估中,提供具有未见目标位姿、接近走廊和视觉上下文的留出泛化测试。
传感器噪声与观测模型
每帧记录真实状态、带噪观测向量、动作、奖励以及渲染的第一人称相机视图,以 LeRobot 格式打包,归一化统计量仅基于训练划分计算。
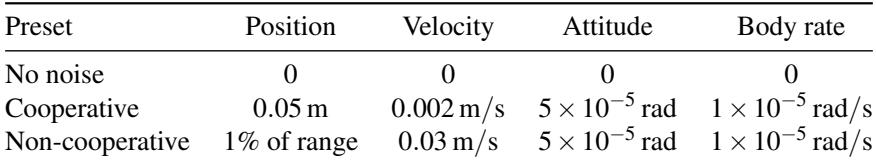
传感器噪声采用以下三种模型之一:
- 协作式:差分 GNSS 级相对导航,具有固定的位置误差预算。
- 非协作式:基于视觉的导航,位置误差随距离增加,速度估计较粗糙。
- 无噪声:用于隔离和量化世界模型重构误差。
姿态和角速度噪声假设来自追踪飞行器自身的星敏感器和陀螺仪,在两种噪声预设下保持一致。所有噪声幅度均为总均方根误差。
处理与渲染细节
运动学观测通道通过可配置高斯传感器模型报告 13 维相对视图(相对位置、速度、姿态四元数和角速度)。视觉通道为追踪飞行器机头相机拍摄的 512 x 512 第一人称视图,垂直视场角为 82 度。帧以 20 Hz 仿真频率从记录的仿真状态渲染,使用基于物理的渲染器,包含全纹理地球、星空、月球和依赖历元的太阳光照。
模型中的数据使用
行为策略基于带噪声的测量而非真实状态进行决策,因此记录的动作-结果对反映了基于观测状态行动时的偶然转移不确定性。这是有意为之,世界模型从不基于奖励函数进行训练。训练数据用于训练世界模型预测未来状态和观测,混合策略语料提供了对目标导向、无定向和接触邻近运动的广泛覆盖。
方法
作者将对接场景建模为离散时间部分可观测决策过程,其中世界模型近似给定过去观测和动作历史条件下下一观测的分布。所提出的架构采用模态参数化设计,使同一骨干网络能够处理任意输入流组合。
如下图所示:
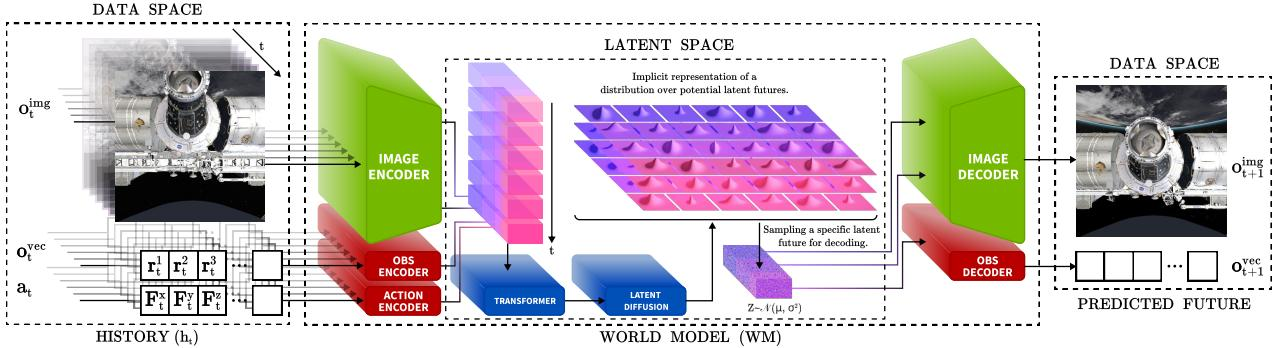
每个输入流为每时间步的 token 向量贡献固定数量的 token。一个轻量级多层感知器投影运动学状态测量,视觉 transformer 通过学习到的注意力瓶颈将每帧相机图像编码为图像 token,该瓶颈将少量潜在查询与帧的块嵌入进行交叉注意力。第二个多层感知器将动作投影为附加 token,作为条件信息追加到每时间步向量中。这些状态、图像和动作 token 的拼接构成每个时间步的潜在状态。
骨干网络为分解的空间-时间 transformer。每个块先执行空间注意力,即对单个时间步内的 token 进行双向注意力以融合状态、动作和图像信息,随后执行时间注意力,在滑动窗口内使用旋转位置嵌入对时间步进行因果注意力。这种注意力分解将计算成本从完整 token 序列的二次复杂度降低为各轴分别的二次复杂度。此外,键值缓存支持随水平长度线性增长的自回归 rollout,解决规划期间的吞吐瓶颈。
预测完全在潜在空间中进行,使用独立应用于每个 token 的流匹配头。以当前时间步的骨干输出为条件,该头学习一个速度场,将标准高斯样本输送到下一潜在状态与当前潜在状态之间的残差。采样得到的潜在向量追加到 token 历史中,模型通过潜在空间自回归向前滚动,循环过程中不解码为观测。仅当需要观测空间输出时,模态特定的解码头才将潜在向量映射回预测图像和状态。
训练过程基于从记录轨迹中采样的上下文步加 rollout 步窗口。流匹配头使用潜在残差上的整流流目标进行训练。对于噪声样本 ε∼N(0,I) 和噪声水平 τ∼U(0,1),加噪输入位于数据与噪声之间的直线上:
xτ=(1−τ)Δzt+1+τε该头通过最小化平方误差来回归该路径的恒定速度:
Lflow=∥fθ(xτ,τ,ht)−(ε−Δzt+1)∥2为了使潜在空间锚定于观测,作者引入两类重构项。逐模态解码损失从预测的潜在向量重构每个观测流:
Lmdec=∣S∣1t∈S∑∥gm(z^t)−otm∥2而潜在往返锚定项从真实观测自身的编码重构该观测,以保持 token 编解码器接近恒等映射:
Lmrt=T1t∑∥gm(zt)−otm∥2这些项以加权和的形式组合:
L=λflowLflow+m∑wmLmdec+m∑βmLmrt训练过程中,模型基于自身预测进行自回归推进,教师强制概率在初始若干 epoch 内从 1 退火至 0。优化采用 AdamW,混合 bfloat16 精度和梯度范数裁剪。
实验
实验评估了基于世界模型的规划器在国际空间站对接任务中的表现,并与 PPO 强化学习基线在不同传感器噪声体制下、分别在训练端口和未见端口上进行比较。流匹配世界模型在预测质量上优于 Dreamer 风格基线,其规划器在分布内对接中与 PPO 持平或更优,并可泛化至全部三个未见端口,而 PPO 在其中两个端口上失败。然而,由于更多的奖励调优,PPO 实现了更严格的终端接触条件。世界模型还能以 98% 的准确率检测新出现的异常物体,将预测不确定性集中于意外元素上。
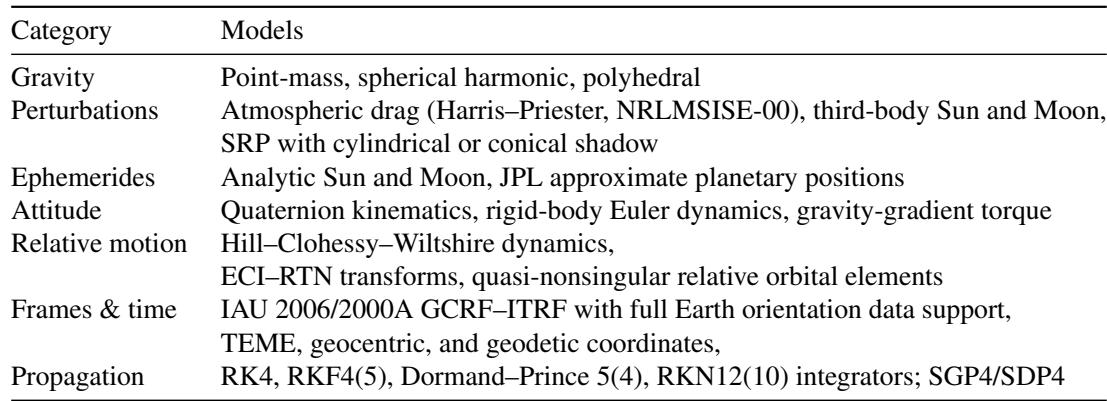
AstroJAX 是一个开源的、可微分的天体动力学库,基于 JAX 实现,涵盖重力模型、摄动、星历、姿态动力学、相对运动、坐标系、时间和传播。与 brahe 库的验证表明大多数模型高度一致,但 NRLMSISE-00 大气密度模型除外,其精度目前有限。该库包含从点质量和球谐重力到大气阻力、太阳辐射压和多种积分器在内的广泛模型。坐标系变换与 IAU SOFA 参考值高度一致,大多数加速度与 brahe 在相对容差内一致。NRLMSISE-00 大气密度模型是主要异常项,一致性限制在约 15% 以内。
生成的数据集包含 500,000 条训练转移(采用混合策略比例)和 50,000 条验证转移(仅使用对接策略)。训练覆盖五个对接端口,验证覆盖全部八个端口,其中三个端口留作泛化测试。每帧存储状态、带噪观测、动作、奖励和渲染相机视图,动作应用噪声模型以反映偶然不确定性。训练按 0.30/0.35/0.35 的比例混合随机、轨道和对接策略,验证仅使用对接策略。训练划分使用五个对接端口,三个端口(Harmony 天顶、Poisk 天顶、Unity 天底)在训练中不出现,用于留出评估。传感器噪声应用于行为策略使用的观测,使记录的转移动力学反映真实世界的不确定性而非确定性真实状态动力学。
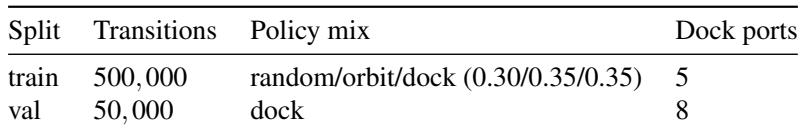
传感器噪声在三种预设下建模:无噪声、协作式和非协作式。协作式使用固定位置误差,非协作式位置误差随距离缩放。姿态和角速度噪声在协作式和非协作式预设下相同。非协作式位置误差按距离的 1% 增长,协作式使用固定 0.05 米误差。速度噪声非协作式(0.03 米/秒)大于协作式(0.002 米/秒)。姿态和角速度噪声在协作式和非协作式模型下相同。
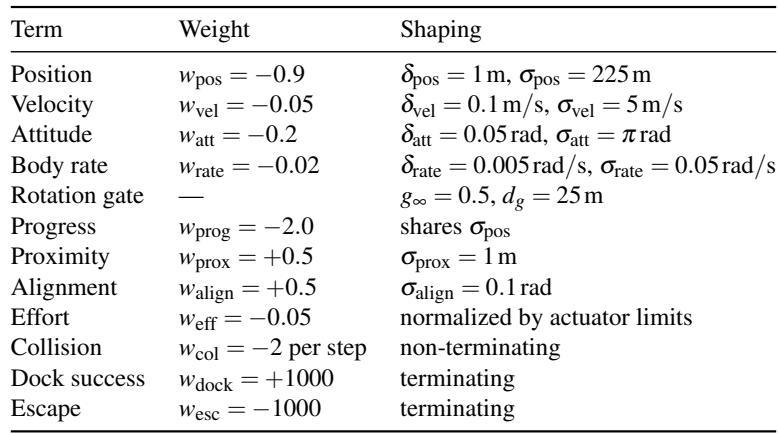
该表指定了用于训练对接任务 PPO(近端策略优化)基线的奖励塑形参数。权重和塑形核经过调优以优先实现缓慢、指向明确的趋近,位置误差惩罚较大,姿态误差惩罚适中,同时为接近和进展提供较小的正向奖励。这些参数是必要的,因为默认环境配置使时间差分学习失效。位置误差惩罚以 −0.9 的权重和较宽的塑形尺度主导奖励,鼓励智能体缩短与对接端口的距离。姿态和角速度惩罚相对较小,但仅在智能体接近端口时激活,塑造指向明确的最终趋近。距离变化相对于位置尺度的进展奖励为 −2.0,鼓励向目标稳定推进。正向接近和对齐奖励仅在较小半径内激活,在端口附近提供稀疏的额外激励。基线需要大量调优这些参数才能实现有意义的对接行为,凸显了该任务对无模型强化学习的难度。
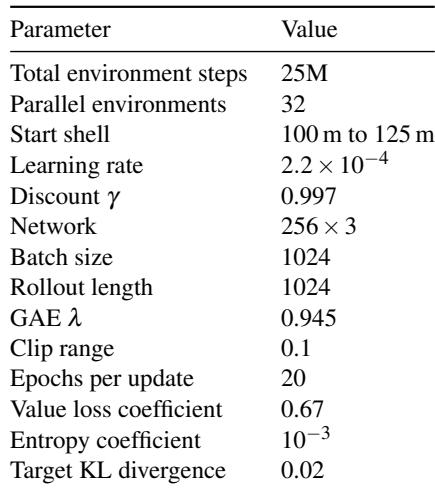
该表记录了适用于对接任务的 PPO 基线配置,包括 2500 万总环境步、32 个并行环境和 0.997 折扣因子。基线使用 256x3 网络和 1 Hz 控制步长以缓解奖励稀疏问题,其奖励函数包含多项塑形项。所引用的分析表明,在仅以位置判定成功时规划器优于 PPO,但在完整接触条件下 PPO 成功率更高,而规划器在天顶端口上的逃逸率为零,PPO 的逃逸率则较高。PPO 在 32 个并行环境中训练 2500 万步,折扣因子为 0.997。基线使用 1 Hz 控制步长缓解奖励稀疏问题,因为原生 20 Hz 步长使终端奖励可忽略。在仅以位置判定成功时,规划器在所有容差下均优于 PPO,但在完整接触条件下 PPO 成功率更高,这归因于调优投入。规划器在所有端口上的逃逸率为 0%,而 PPO 在每个天顶端口的 rollout 中逃逸率为 88%,表明 PPO 较低的碰撞率反映的是未完成的趋近。规划器的残余失效模式是天顶趋近中的碰撞,而 PPO 的失效模式是通过逃逸丢失目标捕获。
AstroJAX 是基于 JAX 的可微分天体动力学库,与 brahe 的验证显示大多数模型高度一致,但 NRLMSISE-00 大气密度模型除外,其精度限制在约 15% 以内;坐标系变换与 IAU SOFA 参考值高度一致。生成的对接强化学习数据集包含独立的训练和验证划分,使用 5 个训练端口和 3 个留出端口,传感器噪声在三种预设(无、协作式、非协作式)下建模,非协作式误差随距离缩放。对于 PPO 基线,奖励塑形经过大量调优以应对奖励稀疏问题,以主导性的位置误差惩罚和端口附近奖励为主;规划器在仅以位置判定成功时优于 PPO,但在完整接触条件下 PPO 成功率更高,而规划器逃逸率为 0%,PPO 在天顶端口上的逃逸率达 88%,表明 PPO 的碰撞更多是未完成的趋近。