Command Palette
Search for a command to run...
Vero:面向通用视觉推理的开放 RL 配方
Vero:面向通用视觉推理的开放 RL 配方
Gabriel Sarch Linrong Cai Qunzhong Wang Haoyang Wu Danqi Chen Zhuang Liu
摘要
构建一个能够在图表、科学、空间理解以及开放式任务中均能发挥作用的视觉推理器,需要具备哪些条件?最强的视觉语言模型(VLM)表明,广泛的视觉推理已触手可及,然而其封闭的数据和强化学习(RL)流程使得这些成果难以研究、复现或扩展。我们推出了 Vero,一个完全开放的 VLM 系列,在多种视觉推理任务上达到或超越现有开放权重模型。我们跨六个广泛的任务类别扩展了 RL 数据和奖励,构建了 Vero-600K,这是一个包含 59 个数据集、60 万样本的数据集,并设计了任务路由奖励以处理异构答案。在我们的 30 基准套件 VeroEval 上,Vero-600K 在受控比较中优于现有的 RL 数据集。应用于五个起始模型时,Vero 变体平均比其初始模型提升 2.9–5.4 分。值得注意的是,基于 Instruct 模型训练的 Vero-Qwen3I-8B,在无需额外蒸馏的情况下,平均超越 Qwen3-VL-8B-Thinking 3.8 分。系统性消融实验揭示,不同任务类别会引发不同的推理模式,而广泛的性能提升依赖于联合学习这些模式,而非孤立学习。所有数据、代码和模型均已公开。
一句话总结
普林斯顿大学的研究人员推出了 Vero,一个完全开源的视觉语言模型系列,通过 Vero-600K 数据集和任务路由奖励,在六类任务上扩展强化学习数据和奖励,在多样化视觉推理任务上达到或超越现有开源权重模型,在五个起始模型上平均提升 2.9–5.4 分,并在无蒸馏的情况下超越 Qwen3-VL-8B-Thinking 达 3.8 分。
核心贡献
- 推出 Vero,一个完全开源的视觉语言模型系列,使用单阶段强化学习在 Vero-600K 上训练,该数据集包含来自六类任务、59 个数据集的 60 万样本,采用任务路由奖励以适配异构答案格式。
- 在包含 30 个基准的 VeroEval 评测套件中,Vero-600K 在受控比较下优于现有强化学习数据集;将 Vero 变体应用于五个起始模型后平均提升 2.9–5.4 分,其中 Vero-Qwen3I-8B 在无蒸馏的情况下平均超越 Qwen3-VL-8B-Thinking 达 3.8 分。
- 系统性消融实验表明,不同任务类别会激发不同的推理模式,例如 STEM 任务中回溯行为增多,而定位任务中则呈现类似视觉搜索的行为;广泛的性能提升依赖于以均衡、均匀暴露的方式联合学习这些类别,从而将多任务强化学习重新定义为一种分布设计问题。
引言
视觉语言模型日益被期望处理广泛的视觉任务,从图表解读到空间推理和开放式问题。强化学习已成为推动进展的关键因素,然而现有最强模型依赖专有流程,其奖励设计和训练数据未公开,使得系统研究性能驱动因素变得困难。完全开源的工作往往聚焦于视觉数学等狭窄领域,而在单一任务类别上训练无法很好地泛化到其他视觉能力。
作者推出 Vero,一个完全开源的视觉语言模型系列,采用单阶段强化学习方案,无需专有数据、热启动或分阶段训练。作者构建了 Vero-600K,一个包含来自 59 个数据集、覆盖六类任务的 60 万样本数据集,并配以任务路由奖励函数。通过系统性消融实验,作者发现数据多样性是关键要素,不同任务类别会激发不同的推理模式,这些模式在孤立训练时迁移效果较差。该方案在不同模型家族上均带来一致提升,在整体基准分数上比后训练模型提高 +2.9 至 +5.4 分,直接应用于仅预训练的基础模型时最高提升 +12.9 分。作者公开了全部数据、代码和模型,以支持开源研究。
数据集

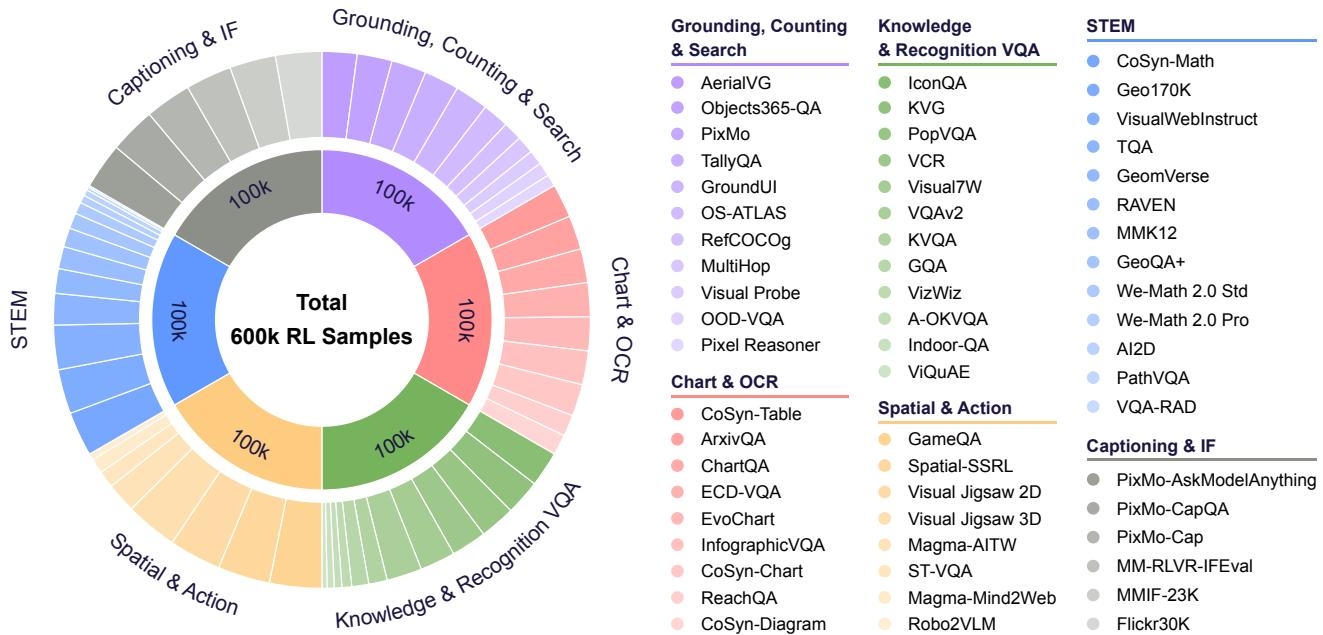
作者构建了 Vero-600K,一个多任务强化学习训练集,包含来自 59 个数据集的 60 万样本。数据按六类任务组织,每类针对一种独特的视觉推理能力。各类别如下:
- STEM(13 个数据集): 数学图表推理、科学图像解读和医学图像理解,答案多为数值或符号形式。
- 空间与动作(8 个数据集): 具身推理、UI 导航和 3D 空间理解,需要对空间变换和动作序列进行推理。
- 知识与识别(12 个数据集): 结合物体、场景和实体识别与外部或常识知识的视觉问答。
- 图表与 OCR(9 个数据集): 从文档、图表、表格和信息图中提取并推理结构化信息。
- 定位、计数与搜索(11 个数据集): 通过边界框对物体进行空间定位、对实体实例进行计数以及在视觉干扰物中进行搜索。
- 描述与指令跟随(6 个数据集): 开放式图像描述和遵循提示指令。
数据整理流程包括三个步骤:
-
数据集来源与筛选: 作者从指令微调和强化学习集合(如 FineVision)以及近期发布的任务特定来源中选取超过 250 个候选数据集。作者应用启发式过滤,剔除样本数少于 1K、平均图像分辨率低于 20 万像素(保留五个低分辨率数据集以保证问题质量)或包含二元问题的数据集。随后对每个候选数据集人工检查约 50 个样本,依据三个标准:正确性(标注错误率低于 5%)、无歧义性(存在唯一可验证答案)和可验证性(答案格式与奖励函数兼容)。在通过启发式筛选的约 100 个数据集中保留了 59 个。对少数数据集,作者重写问题以修正提示清晰度或剔除高错误率子集。
-
数据过滤: 在数据集级过滤后,对单个样本进一步过滤。问题过滤使用 Qwen3-VL-235B-A22B-Instruct 剔除模糊、与图像无关或不可验证的问题,对每个数据点在相关性、歧义性、语言、可验证性和数值精度上进行评分。答案过滤使用纯文本 Qwen3-235B-A22B-Instruct 对标准答案进行归一化。数值答案去除单位和货币符号,转换为小数形式,并按表达式求值。选择题答案归一化为单一规范字母。除描述和指令跟随外,具有多值答案、不可化简符号表达式或模糊描述的样本均被剔除。答案过滤不应用于空间与动作或定位任务,因为这些任务的答案已标准化。
-
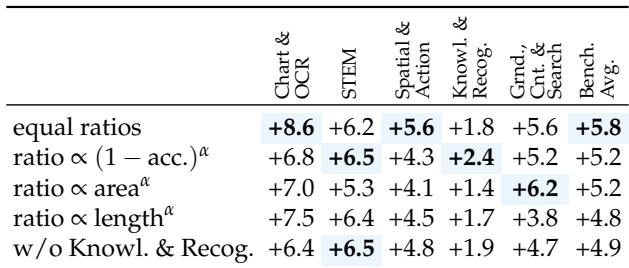
数据混合: 作者研究了四种任务类别权重方案(均匀、难度加权、图像大小加权、推理长度加权)。均匀采样取得最高的基准平均提升(相对基础模型 +5.8 分),因此被用于训练。
作者还引入了 VeroEval,一个包含 30 个基准的评测套件,覆盖六类任务,每类包含三至八个基准。基准选择依据难度(优先选择前沿模型仍有提升空间的基准)、标注质量和类别内多样性。
方法
作者构建了 Vero-600K,一个多任务强化学习训练集,包含覆盖六类任务的 60 万样本。数据整理流程包括多个阶段的来源筛选、过滤和混合,以确保高质量的训练数据。
如下图所示:
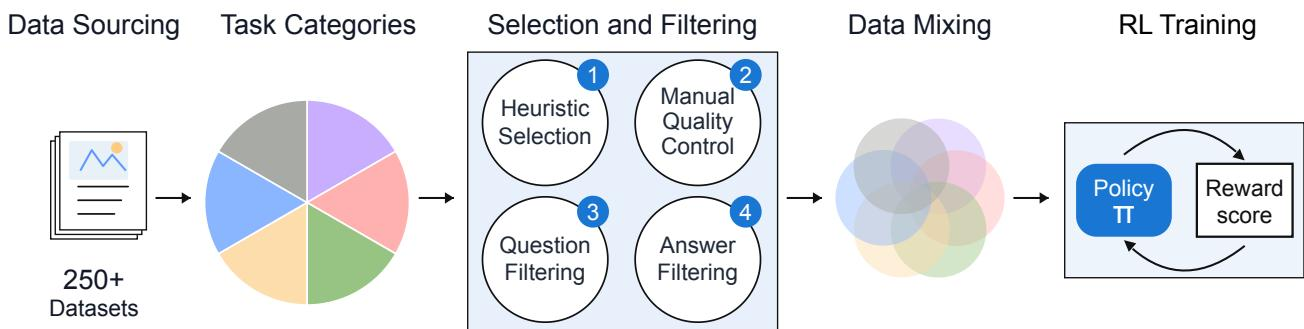
流程始于从超过 250 个候选数据集中进行来源筛选。作者应用启发式选择,剔除样本数少于 1K、平均图像分辨率低或包含二元问题的数据集。随后进行人工质量控制,对每个数据集约 50 个样本检查正确性、无歧义性和可验证性。为进一步精炼数据,作者采用基于 LLM 的问题过滤来剔除模糊或不可验证的提示,以及答案过滤来归一化标准答案以支持稳定的奖励计算。保留的数据随后按任务类别合并为均匀加权混合。下图展示了六类任务的代表性样本,突出训练集所覆盖的视觉输入和答案类型的多样性。
如下图所示:
在训练过程中,作者使用强化学习,基于组相对策略优化(GRPO)并整合 GSPO 的算法进展。GSPO 将独立的逐 token 重要性比率替换为序列级比率。对于一组 G 次 rollout 中的每个响应 y,使用序列平均对数概率差 Δˉi=∣yi∣1∑t(logπθ(yi,t)−logπθold(yi,t)) 来形成 token 级比率 si,t(θ)=exp(sg(Δˉi)+logπθ(yi,t)−sg(logπθ(yi,t))),其中 sg 表示停止梯度。GSPO 目标定义为:
J(θ)=G1i=1∑G∣yi∣1t=1∑∣yi∣min(si,t(θ)Ai,clip(si,t(θ),1−εlow,1+εhigh)Ai)其中 Ai=(ri−μg)/(σg+ϵ) 是归一化组优势。作者采用非对称的 clip-higher 策略,移除 KL 惩罚以允许更少限制的更新,并应用在上下文限制前线性上升的软超长惩罚。
响应 y 的总奖励公式为:
R(y,y∗)=(1−α)Racc(y,y∗)+αRfmt(y)+Roverlong(y)其中 α=0.2。格式奖励 Rfmt 要求响应遵循特定结构,包含非空的思考内容和格式正确的答案块。超长惩罚 Roverlong 在缓冲区内使用线性上升以抑制过长的响应。
对于准确率奖励 Racc,作者设计了十个任务路由奖励函数,对应数据集中的不同任务类型。
如下图所示:
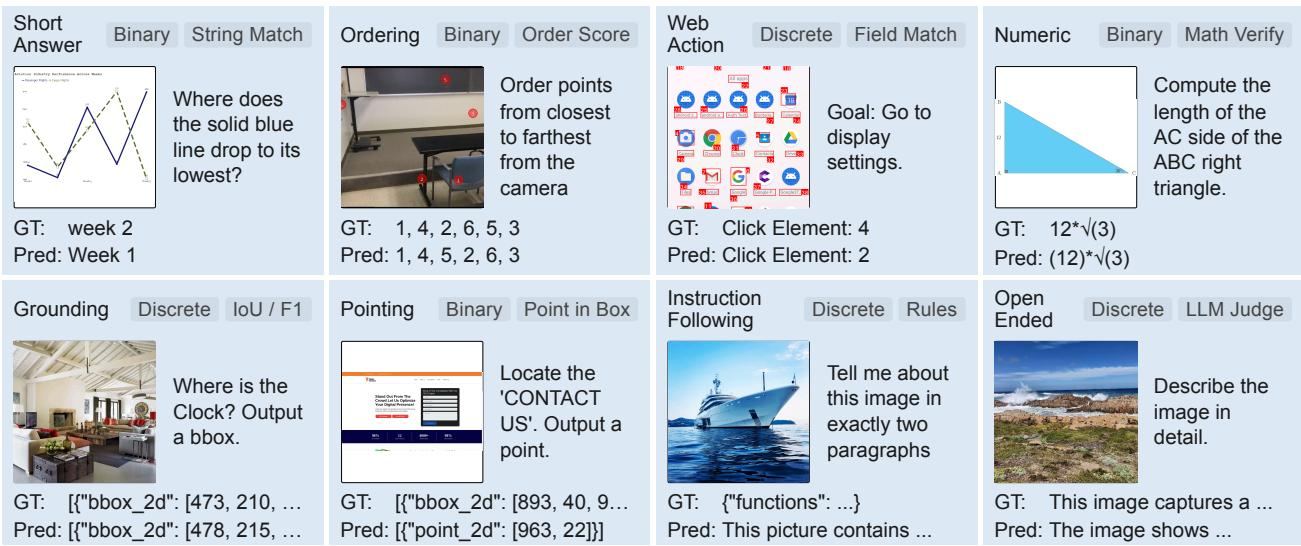
这些验证器包括二元奖励,如字符串匹配、多项选择、列表字符串匹配、通过符号解析的数值验证、排序和框内点检查。还使用了分级奖励,包括用于定位的 IoU/F1 评分、用于网页动作的字段匹配、用于指令跟随的规则检查,以及用于开放式响应的 LLM 作为评判者的方法。这种任务路由设计能够在多样化的答案格式上实现准确的奖励计算。
实验
评估使用多样化的视觉推理基准套件,配备任务特定的解码设置和 LLM/VLM 评判者。Vero 作为完全开源的单阶段强化学习方案,配备 60 万样本多任务数据集和任务路由奖励,在六类任务上持续优于先前的开源和专有基线,相对初始模型提升 +2.9 至 +12.9 分,且无需蒸馏。消融实验表明,带多路由奖励的 GSPO 优于 GRPO 和 DAPO,多样化的任务混合消除了单领域训练中出现的负跨任务迁移,而推理轨迹分析揭示了每类任务在认知和技能层面的不同特征。通过纳入带评判者奖励的开放式指令跟随任务,视觉聊天质量得以保持并提升,严格的评判者准则缓解了奖励破解问题。
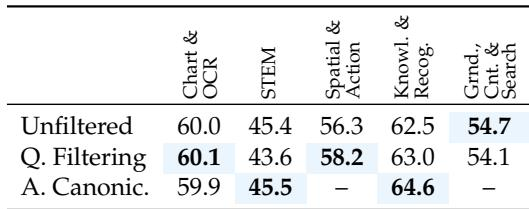
通过剔除模糊样本对噪声数据集进行过滤,通常能提升模型在大多数任务类别上的性能,但效果因类别而异。问题过滤往往提升空间、知识和定位任务的分数,而答案规范化有助于知识和定位类别,但可能轻微损害 OCR 和图表任务。问题过滤相比未过滤数据提升了空间、知识和定位任务的平均分数。答案规范化在知识和定位类别上带来增益,但略微降低了图表和 OCR 任务的性能。未过滤基线在 STEM 任务上表现最佳,而两种过滤方法在该类别上要么持平要么逊色。
训练混合中的均匀任务比例取得最高的平均基准增益,优于难度加权、图像面积加权和推理长度加权方案。移除知识与识别类别会降低整体性能,凸显了纳入广泛任务多样性的价值。结果支持均衡、广泛的多任务训练能驱动一致的跨类别提升。均衡任务比例取得最佳平均分数增益,超过所有加权替代方案。难度加权和面积加权方案并列第二,平均增益低于均匀方案。推理长度加权比例在测试的加权方案中产生最弱的平均提升。移除知识与识别类别会降低平均增益,表明其对整体性能的贡献。均匀比例在图表/OCR 和定位/计数/搜索类别中带来最大增益,而难度加权对 STEM 帮助最大。
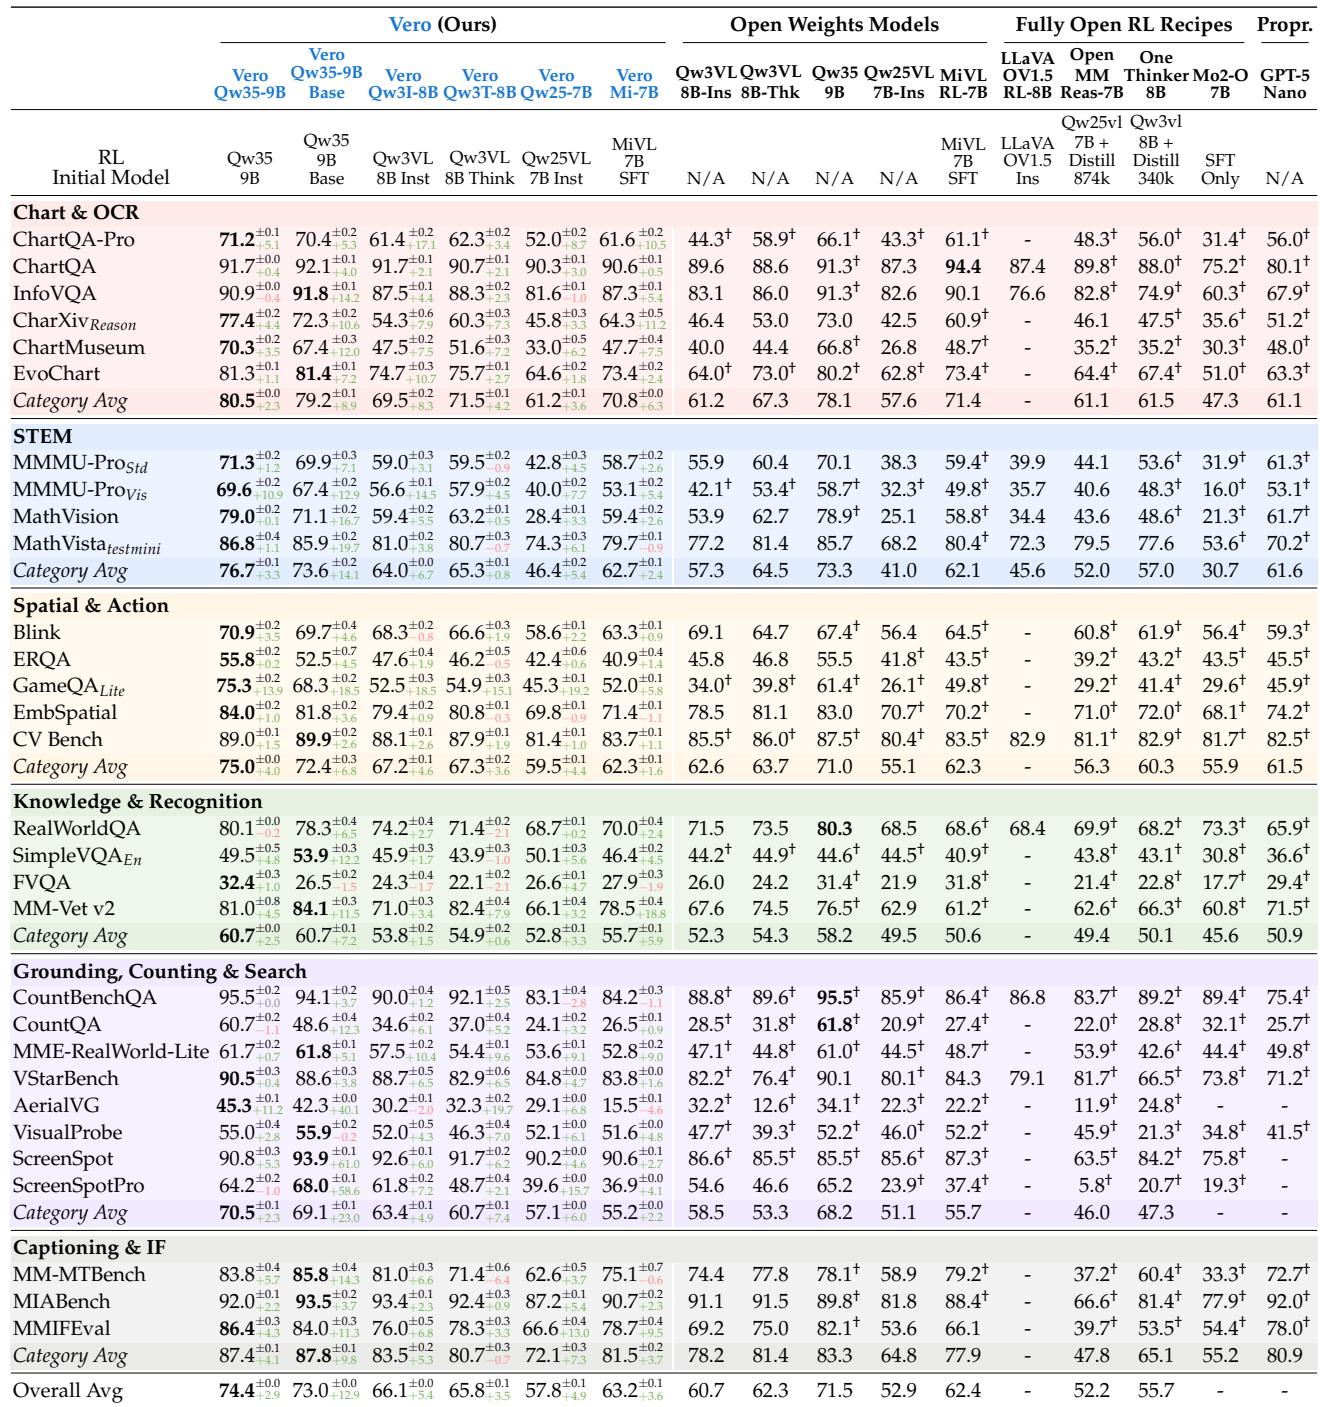
Vero 作为完全开源的强化学习方案,在 VeroEval 的六类任务上取得最先进结果,在无蒸馏的情况下提升多个基础模型。最大增益来自将强化学习直接应用于仅预训练的基础模型,而所有测试的初始模型均呈现一致提升。Vero-Qwen35-9B 达到最高整体平均分,相对其初始模型提升 +2.9 分,并在 30 个基准中赢得 25 个。将强化学习直接应用于仅预训练的 Qwen3.5-9B-Base 取得最大整体增益(+12.9),其中定位、计数与搜索以及描述与指令跟随类别提升显著。Vero-Qwen3I-8B 在无蒸馏的情况下整体超越 Qwen3-VL-8B-Thinking 达 +3.8 分,并整体超越 OneThinker-8B 达 +10.4 分。Vero 训练提升了最优模型全部六个类别的平均分,其中描述与指令跟随以及空间与动作类别的增益最大。Vero-MiMo-7B 基于 MiMo-VL-7B-SFT 训练,整体提升 +3.6 分,并在 STEM、知识与识别以及描述与指令跟随类别上超越专有强化学习基线。
在 Qwen2.5-VL-7B-Instruct 上的消融实验表明,带多路由奖励设计的强化学习在多样化视觉推理任务上优于监督微调和更简单的奖励方法。在强化学习算法中,GSPO 取得最高平均分数,并相比 GRPO 和 DAPO 保持更稳定的熵,表明更好的探索和更少的策略崩溃。多路由奖励设计在各类别上优于 math_verify,尤其在答案格式多样化的场景中。在提出的数据集上进行 SFT 优于强 SFT 基线,但 RL 在所有任务类别上带来更一致的增益。GSPO 的平均分数高于 GRPO 和 DAPO,且其熵在训练过程中保持显著更稳定。
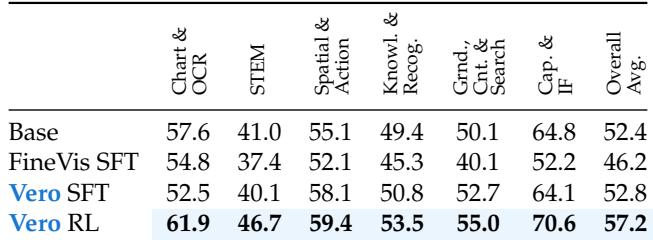
通过剔除模糊样本对噪声数据集进行过滤通常能提升模型性能,其中问题过滤提升空间、知识和定位任务,答案规范化有助于知识和定位但略微损害 OCR 和图表任务,而未过滤基线在 STEM 上仍为最优。训练混合中的均匀任务比例相比加权方案取得最高的平均基准增益,移除知识与识别类别会降低整体性能,支持均衡、广泛的多任务训练。Vero 作为完全开源的强化学习方案,在无蒸馏的情况下于六类任务上取得最先进结果,最大增益来自将强化学习直接应用于仅预训练的基础模型,且所有测试的初始模型均呈现一致提升。在 Qwen2.5-VL-7B-Instruct 上的消融实验表明,带多路由奖励设计的强化学习优于 SFT 和更简单的奖励方法,其中 GSPO 取得最高平均分数,并相比 GRPO 和 DAPO 保持更稳定的熵。