Command Palette
Search for a command to run...
面向 AGI 的数据科学与技术第一部分:分层数据管理
面向 AGI 的数据科学与技术第一部分:分层数据管理
摘要
人工智能的发展可视为数据驱动学习范式的演进,数据组织与利用方式的不断转变持续推动模型能力的提升。尽管取得了显著进展,当前大语言模型(LLM)研究仍以依赖数据规模单向扩展的范式为主导,日益面临数据可用性、获取成本及训练效率等方面的瓶颈。本文认为,通用人工智能(AGI)的发展正进入数据与模型协同进化的新阶段,其中模型主动引导数据管理,而高质量数据反过来增强模型能力。为实现这一愿景,我们提出了一种分层数据管理框架,旨在支持跨异构学习目标与成本约束的完整 LLM 训练生命周期。具体而言,我们引入了从原始未整理资源到组织化、可验证知识的 L0–L4 分层数据管理框架。重要的是,LLM 被充分应用于数据管理流程,如质量评分与内容编辑,以跨层精炼数据。每一层具有独特的数据属性、管理策略及训练角色,使数据能够在 LLM 训练各阶段(包括预训练、中期训练和对齐)中实现战略性分配。该框架明确平衡了数据质量、获取成本与边际训练收益,为可扩展且可持续的数据管理提供了系统性方法。我们通过数学与网页数据的实证研究验证了所提框架的有效性,其中从原始语料构建分层数据集并用于多个训练阶段。实验结果表明,分层感知的数据利用显著提升了训练效率与模型性能。为促进进一步研究,我们向社区发布了分层数据集及处理工具。
一句话总结
清华大学、北京智谱华章科技有限公司、北京理工大学和华南农业大学的研究者提出了一个面向AGI开发的L0–L4分层数据管理框架。在该框架中,LLM主动跨层级精炼数据,以平衡数据质量、获取成本和边际训练收益。其在数学和网页数据上的实证研究表明,分层感知的数据利用能够显著提升训练效率和模型性能。
核心贡献
- 提出了L0–L4分层数据管理框架,将数据从原始未整理资源逐步组织为结构化且可验证的知识。每一层由不同的数据属性、管理策略以及预训练、中期训练和对齐阶段的训练角色所定义。
- 将数据与模型协同演化的视角付诸实践,利用LLM进行数据质量评分和内容编辑,实现分层感知的资源分配,从而平衡数据质量、获取成本与边际训练收益。
- 针对数学和网页数据的实证研究表明,分层感知的数据利用能够提升训练效率和模型性能。分层数据集及处理工具已向社区开源。
引言
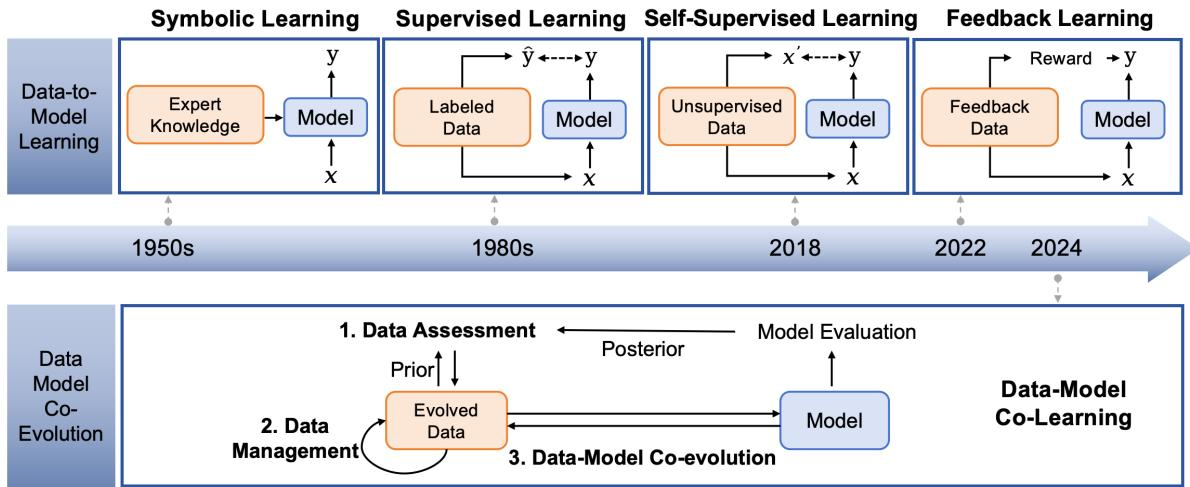
作者梳理了人工智能通过四种数据驱动范式的演进历程,从符号学习发展到基于反馈的强化学习,并指出当前以扩大数据规模为核心的做法正触及根本性瓶颈。以往的数据处理工作,如过滤和选择,仅解决孤立任务,无法满足完整LLM训练生命周期中的系统性需求,因为不同训练阶段对数据质量、数量和分布有着不同要求。为解决这一问题,作者提出了数据与模型协同演化的视角,并引入L0–L4分层数据管理框架,将数据从原始资源组织为结构化、可验证的知识。其在网页、数学和代码领域的实证研究表明,更高层级的数据能够提升性能,而分层感知的训练策略(在后期阶段引入更高质量数据)可防止性能饱和,并优于混合训练方法,从而将细粒度质量控制确立为AGI开发的核心组成部分。
数据集
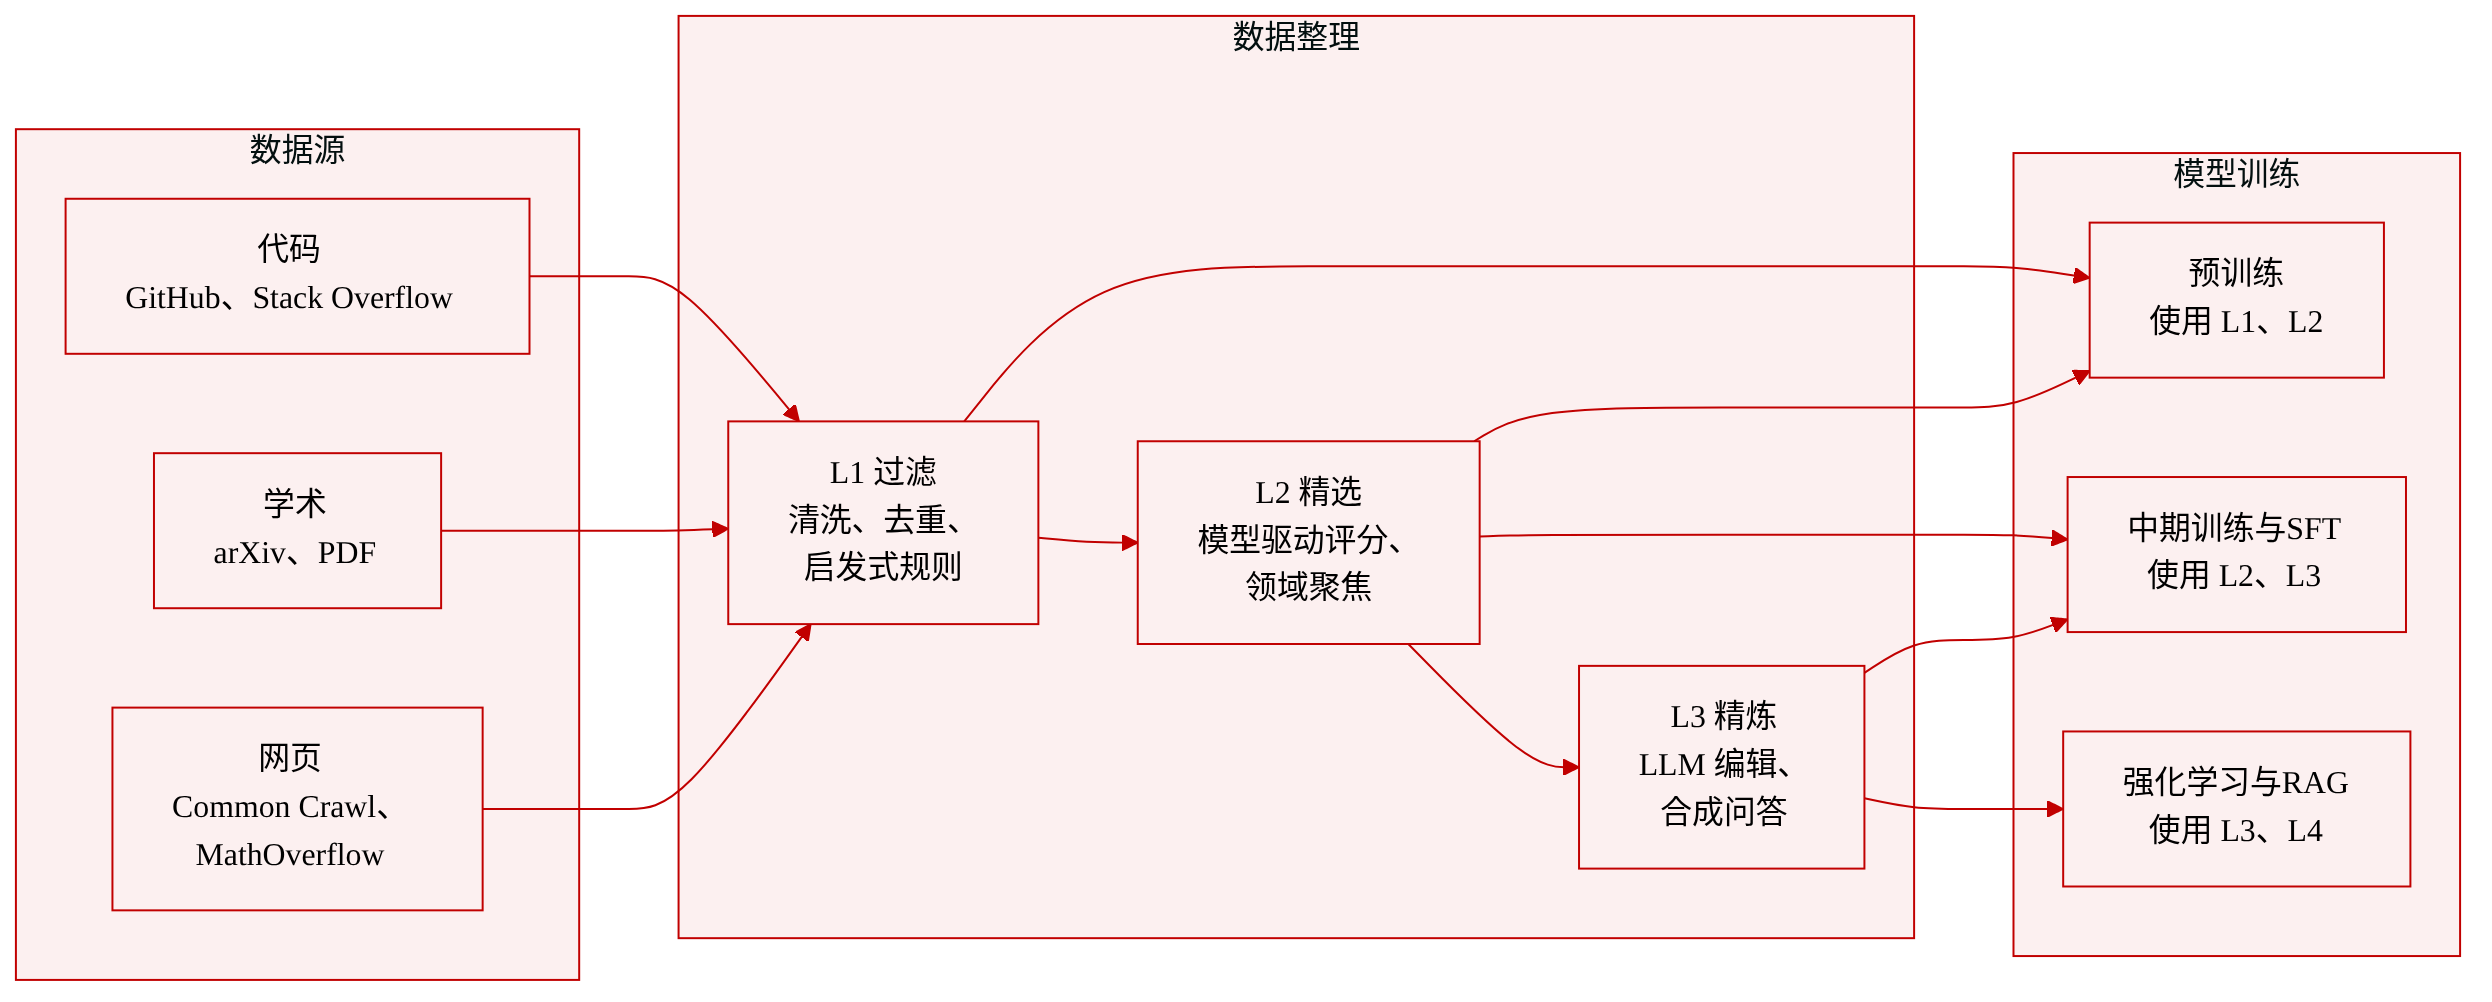
作者引入了一种分层数据管理框架,将数据集组织为五个层级,从原始存档数据到高度结构化的知识资产。每一层都应用逐步精细化的处理流程,以提高数据质量及其对模型训练的适用性。
数据集构成与来源
- 该框架从L0原始数据开始,这是对异构来源的广泛收集,包括通用网页内容(新闻、博客、社交媒体)、娱乐媒体、学术文献、源代码仓库以及音频、视频和图像等多模态资产。
- 该层级的主要来源包括Common Crawl(最大的开源网页爬取库,涵盖15年间超过300亿个页面)、arXiv(LaTeX和PDF预印本论文)、GitHub(代码历史与版本记录)以及Stack Overflow(编程问答)。
- 数据获取依赖于网络爬取、批量下载和格式解析。MinerU-HTML和Resiliparse等工具负责HTML提取,而MinerU、olmOCR和Nougat用于解析PDF文档。
各子集的关键细节
- L0原始数据以原生格式或仅经最小程度转换的格式存储。其信息密度低、噪声高,因此不直接用于训练,而是作为可追溯性和二次处理的存档储备。
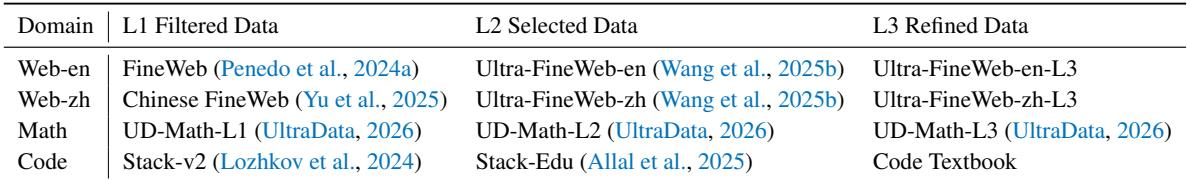
- L1过滤数据通过基础清洗操作生成:URL过滤、文本提取、语言识别、启发式规则过滤和全局去重。两个代表性数据集说明了该层级。
- FineWeb以Common Crawl为起点,使用Trafilatura进行文本提取(优于WET文件),应用RefinedWeb的URL黑名单、fastText语言分类和质量过滤规则,得到约36万亿个token。随后,其在96个快照上应用独立快照去重(5-gram、112个哈希函数、14个桶、75%相似度目标),得到约20万亿个token。启发式过滤器(行尾标点比例、重复行字符比例、短行比例)去除了约22%的token。最终数据集包含15万亿个token。
- UltraData-Math-L1应用了一套面向数学内容的清洗算子,包括格式修复映射器(移除不可见字符、合并多余换行、去除导航栏)和内容过滤器(丢弃无标点的短文和文本长度异常的文档)。
- L2选择数据采用模型驱动的选择方法来提高信息密度。文中提供了两个示例。
- Ultra-FineWeb利用通过高效验证策略(使用权重衰减调度器和两阶段退火)识别出的高质量种子数据,训练了一个轻量级fastText分类器。该分类器对FineWeb数据集进行过滤,性能优于L1版本。
- FineMath从Common Crawl WARC文件中提取文本,使用基于Llama-3.1-70B-Instruct训练的分类器进行初始评分(3分制),以识别高质量数学领域,并将URL列表扩展至包含OWM和InfiMM-WebMath来源。其重新提取页面并保留LaTeX格式,得到71亿个页面和6.5万亿个token。第二轮分类(5分制)过滤出推理和教育内容。最后进行单频段MinHash LSH去重(10个哈希函数)、fastText语言分类(仅限英语)和基准测试去污染。由此生成FineMath-4+(100亿个token)和FineMath-3+(340亿个token)。
- L3精炼数据采用编辑和合成增强方法。文中描述了两种途径。
- UltraFineWeb-L3使用LLM精炼网页文本,移除非内容元素(侧边栏、页眉、页脚、广告),纠正OCR错误,修复代码缩进,并处理语法不一致问题。未通过信息密度阈值的文档将被丢弃。
- UltraData-Math-L3首先将清洗后的种子文档标准化为LaTeX格式,然后使用多模型集成生成五种教学格式:难度分层的问答对、多轮师生对话、多风格改写、知识驱动的教材模块以及角色融合的综合内容。所有输出均需经过LaTeX语法错误和逻辑不完整性过滤。
- L4组织数据侧重于编排和事实核查。示例包括Wikidata(结构化多语言知识库)和UltraData-arXiv(具有标准化公式、引用和实验结果的学术文献)。
论文如何使用数据
- L0数据仅作存档,不参与模型训练。
- L1数据支持大规模预训练,提供基础语言理解和通用知识。
- L2数据适用于衰减和中期训练阶段,具有高信息密度和领域特定质量。
- L3数据适用于中期训练、监督微调(SFT)和强化学习(RL),可增强逻辑推理、数学能力和指令遵循能力。
- L4数据服务于检索增强生成(RAG)等下游应用,提供可信知识索引以减少幻觉。
处理与元数据构建
- 文中未明确提及裁剪策略,但框架强调每一层的提取、过滤、去重和合成。
- 元数据构建出现在L4层级,数据被组织为结构化、可搜索的格式,并带有经过验证的事实和相互关联。
- 该框架支持渐进式训练策略,研究者可以从L1池中按领域需求采样,或从L2中提取高质量种子以指导L3合成。
方法
分层数据管理框架
作者提出了一种以数据质量和可信度为核心的细粒度分层数据管理框架,以解决现有方法在LLM训练中不加区分地混合不同质量数据所带来的局限。该框架定义了L0至L4五个不同层级,每一层代表数据纯度的逐步提升,同时伴随着更高的获取和计算开销。
L0:原始数据
L0层级作为基础存档储备,包含原生格式或仅经最小结构转换的数据。该层涵盖异构来源,包括通用网页内容、娱乐媒体、学术文献、源代码仓库以及音频、视频和图像等多模态资产。尽管L0数据覆盖面广,但其低信息密度和高噪声水平使其不适合直接用于模型训练。
该层级的获取依赖于网络爬取、批量下载和格式解析等基本操作。对于HTML内容,MinerU-HTML和Resiliparse等工具可进行高效提取,而PDF解析则通过MinerU、olmOCR和Nougat等系统完成。代表性L0数据集包括Common Crawl(提供不同粒度的WARC、WAT和WET格式),以及MathOverflow、arXiv、GitHub和Stack Overflow等垂直来源。L0层级的管理策略侧重于全量存储和数据完整性保障,为后续层级建立可追溯性基础。
L1:过滤数据
L1层级构成基础数据清洗层,旨在通过低成本工程方法消除明显噪声。其技术流程包括URL过滤、文本提取、语言识别、启发式规则过滤和全局去重。作者通过两个代表性工作说明L1实践。
FineWeb通过实证消融实验验证了L1策略。使用Trafilatura从WARC文件中提取文本优于基于WET的提取。该流程应用RefinedWeb的URL黑名单、fastText语言分类器和质量过滤规则,将语料缩减至约36万亿个token。值得注意的是,FineWeb采用独立快照去重而非全局MinHash去重,因为全局去重会提高旧快照中低质量数据的采样率。自定义启发式过滤器包括行尾标点比例过滤(阈值0.12)、重复行字符比例过滤(阈值0.1)和短行比例过滤(阈值0.67),共同去除约22%的token。
UltraData-Math通过一套面向数学内容的专用清洗算子实现L1管理,这些算子分为格式修复映射器和内容过滤器。格式修复映射器在不改变记录数量的情况下标准化文本,移除不可见字符、合并多余换行并去除界面噪声。内容过滤器丢弃未通过基本可用性标准的记录,例如缺乏标点的短文或文本长度异常的文档。L1数据支持大规模预训练,为通用知识理解和语言表征提供基础能力。
L2:选择数据
L2层级标志着从基于规则向模型驱动的数据管理范式转变。该层级的选择利用领域特定分类器、语义级过滤、质量评分和数据标注来识别并保留高价值样本。作者介绍了两个代表性实现。
Ultra-FineWeb引入了一种基于权重衰减调度器和两阶段退火阶段的高效验证策略,显著减少了评估数据子集所需的GPU时长。该策略能够快速评估候选数据池,从中选择高质量样本作为轻量级fastText分类器的种子数据。与基于LLM的分类器相比,fastText在保持选择质量的同时降低了推理开销。使用该方法过滤FineWeb得到的数据集显著优于L1层级的FineWeb,验证了模型驱动选择的有效性。
FineMath通过多阶段构建流程解决了现有数学数据集的不足。该流程首先对Common Crawl WARC文件进行基于分类器的评分,以识别高质量数学领域,随后扩展URL列表以纳入OWM和InfiMM-WebMath来源。在保留LaTeX格式的重新提取之后,第二轮分类过滤出推理和教育内容。流程最后进行MinHash LSH去重、fastText语言分类和基准测试去污染。由此得到的FineMath-4+在GSM8K上实现了2倍的性能提升,在MATH上实现了6倍的性能提升。
L2数据在信息密度、专业性和任务相关性方面取得了显著进步,为基础预训练和持续预训练阶段提供了高效的训练语料。
L3:精炼数据
L3层级采用编辑、修复和合成增强来消除语义缺陷并强化逻辑连贯性。UltraFineWeb-L3实现了一种编辑精炼策略,将数据处理视为语义蒸馏而非简单过滤。LLM通过移除侧边栏、页眉和残留广告等非内容元素、纠正OCR错误、修复损坏的代码缩进以及处理语法不一致来精炼网页文本。未通过信息密度阈值的文档将被丢弃,这种过滤加编辑的范式实现了数据质量的二次净化。
UltraData-Math-L3实现了一条系统化的合成流程,以克服网络挖掘数学数据稀缺的问题。该流程首先将种子文档清洗为统一的LaTeX格式,然后采用多模型集成策略将这些种子转换为五种教学格式:遵循课程递进顺序的难度分层问答对、跨越七种角色配对的多轮师生对话、将数学逻辑与表达风格解耦的多风格改写、提取定理用于教学讲解的知识驱动教材模块,以及模拟专业教育材料的角色融合综合内容。所有合成输出均需经过严格的LaTeX语法错误和逻辑不完整性过滤。
L3数据支持中期训练、监督微调和强化学习等关键阶段,实现创造性价值增强,突破原始数据分布的约束。
L4:组织数据
L4层级代表框架中最精炼的状态,强调统一编排和严格规范化,将碎片化信息转化为结构化、可靠、可搜索的知识资产。该层级的管理围绕两个核心操作:数据编排,即在不同主题框架下统一分散的数据;以及事实核查,即与可信来源交叉验证条目以消除事实不一致。代表性示例包括Wikidata和UltraData-arXiv,其中数学公式、引用和实验结果等复杂元素被标准化为相互关联的格式。L4数据的结构严谨性和可信度使其在检索增强生成中不可或缺,为模型幻觉提供有力防御。
L0–L4分层框架支持渐进式训练策略,使模型在不同演化阶段与质量逐步提升的数据资源相匹配。L0作为存档储备,L1支持大规模预训练,L2适用于衰减和中期训练阶段,L3为中期训练、SFT和RL阶段的逻辑推理能力跃升提供高质量语料,L4则为下游应用构建可信知识索引。该框架解耦了数据管理的复杂挑战,将数据质量从基于经验的评估转变为可预测的工程指标,推动模型能力向确定性进步方向发展。
实验
评估使用MiniCPM-1.2B模型,采用三种验证策略(高效、预训练和衰减),在英语、中文、数学和代码语料上评估分层数据管理框架。结果显示,所有领域从L1到L3均呈现一致的质量提升,其中数学领域提升最大(+7.06个百分点)。UltraData-Math案例研究证实,更高层级的数学数据对非数学基准具有可迁移的收益,可增强通用推理和代码生成能力。对比训练实验表明,分层训练(从L1到L3的逐阶段训练)在整体上比混合训练高出1.49个百分点,且在后期阶段保持持续的学习增益,验证了该框架在使数据质量与模型学习需求对齐方面的有效性。
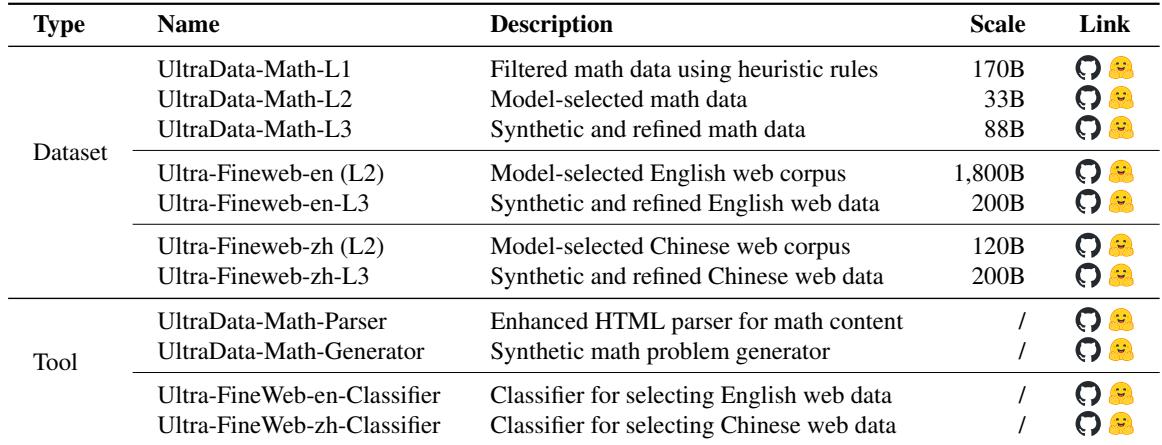
本文介绍了一个分层数据管理框架,包含多个开源数据集和工具,按L1、L2和L3质量层级组织。实验表明,逐步引入更高质量数据的分层训练优于混合训练,尤其在后期阶段,可带来更持续的性能提升。分层训练的整体平均提升(1.49个百分点)高于混合训练。在训练后期,分层训练提升3.31个百分点,而混合训练提升1.91个百分点,增长幅度约为后者的1.7倍。分层方法避免了混合训练中在偏好知识广度任务上出现的性能下降。
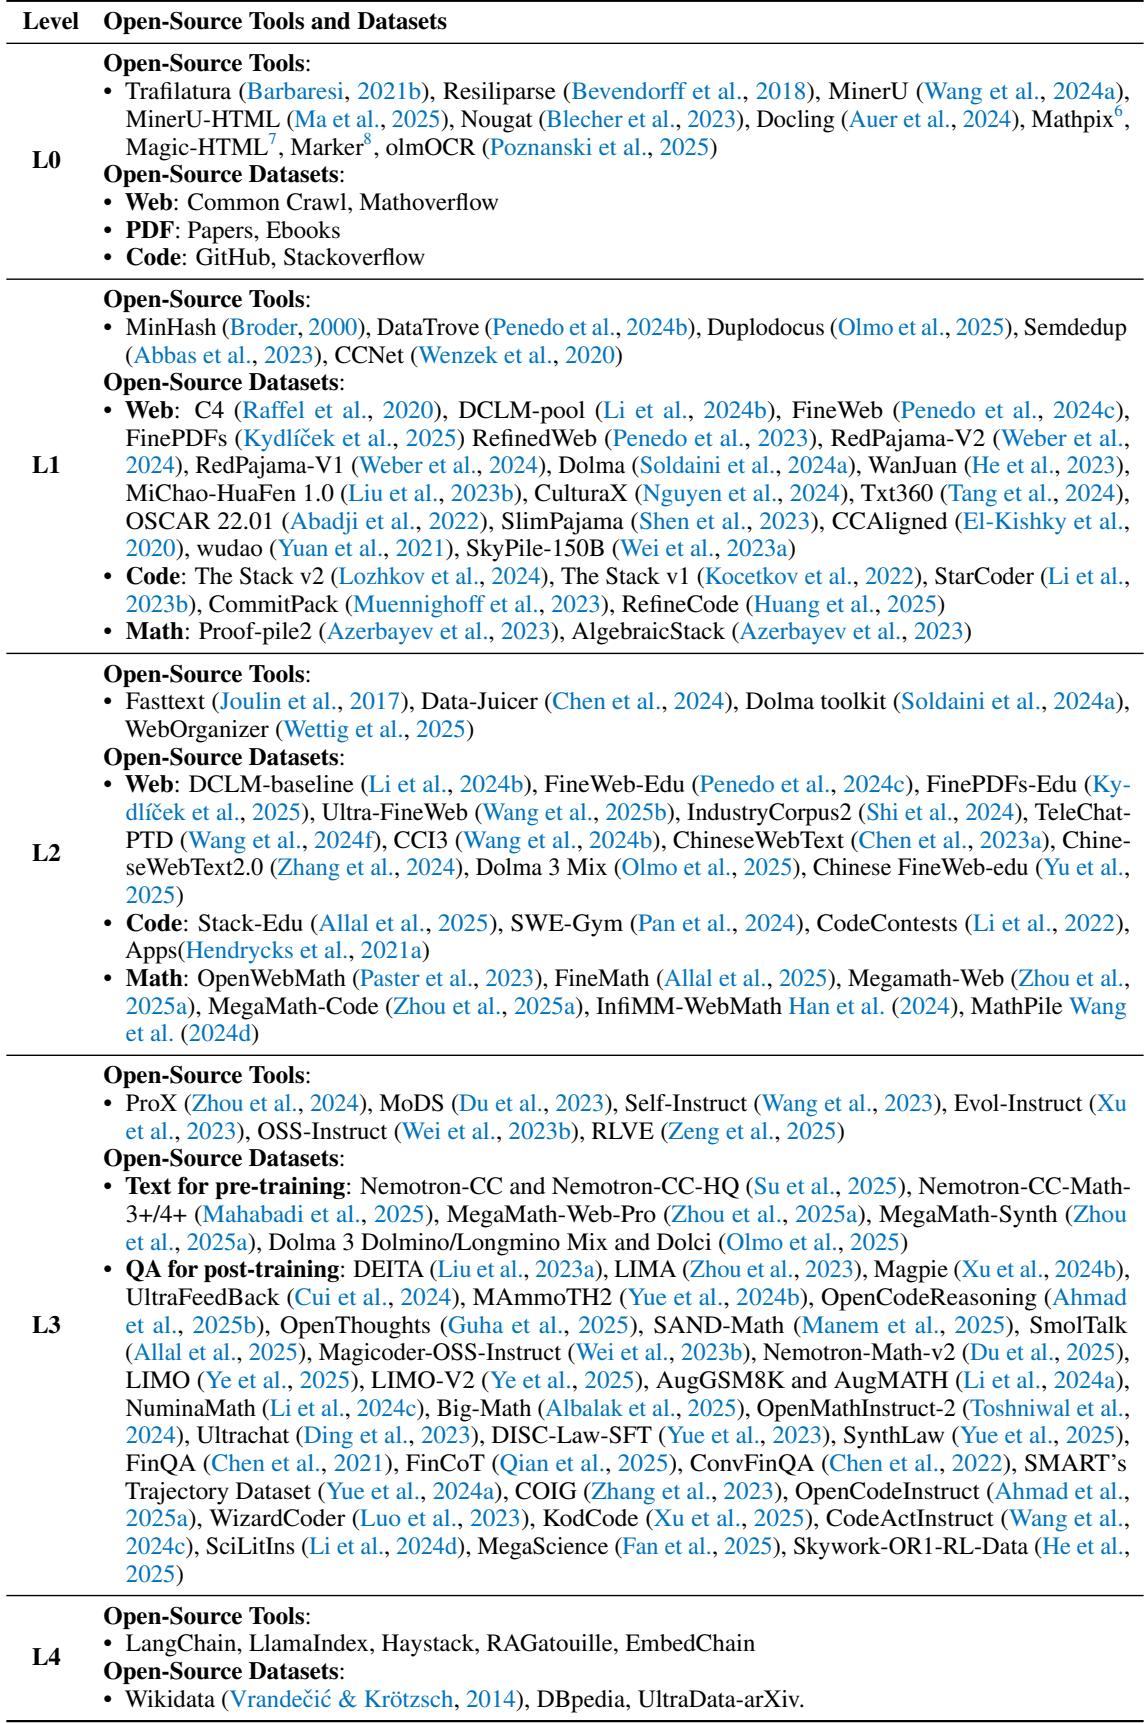
该表列出了映射到五层(L0–L4)数据管理框架的开源工具和数据集,每一层对应递增的数据质量和处理成本。该框架支持分阶段训练策略,随时间逐步引入更高质量的数据,相比传统混合训练可带来持续的性能提升。L0工具侧重于从原始网页、PDF和代码来源进行提取,而L1工具强调大规模语料的去重和过滤。L2引入基于模型的选择和质量过滤,涉及FineWeb-Edu和DCLM-baseline等数据集;L3则包含Self-Instruct和Evol-Instruct等合成与指令生成工具。L4专注于知识集成和检索,涉及LangChain和LlamaIndex等工具,以及Wikidata和DBpedia等结构化数据集。逐步使用L1、L2和L3数据的分层训练在后期阶段展现出比混合训练更大的性能提升,增长幅度约为后者的1.7倍。
MiniCPM-1.2B模型使用73,448个token的词表、1,536的隐藏维度和52层结构,配备24个查询头和8个键/值头。训练配置包括4,096的序列长度、0.1的权重衰减和1.0的梯度裁剪,批大小因验证阶段而异。模型使用Megatron-LM库和MiniCPM3-4B分词器进行训练。该模型具有12.5亿非嵌入参数,隐藏维度为1,536,前馈瓶颈维度为3,840。架构使用24个查询头和8个键/值头,注意力头维度为64。训练使用4,096的序列长度,高效验证阶段的全局批大小为512,而预训练验证使用更大的全局批大小2,048。学习率调度因阶段而异,预训练验证使用余弦调度,衰减验证使用指数衰减。

逐步引入L1、L2和L3过滤数据的分层数据管理策略,在最终模型性能和持续学习增益方面均优于混合训练方法。早期训练中两种策略进展相似,但在后期阶段,分层方法实现了更大的提升(3.31个百分点),而混合训练为1.91个百分点,整体平均优势为1.49个百分点。该优势归因于在每个训练阶段将数据质量层级与模型学习需求对齐,减少了低质量数据的干扰。分层训练在后期阶段的性能增益为3.31个百分点,而混合训练为1.91个百分点。分层策略的整体平均性能比混合训练高出1.49个百分点。两种策略的早期训练曲线相似,但分层训练在引入L2和L3数据后保持持续增长。L1数据提供广泛的语言覆盖,L2增强高密度内容学习,L3深化推理和领域知识。
分层数据管理框架在所有评估领域均产生一致的质量提升,英语网页、中文网页、数学和代码任务的平均基准分数从L1到L3均有所上升。最大增益出现在数学领域,代码和语言领域也有较小但正向的增益。L3 > L2 > L1的性能层级在所有领域中普遍成立,验证了该框架即使在受限训练预算下也行之有效。所有领域的平均分数均从L1到L3有所提升,其中数学领域增幅最大,约为7个百分点。L3 > L2 > L1的严格性能排序在全部四个领域中无一例外。少数常识推理任务在分层训练下出现轻微下降,这可能是由于这些任务依赖于更广泛的L1数据覆盖。
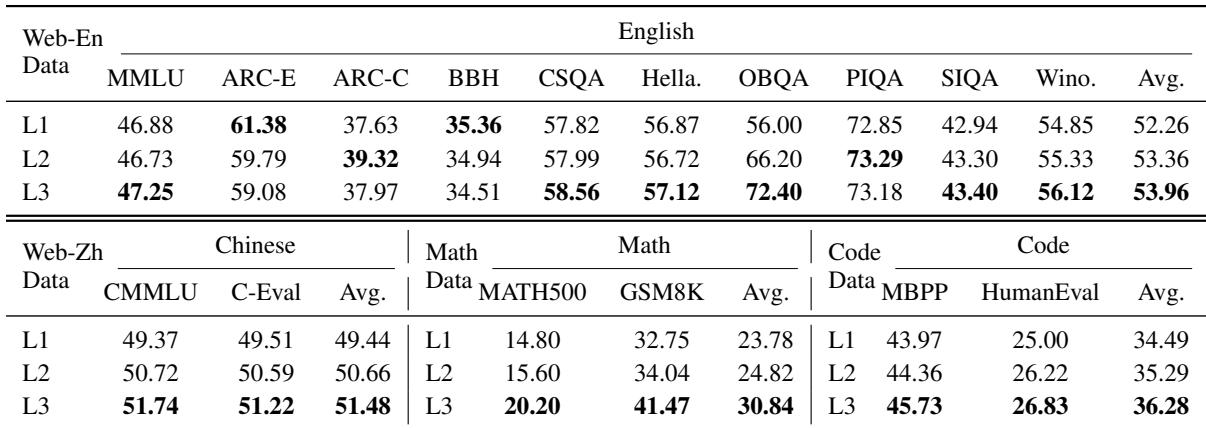
实验验证了一种在训练过程中逐步引入更高质量数据(L1至L3)的分层数据管理框架。与混合训练相比,分层训练实现了更高的整体平均性能增益(1.49个百分点)和更大的后期阶段提升(3.31个百分点对1.91个百分点),增长幅度约为后者的1.7倍,同时避免了在偏好广度任务上的性能下降。L3 > L2 > L1的性能层级在所有评估领域中一致成立,其中数学领域增益最大,代码和语言任务也有较小的正向增益,证实了该框架即使在受限训练预算下也行之有效。