Command Palette
Search for a command to run...
金鹅妙法:从不可验证的互联网文本合成无限 RLVR 任务的简单技巧
金鹅妙法:从不可验证的互联网文本合成无限 RLVR 任务的简单技巧
GooseReason-0.7M 强化学习验证推理数据集
摘要
基于可验证奖励的强化学习(RLVR)已成为激发大型语言模型(LLM)复杂推理能力的基石。然而,RL 的规模化受限于现有可验证数据的稀缺性,且随着训练的持续,性能提升逐渐趋于饱和。为克服这一瓶颈,我们提出“金鹅妙法”(Golden Goose),一种通过构建填空式多项选择题任务,从不可验证的互联网文本中合成无限 RLVR 任务的简单技巧。给定源文本,我们提示 LLM 识别并遮蔽关键推理步骤,然后生成多样且合理的干扰项。这使得我们能够利用通常被先前 RLVR 数据构建所排除的推理丰富型不可验证语料(如科学教科书),合成大规模 RLVR 数据集 GooseReason-0.7M,其中包含超过 70 万个涵盖数学、编程和一般科学领域的任务。实验表明,GooseReason 能有效激活在现有 RLVR 数据上训练已饱和的模型,在持续 RL 下带来稳健而持久的性能提升,并在 15 个多样基准上为 1.5B 和 4B-Instruct 模型取得新的最先进结果。最后,我们将 Golden Goose 应用于实际场景,从原始 FineWeb 抓取数据中为网络安全领域合成 RLVR 任务,而该领域此前并无 RLVR 数据。基于所得数据 GooseReason-Cyber 训练 Qwen3-4B-Instruct,在网络安全领域创下新的最先进水平,超越了经过大量领域特定预训练和后训练的 7B 领域专用模型。这凸显了通过利用丰富的、推理密集的不可验证互联网文本来自动扩展 RLVR 数据的巨大潜力。
一句话总结
来自华盛顿大学和微软的研究者提出了Golden Goose,一种简单的方法,通过掩蔽关键推理步骤并生成多样化的干扰项,从不可验证的互联网文本中合成无限数量的RLVR任务,从而构建了包含0.7M个任务的GooseReason数据集。该数据集能够使已饱和的RL训练重新获得提升,并在15个基准测试上为1.5B和4B-Instruct模型取得了最先进的结果,其中GooseReason-Cyber在7B领域专用模型上实现了新的网络安全SOTA。
核心贡献
- 引入Golden Goose,一个通过提示LLM掩蔽关键推理步骤并生成多样化干扰项,将不可验证的互联网文本转换为可验证的中间填充式多项选择RLVR任务的流程,从而能够利用先前RLVR数据构建所排除的富推理语料库,如自由格式的教科书。
- 发布GooseReason-0.7M,一个大规模RLVR数据集,包含超过70万个涵盖数学、编程和通用科学领域的合成任务,完全基于不可验证的来源构建,无需领域专家或手工制作的环境。
- 实验表明,在GooseReason数据上训练能够使已在现有RLVR数据上饱和的模型重新获得提升,在持续RL训练下取得持续增益,并在15个基准测试上为1.5B和4B-Instruct模型取得新的最先进结果;在网络安全部署中,使用GooseReason-Cyber数据训练的Qwen3-4B-Instruct超越了经过大量领域特定预训练和后训练的7B领域专用模型。
引言
带可验证奖励的强化学习(RLVR)已成为教授大型语言模型复杂推理的核心方法,为DeepSeek-R1、OpenAI-o3和Gemini-3等系统提供支持。然而,RLVR的规模化受到需要具有可自动检查的ground-truth答案的问题的限制,例如可通过验证器解析的数学问题或具有可执行单元测试的编程任务。先前的工作依赖于人工编写的问题(成本高昂且范围狭窄),或手工制作的过程化数据生成器(难以扩展到数百个环境之外)。因此,诸如开放式教科书问题、定理证明段落和没有测试用例的编程问题等丰富但不可验证的来源通常被丢弃。
为了解决这一问题,作者引入了GooseReason,一个将不可验证的互联网文本转换为可验证RLVR任务的简单流程。该方法提示LLM识别源段落中一段连续的关键推理步骤,将其掩蔽,并生成合理的干扰项,从而产生具有可验证答案的中间填充式多项选择任务。这使得构建GooseReason-0.7M成为可能,这是一个包含超过70万个涵盖数学、编程和科学领域的RLVR任务的数据集。实验表明,纳入这些任务能够使RL训练已饱和的模型重新获得提升,在15个基准测试上产生持续增益,甚至改善了对数据未明确覆盖的下游任务的推理泛化。
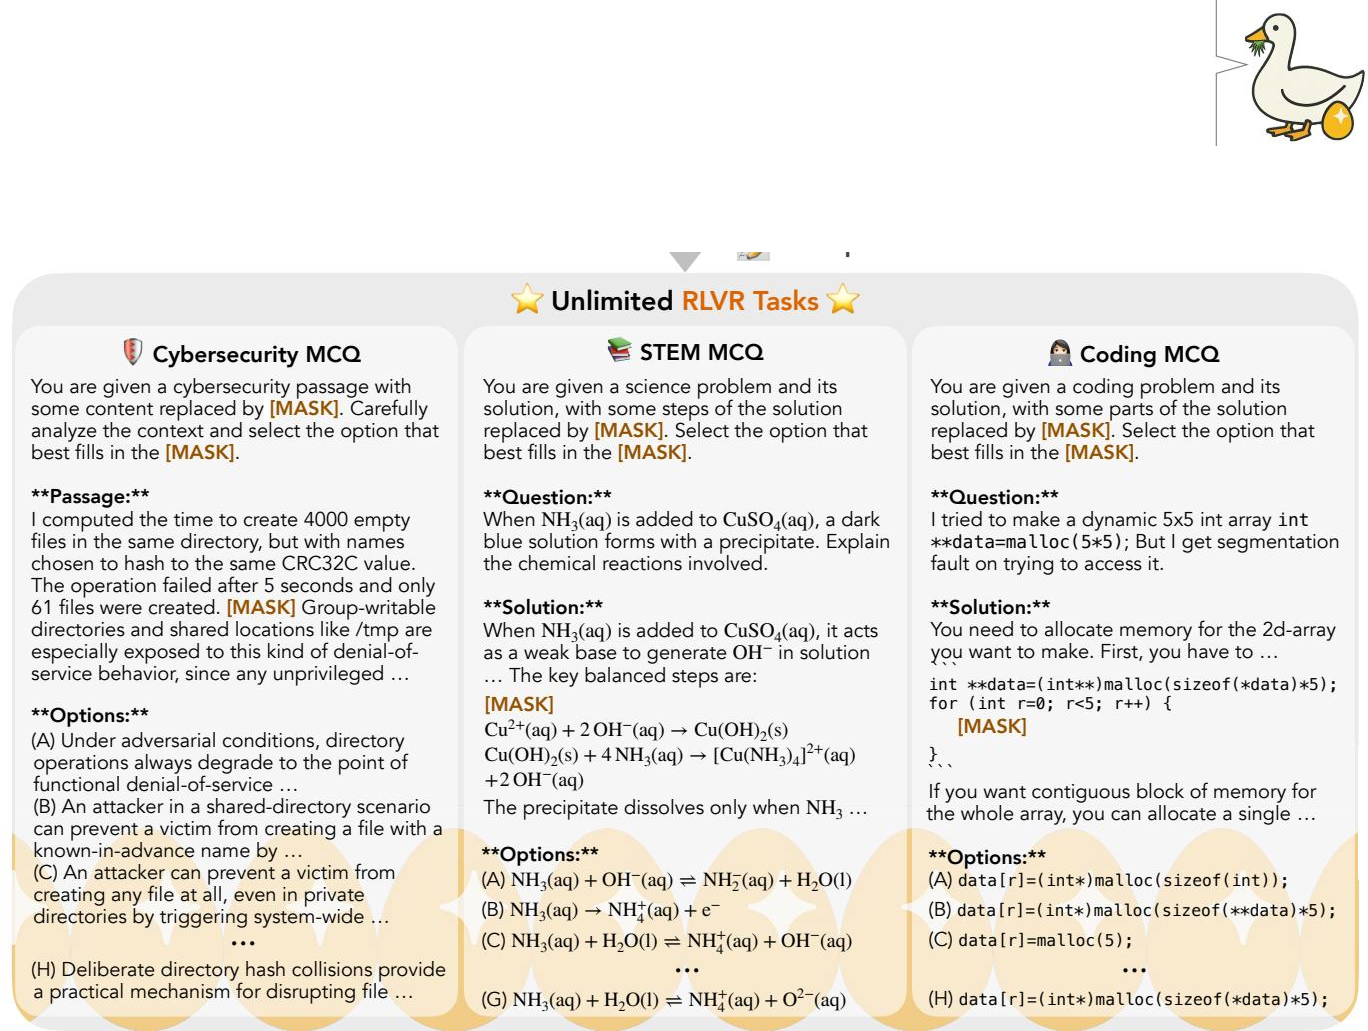
数据集
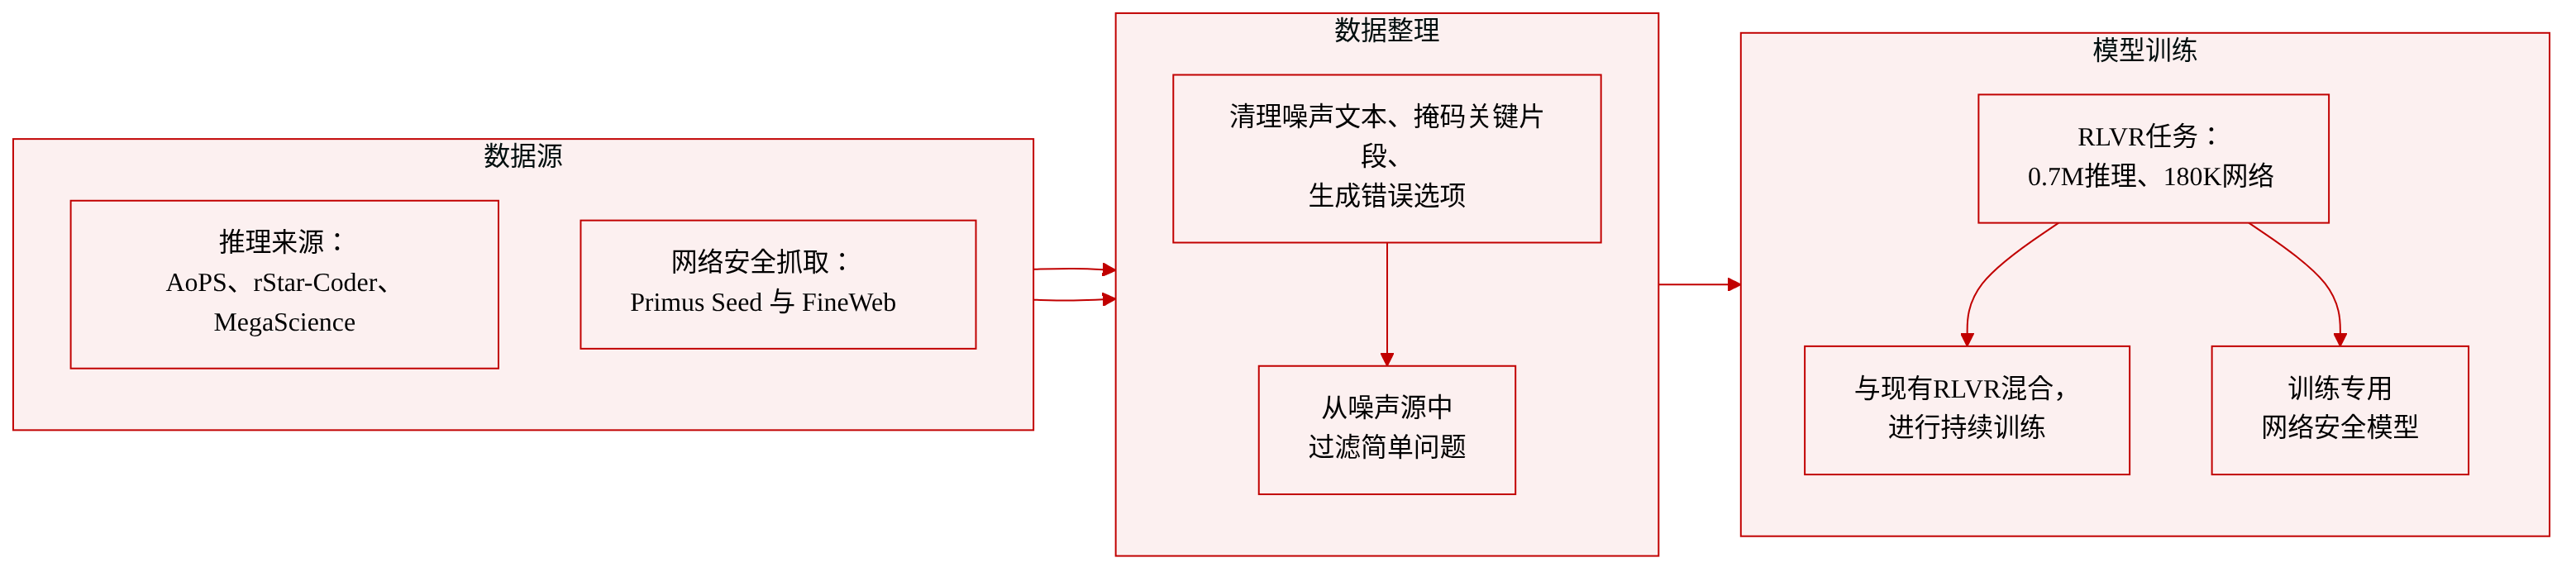
作者通过一个合成流程构建数据集,将原始文本转换为可验证的多项选择推理问题。以下是其组成、来源和使用的详细说明。
合成流程
- 给定源文本,作者提示大型语言模型(GPT-5)识别一段连续的重要推理步骤。
- 将该段落替换为[MASK]token以创建掩蔽上下文,将该段落视为ground-truth答案,并提示模型生成多个合理但不正确的干扰项。
- 最终问题是一个多项选择项目,包含掩蔽上下文以及以随机顺序排列的真实答案和干扰项。
- 对于嘈杂的源文本,模型首先将其提取或总结为更简洁、具有教育价值的版本,然后从该版本构建掩蔽上下文和干扰项。
- 如果源中不包含合适的段落,模型返回空字符串并跳过该文本。
- 为确保质量,整个合成过程使用GPT-5。对于推理密集型来源,无需后处理。对于嘈杂来源,作者增加了基于难度的过滤,移除学生模型在所有16次rollout中都能正确回答的简单问题。
推理领域(GooseReason-0.7M)
- 基于先前被排除在RLVR数据管理之外的三个语料库构建:
- AoPS-Instruct:来自Art of Problem Solving论坛的约60万个问答对,主要是奥林匹克级别的数学问题和社区解答。这些内容是非结构化的,有时不完整,许多定理证明解答无法用数学验证器验证。
- rStar-Coder:37.7K个专家编写的竞赛编程问题(来自IOI、Codeforces等),带有oracle解决方案,外加合成问题。1.656M个合成问题中只有380K个获得了测试用例;作者使用合成SFT划分(没有测试用例的问题和教师解决方案)来生成可验证的编程问题。
- MegaScience:来自约12K本大学水平教科书的65万个问答对,涵盖物理、生物学、化学、医学、计算机科学、数学和经济学。许多答案包含专业公式或开放式多段落讨论,难以用验证器验证。
- 该流程产生了超过70万个新颖的RLVR任务。
- 与现有RLVR数据(ProRL混合)的有效性分析表明,ProRL混合中的136K样本中只有约25%提供了有意义的学习信号,而GooseReason-0.7M保留了约70%的有效性,大幅补充了现有的RL训练数据集。
网络安全领域(约180K个任务)
- 该领域缺乏开源RLVR数据集,因此作者使用Primus数据作为原始来源:
- Primus-Seed:从MITRE、Wikipedia和网络安全公司网站等可信来源抓取,外加专家手动收集的网络威胁情报。
- Primus-FineWeb:从FineWeb中过滤出的网络安全相关文本,使用Primus-Seed作为正样本。
- 这些来源大量依赖网页抓取且较为嘈杂。作者直接应用合成流程,从原始互联网文本中产生了约180K个RLVR任务。
在模型中的使用
- 学生模型仅接收掩蔽上下文,必须从候选集中选择正确的选项。
- RL期间的验证仅检查预测选项是否与ground-truth答案匹配。
- 推理领域任务与现有RLVR数据混合以扩展持续RL训练,而网络安全任务用于训练该领域的专用模型。
方法
作者提出了一种数据合成流程,从推理丰富但不可验证的文本中构建带可验证奖励的强化学习(RLVR)任务。如框架图所示,该过程始于源文本S。提示LLM识别包含关键推理步骤的连续段落t。该段落被替换为特殊的[MASK]token,形成掩蔽上下文Smask。原始段落t作为ground-truth答案。同时,LLM生成一组多样化的干扰项D={d1,d2,…,dk},这些干扰项在Smask的上下文中与t风格相似且看似合理,但并不正确。最终任务被表述为多项选择问题Q=(Smask,{t}∪D)。
对于嘈杂的源文本(如网页抓取内容),流程包含预处理步骤,LLM首先将文本提取或总结为连贯的、具有教育价值的段落S′,然后再应用掩蔽和干扰项生成步骤。如果源文本不包含合适的段落,LLM返回空字符串。为确保数据质量,系统采用基于难度的过滤,移除那些学生模型在所有rollout中都能一致解决的过于简单的问题。在训练阶段,向学生模型提供Smask,任务是从候选集中选择最能填补[MASK]的选项。RL期间的验证仅检查预测是否与ground-truth选项匹配。
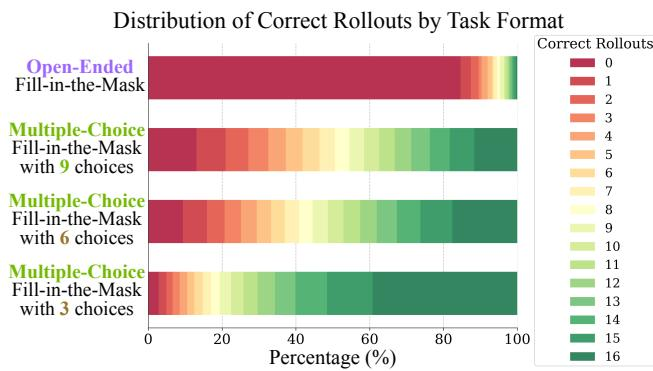
任务格式的设计对于有效的RL训练至关重要。作者比较了开放式填空任务与多项选择形式。他们观察到,开放式任务常常导致较差的指令遵循,模型忽略掩蔽并从零开始解决问题,从而不产生可用的奖励信号。关于干扰项的数量,作者对选项数量的影响进行了消融实验。如下图所示,选项太少(例如3个)会使任务过于简单,使模型能够依赖排除策略而非推理。相反,将干扰项数量增加到9个会将大多数问题转移到中等难度区间,其特点是成功和失败的rollout混合存在,这为强化学习提供了最有效的信号。
实验
实验评估了GooseReason数据集在LLM的RL训练的各种扩展场景中的表现。在数据饱和情况下,纳入GooseReason能够使已饱和的模型重新获得提升,在数学、编程特别是STEM领域产生稳健增益,同时改善到无关任务的迁移,即使对于较早达到平台的更强模型也是如此。在固定计算预算下,与GooseReason的联合训练在相同的步数下实现更高的性能,显示出更高的计算效率扩展。在专业领域,GooseReason-Cyber使RLVR能够以最少的训练步骤在网络安全推理方面实现实质性改进,超越了先前的领域特定方法。
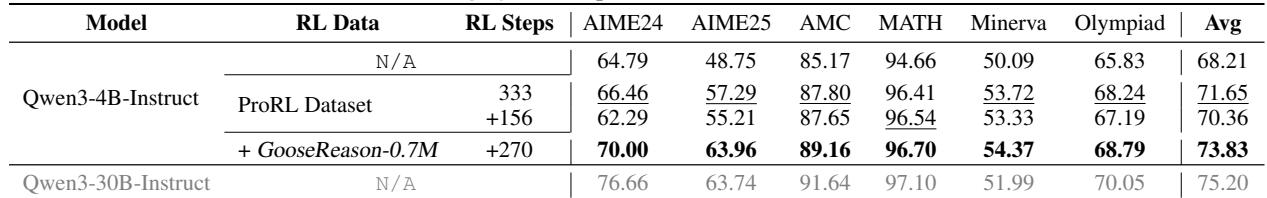
在更强模型上使用原始ProRL数据继续进行RL训练,约300步后会导致性能饱和或退化,数学和STEM出现损失。添加GooseReason-0.7M能够使已饱和的模型重新获得提升,在所有评估的基准测试上产生一致增益,实现进一步的RL扩展并提高平均性能。仅使用ProRL数据的扩展RL会导致数学和STEM性能下降,只有微小的编程增益。在饱和后纳入GooseReason-0.7M可改善所有列出的数学基准测试的结果,将平均得分从70.36提升到73.83。增益广泛,包括训练数据未直接覆盖的任务,表明推理技能具有可迁移性。
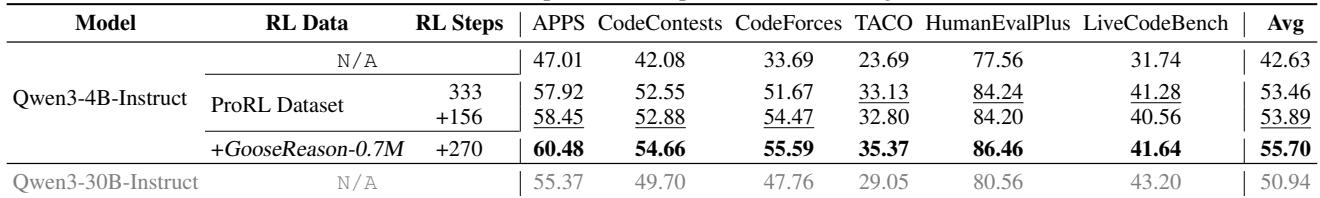
在RL训练中添加GooseReason数据可提高Qwen3-4B-Instruct的编程基准测试性能,并随RL步骤的增加获得进一步增益。使用GooseReason的4B模型在平均值和大多数单项基准测试上超越了规模大得多的Qwen3-30B-Instruct。在APPS、CodeContests、CodeForces、TACO、HumanEvalPlus和LiveCodeBench上均获得一致的增益。纳入GooseReason-0.7M将4B模型的平均pass@1从42.63提高到55.70,超过了30B模型的50.94。使用GooseReason的4B模型在所有六个编程基准测试上均优于30B模型,除了LiveCodeBench略有降低。使用GooseReason将RL步骤从333增加到270,在CodeForces和TACO上获得了额外增益,同时在其他基准测试上保持高准确率。
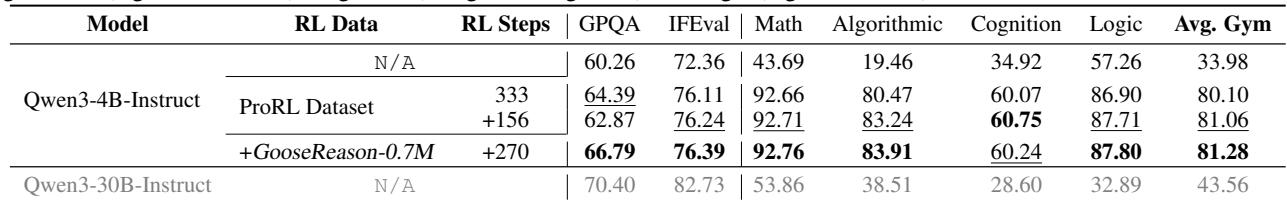
该表比较了Qwen3-4B-Instruct的强化学习方案,显示在ProRL训练中添加GooseReason数据能够在STEM推理、指令遵循和逻辑谜题方面产生一致的增益。最佳配置在多个基准测试上接近或超过7.5倍更大的模型的性能,而没有RL的基础模型在推理密集型任务上表现明显较差。在ProRL中添加GooseReason在数学、算法、认知和逻辑任务上的得分均优于仅使用ProRL,其中数学和算法类别的增益最大。经过GooseReason训练的4B模型尽管规模小得多,但在大多数推理基准测试上达到了与Qwen3-30B-Instruct相当或更好的结果。指令遵循和GPQA也随GooseReason有所改善,表明推理技能可以迁移到训练数据领域之外。
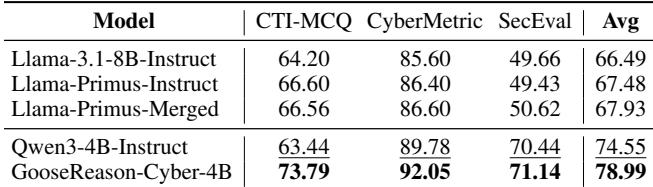
使用GooseReason-Cyber训练的4B Qwen模型在网络安全基准测试上取得了最先进的结果,尽管RL训练少得多,仍超越了更大的8B领域专用模型。该方法产生了显著的平均性能增益,是先前最佳8B方法改进幅度的三倍以上。GooseReason-Cyber-4B模型仅使用100个RL步骤,就在其基础Qwen3-4B之上将平均基准测试性能提高了4.44%。该4B模型超越了所有8B基线,包括先前最先进的Llama-Primus-Instruct(其仅在其基础上提高了1.44%)。在所有三个评估的网络安全任务上都出现了增益,其中在威胁情报和漏洞分析方面观察到了最大的相对提升。
实验表明,在强化学习中添加GooseReason数据能够防止饱和,并在数学、编程、推理和指令遵循基准测试上产生一致增益,即使对于比大型对应模型小得多的模型也是如此。该方法支持进一步的RL扩展,改善了对训练分布之外任务的迁移,并同样提升了网络安全性能,其中4B模型以更少的训练步骤超越了更大的领域专用基线。