Command Palette
Search for a command to run...
APEX–Agents
APEX–Agents
摘要
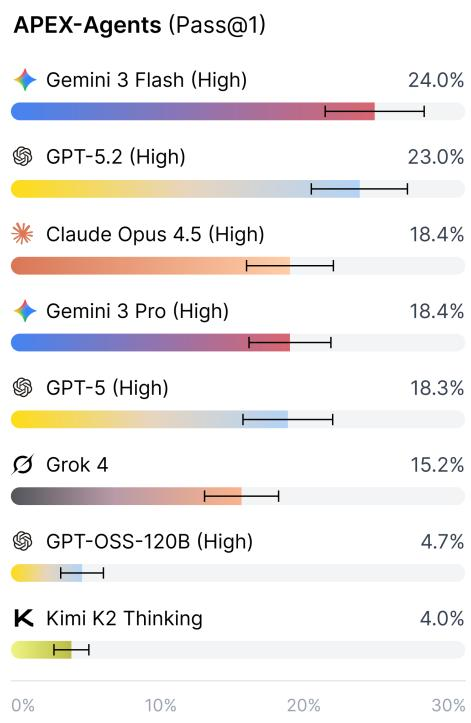
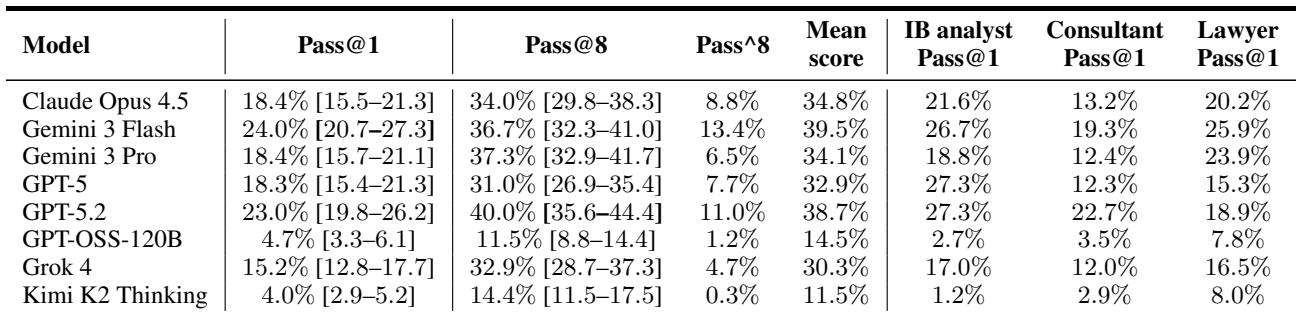
我们提出了面向智能体的 AI 生产力指数(APEX–Agents),这是一个用于评估 AI 智能体能否执行由投资银行分析师、管理咨询顾问和公司律师所创建的长期跨应用任务的基准。APEX–Agents 要求智能体在包含文件和工具的真实工作环境中进行导航。我们使用 Pass@1 对八个智能体进行了排行榜测试。Gemini 3 Flash(Thinking=High)以 24.0% 的最高分位居榜首,其次是 GPT-5.2(Thinking=High)、Claude Opus 4.5(Thinking=High)和 Gemini 3 Pro(Thinking=High)。我们开源了 APEX–Agents 基准(n = 480),包含所有提示、评分标准、标准答案、文件和元数据。我们还开源了 Archipelago,这是我们用于智能体执行和评估的基础设施。
一句话总结
Mercor 推出 APEX–Agents,这是一个开源基准测试(n=480),用于在来自投资银行、咨询和法律领域的真实文件与工具环境中评估 AI agent 在长周期、跨应用任务上的表现。该基准测试通过 Pass@1 评估了八个 agent,其中 Gemini 3 Flash(Thinking=High)以 24.0% 的成绩领先,同时发布了其 agent 执行与评估基础设施 Archipelago。
核心贡献
- 推出 APEX–Agents,一个包含 480 个长周期、跨应用任务的基准测试,任务由投资银行分析师、管理顾问和公司律师创建,旨在真实专业工作环境(含文件与工具)中评估 AI agent。
- 使用 Pass@1 对八个 agent 进行排行榜评估,结果显示 Gemini 3 Flash 以 24.0% 的成绩位居榜首,GPT-5.2 以 23.0% 紧随其后,Claude Opus 4.5 和 Gemini 3 Pro 均为 18.4%,开源模型得分低于 5%。
- 在 CC-BY 许可下开源完整的 APEX–Agents 数据集(包括提示词、评分标准、黄金输出、文件和元数据),同时开源 Archipelago,一个用于 agent 执行与评估的开源基础设施。
引言
如果 AI agent 能够可靠地完成专业服务工作,其经济和社会影响将是深远的,将重塑知识工作并提升生产力。Box、Salesforce 和 Databricks 等企业已在部署 agentic 系统,然而现有的 agentic 评估存在较大的模拟与真实差距。这些基准测试往往范围狭窄、人为设计,且仅包含简单任务,无法反映专业人士的日常工作方式。
为解决这一问题,作者提出了 APEX–Agents,一个新的前沿 AI 评估基准测试。任务由投资银行分析师、管理顾问和公司律师创建,要求 agent 进行推理、展示高级知识、使用多个应用程序,并在长周期内进行规划。该基准测试基于独特项目场景构建了数据丰富的世界,专业人士在其中规划工作并在 5 至 10 天内产出客户可交付成果。随后,agent 被赋予访问这些世界的权限,包含人类会使用的所有数据和软件。
APEX–Agents 包含 33 个世界中的 480 个任务。通过测试八个模型,作者发现 Gemini 3 Flash 表现最佳,Pass@1 得分为 24.0%,GPT-5.2 以 23.0% 紧随其后,Claude Opus 4.5 和 Gemini 3 Pro 均为 18.4%。开源模型得分低于 5%,凸显了显著差距。结果表明仍有很大的提升空间,即使表现最好的 agent 在 Pass@1 上的得分也低于 25%,失败原因包括步骤耗尽以及不同运行之间表现不一致。数据集和基础设施 Archipelago 已开源,以促进进一步研究。
数据集
数据集构成与来源
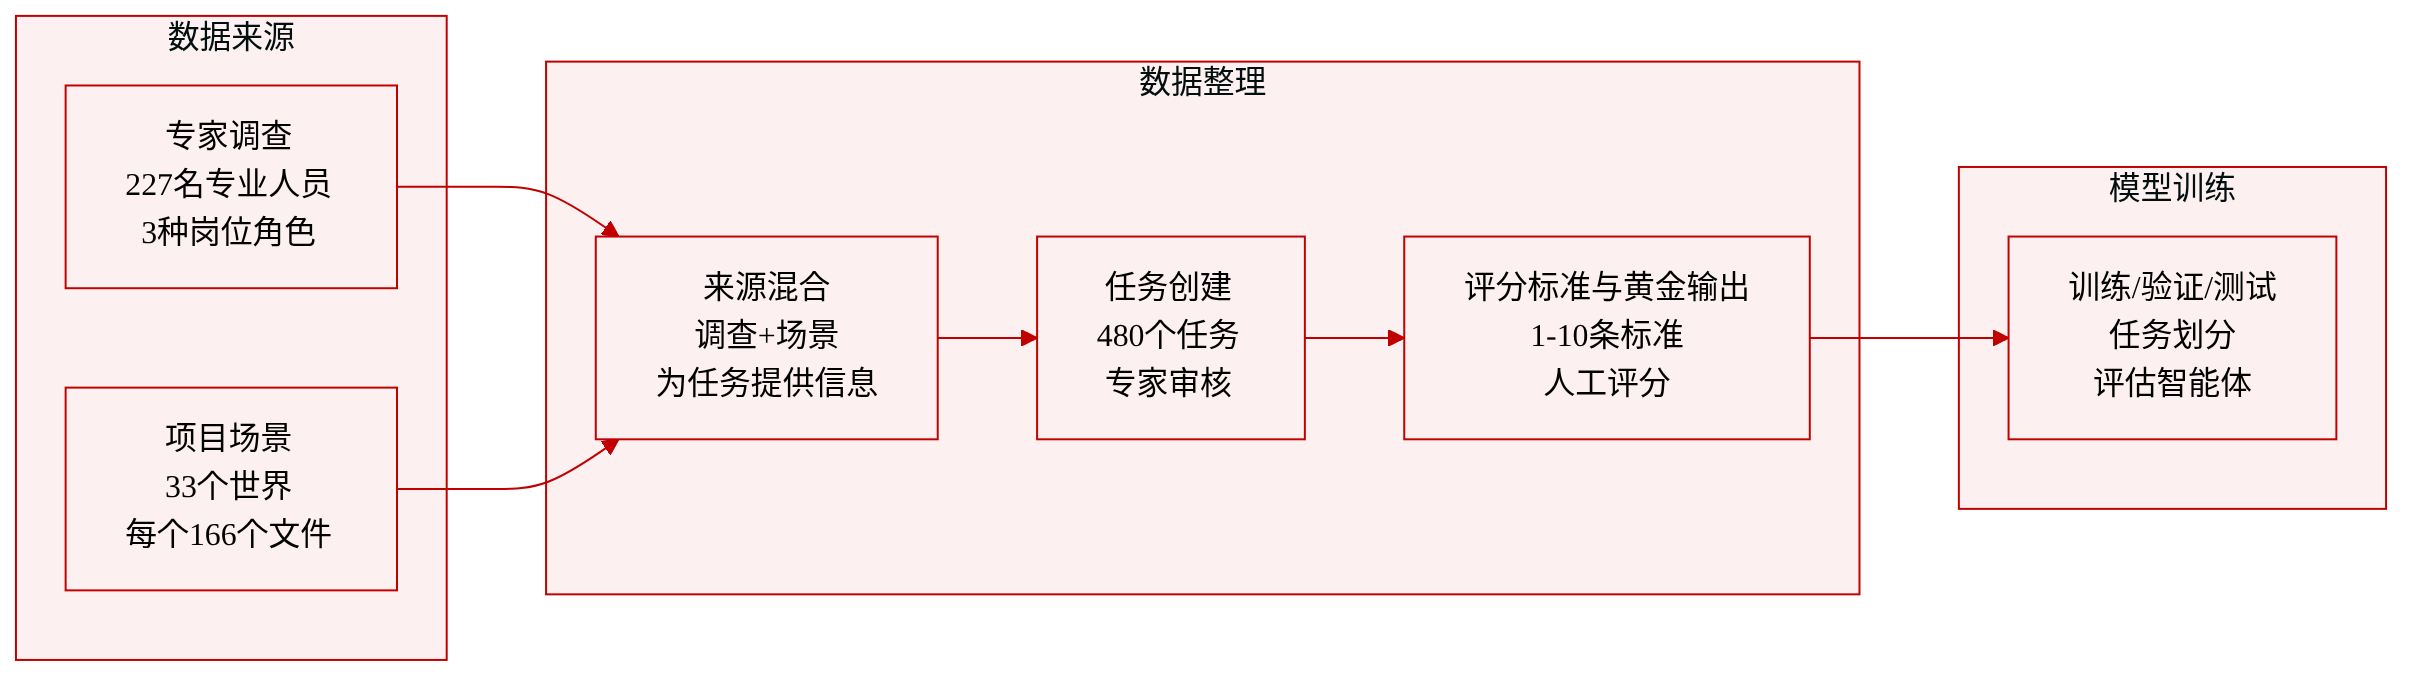
APEX-Agents 基准测试基于对 Mercor 人才市场中 227 位专家的调查构建,涵盖 58 位金融与投资分析师、77 位管理顾问和 92 位律师,平均拥有 10.8 年专业经验。调查要求参与者将时间分配至核心活动、学习、行政、沟通、会议和非生产性时间。核心活动占总时间的 47%,这些活动的自由文本描述被手动归为 18 个类别,直接为基准测试的任务创建提供了依据。
世界创建与结构
- 该基准测试包含 33 个世界:投资银行 10 个、管理咨询 11 个、法律 12 个。
- 每个世界始于专家创建的项目场景,灵感来自真实专业项目,并包含交付公司、客户、项目目标和约束条件等背景信息。
- 专家承担世界内角色(如合伙人、分析师、助理),朝着项目目标推进工作,发送电子邮件、开展研究,并反复迭代电子表格、报告和幻灯片等交付物。每个项目有一位专家扮演客户角色。
- 平均每个世界包含 166 个文件。在 33 个世界中,22 个完全涉及虚构实体,9 个涉及虚构场景中的真实公司,2 个为两者混合。
- 每个世界有九个应用程序(日历、聊天、代码执行、文档、文件系统、邮件、PDF、电子表格、演示文稿),提供 63 个工具。两个投资银行世界还包含 EDGAR SEC、股票与金融市场数据应用以及固定收益市场数据应用,新增 187 个工具。网络搜索被禁用以保持评估的可复现性。
任务设计
- 每个世界包含 8 至 20 个任务,平均每个世界 14.5 个任务。
- 每个任务是一个单轮提示,要求使用世界内文件和应用程序。任务基于 APEX 调查制定,并经过多轮评审。
- 贡献者使用前沿 agent(GPT-5、Claude Opus 4.5、Gemini 3 Pro)收集输出,并对任务质量进行对抗性迭代。
- 在 480 个任务中,422 个要求以控制台消息作为输出。其余 58 个要求创建或编辑电子表格(14 个创建、16 个编辑)、文档(20 个创建、2 个编辑)或演示文稿(5 个创建、1 个编辑)。
评分标准与黄金输出
- 专家创建了评分标准,其标准为自包含、简短、描述性的陈述,针对 agent 的输出判定为真或假。每条标准都有指定所需输出类型的评分目标。
- 任务包含 1 至 10 条标准,平均为 4.06。投资银行任务的平均标准数量较少,因为许多任务仅要求单一数值(如更新后的 EBITDA)。
- 对于每个任务,专家创建了包含解决提示所需确切信息的黄金输出,输出类型与要求一致。专家手动根据评分标准对黄金输出进行评分,以确保一致性。
- 每个提示和评分标准均带有元数据标签,包括预期输出类型、工作流程以及行业专业人士在现实世界中完成该任务的估计时间。
贡献者与基线验证
- 共有 256 位专家为 APEX-Agents 做出贡献,平均经验为 12.9 年(中位数为 11.0 年)。其中包括来自 BCG 和麦肯锡的前顾问、来自摩根士丹利和花旗集团的投资银行家,以及迪士尼和其他财富 500 强公司的公司律师。他们创建场景、构建世界、创建任务、审核质量,并检查黄金输出和评分标准。
- 对于 20% 的任务(n=96),独立专家从头执行以验证任务可行性、评分标准公平性和时间估计。在 10% 的任务中发现了提示、评分标准或元数据的小问题并予以修复,修复结果级联至数据集其余部分。
- 对于这些样本任务,专家估计完成时间为 1.70 小时,而实际时间为 1.37 小时,高估了 33%。整个基准测试的估计时间为 1.82 小时。
方法
作者进行了一项基线验证研究,以验证基准测试任务的质量和可行性。对于 20% 的任务(对应 96 个实例),未参与创建或评审过程的专家从头独立执行任务。该流程有三个目的:验证任务确实可以完成、评估评分标准的公平性,以及检查原始任务创建者提供的时间估计的准确性。在 10% 的基线验证任务中,作者发现提示、评分标准或元数据存在小问题,随后予以修复,并将修正级联至整个数据集以确保一致性。对于样本任务,专家估计完成时间为 1.70 小时,而实际测量时间为 1.37 小时。这显示出 0.45 小时的高估,对应 33% 的偏差,表明原始时间估计相对于实际执行时间往往偏保守。
实验
APEX-Agents 基准测试由 33 个专家创建的世界构成,涵盖投资银行、管理咨询和法律领域,包含 480 个长周期任务,通过评分标准和黄金输出进行评分,基线验证研究确认了任务可行性和评分标准公平性。评估使用了一个评判模型(Gemini 3 Flash),该模型在真实标签集上验证的准确率为 98.5%,Pass@1 为主要指标。结果显示 Gemini 3 Flash 以 24.0% 的 Pass@1 领先,GPT-5.2 紧随其后,而开源 agent 低于 5%;Pass@8 得分高出约 15 个百分点,表明具备能力但缺乏一致性。失败分析显示,成功的轨迹使用更少的步骤和工具调用,避免了死循环,文件输出任务更难,而 token 使用量差异很大但与性能无相关性。
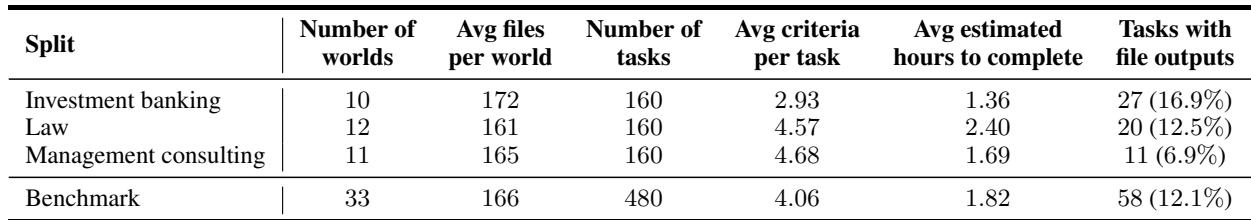
APEX–Agents 基准测试涵盖三个领域,33 个世界中共有 480 个任务,平均每个世界约 166 个文件,每个任务平均 4 条评估标准。需要文件输出的任务较少,且 agent 得分往往较低,而文件删除较为罕见,被视为不良行为。投资银行的文件输出任务比例最高,为 16.9%,管理咨询最低,为 6.9%。法律任务的平均估计完成时间最高,为 2.40 小时,而投资银行为 1.36 小时。在整个基准测试中,仅有 12.1% 的任务需要文件输出,agent 在这些任务上的得分低于控制台输出任务。文件删除仅出现在 0.12% 的轨迹中,其中 GPT-5.2 的删除次数最多。
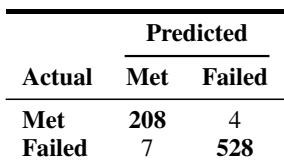
评判模型与人工标签高度一致,总体准确率为 98.5%,精确率和召回率均衡在 97% 至 98% 左右。错误较为罕见,假阳性和假阴性各约占 1% 至 2% 的情况,且该模型对其评分的 agent 表现相似,缓解了自我偏好问题。评判模型能正确识别大多数满足和未满足的标准,仅在每个方向上存在少量误分类。精确率和召回率均较高,表明评判模型很少过度或不足地认定标准。评判模型对其同时评估的 agent 的假阳性率与其他 agent 相当,表明自我偏好偏差有限。
Gemini 3 Flash 以 24.0% 的 Pass@1 领先 APEX–Agents 基准测试,GPT-5.2 以 23.0% 紧随其后,而开源 agent 远远落后,得分低于 5%。Pass@8 得分比 Pass@1 高出约 15 个百分点,表明 agent 具备能力但缺乏一致性。统计检验显示,排名前两位的模型之间没有显著差异,但均显著优于其他所有模型。闭源 agent 大幅领先于开源 agent,开源模型在 Pass@1 上得分低于 5%。Pass@8 得分比 Pass@1 高出约 15 个百分点,表明 agent 具备能力但缺乏一致性。两个最佳 agent(Gemini 3 Flash 和 GPT-5.2)之间的差异在统计上不显著,但两者均显著优于其他所有模型。开源 agent 在公司法任务中相对更强,得分约为 8%,而在其他工作类别中仅为个位数。GPT-5.2 在 Pass@8 上取得最高分 40.0%,其次是 Gemini 3 Pro 和 Gemini 3 Flash。
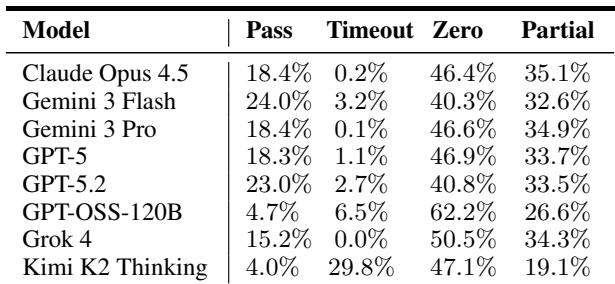
在 APEX-Agents 上,闭源模型优于开源模型,Gemini 3 Flash 的通过率最高,GPT-5.2 紧随其后。所有 agent 在至少 40% 的运行中得分为零,开源模型的超时更为频繁,尤其是 Kimi K2 Thinking。文件相关任务和意外的文件删除是额外的失败来源。Gemini 3 Flash 的通过率最高,GPT-5.2 紧随其后,而 GPT-OSS-120B 等开源模型明显落后。所有 agent 在至少 40% 的运行中完全失败,表明任务难度较高。开源模型的超时频率远高于闭源模型,Kimi K2 Thinking 在近 30% 的轨迹中超时。意外的文件删除很少见,但以 GPT-5.2 最为频繁,而有些模型从不删除文件。在所有领先模型中,需要创建或编辑文件的任务得分低于控制台输出任务。
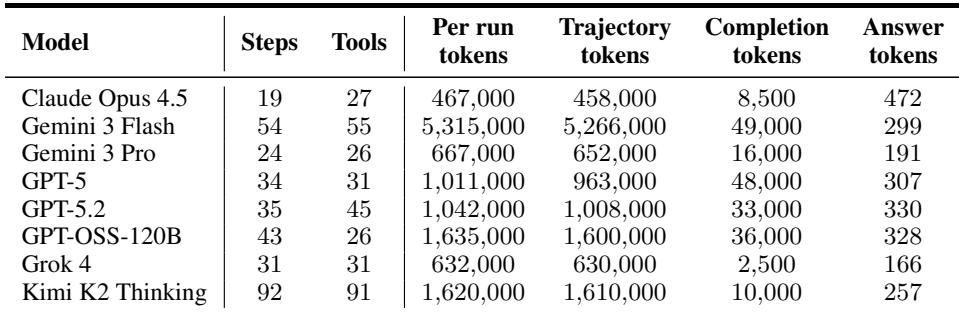
Agent 在资源使用方面差异很大,Gemini 3 Flash 消耗的 token 和步骤最多,Kimi K2 Thinking 也使用大量资源但未带来相应的更好结果。各 agent 的最终答案 token 数量相近,表明输出长度相当。Gemini 3 Flash 使用的 token 约为 GPT-5.2 的 5 倍,约为 Gemini 3 Pro 的 8 倍,同时步骤数比 GPT-5.2 多约 54%,工具调用多约 22%。Kimi K2 Thinking 每个任务平均使用 92 个步骤和 91 次工具调用,以及 160 万 token,但更高的资源使用并未持续带来更好的输出。答案 token 数量相对均匀,从 Gemini 3 Pro 的 191 到 Claude Opus 4.5 的 472,表明 agent 在输出长度上差异不大。
APEX-Agents 基准测试在三个领域的 480 个任务上评估 agent,结果显示闭源模型(以 Gemini 3 Flash 和 GPT-5.2 为首)显著优于开源 agent,后者在 Pass@1 上得分低于 5%。评判模型表现出高可靠性,准确率为 98.5%,自我偏好偏差极小。文件输出任务较少且更难,资源使用差异很大,Gemini 3 Flash 消耗的 token 和步骤远多于其他模型,但性能并未成比例提升,且所有 agent 在至少 40% 的运行中完全失败。