Command Palette
Search for a command to run...
TERMINAL-BENCH:在命令行界面中针对困难、现实任务的智能体基准测试
TERMINAL-BENCH:在命令行界面中针对困难、现实任务的智能体基准测试
摘要
AI 智能体可能很快将能够在不同领域中自主完成有价值的、长期的任务。当前的基准测试要么不衡量现实世界的任务,要么难度不足以有意义地衡量前沿模型。为此,我们提出了 Terminal-Bench 2.0:一个精心策划的困难基准测试,由 89 个计算机终端环境中的任务组成,这些任务灵感来源于真实工作流程中的问题。每个任务都有独特的环境、人工编写的解决方案和全面的验证测试。我们表明,前沿模型和智能体在该基准测试上的得分低于 65%,并进行了错误分析,以确定模型和智能体改进的领域。我们发布了数据集和评估工具,以帮助开发者和研究人员在 tbench.ai 上进行未来的工作。
一句话总结
斯坦福大学、Anthropic 及合作者提出了 Terminal-Bench 2.0,一个包含 89 个困难且真实的命令行任务的精选基准,配有手工编写的解决方案和全面的测试,实验表明前沿 Agent 的得分低于 65%,并提供了错误分析以指导未来模型和 Agent 的改进。
核心贡献
- 提出了 Terminal-Bench 2.0,一个包含 89 个任务、运行于真实计算机终端环境的基准,每个任务都有独特的环境、手工编写的解决方案和全面的验证测试,这区别于依赖合成环境或狭窄 CLI 子任务的先前基准。
- 在 16 个前沿模型上对这些任务进行了基准测试,显示顶级模型解决的任务少于 65%,而较小模型的得分约为 15%,并提供了一套失败模式分类以指导未来模型和 Agent 的改进。
- 在 tbench.ai 发布了数据集和评估框架,并纳入了可复现性措施,如固定包版本、预构建 Docker 镜像和 Big-Bench canary 字符串,以帮助训练数据去污染。
引言
随着 AI Agent 在高风险领域中能够自主执行长时间任务,基准测试必须不断演进以反映真实世界任务的复杂性。终端是软件工程、科学计算和网络安全等专业工作的关键接口,并已成为 Cursor 和 Claude Code 等 AI Agent 的标准环境。然而,现有基准通常侧重于命令行使用的狭窄方面或依赖合成环境,无法捕捉专业级终端工作的多样性和难度。
作者提出了 Terminal-Bench,一个用于在真实命令行任务上评估 Agent 的框架。每个任务包含一个容器化环境、一条指令、验证测试和一份手工编写的参考解决方案。他们还提出了 Terminal-Bench 2.0,一个包含 89 个任务、由三位评审者手工验证的数据集。对前沿模型的基准测试显示,它们解决的任务少于 65%,而较小模型的得分约为 15%。作者还提供了一套失败模式分类以指导未来发展。
主要局限性包括 Agent 可能访问互联网以查找 oracle 解决方案、潜在的训练数据污染,以及外部依赖或机器资源的可变性。尽管经过手工评审,某些任务仍可能不完全符合验证标准,但作者优先考虑多样性和真实性,而非验证的简便性。
数据集
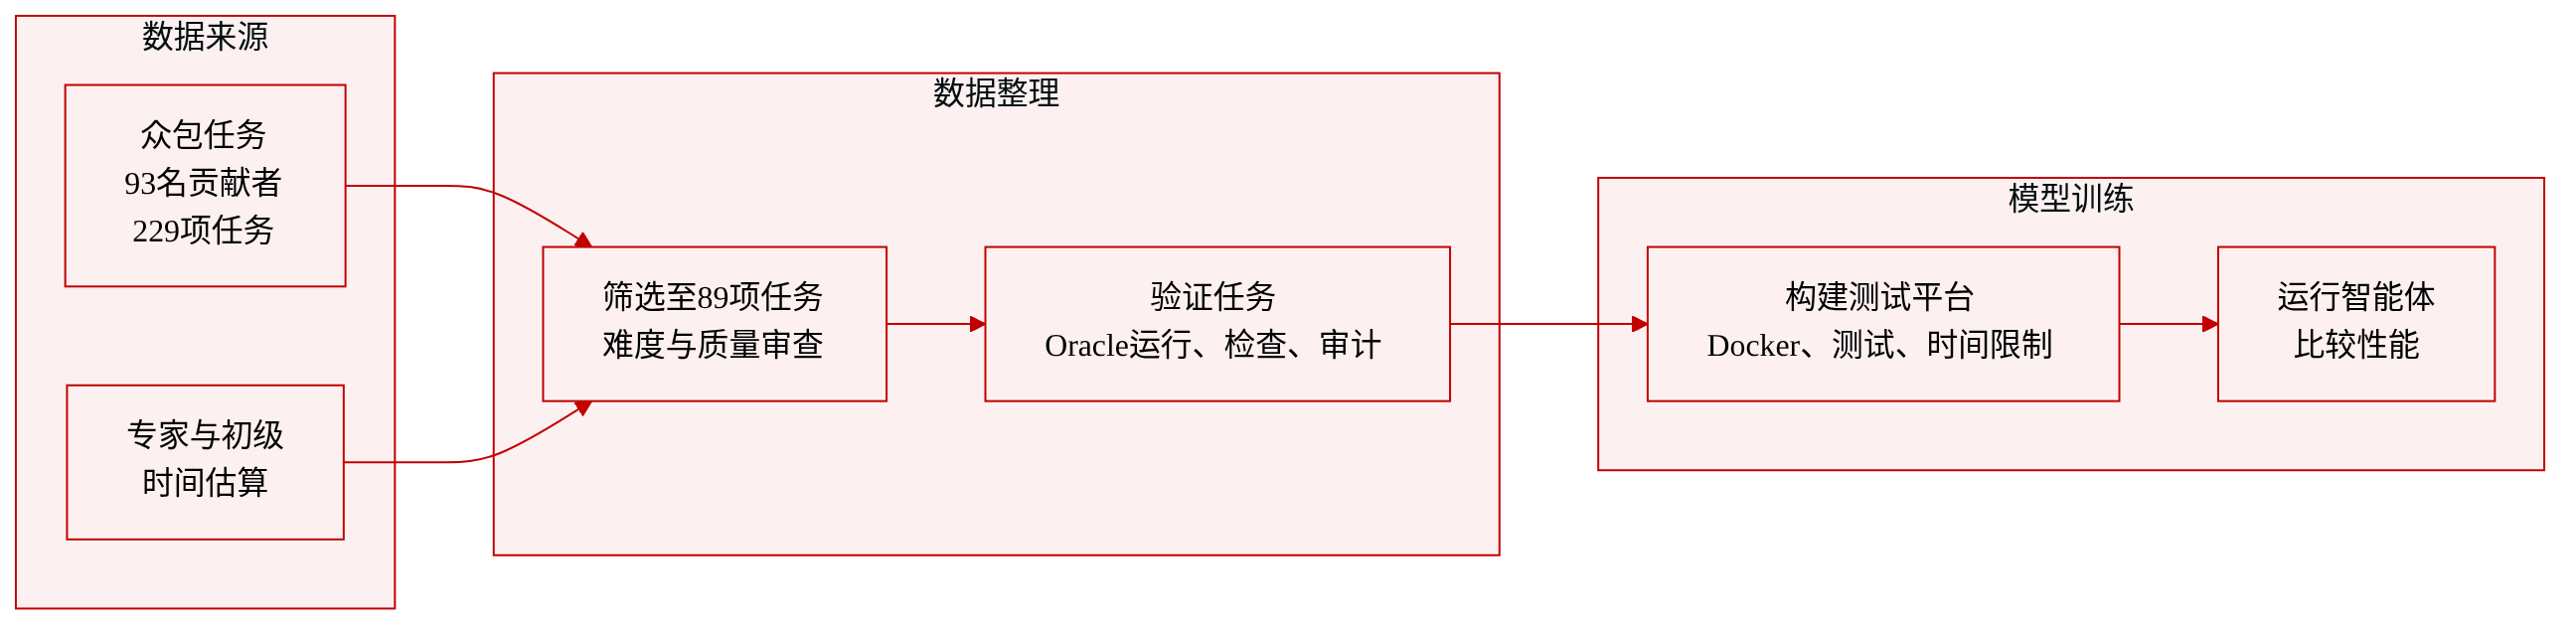
作者提出了 Terminal-Bench,一个用于构建 Agent 可通过终端解决的真实任务的框架。该数据集包含的任务范围从训练机器学习模型,到从源代码构建并运行 Linux,再到逆向工程二进制文件。
数据集组成和来源
- 任务通过开源贡献众包生成,共有 93 位贡献者创建了 229 个任务。
- 从这 229 个任务中,作者根据自身难度评估和三位经验丰富的人类评审者的质量评估,为 Terminal-Bench 2.0 数据集挑选了 89 个任务。
- 每个任务包含一条指令、一个 Docker 镜像、一组测试、一个示例解决方案和一个时间限制。指令描述了 Agent 必须在 Docker 容器内于时间限制内完成的内容。
每个子集的关键细节
- 测试通过检查最终容器状态的属性来验证指令中描述的所有结果是否已实现。测试不检查 Agent 的命令或控制台输出,使框架以结果为导向。
- 贡献者为其任务分配了专家和初级工程师的完成时间估计。这些估计的分布以及每个任务的高层类别已在论文中报告。
- 任务使用 Harbor 任务格式指定,并使用 Harbor 框架运行,该框架支持流行的 Agent,包括 Claude Code、Codex CLI、OpenHands 和 Mini-SWE-Agent,以及作者自己的 Agent Terminus 2。
验证和筛选规则
- 如果经验丰富的评审者确定任务符合具体性、可解决性和完整性标准,则该任务被视为已验证。
- 具体性意味着单元测试仅在容器达到可接受状态时通过。
- 可解决性由 oracle 解决方案脚本确认,执行该脚本后所有测试用例均通过。
- 完整性确保 Agent 无法通过真实部署中不存在的捷径作弊,例如从 git 仓库历史中删除未来提交。
- 验证过程包括自动化工作流(运行 oracle 解决方案)、贡献者检查清单、用于发现常见错误的自动化语言模型工具、经验丰富评审者的手工评审、使用多个语言模型运行任务、用于检测设计缺陷的对抗性利用 Agent,以及由两位额外审计员进行的最终手工评审。
- 作者指出,最终基准中的每个任务大约经历了三小时评审者工作。
数据的使用方式
- 任务是交互式的。一旦向 Agent 提供指令和 Docker 容器,它必须通过调用工具(如编辑文件或运行 Bash 命令)来探索和操作环境,以完成任务。
- 作者将该数据集作为比较模型性能的中立测试平台,包括他们自己的 Agent Terminus 2。
方法
作者提出了 Harbor,一个专门用于大规模构建和执行 Agent 评估的框架。Terminal-Bench 任务以 Harbor 任务格式实现,并使用 Harbor 框架执行,确保一致且可复现的评估流程。Terminal-Bench 2.0 通过 Harbor 注册表分发,用户可直接使用命令 harbor run -d [email protected] 运行该基准。
Harbor 预集成了多个容器沙箱提供商,为每次 Agent 运行提供灵活且隔离的执行环境。在作者的实验中,他们使用 Daytona 作为沙箱提供商,并行运行 32 到 100 个容器以实现高吞吐量评估。实验中使用的 Harbor 配置文件可在 github.com/laude-institute/terminal-bench-experiments 仓库中公开获取,以促进可复现性和研究社区的进一步定制。
实验
评估在 Terminal-Bench 2.0 上运行了六个 Agent 和 16 个前沿模型,总计超过 32,000 次试验,并使用自定义脚手架(Terminus 2)作为模型比较的中立基线。结果显示,专有模型与兼容 Agent 的组合主导了排行榜前列,其中 Codex CLI 和 GPT-5.2 实现了最高的解决率,且模型选择通常比 Agent 脚手架更重要。成本和交互模式差异很大,但轮次数量和 token 使用量均与成功无关。较新的模型在八个月内将最先进性能提升了近一倍,表明该基准可能很快饱和。人类预测的任务难度与经验难度呈正相关,但人类往往高估需要创造性推理任务的易度。轨迹级错误分析揭示了不同的失败特征:封闭模型主要遭受执行错误,而一个开放模型在执行、连贯性和验证方面表现出均衡的错误。命令级分析将缺失可执行文件确定为最常见的失败,各模型的错误率在 9% 到 27% 之间。
Terminal-Bench 2.0 中的任务完成时间估计范围很广,专家估计大多在一天以内,初级工程师估计大多在一小时到一周之间。一小部分任务属于极长周期任务,其中一项任务专家需要近一整天,初级工程师需要十天。专家估计近一半任务在一小时内完成,而初级工程师估计只有约 8% 在该范围内。初级工程师的估计集中在一小时到一天之间,超过 70% 的任务在该区间。一小部分任务预计初级工程师需要一周以上,而没有任何任务预计专家需要那么长时间。一项修复 OCaml 垃圾收集器的任务,专家估计需要 24 小时,初级工程师估计需要 240 小时。
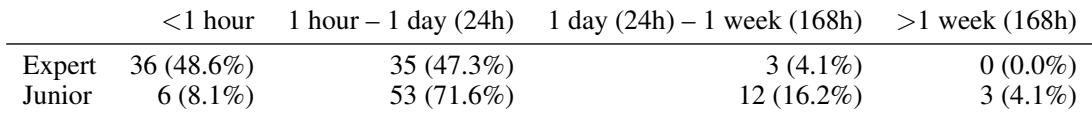
Terminal-Bench 2.0 任务持续时间估计显示出广泛的分布,专家通常预期大多数任务在一天内完成,而初级工程师预测的时间线更长,大多在一小时到一周之间。专家将近一半的任务评为一小时内,而初级工程师将超过 70% 的任务置于一小时到一天之间,只有约 8% 在一小时内。少数任务属于极长周期任务,例如修复 OCaml 垃圾收集器,专家估计需要 24 小时,初级工程师估计需要 240 小时,且没有任何任务预计专家需要一周以上,尽管有些任务对初级工程师确实如此。