Command Palette
Search for a command to run...
TeleChat3-MoE 训练报告
TeleChat3-MoE 训练报告
摘要
TeleChat3-MoE 是 TeleChat Wang et al. (2024a;b; 2025); Li et al. (2024a;b) 大语言模型的最新系列,采用 Mixture-of-Experts (MoE) 架构,参数规模从 1050亿到超过 1万亿,在 Ascend NPU 集群 Huawei Technologies Co. (2023) 上端到端训练。本报告主要介绍支撑可靠且高效扩展至前沿模型规模的底层训练基础设施。我们详细阐述了面向算子级和端到端数值精度验证的系统化方法,以确保不同硬件平台和分布式并行策略之间的一致性。此外,我们引入了一系列性能优化,包括交错流水线调度、面向长序列训练的注意力感知数据调度、面向专家并行的分层重叠通信,以及基于 DVM 的算子融合。我们还提出了一种系统化并行化框架,利用解析估计和整数线性规划来优化多维并行配置。此外,我们提出了面向集群级优化的方法学路径,以解决大规模训练任务中的主机端和器件端瓶颈。这些基础设施改进带来了显著的吞吐量提升,并在包含数千台设备的集群上实现了近似线性扩展,为基于硬件生态的大规模语言模型研发提供了坚实基础。
一句话总结
中国电信人工智能研究院(TeleAI)与华为联合推出 TeleChat3-MoE,这是一个参数量从 1050 亿到超过一万亿的混合专家大语言模型系列,并在昇腾 NPU 集群上完成端到端训练。其训练基础设施结合算子级与端到端数值精度校验、流水线和专家并行性能优化、面向多维并行的整数线性规划以及集群级调优,从而在包含数千台设备的集群上获得吞吐提升与接近线性的扩展性。
核心贡献
- 面向昇腾 NPU 集群上的 TeleChat3 MoE 语言模型,构建了系统化训练基础设施,包括算子级与端到端数值精度校验,以在不同硬件平台和分布式并行策略之间保持一致性。
- 面向前沿规模训练引入性能优化,包括交错流水线调度、面向长序列的注意力感知数据调度、用于专家并行的分层重叠通信、基于 DVM 的算子融合,以及面向多维并行配置的解析式整数线性规划框架。
- 通过基于性能剖析的集群级优化解决主机与设备瓶颈,从而实现较高的 Model Flops Utilization、在数千设备集群上的接近线性扩展,并开源面向大语言模型的训练技术栈。
引言
大型语言模型越来越多地依赖混合专家(MoE)架构,以扩展到数千亿甚至数万亿参数,同时保持可控的活跃计算量。这使在大规模加速器集群上训练成为一项基础设施挑战:系统必须保持数值精度、维持分布式效率,并在众多设备之间选择有效的并行策略。以往实践往往依赖人工专家调优,并且当模型在硬件、框架或分布式配置之间迁移时可能出现精度不一致。针对这一问题,该工作基于 MindSpore,在华为昇腾 NPU 上构建了 TeleChat3-MoE 的训练基础设施。该工作引入系统化精度校验,以及面向流水线调度、长序列负载均衡、专家并行通信重叠和算子融合的框架优化,并提出一种将解析估算与整数线性规划相结合的并行优化器,将调优时间从数天缩短至数小时。
方法
该工作构建了 TeleChat3-MoE 系列,这是一个参数量从 1050 亿到数万亿、基于统一混合专家架构的大语言模型家族。为支持前沿规模下的高效训练与推理,该架构融合了若干关键改进。首先,Multi-Latent Attention 将 key-value 向量压缩到低维 latent space,从而显著减少缓存占用,并提升推理期间的计算强度。其次,模型采用浅层而宽的拓扑结构,以较少层数和更宽的隐藏维度增强计算密度,并降低流水线 bubble 开销。第三,采用高稀疏度 MoE 设计,其中活跃参数仅占总参数的一小部分,例如在数百个专家外加一个共享专家中采用 top-4 到 top-8 路由,从而带来较低的激活内存占用和更高并发度。
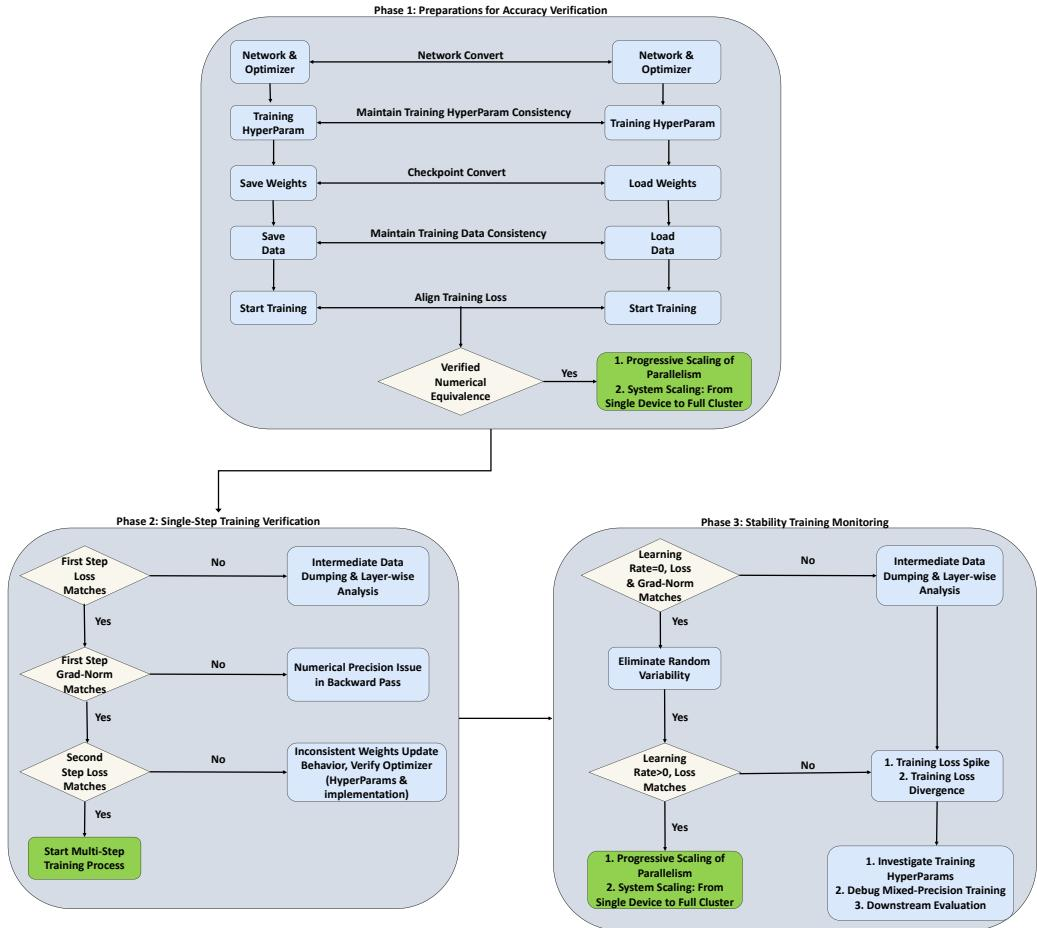
为确保在异构硬件上训练可靠且可复现,该工作建立了跨硬件精度对齐的系统化流程。该流程首先对齐基础配置,包括词表、网络架构、超参数以及混合精度设置。如果仍存在偏差,则执行结构化定位流程以隔离根因,从单设备验证逐步推进到全集群扩展,如下所示。
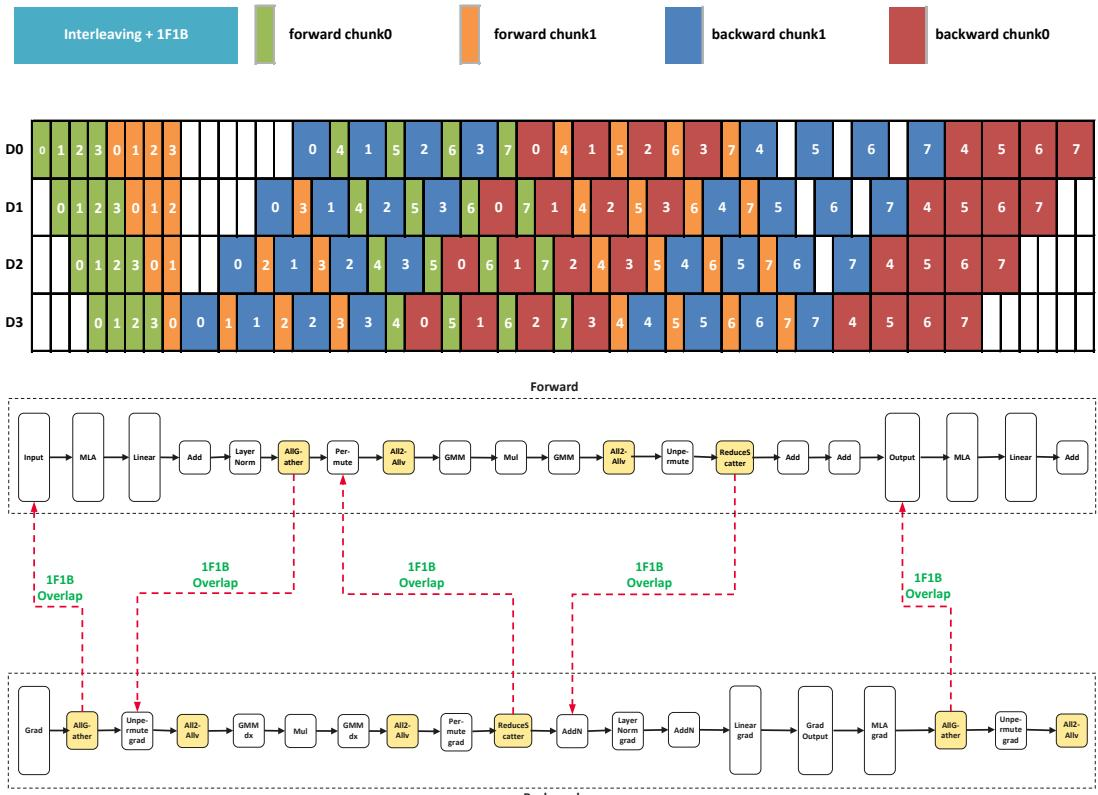
为在超大规模集群上实现高效训练,该工作在训练框架内实现了多项关键优化。在流水线并行方面,采用交错流水线调度,并结合 1F1B 重叠策略。不同于为每个阶段分配连续层的传统方法,交错调度将非连续层进行分配,从而实现更细粒度并行。在稳态阶段,调度来自不同 micro-batch 的相邻前向与反向过程,使计算与通信重叠,大幅减少流水线 bubble,并提升端到端吞吐,如下图所示。
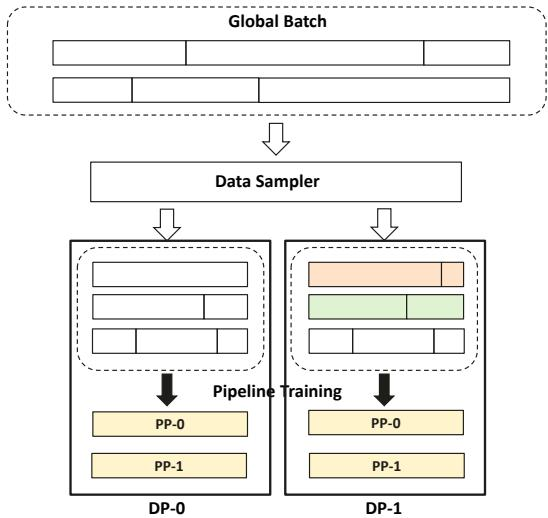
在包含稀疏注意力的长序列预训练任务中,由于计算成本依赖输入且文档长度变化较大,常出现严重负载不均衡。为解决该问题,提出注意力感知数据调度机制。通过根据子序列长度在每个 micro-batch 内重新分配样本,调度器在各设备之间平衡总注意力计算量,确保负载均衡执行,并提升长上下文模型的吞吐,如下图所示。
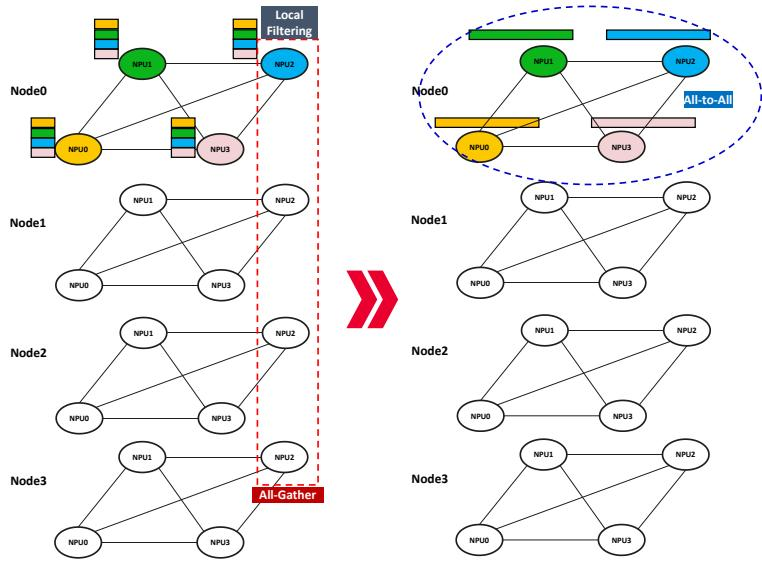
在混合专家训练中,通过专家并行进行的跨设备通信往往占据主要训练时间。该工作提出分层拓扑感知通信方案,以替代全局 All-to-All 集合通信。该三步流程首先在节点间执行 AllGather,使每台机器收集完整数据;随后执行本地过滤,仅保留所需专家副本;最后在节点内执行 All-to-All 进行重新分布。通过使通信模式与物理集群拓扑对齐,该设计显著减少冗余跨设备流量,如下图所示。
基于该分层方案,进一步设计了专家并行通信重叠技术,以最大限度降低开销。输入数据按 batch 和 sequence 维度划分,并送入多个并发执行流。这样,一个执行流中的通信可以被另一个执行流中的前馈网络计算所重叠。此外,节点间通信与节点内通信可在不同网络上并行执行且不发生带宽竞争,从而显著降低通信时间在训练中的占比,如下图所示。
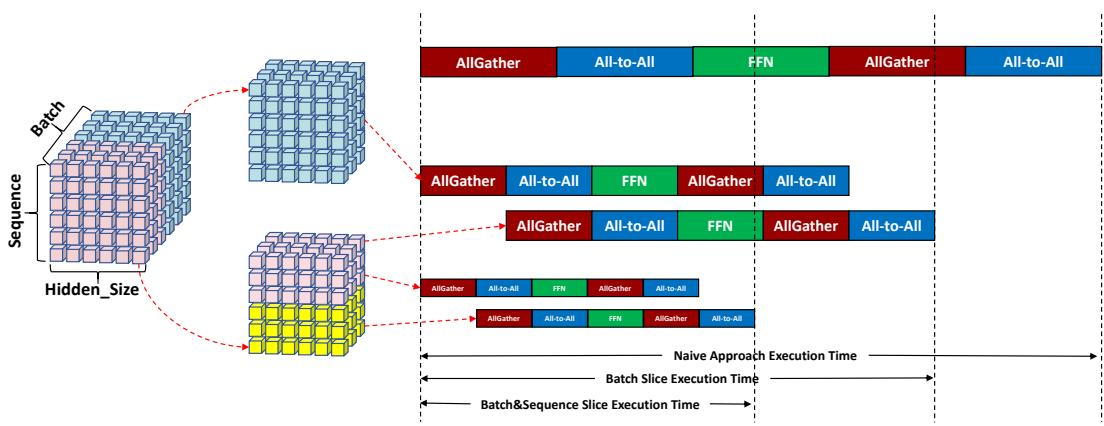
最后,为解决限制计算单元利用率的 memory-bound 小算子问题,采用基于 Device Virtual Machine 框架的自动算子融合技术。该方法将 memory-bound 算子与相邻算子融合并联合执行,消除中间张量的显式物化,并减少全局内存访问,对计算密集与访存密集的 kernel 组合尤其有效。
实验
实验评估大规模 MoE 训练栈的可扩展性、正确性与实际效率。结果表明,流水线、通信和自动并行化技术支持从较小集群到数千设备的高效扩展;所提工具达到或超过人工调优效果,同时降低工程投入。精度对齐研究表明,逐步扩展与张量比较可以识别框架级不一致,从而在异构硬件上保持一致行为。额外集群剖析确认,主机隔离、设备功耗策略调整以及降低监控开销可提升吞吐稳定性与利用率。
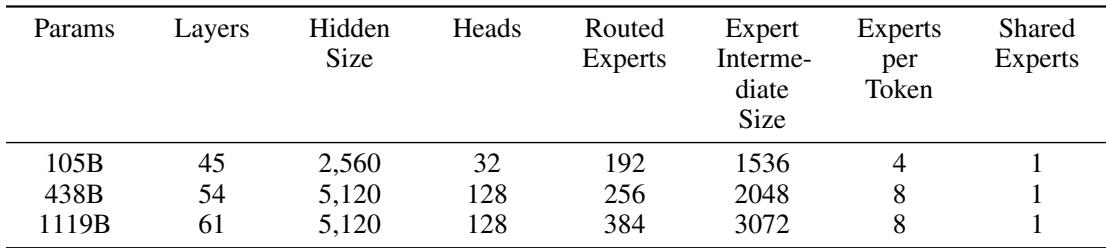
TeleChat3-MoE 系列涵盖三种模型规模,并保持一致的混合专家设计。随着参数量增加,模型主要通过增加层数、提升容量维度以及扩展 routed expert 容量来扩展,同时全部模型共享一个共享专家,并通过优化后的位置嵌入支持长上下文。随着整体参数量增长,较大模型会增加深度和 routed expert 容量。最大模型与中等模型使用相同隐藏宽度和 head 数,但拥有更多 routed expert 和更宽的 routed expert。所有模型均保留一个共享专家,并支持更长的上下文长度。
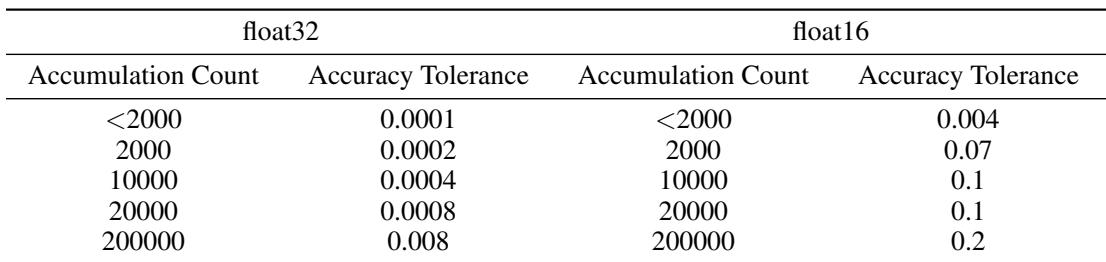
推荐的精度容差标准随累加次数增加而放宽,因为重复累加会放大数值误差。Float32 测试要求比 float16 更严格的容差,而两种精度类型对于累加次数更高的算子均需更宽松的限制。具有更多累加操作的算子被赋予更大的精度容差。Float32 容差比 float16 容差更严格。
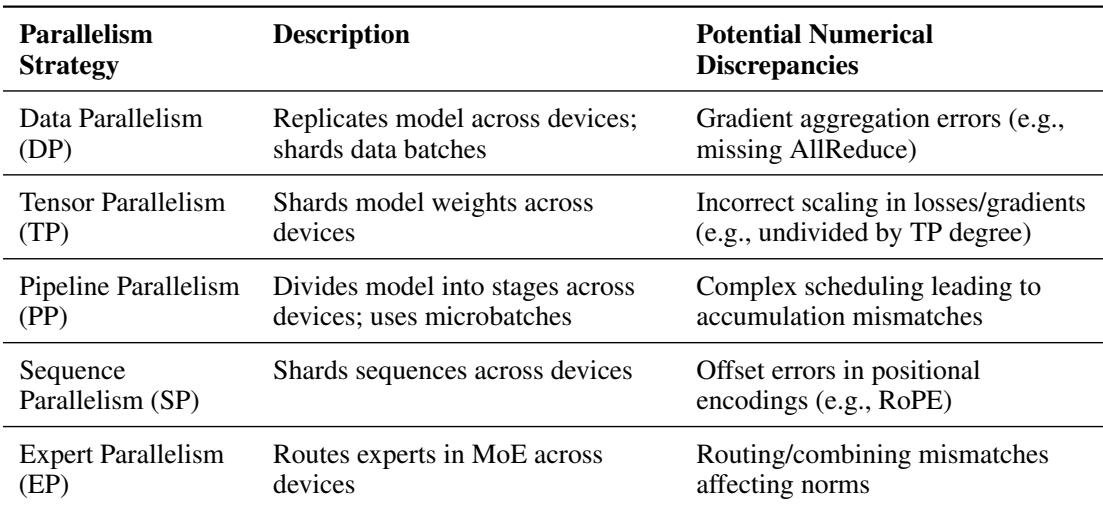
该表列出大规模训练中主要并行方案及其可能出现的数值不一致。它支持一种验证流程:从可复现基线开始,应用新的并行配置,检查前向与反向等价性,并在张量、梯度或优化器状态中定位偏差。在扩展 MoE 模型时,专家路由、流水线调度和序列分片都可能引入隐藏数值变化,这些风险需要特别关注。数据并行主要面临梯度聚合误差风险,例如遗漏 AllReduce 操作;张量并行在 TP degree 未正确处理时,可能导致损失或梯度缩放错误;流水线并行可能由于复杂 microbatch 调度导致累加不一致;序列并行可能在 RoPE 等机制中引入位置偏移误差;专家并行可能通过 MoE 模型中的路由与组合不一致影响范数。所述调试方法使用相同的 seed 与权重、等价性检查和增量回滚,以隔离通信或调度问题。
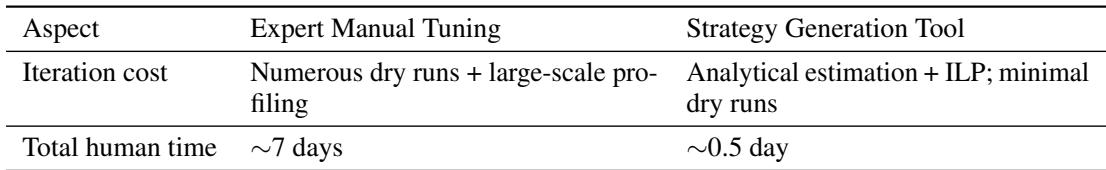
该表比较专家人工调优与使用策略生成工具的系统化并行化框架。该工具以解析估算和基于 ILP 的搜索取代大量试运行和大规模 profiling,从而降低迭代成本。它同时也大幅降低人工调优总工时,将流程从约一周缩短至一天以内。人工调优依赖反复试运行和大规模 profiling;策略生成工具使用解析估算与 ILP,仅需极少试运行。并行化调优的总人工时间从约一周缩短至不到一天。
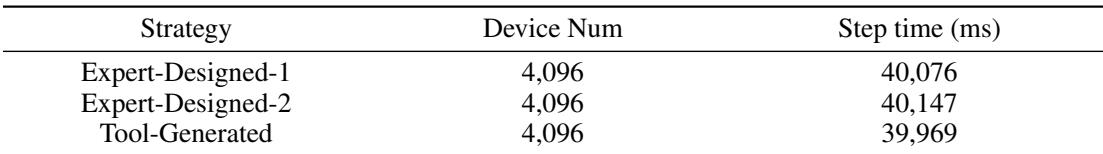
该工具生成的策略在 4,096 台设备的对比配置中实现最低 step time,略优于专家设计的基线。它通过自动化并行设计搜索降低工程投入,支持大型 MoE 模型在大型集群上更快且更可复现的扩展。工具生成配置报告的 step time 最低。在相同大规模设置下,它与专家设计策略持平或略有提升。结果表明,自动并行优化可在保持性能的同时降低调优投入。
该评估检查 TeleChat3-MoE 扩展设计,并验证数值稳定性、并行调试与自动策略优化。结果表明,精度容差应随累加次数增加而放宽,同时 Float32 应比 Float16 保持更严格。并行分析识别了数据、张量、流水线、序列和专家并行设置中的数值风险,并支持一种以基线为驱动的流程来隔离偏差。与专家调优的比较表明,基于解析估算与 ILP 的策略生成大幅降低调优时间,并在大型集群上取得有竞争力的 step time。