Command Palette
Search for a command to run...
CLaRa:以连续潜在推理连接检索与生成
CLaRa:以连续潜在推理连接检索与生成
Jie He Richard He Bai Sinead Williamson Jeff Z. Pan Navdeep Jaitly Yizhe Zhang
CLaRa 连续潜变量推理数据集
摘要
检索增强生成(RAG)利用外部知识增强了大语言模型(LLM),但仍存在上下文过长以及检索与生成优化相互割裂的问题。在本工作中,我们提出了 CLaRa(连续潜在推理),一个在共享连续空间中执行基于嵌入的压缩与联合优化的统一框架。为了获得语义丰富且可检索的压缩向量,从而缩短输入至生成器的文档长度,我们引入了 SCP,一种基于问答与释义监督的、保留关键信息的的数据合成框架。随后,CLaRa 通过单一的语言建模损失端到端地训练重排器与生成器,并使用可微分的 top-k 估计器使梯度能够同时流经两个模块。理论上,这种统一优化使得检索相关性与答案质量相一致。在多个问答基准上的实验表明,即使在文本压缩率达到 16 倍的情况下,CLaRa 在压缩与重排性能上仍达到了最优水平,超越了基于文本微调的基线方法。
一句话总结
来自苹果公司和爱丁堡大学的研究者提出了 CLaRa(Continuous Latent Reasoning)——一个统一框架,通过 SCP 关键保留合成框架将检索到的文档压缩为嵌入向量,并使用可微的 top-k 估计器端到端地训练重排序器和生成器,在多个问答基准上以 16 的文本压缩率实现了最先进的压缩与重排序性能。
核心贡献
-
引入 CLaRa,一个统一框架,将 RAG 文档压缩为连续潜在向量,并通过可微 top-k 估计器联合优化重排序器和生成器,使得检索器能够通过生成器的语言建模损失进行无标签学习。
-
提出 SCP,一个关键保留数据合成框架,从问答对(包括组合推理案例)和改写文档中构建预训练监督,以生成语义丰富、可检索的压缩向量,从而缩短生成器上下文。
-
在四个单跳和多跳问答基准上使用 Mistral-7B 和 Phi-4B 进行评估,实现了最先进的压缩和重排序性能,在文本压缩比为 16 的情况下,优于监督式、无监督式和纯文本 DRO 基线。
引言
检索增强生成(RAG)是一种将大型语言模型锚定到外部证据的有效方式,然而大多数 RAG 系统存在结构性缺陷:检索和生成是分开优化的。检索器根据表面相似度对文档排序,而生成器不提供关于实际所需内容的反馈,导致两个相互关联的问题。首先,效率受到架构不匹配的损害,因为稠密检索器在嵌入空间中操作,而生成器消费原始文本,造成冗余处理、更高的推理成本和上下文溢出。其次,优化被阻塞,因为离散的文档选择使得梯度无法回流到检索器,因此它无法与生成器的任务目标对齐。先前的解决方案,例如基于嵌入的压缩或用于联合训练的强化学习,仍然依赖原始文本,需要特定于查询的重新压缩,或面临不稳定且计算量大的训练。
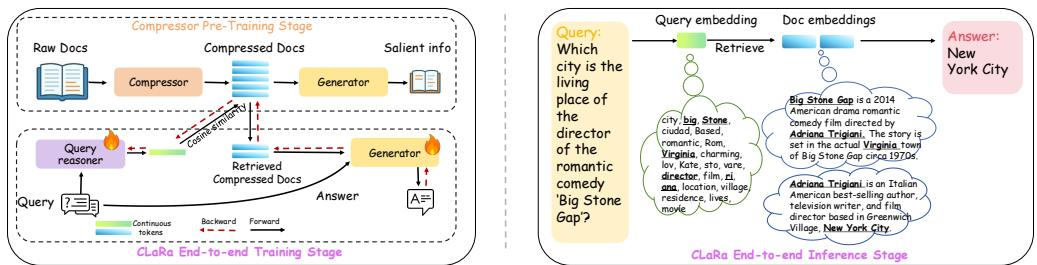
作者贡献了 CLaRa(Continuous Latent Reasoning),一个在共享的连续文档表示上进行检索和生成的统一框架。每个文档被编码为紧凑的记忆 token 集,同时用于检索和生成,消除了冗余计算并实现了真正的端到端优化。他们引入了一个显著信息感知的预训练目标来保持语义保真度,并使用直通估计使 top-k 文档选择可微,从而允许生成器梯度直接更新检索器,而无需显式的检索标签。作者表明这一统一目标为检索器学习提供了有效的梯度,并在单跳和多跳问答基准上评估了 CLaRa,其性能优于监督式和无监督式基线,同时在高文本压缩比下取得了强劲结果。
数据集
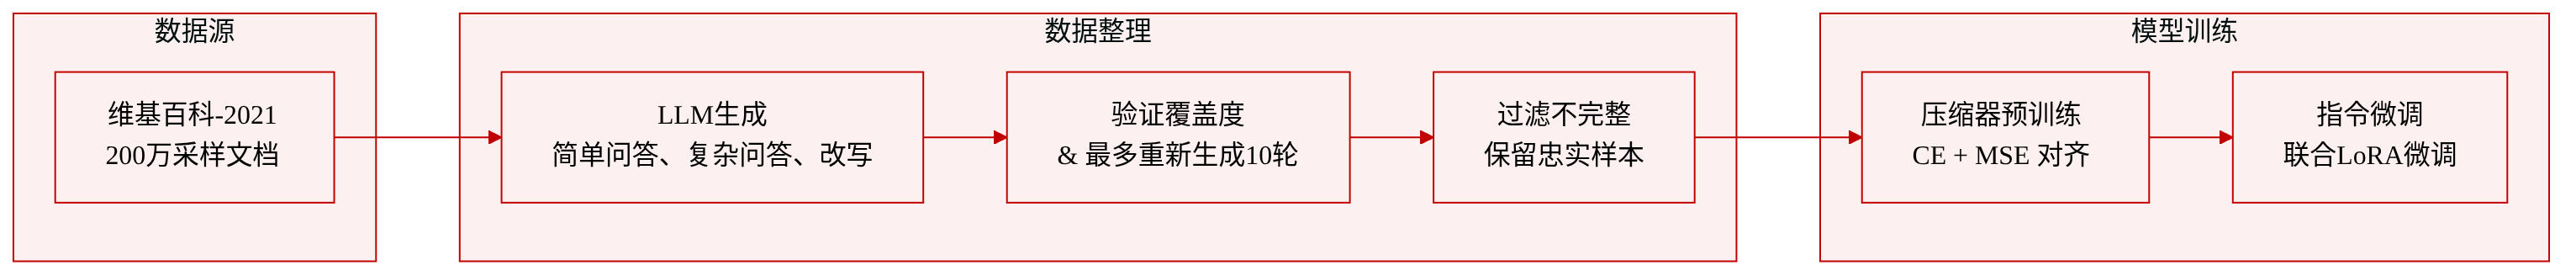
为了进行显著信息压缩器的预训练,作者构建了一个合成数据集,旨在通过问答和改写显式暴露文档的语义核心。构建流程如下:
- 源数据:从 Wikipedia-2021 语料库中随机采样的 200 万个文档。
- 监督信号生成:使用本地部署的 LLM(Qwen-32B)为每个文档生成三种互补的监督信号:
- 简单 QA 对:每个问题针对单个原子事实,促进细粒度的事实保留。通过仅提取先前的未涵盖的事实来避免冗余。
- 复杂 QA 对:每对整合多个事实以促进关系推理,显式连接之前无关的信息以增加覆盖范围。
- 改写:表面结构改变但语义保留,展示相同内容的更紧凑表达。
- 验证与再生成:对于每个文档,生成的 QA 对和改写由本地 LLM 检查事实一致性和信息覆盖度。如果检测到缺失内容,LLM 会审查原始文本和现有对以生成额外的问题来覆盖未涵盖的事实。此迭代过程最多运行 10 轮,仍未通过覆盖标准的样本将被丢弃。此过滤确保训练集中仅保留完全覆盖且事实忠实的样本。
作者随后在预训练和指令微调阶段使用此数据集:
- 压缩器预训练:模型接收文档并附加可学习的 memory tokens,仅压缩器的 LoRA 适配器处于活动状态。memory tokens 的隐藏状态形成压缩表示。训练使用交叉熵损失用于答案生成(以 QA 或改写作为指令),加上一个均方误差项,将文档 token 的平均隐藏状态与 memory tokens 的平均隐藏状态对齐,保持压缩潜在空间对原始文本的忠实性。
- 指令微调:为了使预训练的压缩器适应下游 QA,并获得能够处理连续文档表示的答案生成器,作者可选地联合微调压缩器和生成器的 LoRA 适配器。使用下游训练数据集,其中检索到的文档与任务指令配对作为输入,输出是由教师模型基于相同文档和指令生成的标准响应。
方法
作者提出了一个两阶段框架,首先将文档蒸馏为紧凑的语义表示,然后联合优化检索和生成。初始阶段,显著信息压缩器预训练(SCP)专注于学习信息丰富的文档表示。为了防止模型在琐碎的 token 级重建上浪费能力,作者构建了一个合成数据集,通过问答对和改写文档显式暴露显著信息。该流程包括迭代验证和再生成以确保完整的事实覆盖。基于这些精心整理的数据,训练压缩框架。参见框架图
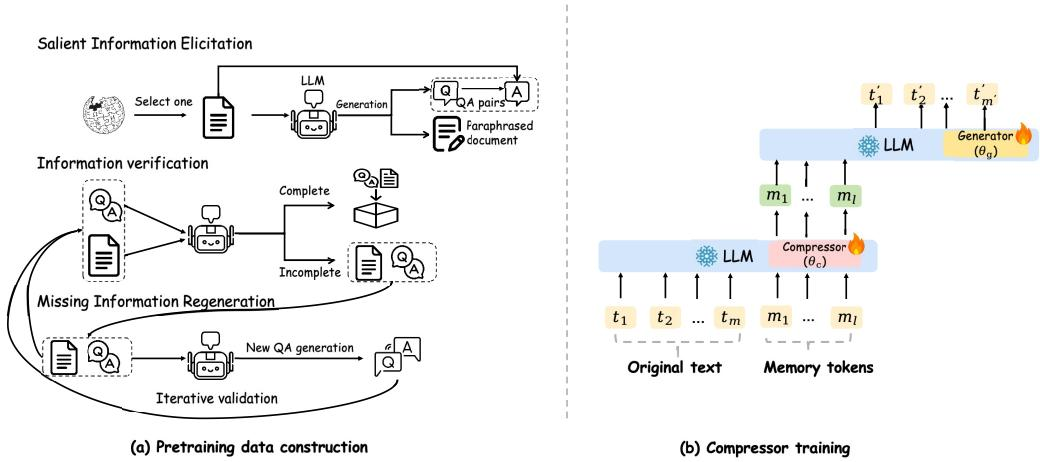
底层架构使用一个共享的基础模型,配备不同的低秩适配(LoRA)适配器以实现模块化控制。在压缩过程中,压缩器适配器 θc 处理原始文档 token di={t1,…,tm},并附加 l 个可学习的 memory tokens (m1,…,ml)。这些 memory tokens 的最终层隐藏状态产生压缩表示:
Mi=LLMθc([t1,…,tm,m1,…,ml])[m+1:m+l]为了确保这个紧凑向量忠实捕获原始语义,训练目标结合了用于文本生成的交叉熵损失和均方误差对齐损失。该对齐损失最小化了原始文档 token 的平均隐藏状态与 memory tokens 的平均隐藏状态之间的距离,迫使压缩器在不漂移的情况下总结相同的语义空间:
LMSE=∣di∣1t∈di∑ht−l1j=1∑lhmj22压缩器预训练后,框架过渡到 CLaRa,该阶段将检索和生成统一在单个语言模型内,通过可微的检索模块实现。参见端到端训练架构
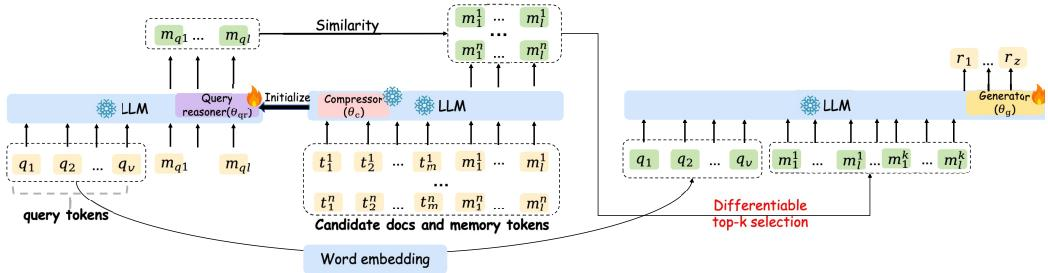
预训练的压缩器保持冻结,以允许高效的离线文档编码为稠密嵌入。查询推理器(由压缩器初始化的 LoRA 适配器实现)学习使用相同数量的 memory tokens 将查询编码到相同的表示空间。此设计使查询推理器能够通过 next-token 预测训练预见相关文档内容。检索通过计算查询嵌入与冻结文档嵌入之间的余弦相似度来执行:
si=cos(q,Mi),i=1,…,D然后,将 top-k 个最相关的文档嵌入与查询拼接,传递给生成器适配器 θg,它生成最终答案。查询推理器和生成器通过统一的语言建模损失同时更新,使得检索器能够直接从生成目标接收隐式监督,而无需显式的相关性标签。
为了弥合 top-k 选择的离散性与连续梯度流之间的鸿沟,作者采用直通(ST)估计。该技术在训练中充当软透镜,在前向传播中保留离散的检索行为,同时通过 softmax 加权的软选择实现平滑的梯度反向传播。通过将 ST 估计器应用于候选嵌入来计算聚合的 top-k 文档表示。这种梯度耦合确保检索器接收互补信号:它被鼓励对能够最大化生成似然的文档进行排序,同时从生成器接收表示级别的反馈。为了验证查询推理器的内部推理能力,作者应用 logit lens 分析将记忆嵌入投影到输出头。参见 token 解码分析
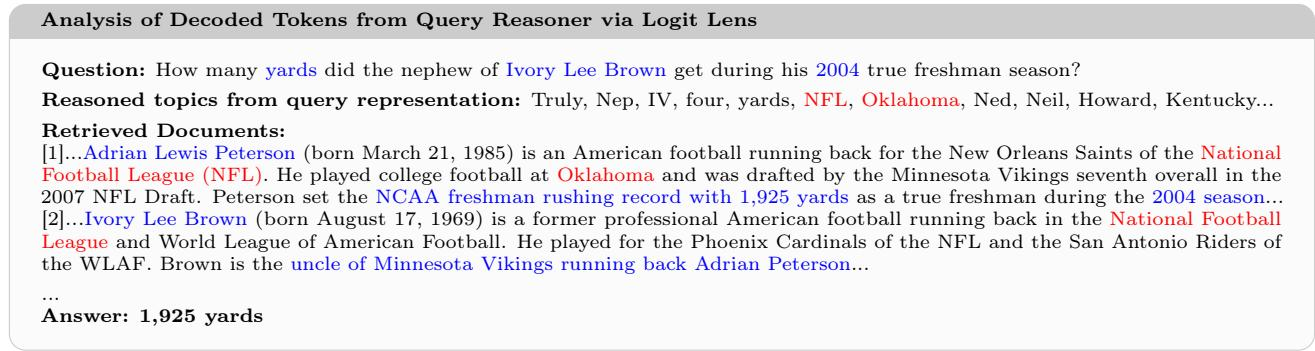
该分析表明,查询推理器隐式解码了与推理相关的知识和证据,这些内容可能未在问题中显式出现,展示了有效的语义对齐和相比基线系统增强的检索准确性。
实验
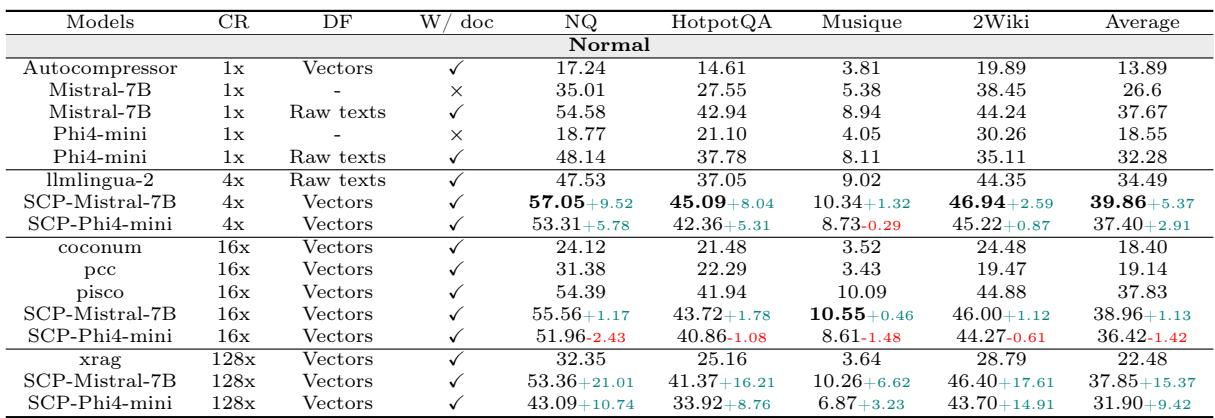
该研究在四个问答基准上验证了联合优化的压缩、重排序和生成框架,表明软压缩能够保留关键推理同时过滤噪声,通常优于原始文本基线。联合训练在多种压缩比下保持稳健,并在正常设置下受益于指令微调初始化,而在 oracle 条件下检索质量显著提升。值得注意的是,弱监督的检索器优于完全监督的基线,消融实验确认了多样化的预训练目标和 MSE 对齐损失增强了语义一致性和整体性能。
所提出的文档压缩器在问答数据集上一致优于软压缩和硬压缩基线,在去除检索噪声时增益更大。它还优于未压缩的文本基线,表明训练良好的软压缩能够保留推理关键信息并过滤无关内容。在极端压缩比下性能下降,但在正常检索条件下下降幅度适中。在 Normal 和 Oracle 设置下,与最佳软基线相比平均增益分别为 1.13% 和 5.35%。在 Mistral-7B 和 Phi-4-min 上分别超过未压缩文本基线 2.36% 和 6.36%。超过 32 倍的极端压缩更显著地损害 Oracle 性能,但在 Normal 设置下影响适中。
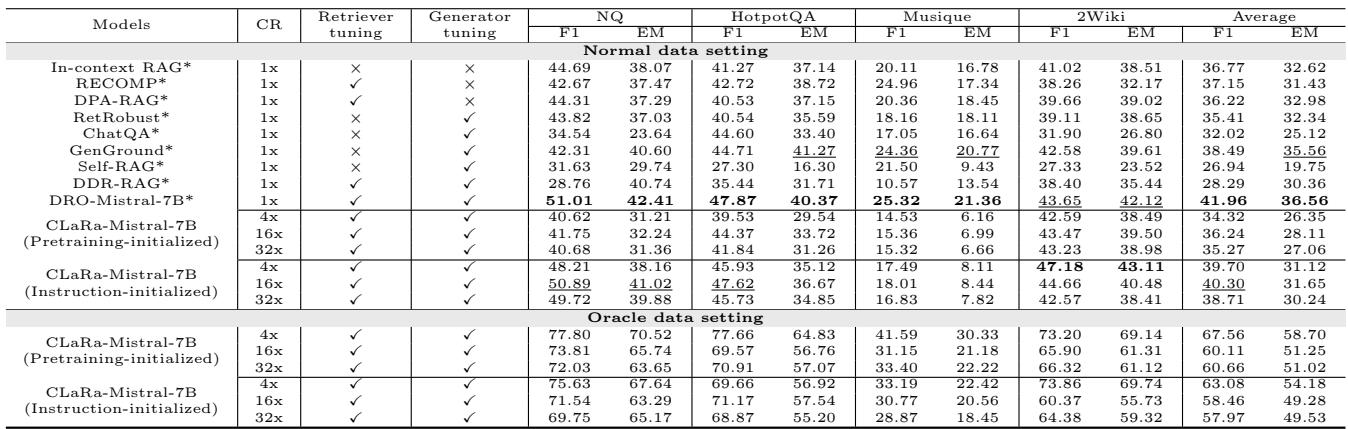
所提出的方法在上下文压缩 16 倍的同时,实现了与强基线相当的端到端 QA 性能。在噪声检索下,性能在多种压缩比下保持稳定,甚至在一些数据集上超过基于文本的基线,而精确检索显著提升了分数。当检索噪声大时,初始化选择更为重要,但随着检索质量的提高其影响减弱。在 16 倍压缩下,该方法在正常检索下的 NQ 和 2Wiki F1 分数上超过基于文本的基线。在 oracle 设置中提供带注释的正例将 F1 提升到 NQ 和 HotpotQA 的 75% 以上。在噪声检索下,指令微调初始化比预训练初始化产生更强的结果,但差距在检索可靠时缩小。
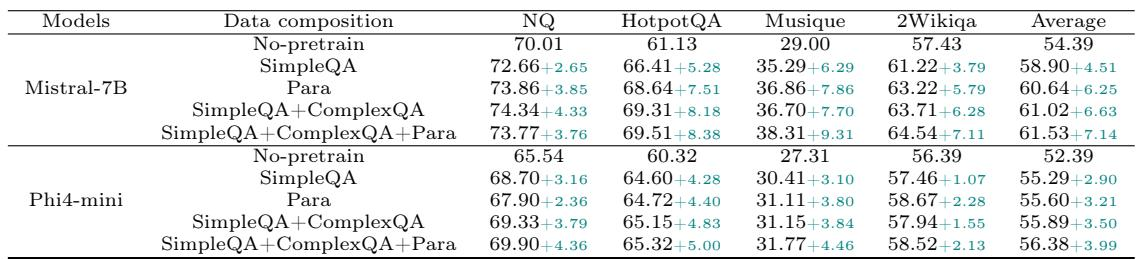
在 oracle 检索和 32 倍压缩比下,基于 QA 风格和改写目标的预训练一致改善了指令微调性能,其中组合和多样化的目标获得了最大的增益。仅使用改写已经提供了显著的改进,添加复杂 QA 类型进一步提升了结果,特别是对于更大的模型。任何预训练数据组合都优于无预训练基线,这证实了事实推理和改写重写都能丰富压缩表示。组合所有目标类型(简单 QA、复杂 QA 和改写)产生了最高的平均增益,尤其是在多跳和开放域基准上。仅改写的预训练在基线上提供了强提升,有时可媲美或超过添加简单 QA 的效果,这表明多样化的语义覆盖具有价值。
该表显示了在四个数据集上,在两种压缩比下有无 MSE 损失的指令微调性能。添加 MSE 损失产生混合效应:在两种压缩比下都改善了 Musique 和 2Wikiqa 的分数,但降低了 NQ 的性能,有时还降低了 HotpotQA 的性能。总体变化幅度适中,通常约在 1.5 分以内。MSE 损失在 32 倍和 128 倍压缩下一致改善了 Musique 和 2Wikiqa,增益高达 1.56 分。在 32 倍和 128 倍压缩下添加 MSE 损失降低了 NQ 性能,最大降幅在 128 倍时为 1.28 分。HotpotQA 在 32 倍时略有增益,但在 128 倍时有轻微损失,表明效果在不同配置下并不一致。
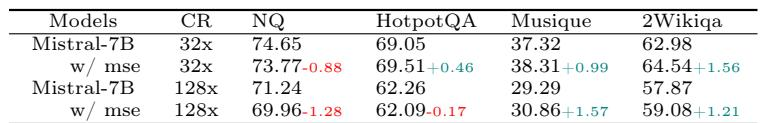
所提出的文档压缩器在 QA 任务上一致优于软压缩和硬压缩基线,甚至优于未压缩文本,在去除检索噪声时增益更大,但极端压缩比会导致适度退化。初始化选择在噪声检索下影响更大,而结合 QA 和改写目标的预训练改善了指令微调,特别是对于更大的模型。添加 MSE 损失产生混合效应,在一些数据集上提升性能而在其他数据集上降低性能,其影响随压缩比和配置而变化。