Command Palette
Search for a command to run...
CancerGUIDE:基于内部分歧估计的癌症指南理解
CancerGUIDE:基于内部分歧估计的癌症指南理解
CancerGUIDE Synthetic Patient Data 癌症指南合成患者数据
摘要
国家综合癌症网络(NCCN)为癌症治疗提供基于证据的指南。将复杂的患者临床表现转化为符合指南的治疗建议耗时费力,需要专业知识,且容易出错。大语言模型(LLM)能力的进步有望减少生成治疗建议所需的时间并提高准确性。我们提出了一种基于 LLM 智能体的方法,用于自动生成非小细胞肺癌(NSCLC)患者的指南一致治疗轨迹。我们的贡献有三方面。首先,我们构建了一个包含 121 例 NSCLC 患者的新型纵向数据集,涵盖临床就诊记录、诊断结果和病史,并由经认证的肿瘤学家根据相应的 NCCN 指南轨迹进行了专业标注。其次,我们证明了现有的 LLM 具备领域特定知识,能够为模型开发和评估生成高质量的代理基准,与专家标注的基准实现了强相关性(Spearman 系数 r = 0.88,RMSE = 0.08)。第三,我们开发了一种混合方法,将昂贵的人工标注与模型一致性信息相结合,构建了预测患者相关指南的智能体框架,以及一个元分类器,用于验证预测准确性并提供校准后的置信度评分用于治疗推荐(AUROC=0.804)。校准后的置信度评分是传达输出准确性、定制性能权衡以及支持法规遵从的关键能力。这项工作为基于 LLM 的临床可行指南依从系统建立了框架,该系统在降低标注成本的同时平衡了准确性、可解释性和法规要求,为自动化临床决策支持提供了一条可扩展的路径。
一句话总结
微软研究院、斯坦福大学及合作团队提出 CancerGUIDE,一种 LLM agent 框架,通过包含 121 例专家标注病例的数据集以及融合标注与模型一致性的混合方法,为非小细胞肺癌患者生成符合 NCCN 指南的治疗路径,实现校准后的置信度验证(AUROC=0.804),并与专家基准呈现强相关性(Spearman 系数 r=0.88,RMSE=0.08),在准确性、可解释性和监管合规性之间取得平衡,为可扩展的临床决策支持提供支撑。
核心贡献
- 构建了一个包含 121 例非小细胞肺癌患者病例的纵向数据集,涵盖临床就诊记录、诊断结果和病史,每条病例均由委员会认证的肿瘤学家标注 NCCN 指南路径,用于指南推荐系统的训练与评估。
- 证明基于一致性的合成监督信号可从现有 LLM 生成与专家判断高度接近的代理基准,与专家标注基准的 Spearman 相关系数达 0.88,RMSE 为 0.08,同时避免大规模人工标注成本。
- 开发了一种混合 agent 框架,结合元分类器预测患者相关的适用指南,并以校准后的置信度分数验证推荐准确性,AUROC 达 0.804,支持基于 ROC 的误差权衡优化及监管合规性。
引言
癌症治疗规划要求肿瘤学家将复杂的患者病史与频繁更新的临床指南(如美国国家综合癌症网络(NCCN)指南)进行整合。尽管这些循证指南有助于促进一致且高质量的诊疗,但对其进行查阅既耗时又容易出错,导致依从性不稳定,尤其在资源受限的环境中。大语言模型(LLM)为自动化生成符合指南的治疗推荐提供了可能,但在临床决策支持中部署这些模型需要进行严格的验证。FDA 等监管机构建议将 ROC 曲线分析作为性能评估的一部分,而生成式模型输出缺乏语义对齐的置信度分数,难以生成此类分析结果。
此前的评估工作从根本上受限于专家标注数据集的稀缺性,因为获取复杂临床推理的高质量金标准需要大量专家投入。合成数据生成往往无法捕捉临床复杂性,并存在分布偏移问题;而将实际患者治疗方案作为金标准也存在问题,因为真实世界的决策包含了指南之外的因素,如患者偏好、药物可及性和机构规程。这些局限性使得从业者缺乏可扩展的方法来在高风险场景部署前评估模型可靠性。
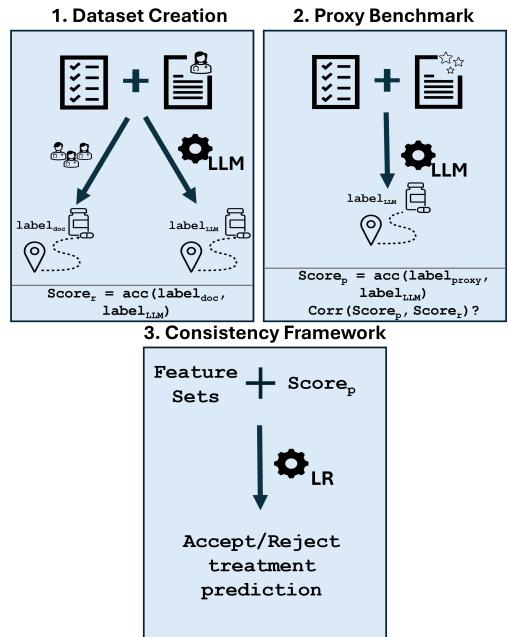
作者通过两种互补的方法来应对这一瓶颈。首先,他们基于六种代理基准生成方法评估模型,包括两个合成数据集和四个基于真实临床笔记并带有一致性衍生标签的数据集,从而在没有金标准标注的情况下实现模型选择。其次,他们证明自一致性和跨模型一致性可作为专家标注病例上准确性的可靠预测指标。为验证这些方法,他们构建了首个非小细胞肺癌 NCCN 指南依从性基准,邀请 13 位肿瘤学家标注 121 条完整的患者路径。其代理基准与人工判断高度相关(Spearman r = 0.88,RMSE = 0.08),其元分类器框架通过整合弱监督信号来分类预测正确性,在多个模型上实现平均 AUROC 为 0.804,同时生成校准后的置信度分数,支持 ROC 分析和监管合规性。
数据集
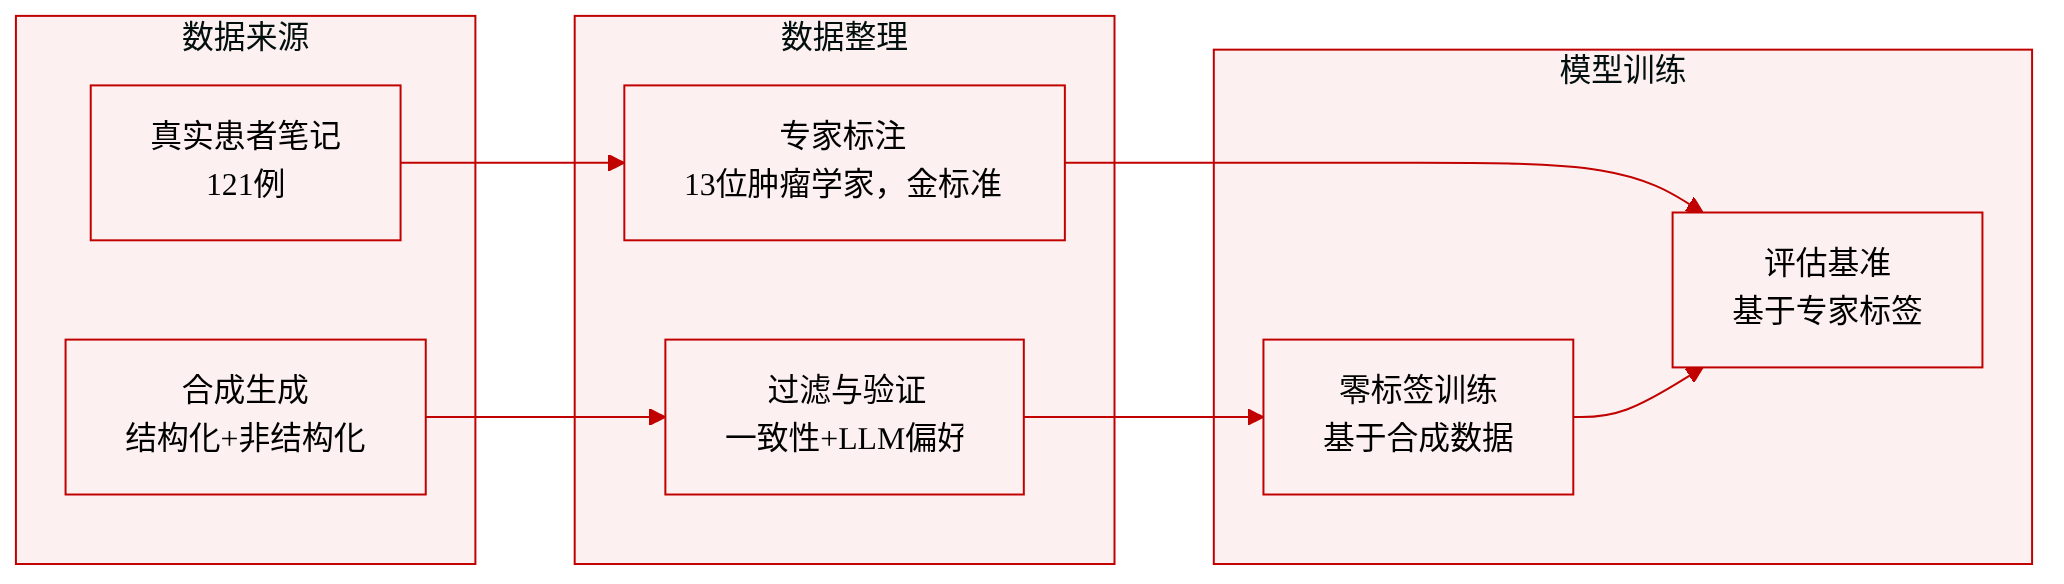
作者构建了两个互补的数据集来研究符合指南的治疗预测:一个用于评估的专家标注基准和一个用于可扩展零标签训练与验证的合成数据集。
专家标注数据集
- 包含 121 条由 13 位肿瘤学家标注的真实患者笔记,平均每条笔记标注时间为 46.5 分钟,美国委员会认证临床医生每小时成本为 500 美元。
- 笔记平均长度为 54,755 个字符,包含 82 条不同的 NCCN 指南路径和 48 个不同的最终治疗推荐。
- 为保障可靠性,11 个示例进行了双重标注,平均治疗匹配率为 0.636,路径重叠得分为 0.692;分歧分析详见附录。
- 该数据集作为评估八个前沿 LLM(GPT-5、GPT-4.1、o3、o4-mini、DeepSeek-R1、LLaMA-3.3-70B-Instruct)的金标准,默认温度为 1.0,GPT-5 采用不同推理强度(极低、中等、高)。
- 报告两个临床相关指标:路径重叠(与标注指南路径的结构一致性)和治疗匹配(推荐治疗节点是否与专家标注一致)。
合成监督数据集
- 为支持专家标签不可用或成本过高的零标签场景而生成。
- 该流程生成高保真合成患者笔记,并配以生成的指南路径,采用两种策略:
- 结构化生成:以目标路径和完整临床指南为条件填充空的结构化字段,通过重建隐含路径并丢弃不匹配的案例进行一致性检查,然后从结构化数据、目标路径、指南和真实临床笔记示例生成非结构化笔记。
- 非结构化生成:跳过结构化字段,直接从目标路径、指南和临床笔记示例生成合成笔记。
- 合成数据使用 GPT-4.1 生成,但用于评估 GPT-4.1 的案例除外,这些案例由 GPT-5 在极低推理条件下生成。
- 过滤步骤选择有效对:生成笔记后,LLM 从中预测路径。若预测与目标路径匹配,则该对通过。否则,LLM 以位置无关的格式在预测路径与目标路径之间进行选择,仅保留选择目标路径的案例。
- 最终合成数据集包含生成模型能够从笔记中正确重建目标路径,或在与其自身预测并列时能够选出目标路径的对,覆盖直接生成失败但验证仍可行的场景。
方法
方法
作者将符合指南的治疗预测形式化为结构化预测问题。给定患者笔记 x∈X,目标是预测符合指南的路径 y∈Y,其中 Y 是决策图空间,节点代表临床决策,终端节点对应治疗方案。LLM f:X→Y 产生预测 y^=f(x)。由于金标准对 (x,y) 难以大规模获取,作者避免直接监督,而是引入一个基于代理信号的两层评估框架。
为奠定形式化基础,作者利用 o3 的视觉能力提取 NCCN 非小细胞肺癌指南决策树,并整理专家标注数据集,由肿瘤学家将患者笔记映射到决策树上,记录节点序列并评估指南依从性。由于直接监督无法随 X 的增长而扩展,作者定义了两类代理评估。第一类使用合成输入 (x^,y^),其中 x^ 以指南路径为条件生成,可在扰动或患者数据替代表示下对模型可靠性进行受控评估。第二类使用真实输入 (x,y^),其中模型预测被多次采样,仅当达到最低自一致性阈值时才保留该对。
这些代理评估为代理评估器 g 提供输入,g 用于预测 y^ 是否符合指南。作者定义了特征映射
ϕ:(X,Y,f)→Rd提取的信号包括模型多次rollout的自一致性、模型间一致性以及与代理基准的对齐程度。该评估器训练为二元分类器:
g(ϕ(x,y^,f))≈1{y^=y},目标是最小化期望分类损失
gminE(x,y)∼D[L(g(ϕ(x,y^,f)),1{y^=y})],其中 D 是患者分布,L 是标准损失。该公式允许在零标签设置下通过利用模型一致性、自一致性和基准衍生特征进行元分类来评估 f。
评估指标
作者采用两个互补指标。路径重叠衡量预测路径中与比较路径重复的节点比例,捕捉决策序列的一致性,反映模型在最终治疗不正确时仍能导航指南依从决策过程的能力。治疗匹配是二元分数,表示最终预测治疗在可用时是否与金标准匹配;在没有金标准的设置中,该指标计算为多次预测中最终治疗重复的比例。这些指标提供互补视角:路径重叠强调过程保真度和决策支持潜力,而治疗匹配捕捉结果正确性。为确保分数确定性,路径相似性评估不使用 LLM 评判器,因为其随机性会混淆直接模型比较。
零标签基准生成
为近似用于评估的 (x,y) 对,作者提出两种互补方法,共六种代理基准方法。
合成监督。 作者生成与指南路径 y^ 配对的高保真合成患者笔记 x^,采用多步骤流程将笔记生成与标签选择分离,在保留真实临床案例的同时过滤错误标签。x^ 使用两种生成策略。结构化生成以生成的路径和完整临床指南为条件填充空的结构化字段,通过重建隐含路径并丢弃不匹配案例进行一致性检查,然后从结构化数据、目标路径、指南和真实临床笔记示例生成非结构化笔记。非结构化生成跳过结构化字段,直接从目标路径、指南和临床笔记示例生成合成笔记。合成数据集使用 GPT-4.1 生成,但用于评估 GPT-4.1 本身的数据集除外,这些由 GPT-5 在极低推理条件下生成。
x^ 生成后,y^ 通过让 LLM 从 x^ 生成路径获得。若预测与目标路径匹配,则该对直接通过。否则,LLM 以位置无关的格式在预测路径与目标路径之间选择,仅保留选择目标路径的案例。这覆盖了直接生成失败但验证仍可行的示例,利用了生成正确路径比识别正确路径更难的不对称性。
基于一致性的伪标签。 作者从两个来源推导伪标签:自一致性(同一模型重复预测之间的一致性)和跨模型一致性(不同模型之间的一致性)。对每个来源,他们根据一致性是通过路径重叠还是治疗匹配来衡量定义两个基准,共得到四个基准。对于自一致性,从模型 m 对每条笔记 x 采样 k 个独立预测。沿路径重叠和治疗匹配评估一致性,保留目标指标上一致性高于阈值 δ=0.9 的笔记,不一致案例计为 0。性能计算为保留子集上的准确率,不一致答案视为错误。对于跨模型一致性,当两个或更多模型在 k 次独立采样后收敛到相同的精确路径时分配伪标签。不一致案例被排除而非惩罚,所有模型在生成的代理基准上进行评估。
最终治疗准确性预测
作者训练一个元分类器,利用源自自一致性指标(k 次 rollout 的路径重叠和治疗匹配)、跨模型一致性(产生相同路径的模型比例)以及代理基准分数的特征来预测生成最终治疗预测的准确性。此外,他们通过无监督方法证明了无标签评估:对自一致性和跨模型一致性特征进行聚类,可自然地将高置信度正确预测与低置信度错误预测分离。在错误识别方面,他们对每个模型在每条患者病例上的 k 次 rollout 不一致性进行制表,利用一致性信号在无需人工标签的情况下检测潜在错误。
实验
实验验证了符合指南的治疗预测,使用路径重叠(过程保真度)和治疗匹配(结果准确性)两个互补指标。作者引入六种零标签代理基准,结合合成监督和基于一致性的伪标签,发现非结构化合成生成的误差更低,按治疗匹配进行阈值化优于路径重叠,而跨模型聚合会增加噪声。在由 13 位肿瘤学家标注的 121 条笔记数据集上评估了前沿 LLM,利用自一致性信号的元分类器以 0.804 的 AUROC 预测治疗准确性,可跨模型和跨患者泛化,并在无任何人工标签的情况下检测出 40% 的错误,证明仅靠一致性模式即可实现可靠的错误检测。
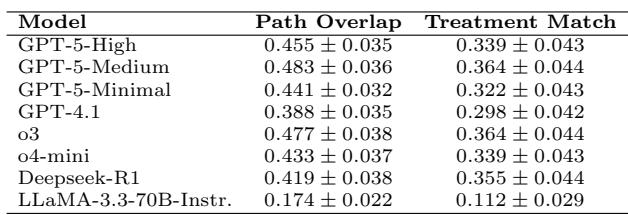
在专家标注的肿瘤治疗基准上,所有评估模型均表现出中等程度的结构路径重叠,但精确治疗匹配率较低,最佳性能约为指南路径的一半。采用中等推理强度的 GPT-5 在路径重叠上领先,并与 o3 并列治疗匹配最佳,而 GPT-4.1 在两个指标上均落后。将推理强度从中等提高到较高会略微降低性能。采用中等推理强度的 GPT-5 达到最高路径重叠,并与 o3 并列最佳治疗匹配。GPT-4.1 在路径重叠和治疗匹配上均表现最弱。将 GPT-5 的推理强度从极低提高到中等可提升得分,但使用较高强度时结果略低于中等。
元分类器利用基于一致性的特征以 0.804 的 AUROC 预测治疗推荐准确性,其中跨模型一致性信号优于代理基准特征。即使没有跨模型信息,仅凭自一致性也能提供强分类能力,且无监督一致性信号无需标注数据即可检测出相当比例的错误。包含跨模型一致性的特征集优于依赖合成基准的特征集,代理基准性能带来的增益微乎其微。仅自一致性特征(无跨模型信息)仍能产生较高的 AUROC,表明其是强独立信号。基于一致性的无监督错误检测 F1 为 0.666,而有监督分类为 0.702,且无需人工标签即可检测出全部模型错误的 40.42%。
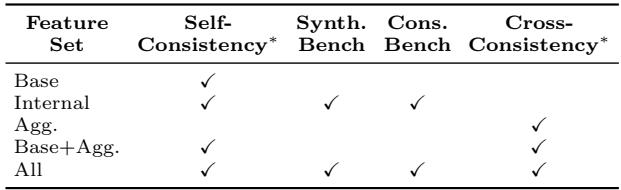
在肿瘤治疗基准上,所有模型仅达到中等程度的结构化指南重叠和较低的精确治疗匹配,中等推理强度的 GPT-5 领先,GPT-4.1 表现最差;中等推理强度优于极低和较高推理强度。用于治疗推荐准确性的独立元分类器表明,基于一致性的特征(尤其是跨模型一致性)是强预测因子,仅自一致性即可提供稳健性能,无监督错误检测无需标签即可捕捉大量错误。