Command Palette
Search for a command to run...
GenSelect:一种生成式最优选择方法
GenSelect:一种生成式最优选择方法
Shubham Toshniwal Ivan Sorokin Aleksander Ficek Ivan Moshkov Igor Gitman
Nemotron-SpecializedDomains-Finance 专业领域金融数据集
摘要
带有并行采样的生成式奖励模型已实现推理任务中有效的测试时扩展。现有方法采用对单个解决方案的点式评分或成对比较。然而,点式方法未能充分利用大语言模型的比较能力,而成对方法在较大采样预算下扩展效率低下。我们提出 GenSelect,其中大语言模型通过长推理在 N 个候选项中选择最佳解决方案。该方法利用了大语言模型的比较优势,同时能在并行采样预算下高效扩展。在数学推理方面,我们证明了推理模型(如 QwQ 和 DeepSeek-R1-0528)擅长 GenSelect,通过简单提示即可优于现有评分方法。
一句话总结
作者提出的 GenSelect 提出了一种生成式奖励模型,其中 LLM 通过长推理在 N 个候选项中选择最佳解决方案,利用比较优势并实现高效的并行扩展,同时证明诸如 QwQ 和 DeepSeek-R1-0528 等推理模型在简单提示下,在数学推理任务上的表现优于现有的逐点(pointwise)和成对(pairwise)评分方法。
核心贡献
- GenSelect 是一种基于锦标赛的 Best-of-N 选择方法,利用具有长推理能力的大语言模型在 N 个候选项中选出最佳方案,在兼顾比较评估优势的同时,高效扩展并行采样预算。
- 该方法采用 N 元淘汰赛制,既尊重上下文窗口限制,又相较穷举成对比较大幅降低计算开销,从而解决更大采样预算下的实际可扩展性问题。
- 在数学推理实验中,GenSelect 始终优于包括多数投票、判别式奖励模型和生成式奖励模型在内的基线;QwQ 和 DeepSeek-R1-0528 等推理模型在简单提示下表现突出,且这些增益在不同锦标赛配置下保持稳健。
引言
测试时扩展(test-time scaling)通过顺序推理和并行采样提升大语言模型在推理任务上的表现,其核心任务是从众多候选中选出最佳回答。以往工作多采用基于规则或判别式奖励模型,而近期生成式奖励模型(GenRMs)通过对候选项进行推理展现出潜力。然而,GenRM 通常以逐点或成对模式工作。逐点评估受限于 LLM 的验证能力,而成对比较在大规模候选中计算代价过高,需要 O(N2) 次穷举比较或 O(N) 次淘汰赛,后者还会增加延迟。为克服这些挑战,作者提出 GenSelect,直接在所有候选方案之间进行 N 元比较,将 GenRM 从二元判断推广到 N 元判断。对于更大的采样预算,他们进一步引入符合上下文窗口限制的 N 元淘汰赛。他们使用 QwQ 和 DeepSeek-R1 的实验表明,GenSelect 在竞赛级数学基准上优于现有基线,并在不同推理设置下保持稳定,从而能在不损失性能的情况下实现更高的并行采样预算扩展。
数据集
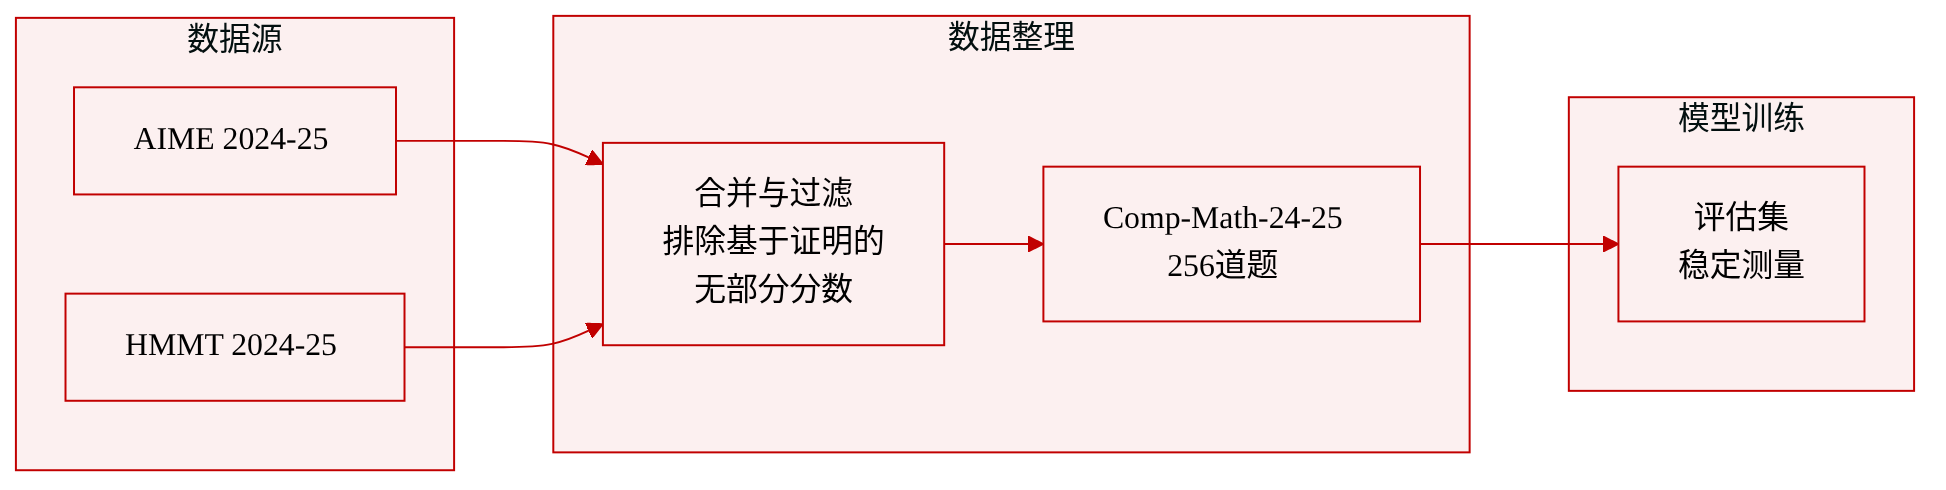
作者构建了一个名为 Comp-Math-24-25 的评估基准,以解决 AIME 竞赛(仅有 30 题)的高方差问题。该数据集由两个来源的问题组合而成:
- AIME(美国数学邀请赛) 和 HMMT(哈佛-麻省理工数学锦标赛) 中 2024 年和 2025 年的题目。
- 筛选规则: 排除基于证明的问题以及按估算正确率给予部分分数的题目。
- 规模: 最终基准共包含 256 道题目。
该基准在论文的实验设置中用作数学推理任务的评估集,相比单独使用 AIME 能提供更统计稳定的度量。
方法
作者建立了一个生成式奖励模型(GenRM)基线,通过零样本提示推理模型来评估解决的正确性。该方法要求模型系统性地分析数学问题及其提出的解决方案,以确定其数学上是否成立。验证过程分为三个主要评估标准:数学准确性检查以验证计算和公式,逻辑推理分析以确保从问题陈述到解答的推理连贯,以及完整性评估以处理边界情况。
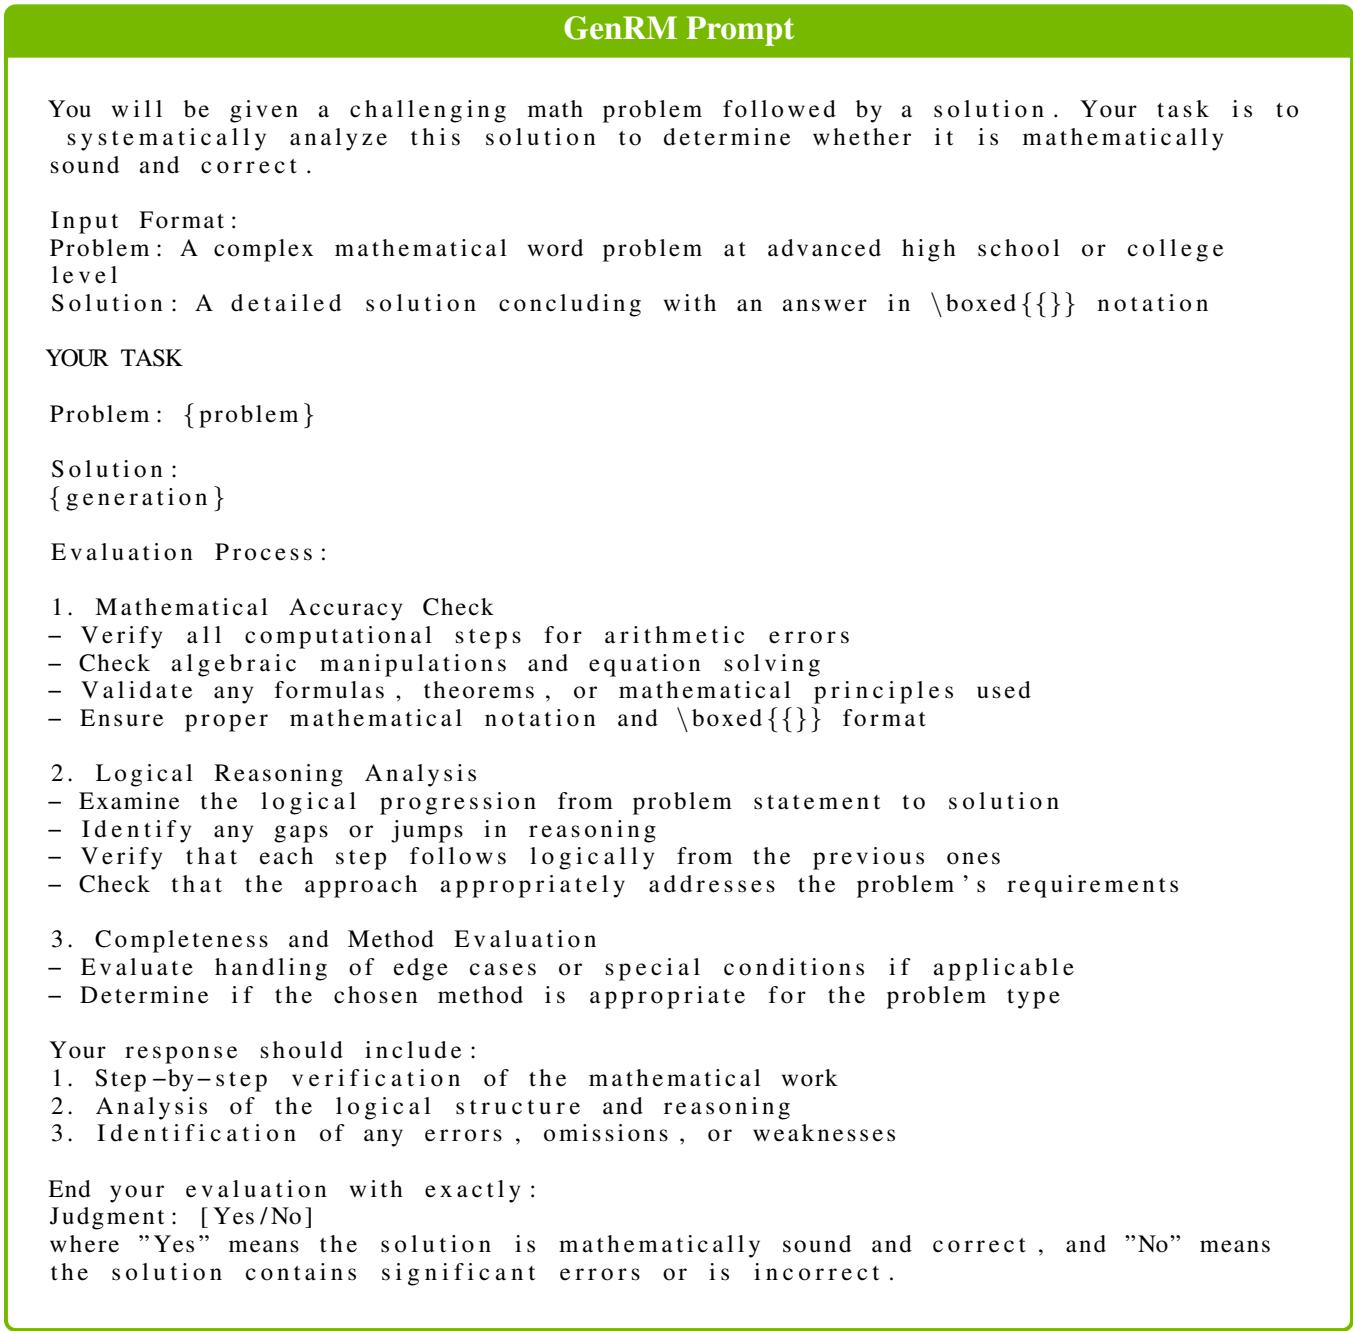
模型被要求输出逐步的数学工作验证、逻辑结构分析,并指出任何错误。评估最终以“是”或“否”的二元判断结束,其中“是”表示正确解答。这种设置允许通过多次采样验证并聚合最终答案,从而实现直接的测试时扩展。
与 GenRM 的逐个评分不同,所提出的 GenSelect 方法通过同时评估所有候选方案来解决 Best-of-N(BoN)选择任务。GenSelect 不是给单个方案打分或进行顺序成对比较,而是利用大语言模型执行 N 元比较,直接从全部 N 个候选中识别最佳回答。
为了克服推理模型固有的上下文窗口限制,作者采用了 N 元淘汰赛策略。该方法通过将候选分组到各轮次中,将评估扩展到更大的采样预算。例如,在评估 64 个候选方案时,16 元比较锦标赛只需两轮和总共五次比较,而二元锦标赛则需要六轮顺序比较和 63 次比较。这种 N 元方法显著降低了计算开销和延迟,同时保持等价的理论复杂度,使系统能够在不断性能的情况下获得效率提升。
实验
在 Comp-Math-24-25 基准上的实验(该基准结合 AIME 和 HMMT 问题以减少方差)表明,所提出的 GenSelect 方法(利用 LLM 比较候选方案)大幅优于多数投票和判别式奖励模型,并且重复使用并与多数投票结合时会获得进一步提升。GenSelect 在不同候选集大小下保持稳定,表明可以增大 N 而不会损失性能。关于计算分配,较强的模型在低预算下倾向于仅生成(generation-only),但在较大预算下则受益于 GenSelect;而较弱的模型在所有预算下均从 GenSelect 中获益。两者在多数投票基线上均显示出显著的总体改进,尤其在 HMMT 切分上。
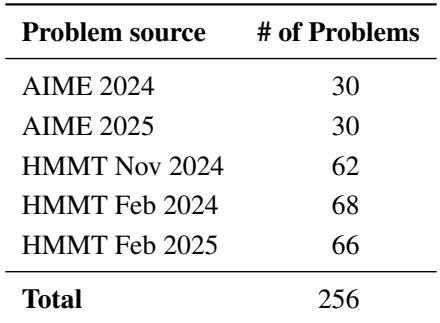
Comp-Math-24-25 数据集通过组合 AIME 和 HMMT 的比赛题目(2024 和 2025 年)构建,共 256 道题目。它刻意排除了基于证明的题目和部分评分题目,专注于可作答的数学问题。数据来源共五处,其中 HMMT 贡献了大部分题目。数据集合并了 2024 和 2025 年的 AIME 和 HMMT 题目,HMMT 占比更大。排除了基于证明和部分评分的题目,最终得到 256 道。各来源题目数量不同,其中 HMMT Feb 2024 贡献最多,AIME 各年贡献 30 道。
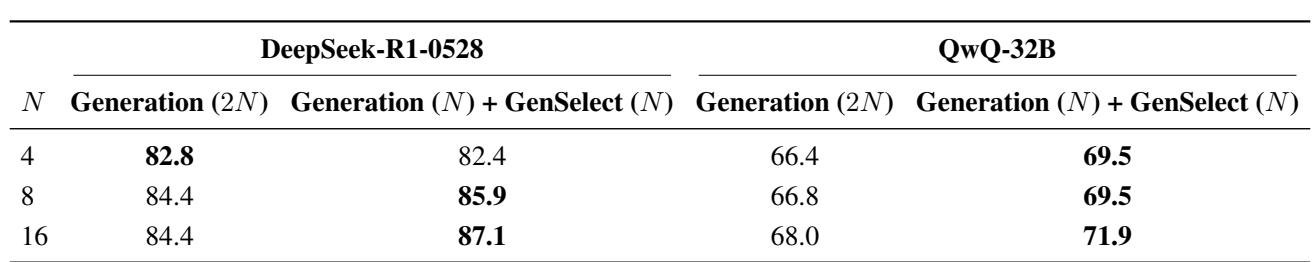
表格比较了两种推理计算分配策略(跨两个模型):将所有预算用于生成解答然后多数投票,与将预算平均分配给解答生成和 GenSelect 生成。对于较强的 DeepSeek 模型,在较低采样预算下优选仅生成,但预算较高时 GenSelect 变得更具优势。对于较弱的 QwQ 模型,GenSelect 在所有测试预算下均一致优于仅生成。DeepSeek 在采样预算较大时,使用 GenSelect 性能提升,且优势随预算增加而增大。QwQ 在每个测试预算水平上,使用 GenSelect 相较于仅生成都能获得更高准确率。将计算分配给 GenSelect 而非额外生成所带来的收益,在较弱的 QwQ 模型上更为显著。
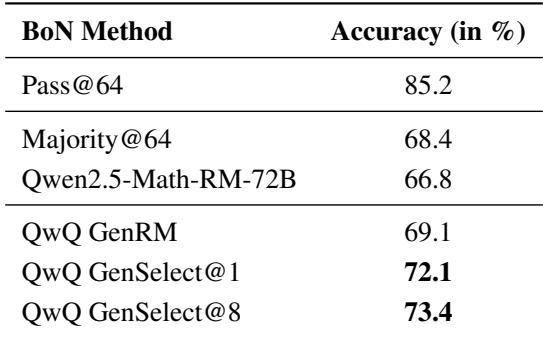
在 Comp-Math-24-25 基准上,通过比较评估(GenSelect)选择最佳解决方案,在 QwQ-32B 上优于多数投票和其他基于奖励模型的基线。增益大于逐个评分方案,重复选择流程还能进一步提高准确率。在与目标分布不同的数据上训练的判别式奖励模型得分低于多数投票,很可能是由于分布不匹配。使用 GenSelect 进行比较选择优于多数投票和逐个评分,并且重复选择过程并对结果应用多数投票可带来额外增益。
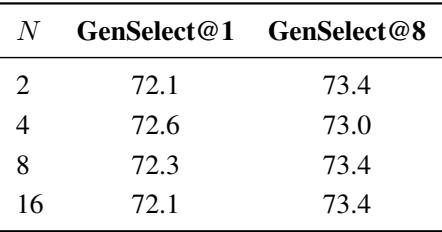
该表格评估了改变比较轮数(N)对 GenSelect 性能的影响。在 N 从 2 到 16 的范围内,无论是单次还是重复的 GenSelect 流程,准确率几乎保持不变。这意味着可以使用更大的 N 来加速选择过程而不牺牲质量。在不同 N 值下,GenSelect@1 准确率保持在 72.1 到 72.6 之间,变化极小。GenSelect@8 准确率范围为 73.0 到 73.4,且随着 N 增加保持稳定。更高的 N 会减少所需的比较轮数,从而在不降低性能的情况下实现更快的选择。
将 GenSelect 应用于 DeepSeek-R1-0528 和 QwQ-32B 后,所有基准切分上的准确率相比多数投票都有显著提升,其中 HMMT-24-25 集合上的相对增益最大。重复的 GenSelect 流程结合多数投票能带来一致改进,表明比较选择是适用于推理模型的有效验证策略。对于两个基础模型,GenSelect 在每个基准切分上都比多数投票有性能提升。对于 DeepSeek-R1-0528 和 QwQ-32B,GenSelect 带来的最大增益出现在 HMMT-24-25 子集上。使用 GenSelect 的 DeepSeek-R1-0528 总体准确率高于使用 GenSelect 的 QwQ-32B。
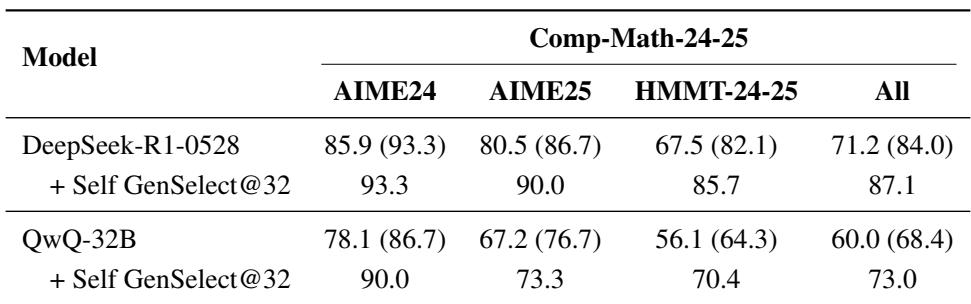
评估在 Comp-Math-24-25 数据集上进行,该数据集合并了 2024 和 2025 年的 AIME 和 HMMT 题目,共 256 道可作答问题。比较选择(GenSelect)在 DeepSeek-R1-0528 和 QwQ-32B 上,跨越所有基准切分,通常优于多数投票和逐个评分基线,其中 HMMT 子集上的相对增益最大;这种优势在较弱的 QwQ 模型上更为明显。增加比较轮数不会损害准确率,允许更快的选择,并且在较高采样预算下 GenSelect 对 DeepSeek 更加有利,而对 QwQ 则始终保持优越。