Command Palette
Search for a command to run...
AceReason-Nemotron:通过强化学习推进数学与代码推理
AceReason-Nemotron:通过强化学习推进数学与代码推理
Yang Chen Zhuolin Yang Zihan Liu Chankyu Lee Peng Xu Mohammad Shoeybi Bryan Catanzaro Wei Ping
摘要
尽管近年来大规模强化学习(RL)在推理方面取得了进展,但构建高性能推理模型的训练方案仍然难以捉摸。前沿模型(如 DeepSeek-R1)的关键实现细节,包括数据策展策略和强化学习训练方案,往往被省略。此外,近期研究表明,对于较小模型,蒸馏仍比强化学习更有效。在这项工作中,我们证明大规模强化学习能够显著增强强大、中小型模型的推理能力,取得超越最先进蒸馏模型的结果。我们通过大量消融实验系统研究了强化学习训练过程,并提出了一种简单而有效的方法:先仅在数学提示上训练,再仅在代码提示上训练。值得注意的是,我们发现仅数学强化学习不仅显著提升了强蒸馏模型在数学基准上的表现(例如,7B/14B 模型在 AIME 2025 上提升 +14.6%/+17.2%),还提升了代码推理任务的表现(例如,7B/14B 模型在 LiveCodeBench 上提升 +6.8%/+5.8%)。此外,延长仅代码强化学习的迭代次数进一步提高了代码基准性能,同时对数学结果的影响最小或没有影响。我们开发了一个稳健的数据策展流程,以收集具有高质量、可验证答案和测试用例的挑战性提示,从而在两个领域实现基于验证的强化学习。最后,我们确定了关键的实验见解,包括采用逐步增加响应长度的课程学习,以及在线策略参数更新的稳定效果。我们发现,强化学习不仅能激发预训练和监督微调(如蒸馏)期间获得的基础推理能力,还推动了模型推理能力的极限,使其能够解决以前无法解决的问题。我们在以下网址发布模型:https://huggingface.co/nvidia/AceReason-Nemotron-14B。
一句话总结
NVIDIA 研究人员证明,采用先纯数学、后纯代码的简单强化学习(RL)课程,能够显著增强紧凑型 7B 和 14B 模型的推理能力,在 AIME 2025 上取得 +14.6%/+17.2% 的提升,在 LiveCodeBench 上取得 +6.8%/+5.8% 的提升,超越基于蒸馏的基线方法,同时依托稳健的数据筛选和策略内(on-policy)参数更新来保证训练稳定性。
核心贡献
- 证明大规模强化学习能够显著增强强小型和中型监督微调模型的推理能力,在 AIME 2025 上分别实现 7B/14B 模型 +14.6%/+17.2% 的提升,超越最先进的基于蒸馏的方法。
- 提出一种简单的两阶段 RL 训练方案,先在纯数学提示上训练,再在纯代码提示上训练。纯数学 RL 还能提升代码推理性能(7B/14B 模型在 LiveCodeBench 上分别提升 +6.8%/+5.8%),随后的纯代码 RL 进一步提升了代码基准成绩,且对数学能力几乎没有影响。
- 构建了一套稳健的数据筛选流程,收集具有高质量可验证答案和测试用例的高难度提示,以支持基于验证的数学与代码 RL 训练,并识别出关键洞见,包括逐步延长响应长度的课程学习、用于训练稳定化的策略内参数更新,以及 RL 既能激发预训练和监督微调阶段获得的基础推理能力,也能扩展模型解决此前无法解决的问题的能力。
引言
作者回应了通过大规模强化学习(RL)构建推理模型日益增长的需求。自 OpenAI o1 发布及 DeepSeek-R1 开源以来,RL 驱动的推理引起了广泛关注,但原始 DeepSeek-R1 报告省略了数据筛选和 RL 训练方案的关键细节,使社区缺乏可复现的路径。此前的研究也得出结论,对于小型和中型模型,蒸馏优于 RL,并建议仅在最大规模系统(如 DeepSeek-V3-671B 或 Llama-3.1-Nemotron-Ultra-253B)上使用 RL。作者对这一假设提出挑战,证明大规模 RL 能够显著增强强小型和中型 SFT 模型(DeepSeek-R1-Qwen-Distilled-7B 和 14B),在 7B 规模上取得与基于蒸馏方法相当的结果,在 14B 规模上超越这些方法。他们的主要贡献包括:先进行纯数学 RL、再进行纯代码 RL,并观察到数学 RL 还能提升代码推理性能,而后续的代码 RL 不会损害数学能力;建立了一套系统化的数据筛选流程,用于可验证的数学问题和编码测试用例;详细的消融实验揭示了逐步延长响应长度的课程学习能提高训练效率,策略内更新能稳定 RL 过程,以及 RL 既能激发已有的推理能力,也能扩展模型解决此前无法解决的问题的能力。
数据集
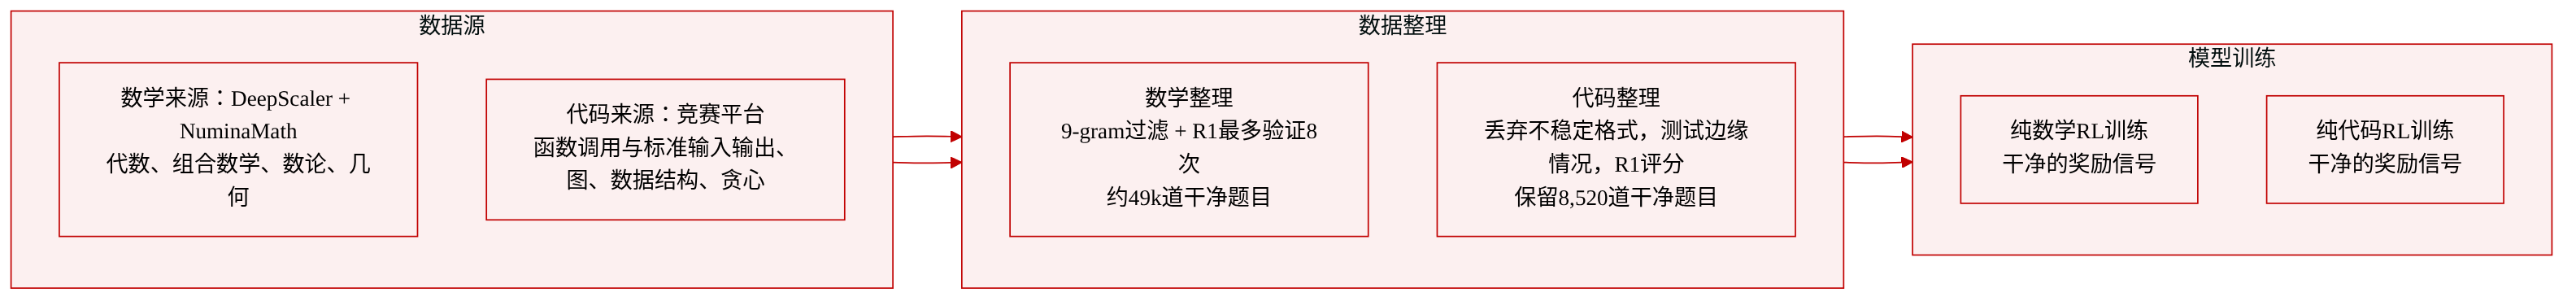
作者构建了两个独立的 RL 训练数据集,一个用于数学、一个用于代码,各自配有独立的数据筛选流程,以确保数据质量和奖励信号的可靠性。
纯数学 RL 数据集
- 来源与构成: 该数据集结合了 DeepScaler 和 NuminaMath,涵盖代数、组合数学、数论和几何。
- 污染过滤: 使用 9-gram 过滤器去除与常见数学基准的重叠。附加规则排除了包含多个子问题、多项选择或判断题格式、过长或过于复杂的答案、基于证明的问题、非英文内容、涉及图表的问题以及过于简短提示的问题。
- 噪声降低: 由于 NuminaMath 主要从在线来源抓取并经过 OCR 和解析工具处理,作者使用 DeepSeek-R1 对每个问题最多尝试 8 次,仅保留基于规则的验证器确认多数投票正确答案的问题。DeepSeek-R1 无法一致解答的问题会被丢弃,因为人工检查通常会发现这些题存在歧义或 OCR 错误。
- 难度平衡: 使用少于 2,000 个 R1 响应 token 的问题会被过滤掉,因为它们被认为无需大量推理即可解决。响应长度在 2,000 到 4,000 个 token 之间的问题会被降采样,以按响应长度平衡数据集。
- 最终规模: 经过严格验证的数据集包含约 49,000 个高质量的数学问题,用于 RL 训练。
纯代码 RL 数据集
- 来源与构成: 来源为现代竞争性编程平台,包含函数调用和标准输入/输出(stdin/stdout)两种格式,涵盖算法主题,如图论、数据结构、数论和贪心算法。
- 奖励稳定性过滤: 移除与标准输出比较不兼容的问题(如需要特殊裁判的多解或交互式问题)以及需要特定平台模板的问题,以尽量减少假阴性奖励。
- 测试用例筛选: 设计强测试用例以覆盖棘手的边界情况和极端输入限制,确保错误解决方案会失败,并消除假阳性奖励。
- 难度评分: 每个问题使用 DeepSeek-R1-671B 进行 8 次 rollout 评估,产生 0 到 8 的难度评分。模型在所有 8 次尝试中均失败的问题(等级 8)会被排除。
- 去污染与去重: 作者使用 n-gram 上下文分析和原始 URL 匹配来执行基准去污染和跨平台问题去重。
- 最终规模: 经过激进过滤后,最终训练集保留 8,520 个问题。
两个数据集分别作为纯数学和纯代码训练阶段的独立 RL 训练语料,过滤选择直接源于在强化学习过程中保持奖励信号干净且无歧义的需求。
方法
作者利用群体相对策略优化(GRPO)算法来训练推理模型。选择该算法是因为其简单性,无需单独的价值函数模型。对于每个问答对,策略模型生成一组 rollout。基于规则的验证器为每个响应分配奖励分数。训练采用 GRPO 的 token 级策略梯度损失变体,其中每个 token 的优势值被统一赋值为整个响应组的归一化奖励分数。
总体目标函数定义为:
JGRPO(θ)=E[∑∣oi∣1∑∑(min(ri,t(θ)A^i,t,clip(ri,t(θ),1−ε,1+ε)A^i,t)−βDKL)]其中 ri,t(θ) 是 token 级重要性权重,A^i,t 是归一化优势。为确保稳定性并防止熵坍缩,作者强制执行严格的策略内约束:在生成一组 rollout 后仅执行一次梯度更新。因此,重要性权重 ri,t(θ) 等于 1,并通过设置 β=0 移除 KL 散度项。这将目标简化为具有组归一化奖励的 REINFORCE 目标:
JGRPO(θ)=E[∑∣oi∣1∑∑A^i,t]奖励机制依赖针对不同领域的独立验证器。对于数学问题,使用基于规则的 Python 验证函数,利用 sympy 检查提取答案的符号等价性。对于编程问题,本地沙箱验证器在完整测试用例集上执行生成的代码,仅当所有测试在时间限制内通过时才给予正向奖励。
训练流程采用特定的课程结构来处理长思维链推理的计算强度。首先进行纯数学强化学习,将最大响应长度从 8K 逐步扩展到 24K token。随后进行纯代码强化学习,进一步将长度扩展到 32K。最后,在 32K 长度下进行第二轮纯数学强化学习。
为提高效率和模型能力,训练融合了三个关键策略。首先,严格策略内方法对每组 rollout 仅进行一次更新,以维持稳定的熵。其次,采用分阶段长度扩展策略,从 8K 逐步推进到 16K、24K,最后到 32K token,而非一开始就使用较高长度。第三,采用课程学习,在后续阶段过滤掉较简单的提示(通过率高于 6/16),引入更困难的问题以推动模型极限。
该框架展现出显著的跨领域泛化能力。虽然纯代码 RL 针对编程任务,但最初的纯数学 RL 阶段也提升了各主题的编码性能。
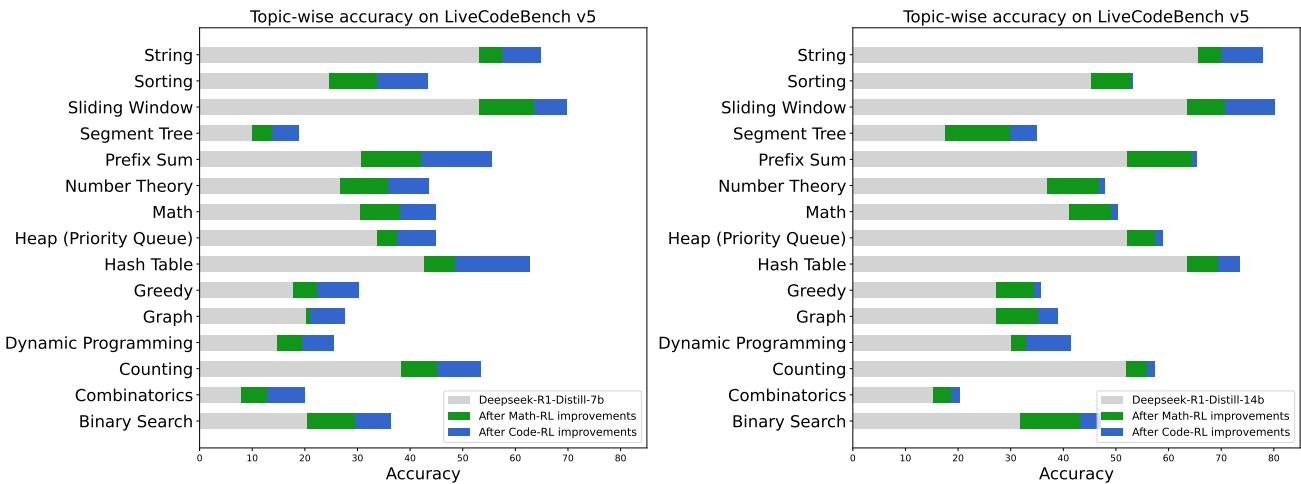
如按主题的准确性分析所示,纯数学 RL 阶段在算法和数学相关的编码领域带来显著提升,而后续的纯代码 RL 阶段进一步改善了依赖实现和数据结构(如模拟和字符串处理)的主题性能。
实验
评估涵盖数学基准(AIME2024/2025、MATH500、HMMT2025、BRUMO2025)和代码基准(LiveCodeBench v5/v6、Codeforces ELO、EvalPlus),以 DeepSeek-R1-Distill-Qwen-7B/14B SFT 基线为起点。主要结果表明,RL 训练在数学和代码准确性上均显著超越 SFT 模型,其中 14B 变体超越了更大的蒸馏模型。分析显示,延长响应长度限制、使用高难度提示训练以及将 Math-RL 安排在 Code-RL 之前均带来显著收益,而代码 RL 中的假阳性或假阴性奖励会导致收敛到次优策略。RL 在所有采样数量下均提升了 pass@1 和 pass@k 指标,并解锁了 SFT 模型无法解决的难题的长尾分布。
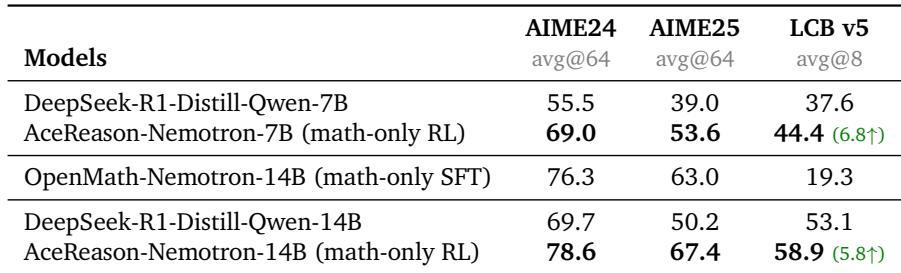
纯数学强化学习提升了代码推理能力,在纯数学监督微调和蒸馏基线上均表现更优。经过 RL 训练的模型在 7B 和 14B 规模下持续在代码基准上取得更高分数,而纯数学 SFT 可能带来明显较差的代码性能。纯数学 RL 使 LiveCodeBench 分数在 7B 上提升 6.8 分、在 14B 上提升 5.8 分,超越蒸馏 SFT 基线。14B 规模的纯数学 SFT 产生的代码性能(19.3)远低于 RL(58.9),显示了 RL 的跨领域优势。RL 模型在两种规模下均超越蒸馏 SFT 在 AIME 数学基准上的表现,表明具有广泛的推理能力提升。
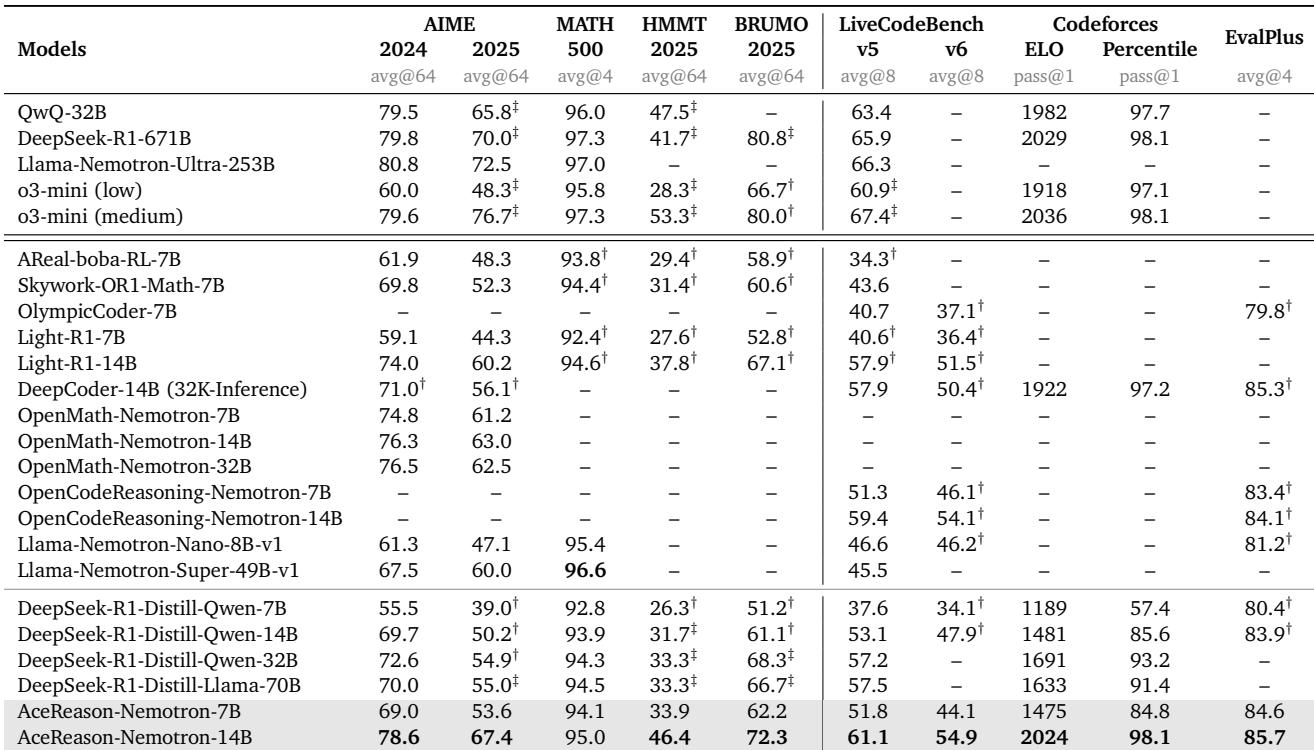
评估结果表明,基于 RL 的训练在数学和代码推理上显著优于初始 SFT 模型,14B 变体甚至展现出比更大蒸馏模型更优越的性能。这些模型在与基于 RL 的最先进模型和前沿推理模型的对比中也表现出竞争性或优越性,pass@k 指标持续提升。RL 训练在数学和编程任务上较 SFT 带来大幅提升,包括 AIME 和 LiveCodeBench 上的显著改善。AceReason-Nemotron-14B 在数学和代码基准上均超过更大的 SFT 蒸馏模型。这些模型在多项任务上与 QwQ-32B 和 o3-mini 等前沿推理模型保持竞争力。
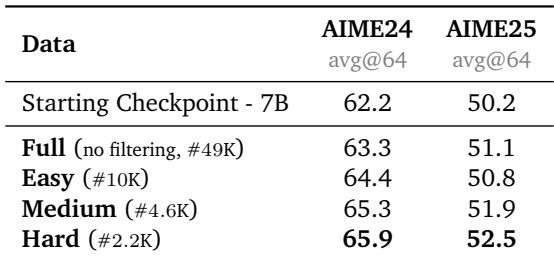
在 24K RL 阶段,按难度过滤训练提示可提高基准性能,最难的提示集在 AIME24 和 AIME25 上取得最佳分数,尽管其提示数量远少于完整数据集。较容易和中等难度的集合也优于未过滤的完整集合,表明按通过率进行课程过滤是有效的。Hard 提示集(2.2K 提示)在 AIME24 和 AIME25 上取得最高分数,优于完整的 49K 提示集。过滤掉 16 次尝试中解决超过 6 次的提示,在 AIME24 上较使用完整未过滤数据获得 2.6% 的提升。Easy 和 Medium 过滤集也都优于未过滤的完整集合,表明移除已被充分解决的提示始终有帮助。
纯数学 RL 在 7B 和 14B 模型的数学与编码基准上均显著提升性能。随后的纯代码 RL 进一步提升编码分数,同时对数学性能的影响微乎其微,表明顺序 RL 训练对于发展跨领域强推理能力是有效的。纯数学 RL 在两种模型规模下均对 AIME 和 LiveCodeBench 带来显著收益。数学 RL 之后的代码 RL 提供了额外的编码改进,而数学退化极小。顺序训练模式在 7B 和 14B 模型中保持一致,展现出稳健的交互作用。
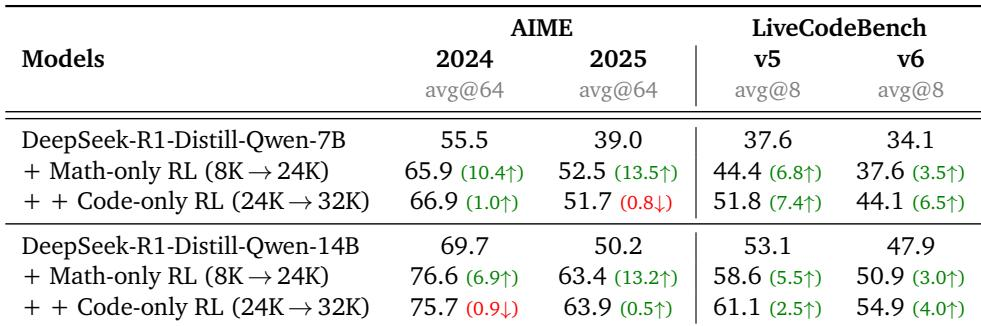
实验证明,强化学习(特别是纯数学 RL)在多种模型规模下显著增强了数学和代码推理能力,优于监督微调和蒸馏基线。按难度过滤 RL 训练提示(特别是选择最难的提示)能产生更好的基准性能。此外,顺序 RL 训练(数学 RL 后接代码 RL)在数学技能几乎不受影响的情况下带来进一步的编码收益,表明具有稳健的跨领域优势。