Command Palette
Search for a command to run...
MIRACL-VISION:一个大规模多语言视觉文档检索基准
MIRACL-VISION:一个大规模多语言视觉文档检索基准
Radek Osmulski Mengyao Xu Gabriel de Souza P. Moreira Benedikt Schiferer Ronay Ak Even Oldridge
MIRACL-VISION 多语言视觉检索数据集
摘要
文档检索是搜索和检索增强生成(RAG)应用中的一项重要任务。大型语言模型(LLM)已助力提升基于文本的文档检索精度。然而,对于具有复杂布局和视觉元素(如表格、图表和信息图)的文档,文本格式并不能完美表征。近年来,基于图像的文档检索流程日益普及,此类流程利用视觉大语言模型(VLM)根据查询检索相关的页面图像。当前视觉文档检索的评测基准十分有限,主要局限于英语,依赖合成生成的问题,且语料库规模较小。为此,我们引入了 MIRACL-VISION,一个多语言视觉文档检索评测基准。MIRACL-VISION 覆盖 18 种语言,是 MIRACL 数据集的扩展。MIRACL 是评估基于文本的多语言检索流程的流行基准,通过高人力投入的标注流程生成高质量问题。为缩减 MIRACL-VISION 的语料规模以提高评测的计算友好性,同时保持数据集的挑战性,我们设计了一种从语料库中剔除“简单”负样本的方法。我们使用流行的公开文本和图像模型,进行了大量实验,将 MIRACL-VISION 与其他基准进行对比。我们观察到,最先进的基于 VLM 的嵌入模型在多语言能力上存在差距,其检索精度比基于文本的检索模型低 59.7%。即使在英语上,视觉模型的检索精度也比文本模型低 12.1%。MIRACL-VISION 是一个具有挑战性、代表性且多语言的视觉检索流程评测基准,将有助于社区构建稳健的文档检索模型。
一句话总结
NVIDIA 研究人员推出 MIRACL-VISION,这是一个多语言视觉文档检索基准测试,将 MIRACL 扩展到 18 种语言,使用人工生成的问题,并提供一种移除简单负样本的方法以实现计算友好的评估。实验表明,最先进的基于 VLM 的嵌入模型在整体上比基于文本的检索模型性能低 59.7%,在英语上低 12.1%,从而凸显了多语言视觉能力方面的差距。
核心贡献
- 本文介绍了 MIRACL-VISION,这是一个覆盖 18 种语言的多语言视觉文档检索评估基准,作为 MIRACL 数据集的扩展构建,利用其人工标注的问题来确保高质量的检索评估。
- 本文提出了一种语料库缩减方法,从检索池中移除"简单"负样本,生成的数据集在保持评估计算可行性的同时仍具有挑战性。
- 将 MIRACL-VISION 与其他基准进行比较的实验表明,最先进的基于 VLM 的嵌入模型在跨语言评估中比基于文本的检索模型低最多 59.7%,在纯英语评估中低 12.1%,揭示了当前视觉检索系统中显著的多语言能力差距。
引言
检索增强生成(RAG)已成为将 LLM 锚定到领域特定内容的标准方法,许多公司现在构建从报告、合同和演示文稿等内部文档进行检索的助手。基于文本的检索流程需要繁重的摄入步骤,如扫描页面的 OCR、版面检测和结构感知分块,这些步骤在复杂版面下都会变得脆弱。一种较新的替代方案是将文档页面表示为图像,并使用结合 OCR 和嵌入能力的视觉语言模型(VLM),由此产生了 DSE-Qwen2、GME-Qwen2、ColPali 和 ColQwen 等模型。然而,用于评估这些视觉检索器的基准(包括 ViDoRe 和 VDR)依赖合成生成的问题、规模较小且不具挑战性的语料库,且缺乏多语言覆盖。作者推出了基于 MIRACL 文本检索数据集构建的 MIRACL-VISION 多语言视觉文档检索基准,覆盖 18 种语言,包括低资源语言(如斯瓦希里语)和非拉丁文字(如阿拉伯语、日语、韩语、俄语)。他们从 MIRACL 查询中生成维基百科文章第一页的图像,问题最初由母语者策划,并策略性地选择难负样本以保持语料库的计算可行性。评估表明,当前最先进的视觉嵌入模型在文本密集型页面上的性能比规模更小的文本嵌入模型低最多 59.7%,挑战了基于 VLM 的检索本质上更优的假设,并为社区跟踪多语言视觉检索进展提供了新资源。
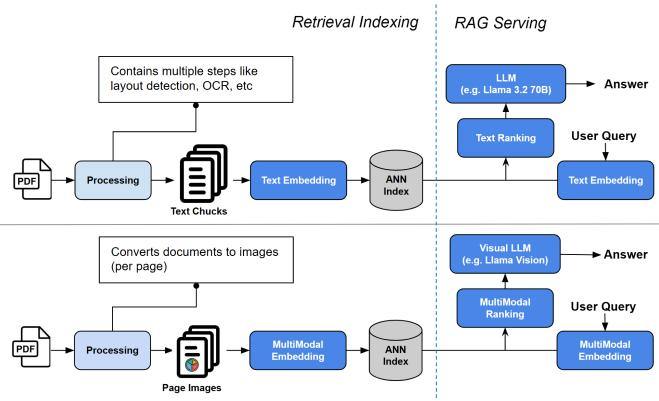
数据集
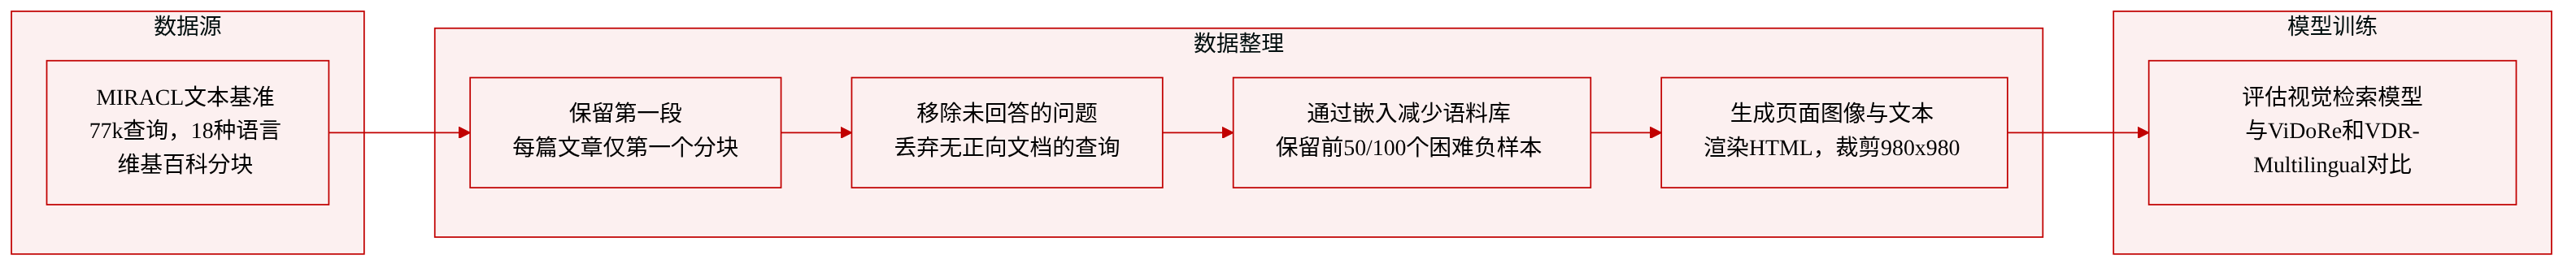
作者推出了 MIRACL-VISION,这是一个通过扩展现有 MIRACL 文本检索基准构建的多语言视觉文档检索基准。以下是数据集的组成、处理和使用方式的详细说明。
组成与来源
- MIRACL-VISION 源自 MIRACL,这是一个覆盖 18 种语言、约 7.7 万条人工生成查询的多语言文本检索基准。
- MIRACL 本身基于维基百科文章,将其分块以进行嵌入。仅英文维基百科就有 570 万篇文章,为英文 MIRACL 语料库产生 3200 万个分块。
- 对于 MIRACL-VISION,作者用包含该段落对应文本的维基百科页面图像替换每个真实文本段落,同时复用原始人工生成的问题。
子集构建与过滤
- 步骤 1:仅保留每篇维基百科文章的第一段,因为作者无法可靠地从任意分块中提取图像。这产生了 MIRACL-1stParagraph 中间集,将平均语料库从每语言 590 万分块减少到约 100 万分块。
- 步骤 2:移除在过滤后的语料库中不再有正样本文档的问题,将每语言平均查询数从 750 减少到 439,产生 MIRACL-1stParagraph 集合。
- 步骤 3:使用 multilingual-e5-large 文本嵌入模型进一步缩减语料库。对问题和文档进行嵌入,计算余弦相似度,每个问题仅保留最相似的 top-100(英语)或 top-50(其他语言)文档。这仅保留正样本和难负样本,在 MIRACL-1stParagraph-Reduced 集合中每语言平均产生约 18,819 个文档,规模小得多但仍具有检索挑战性。
图像与文本生成
- 步骤 4:对于每个剩余文档,作者下载对应的维基百科文章,修改 HTML 以移除侧边栏和页眉等元素,并使用 Playwright 进行渲染。
- 提取文章前 2048 个垂直像素的图像,然后裁剪为 980 x 980 像素并保存到磁盘。
- 同时创建名为 MIRACL-VISION-text 的文本表示,从 HTML 正文中提取前 12 个句子,作为裁剪后图像内容的近似匹配。
统计与比较
- 最终的 MIRACL-VISION 包含 18 种语言,覆盖低资源和非拉丁文字语言。
- 每种语言的查询数量范围为 300 到 483,每种语言的平均语料库大小约为其他视觉文档检索基准的 6 倍。
- 与 ViDoRe(8 个英文和 2 个法文数据集)和 VDR-Multilingual(英文、法文、德文、意大利文、西班牙文)相比,MIRACL-VISION 提供了更广泛的语言覆盖。
- 作者指出的一个局限是 MIRACL-VISION 查询主要基于文本,而 ViDoRe 和 VDR-Multilingual 包含关于表格、图表和信息图表的查询。然而,作者认为基于文本的查询对于评估基于视觉的检索模型的多语言能力仍然高度相关。
- MIRACL 中的人工标注确保了自然提出的问题,而 ViDoRe 和 VDR-Multilingual 中 LLM 生成的合成查询往往会重复源文档中的关键词,可能无法反映无偏的用户查询。
论文中的使用方式
- MIRACL-VISION 用作评估基准,而非训练数据。作者比较 MIRACL-VISION 上的检索性能与 ViDoRe 和 VDR-Multilingual 上的结果,以评估多语言视觉文档检索能力。
- 缩减后的语料库规模专门设计用于在保持检索评估可行性的同时保留相关结果,因为每种语言包含百万级图像的大规模语料库在计算上是不可行的。
方法
作者提出了一个系统化的流程,将基于文本的 MIRACL 数据集扩展为 MIRACL-VISION,这是一个用于多语言视觉文档检索的基准。该流程旨在复用人工生成的查询,同时用对应的文档图像替换真实文本段落。整体生成框架如下图所示。
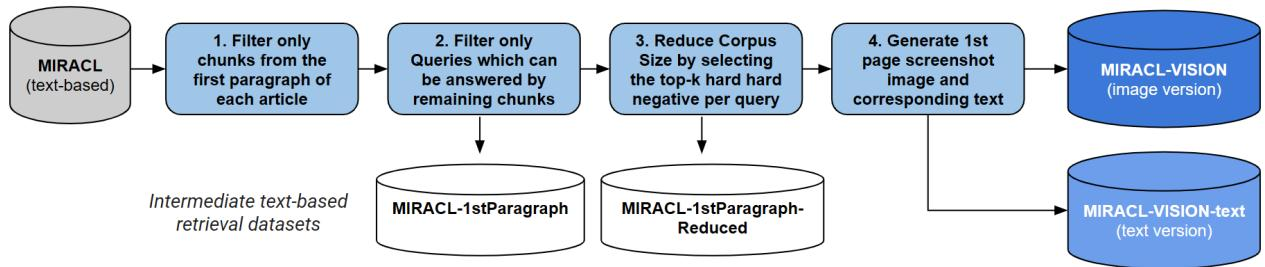
该方法通过四个不同阶段来转换源语料库。
首先,该流程过滤语料库,仅保留从每篇文章第一段派生的分块。由于原始 MIRACL 语料库由为嵌入而分割为可管理分块的维基百科文章组成,从长文档中的任意分块提取图像被证明不可靠。通过将检索目标限制在第一段,系统确保真实答案始终位于源文档的第一页。这种简化允许一致的图像提取。
其次,系统过滤查询集以确保可回答性。在将语料库限制为第一段分块后,某些问题不再在过滤后的集合中具有有效的真实文档。作者移除所有无法由剩余第一段分块回答的查询,创建名为 MIRACL-1stParagraph 的中间数据集。
第三,该流程在保持评估难度的同时缩减语料库规模。完整的第一段分块语料库在图像提取和模型评估方面仍计算成本较高。为解决此问题,作者采用难负样本挖掘策略。他们使用 multilingual-e5-large 文本嵌入模型对语料库中的查询和文档进行嵌入。通过计算查询与文档嵌入之间的余弦相似度,识别每个查询最相似的 top-k 文档。然后修剪语料库,仅保留正样本和这些难负样本(英语为 top-100,其他语言为 top-50)。这产生了一个规模显著更小但仍具挑战性的数据集,名为 MIRACL-1stParagraph-Reduced,为每个查询保留了主要的干扰文档。
最后,系统生成视觉和文本表示。对于缩减语料库中的每个文档,下载对应的维基百科文章。修改 HTML 以仅渲染主要内容,移除页眉和侧边栏。使用 Playwright 库,系统捕获文章前 2048 个垂直像素的截图,然后裁剪为 980x980 像素以形成数据集的图像版本。同时,从 HTML 正文中提取文本内容,保留前 12 个句子作为图像的近似文本表示,创建 MIRACL-VISION-text 数据集。下面提供了此过程的示例,显示用户查询和对应的维基百科文章图像。
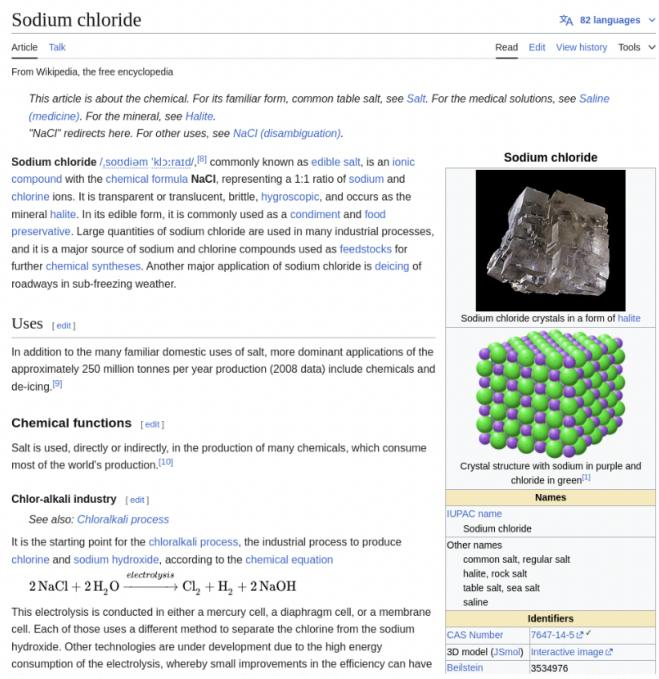
实验
本文推出了 MIRACL-VISION,这是一个新的多语言视觉文档检索基准,并与现有基准进行比较。实验表明,MIRACL-VISION 比现有视觉基准具有显著更高的挑战性,后者由于其小型语料库和合成查询生成而近乎饱和。在同一内容上,基于文本的嵌入模型始终优于基于视觉的模型,非拉丁字母语言尤其突出,同时所需参数远少更多。此外,从 MIRACL 派生的过滤和缩减文本变体在缩减 58 倍的情况下仍保持与原始数据集的检索准确率相关性,尽管提取的较长 HTML 文本会引入噪声从而略微降低性能。
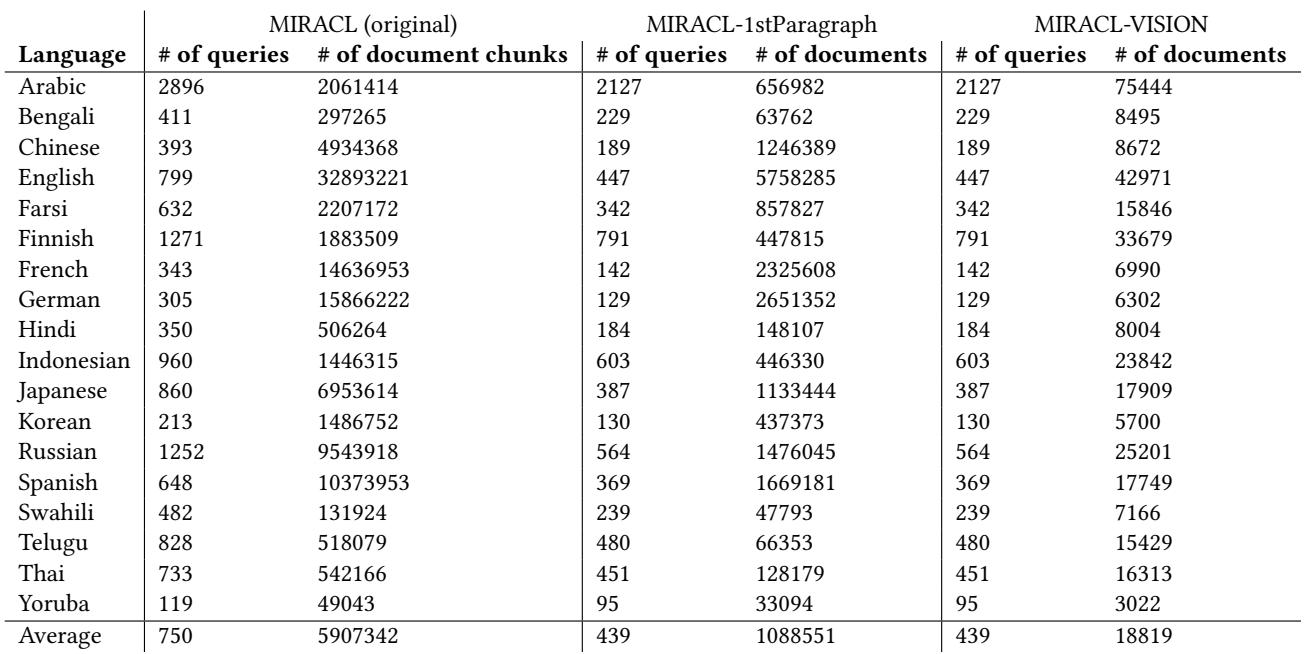
下表比较了原始 MIRACL 语料库、按每篇文章第一段过滤的版本以及 MIRACL-VISION(将文本真实值替换为文档图像)之间的查询和文档数量。过滤同时减少了查询和文档,而 MIRACL-VISION 在保留过滤后查询集的同时进一步大幅减少了文档数量。这种缩减创建了一个更小但更难的检索基准,同时保留难负样本。过滤到第一段将各种语言的查询和文档分块都进行了削减,文档数量下降约 3 到 5 倍。MIRACL-VISION 保持与过滤版本相同的查询,但大幅减少文档数量,通常比过滤后的语料库少一个数量级或更多。MIRACL-VISION 的规模缩减旨在保持难负样本,同时提供更具挑战性的视觉检索任务。
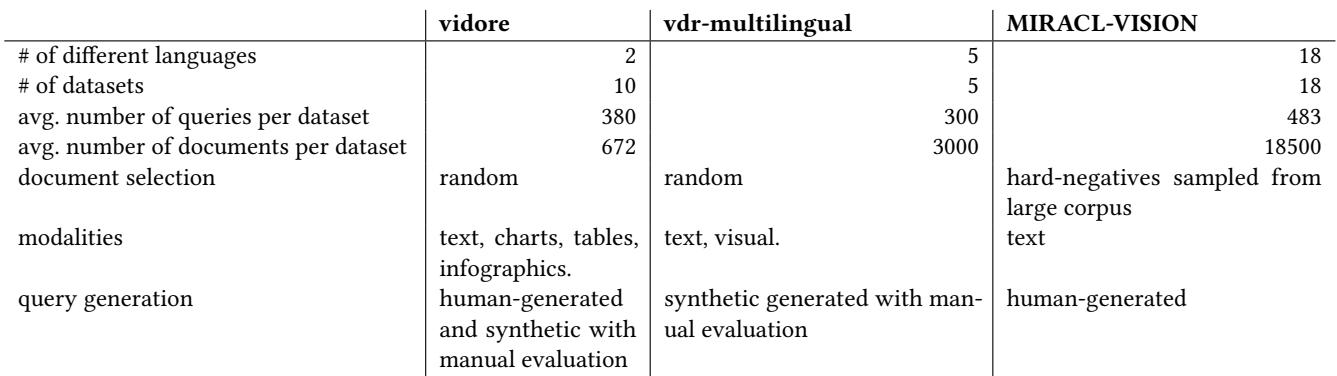
MIRACL-VISION 是一个更广泛且更具挑战性的视觉文档检索基准,覆盖 18 种语言和 18 个数据集,平均每个数据集包含 483 个查询和 18,500 个文档。它使用人工生成的查询和难负样本采样,而其他基准依赖合成查询和随机文档选择,且语料库规模小得多。MIRACL-VISION 覆盖 18 种语言和 18 个数据集,远超现有基准的 2 到 5 种语言和 5 到 10 个数据集。与其他基准中的随机文档选择不同,MIRACL-VISION 从大型语料库中采样难负样本,增加了检索难度。MIRACL-VISION 中的查询来自 MIRACL 的人工生成,而其他基准使用合成生成和人工评估。
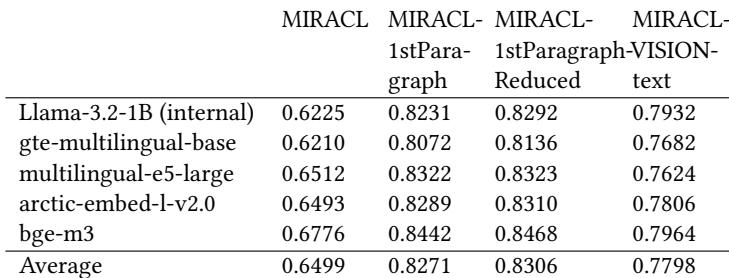
在原始 MIRACL 基准上,所有评估的文本嵌入模型的平均 NDCG@10 约为 0.65,而派生的 MIRACL-1stParagraph 变体得分显著更高,约为 0.83,表明过滤后的版本是更容易的检索任务。Reduced 版本缩小了 58 倍,与完整的第一段版本非常接近,证实了激进的缩小保留了相对检索质量。平均 NDCG@10 从 MIRACL 的 0.6499 上升到 MIRACL-1stParagraph 的 0.8271,表明该变体显著更容易。MIRACL-1stParagraph-Reduced(0.8306)和 MIRACL-1stParagraph(0.8271)得分接近,表明 58 倍缩减保留了难负样本的有效性。
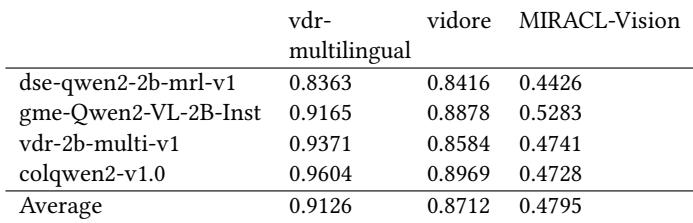
在四个基于 VLM 的嵌入模型中,MIRACL-VISION 上的 NDCG@10 得分远低于 ViDoRe 和 vdr-multilingual,平均得分分别为 0.4795、0.9126 和 0.8712。最佳模型 colqwen2-v1.0 在现有基准上接近饱和,但在 MIRACL-VISION 上急剧下降,表明后者是一个更具挑战性的多语言视觉检索基准。所有模型在 MIRACL-VISION 上的得分都显著较低,平均 NDCG@10 降至 0.4795,而在其他基准上高于 0.87。colqwen2-v1.0 在 vdr-multilingual(0.9604)和 ViDoRe(0.8969)上取得最高分,但在 MIRACL-VISION 上仅为 0.4728。现有基准上的近饱和表现可能源于其较小的语料库规模和重复文档关键词的合成查询,而 MIRACL-VISION 可能反映了真实的用户查询。在四个模型中,gme-Qwen2-VL-2B-Inst 在 MIRACL-VISION 上表现最佳,得分为 0.5283,但仍远低于其他基准上的得分。
文本嵌入模型在 MIRACL-VISION 基准上的所有语言中始终优于视觉嵌入模型,最佳文本模型的平均 NDCG@10 比最佳视觉模型高 50% 以上。差距在英语中最小,但在非拉丁字母语言中显著扩大。此外,参数远少得多的紧凑文本模型超越了更大的视觉模型,凸显了效率优势。基于文本的模型在每种语言上的 NDCG@10 都高于视觉模型,差距从英语的 12.1% 到阿拉伯语、印地语和泰语的近 60% 不等。最佳视觉模型 gme-Qwen2-VL-2B-Instruct 比最佳文本模型 bge-m3 平均落后 50% 以上。仅 3.05 亿参数的文本模型超越了使用 15.43 亿参数的视觉模型,展示了五倍的参数效率优势。
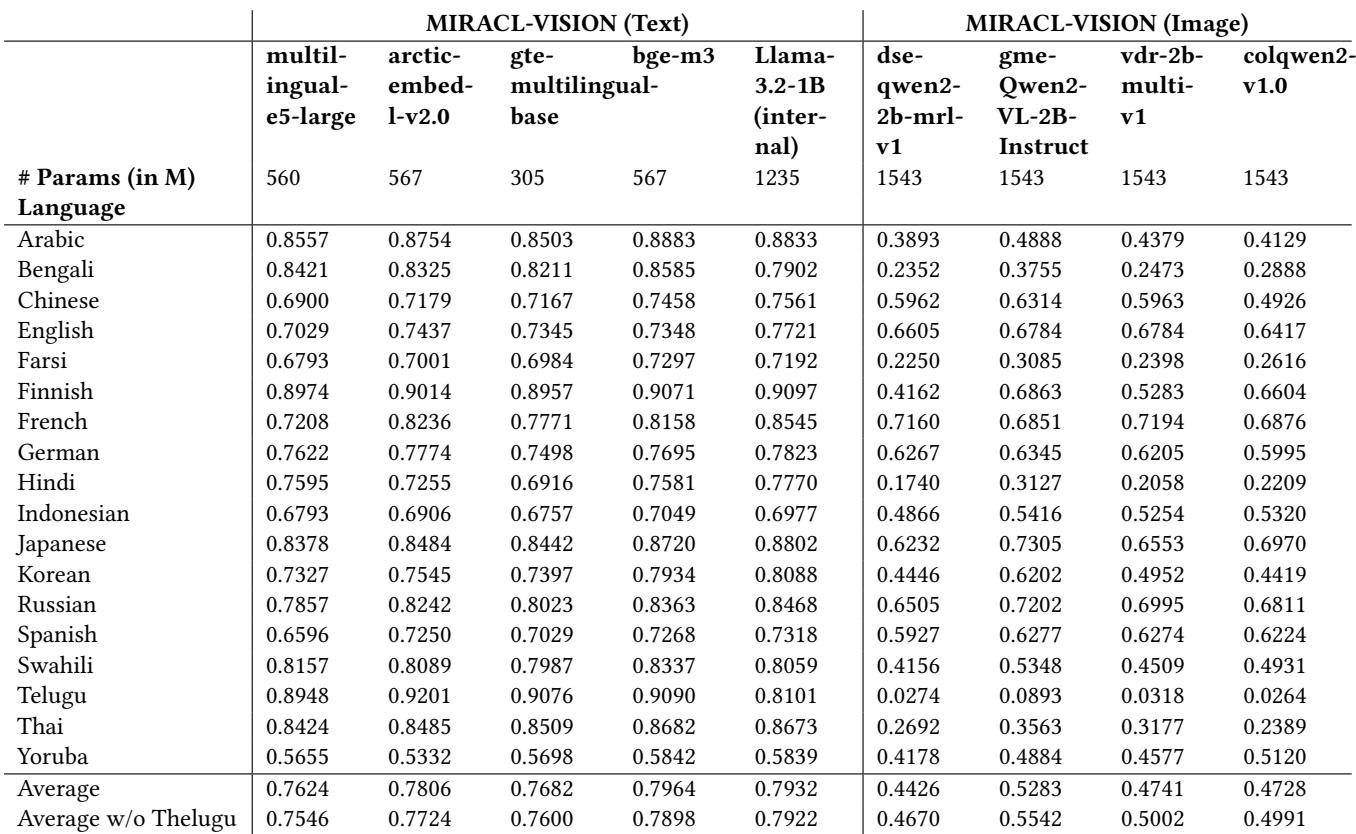
实验表明,MIRACL-VISION 是一个基于过滤 MIRACL 数据构建的视觉文档检索基准,包含人工生成的查询和难负样本,由于其更大的规模和更真实的查询表述,比现有视觉基准具有显著更高的挑战性。在所有语言中,基于文本的嵌入模型始终以较大幅度优于视觉模型,非拉丁文字语言的差距更大,同时紧凑文本模型在效率上超越了更大的视觉模型。此外,对语料库的激进降采样保留了检索质量,表明缩减后的基准尽管规模较小,仍保持了难负样本和难度。