Command Palette
Search for a command to run...
OpenCodeInstruct:面向代码大语言模型的大规模指令调优数据集
OpenCodeInstruct:面向代码大语言模型的大规模指令调优数据集
Wasi Uddin Ahmad Aleksander Ficek Mehrzad Samadi Jocelyn Huang Vahid Noroozi Somshubra Majumdar Boris Ginsburg
OpenCodeInstruct 大型代码指令微调数据集
摘要
大型语言模型(LLM)通过实现代码生成、自动调试和复杂推理,已经改变了软件开发领域。然而,其持续发展受到高质量、公开可用的、针对编码任务的监督微调(SFT)数据集稀缺的制约。为弥补这一差距,我们推出了 OPENCODE-INSTRUCT,这是最大的开放访问指令调优数据集,包含 500 万个多样化的样本。每个样本包含一个编程问题、解决方案、测试用例、执行反馈以及 LLM 生成的质量评估。我们使用该数据集对多种基础模型(包括 LLaMA 和 Qwen)进行了不同规模(1B+、3B+ 和 7B+)的微调。在流行基准(HumanEval、MBPP、Live-CodeBench 和 BigCodeBench)上的全面评估表明,使用 OPENCODEINSTRUCT 进行 SFT 可带来显著的性能提升。我们还介绍了详细的方法论,涵盖种子数据整理、合成指令和解决方案生成以及过滤。
一句话总结
NVIDIA 的研究人员推出了 OpenCodeInstruct,这是一个大规模指令微调数据集,包含 500 万个多样化的编码样本,每个样本均包含编程问题、解决方案、测试用例、执行反馈以及 LLM 生成的质量评估。在该数据集上微调 LLaMA 和 Qwen 模型(1B+、3B+ 和 7B+)在 HumanEval、MBPP、Live-CodeBench 和 BigCodeBench 上取得了显著的性能提升,从而解决了代码 LLM 高质量公开监督微调数据稀缺的问题。
核心贡献
-
OPENCODEINSTRUCT 是迄今为止最大的公开代码指令微调数据集,包含 500 万个多样化样本,并带有丰富的元数据,包括单元测试、执行反馈和 LLM 生成的质量评估,以及覆盖种子筛选、合成指令生成和过滤的完整流程。
-
使用 OPENCODEINSTRUCT 对 Llama3 和 Qwen2.5-Coder 基础模型在多个规模(1B+、3B+ 和 7B+)上进行微调,在 HumanEval、MBPP、LiveCodeBench 和 BigCodeBench 上相较于其指令微调版本产生显著的性能提升,且仅使用 50 万个样本即可超越基线 instruct 模型。
-
大量消融实验和分析揭示了若干关键洞察:基于 LLM 的判断比基于执行的反馈更能有效指示指令质量;结合 Evol-Instruct 和 Self-Instruct 的 Genetic-Instruct 优于单独使用任一种方法;更大的种子集可改进下游生成;通用和算法编码指令均有正向贡献;自然语言到代码的格式显著优于代码到代码的提示。
引言
用于代码的大语言模型通常通过指令微调进行精炼,其中精心挑选的指令-响应对将模型输出与软件工程任务中的用户意图对齐。指令遵循数据的质量在此阶段至关重要,但大规模生成此类数据既困难又昂贵。
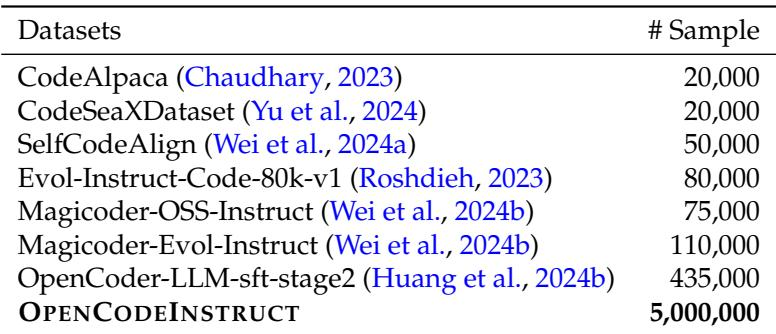
以往方法存在显著局限。人工标注(例如用于训练 Llama-3 的大规模数据集)质量高但成本高昂。SELF-INSTRUCT 和 EVOL-INSTRUCT 等合成蒸馏方法依赖有限的现有数据进行上下文学习,而 OSS-INSTRUCT 利用真实代码片段;然而,这些方法往往需要访问专有模型和数据。此前最大的开放代码指令语料库仅包含 43.5 万个样本。
作者引入了 OPENCODEINSTRUCT,这是迄今为止最大的公开代码指令微调数据集,包含 500 万个 Python 样本。它采用可扩展的合成生成框架,结合了 SELF-INSTRUCT 和 EVOL-INSTRUCT,以 143 万个通用编码指令(通过 OSS-INSTRUCT 从 GitHub 提取)和来自 TACO 的 25443 个算法问题作为种子。该流程还整合了 LLM 生成的单元测试用于反馈聚合,以及基于 LLM 的判断用于样本质量评估。使用 OPENCODEINSTRUCT 对 Llama3 和 Qwen2.5-Coder 在 1B+、3B+ 和 7B+ 规模上进行微调,在 HumanEval、MBPP、LiveCodeBench 和 BigCodeBench 等基准上相较于其指令微调版本取得了显著性能提升。消融实验揭示了若干见解:仅用 50 万个样本微调即可超越原始 instruct 模型;LLM 判断比执行反馈能更可靠地指示质量;Evol-Instruct 和 Self-Instruct 的混合方法效果最佳;更大的种子集可改善下游生成;自然语言到代码的格式优于代码到代码的提示。该数据集将完全开源。
数据集
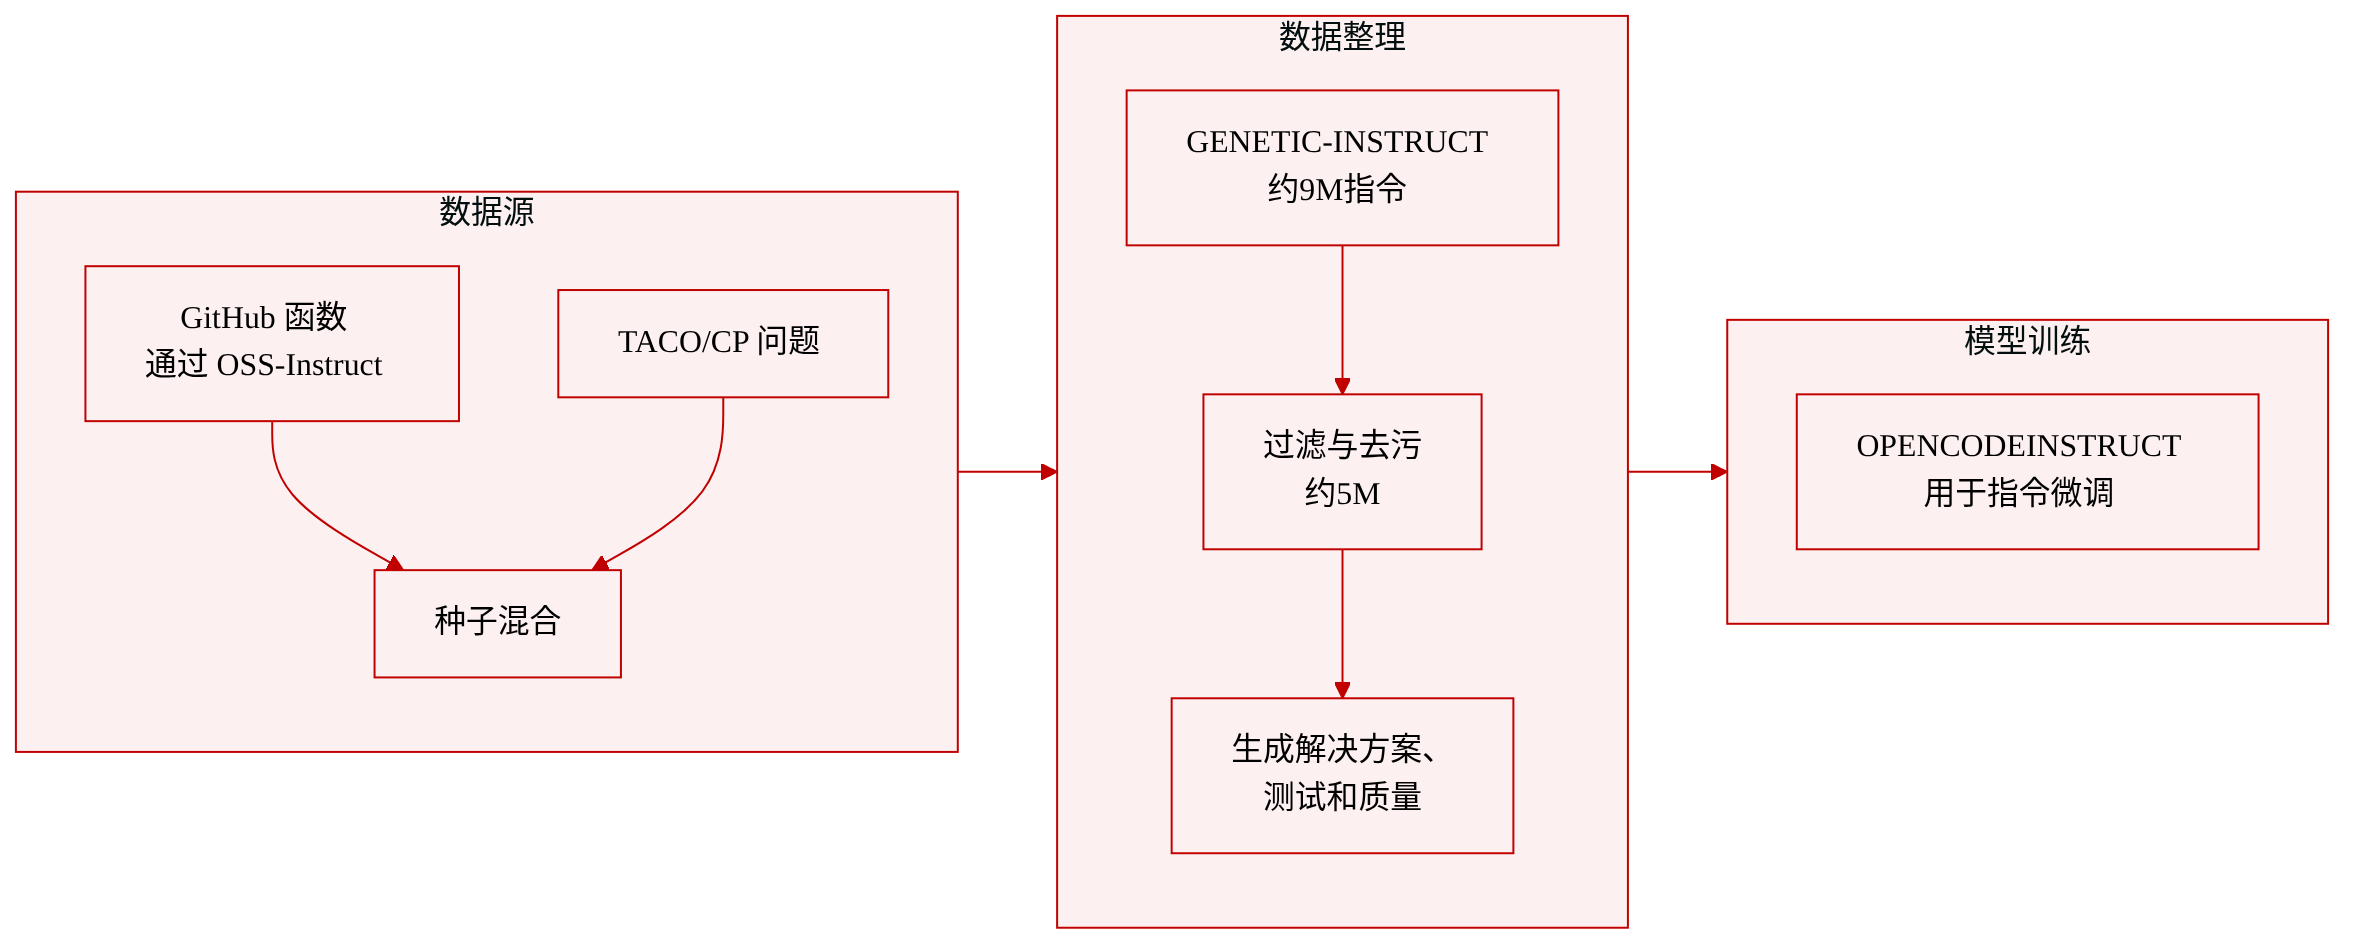
作者构建了 OPENCODEINSTRUCT 数据集用于编码指令微调。开发流程结合了两种种子集合、一个合成生成框架以及一系列过滤和增强步骤。
-
数据集构成和来源:
- 该数据集基于两个初始种子集构建:一个大规模通用集合和一个较小的高质量算法集合。
- 大规模种子是基于从 GitHub 提取的 Python 函数生成的合成指令。作者使用 OSS-INSTRUCT 算法和 Qwen2.5-32B-Instruct 模型,根据这些函数生成了 143 万条编码指令。仅保留指令;生成的解决方案代码被丢弃。
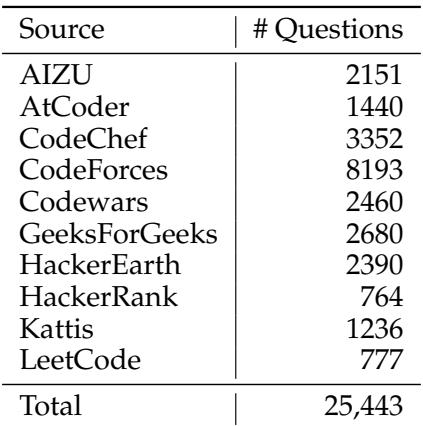
- 小规模种子包含来自 TACO 和多个竞赛编程平台的 25443 个算法编码问题。
-
合成指令生成:
- 作者使用 GENETIC-INSTRUCT 框架从种子生成新指令。该框架采用变异和交叉操作来创建多样的问题。
- 尽管该框架可以迭代运行,但作者只运行了一代,产生了近 900 万条合成指令。
-
数据清洗和去污染:
- 生成的样本池通过两个步骤进行精炼。首先,过滤掉包含 Python 代码片段的指令,因为发现这些指令噪声大且对代码生成任务无益。其次,基于 n-gram 的去污染方法移除了与评估基准的任何重叠。
- 清洗后,约剩 500 万个合成编码问题。
-
响应生成和元数据:
- 作者使用 Qwen2.5-Coder-32B-Instruct 模型为清洗后的指令生成编码解决方案。为了测试生成器的影响,他们还对部分样本使用了 Qwen2.5-32B-Instruct 和 QwQ-32B-Preview。
- 作为元数据,一个 LLM 自动为每个响应从预定义列表中分配最多三个编码技能。
-
测试用例生成和执行:
- 对于每个问题-解决方案对,作者使用 Qwen2.5-Coder-32B-Instruct 生成了十个断言风格的单元测试。
- 所有解决方案都针对其对应的单元测试执行。通过/失败结果和每个解决方案的通过率被纳入元数据。
-
响应质量评估:
- 作者采用 LLM-as-a-judge 方法,使用 Qwen2.5-Coder-32B-Instruct 对每个解决方案在需求符合度、逻辑正确性和边界情况考虑方面进行评分。评估分数和理由被包含在元数据中。
方法
作者提出了一个用于大规模生成编码指令微调数据的综合框架。流程从创建初始种子集合开始,以确保多样性和覆盖范围。并行使用两组不同的种子:大规模通用集合和小规模算法集合。通用种子源自从 GitHub 提取的 Python 函数,经过包含类型检查和去重的严格过滤流程。这些函数作为生成多样化编码指令的基础。算法种子由来自 TACO 数据集的高质量问题组成,侧重于竞赛编程场景,以丰富数据集中的复杂数据结构和算法问题。
请参考框架图,了解开发阶段的概览。
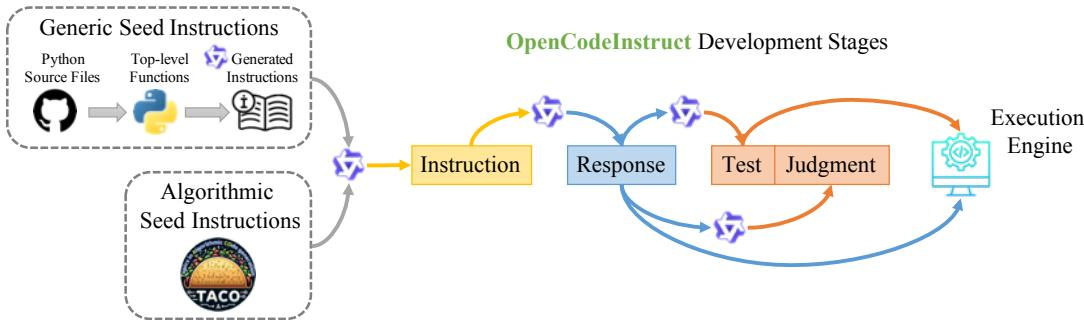
种子创建之后,框架采用可扩展的合成数据生成方法,以生成指令及其对应响应。该过程涉及进化操作,如变异和交叉,其中大语言模型根据特定任务生成新指令,或组合现有指令以创建多样变体。为确保数据质量,应用了清洗和去污染步骤,包括过滤掉包含 Python 代码片段的指令(这些通常具有噪声),并使用基于 n-gram 的方法移除与评估基准的任何重叠。
指令最终确定后,流程进入响应生成阶段。作者提示专门的编码模型为指令生成高质量的代码解决方案。此外,自动生成编码技能形式的元数据,以对解决方案进行分类。为了进一步增强数据集对强化学习(尤其是带执行反馈的强化学习)的实用性,框架为每个问题-解决方案对生成断言风格的单元测试。这些测试由模型创建,然后针对生成的解决方案执行。执行引擎捕获结果,包括通过率和错误类型。测试结果的分布显示,相当一部分解决方案通过所有测试,而其他解决方案则因断言错误或其他执行问题而失败,如测试用例通过/失败分布图所示。
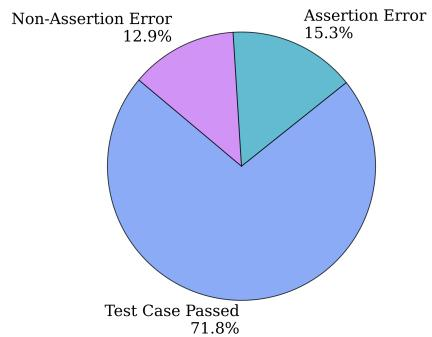
执行结果被整合为元数据,为训练提供有价值的反馈信号。该端到端流程确保了生成一个健壮、多样且高质量的数据集,适用于编码任务中的指令微调。
实验
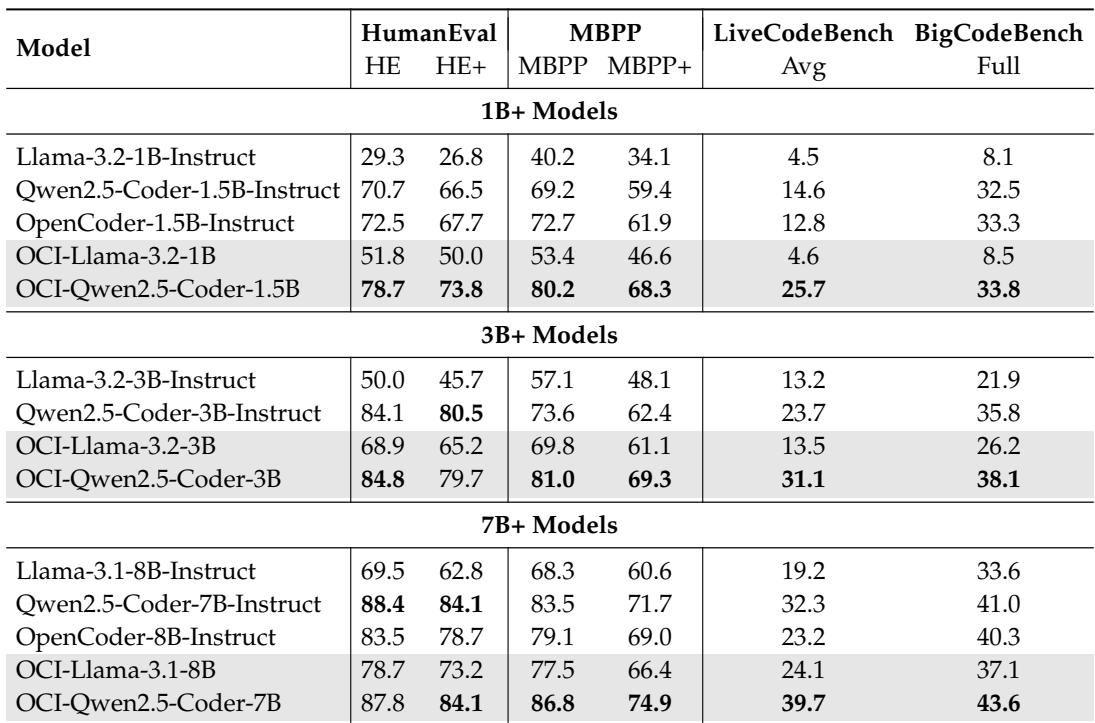
评估使用了 OPENCODEINSTRUCT 对 Llama3 和 Qwen2.5-Coder 模型进行微调,并与指令微调基线在代码生成基准上进行比较,结果显示出一致的改进,尤其是对通用模型而言。消融研究表明,基于 LLM 的验证优于单元测试过滤,更大的合成数据规模可提升性能,两种指令生成算法具有互补性,多样化的种子群体可增强质量,自然语言到代码的格式比代码到代码更有效。此外,使用更强的生成器模型能带来更好的下游性能,且 OPENCODEINSTRUCT 优于基于现有代码片段的同等规模数据集,表明其每个样本的质量更高。
下表比较了各种公开可用代码指令微调数据集的样本数量,范围从 2 万到 43.5 万个样本不等。OPENCODEINSTRUCT 是其中最大的数据集,包含 500 万个合成样本,这些样本来自多样化的种子集,包括 Python 函数和算法问题。该数据集利用可扩展的生成框架,结合 self-instruct 和 evol-instruct 方法,据报告,与现有替代方案相比,每个样本的指令质量更高。OPENCODEINSTRUCT 包含 500 万个样本,远超列出的其他数据集,其中最大的仅有 43.5 万个样本。该数据集使用了更大且更多样化的种子集,包括 143 万个 Python 函数和 25443 个算法问题,这与有限的种子方法不同。评估结果显示,使用 OPENCODEINSTRUCT 微调比使用 OSS-INSTRUCT 样本在基准上的代码生成性能提高了数个点。
下表显示了 TACO 数据集中多个竞争编程平台的算法问题分布。CodeForces 贡献了最大份额,其次是 CodeChef 和 GeeksForGeeks,表明平台多样性广泛。这种分布支持使用 TACO 作为多样化的种子集来生成合成编码指令。CodeForces 是代表最多的平台,提供的题目数量最多。数据集涵盖多个平台,包括 AIZU、AtCoder、Codewars 和 HackerEarth,确保了算法覆盖的多样性。多平台分布增强了用于指令微调的种子集多样性。
使用 OPENCODEINSTRUCT 微调 Llama3 和 Qwen2.5-Coder 模型,在函数级和库级编码基准上相较于其指令微调基线提升了性能。对于 Qwen2.5-Coder,增益显著,而较小的 Llama 模型在更复杂的 LiveCodeBench 任务上改进有限。经 OPENCODEINSTRUCT 微调的 Llama 模型在 HumanEval 和 MBPP 上获得大幅提升,但 LiveCodeBench 上仅小幅增加。使用 OPENCODEINSTRUCT 微调的 Qwen2.5-Coder 模型在所列每个基准上都优于其基线,尤其在 LiveCodeBench 上表现出强劲跳跃。微调后的 Qwen 模型也超越了 OpenCoder-1.5B-Instruct 基线,表明新数据集具有竞争性性能。
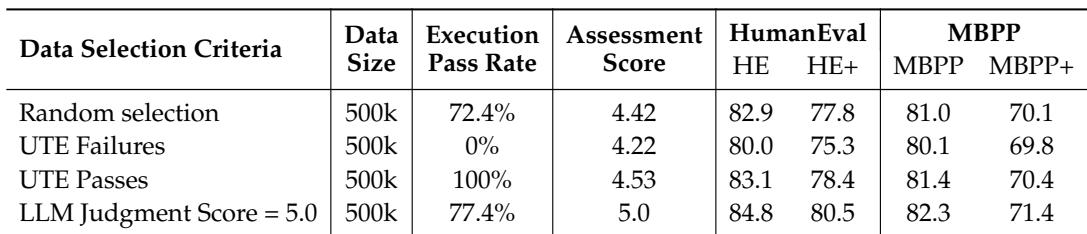
基于单元测试执行反馈和 LLM 判断分数过滤合成训练数据可改善 Qwen2.5-Coder-7B 的微调结果。选择通过单元测试或获得高 LLM 判断分数的样本,比随机选择能获得更好的代码生成性能,而排除未通过的样本则会降低结果。
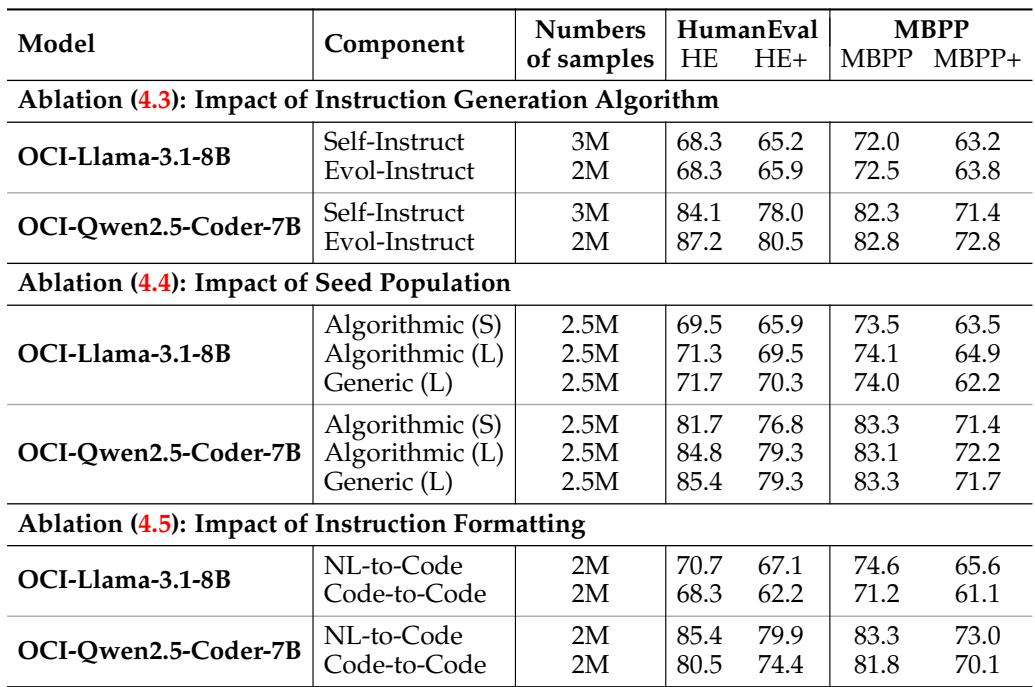
消融结果显示,两种指令生成算法均贡献了互补的优势,其中 Evol-Instruct 在测试的多个基准上对更强的基础模型通常表现更好。使用更大、更多样化的种子群体可带来显著收益,而将算法指令与通用指令结合可提升整体性能。此外,自然语言到代码的格式在所有评估基准上一致优于代码到代码的格式。Evol-Instruct 在若干基准上往往优于 Self-Instruct,尤其是对于基于 Qwen 的模型。具有多样化算法问题的大规模种子集相对于较小种子集带来了显著的性能改进。混合算法和通用种子指令相对于单独使用任一种都产生更佳结果,尽管在某些个别基准上性能相当。自然语言到代码的指令在所有测试的代码生成基准上显著胜过代码到代码的指令。
实验介绍了 OPENCODEINSTRUCT,一个包含 500 万个样本的合成代码指令数据集,构建于多样化的种子集,包括从 CodeForces 等平台获取的 143 万个 Python 函数和算法问题。使用该数据集微调语言模型,尤其是 Qwen2.5-Coder,在代码生成基准上优于基线,尤其在 LiveCodeBench 等基准上取得显著增益。基于单元测试执行和 LLM 判断分数过滤合成样本可进一步提升结果,而消融研究表明,Evol-Instruct、更大的种子集、混合算法和通用指令以及自然语言到代码的格式各自对更强结果有所贡献。