Command Palette
Search for a command to run...
EpiCoder:在代码生成中涵盖多样性与复杂性
EpiCoder:在代码生成中涵盖多样性与复杂性
EpiCoder-func-380k 代码生成数据集
摘要
现有的代码生成方法使用代码片段作为种子数据,限制了合成数据的复杂性和多样性。在本文中,我们引入了一种新颖的基于特征树的合成框架,该框架围绕从代码的高层抽象中获得的层次化代码特征展开。特征树从原始数据构建,并通过迭代细化来增加提取特征的数量和多样性,从而捕获和识别代码中更复杂的模式和关系。通过调整采样子树的深度和广度,我们的框架能够精确控制生成代码的复杂性,实现从函数级操作到多文件场景的功能。我们对广泛使用的基础模型进行了微调,得到了 EpiCoder 系列,在函数级和文件级的多个基准测试中均达到了最先进的性能。特别是,实证证据表明,我们的方法在合成仓库级代码数据方面展现出显著潜力。我们的代码和数据已公开可用。
一句话总结
来自清华大学和阿里巴巴等机构的研究者提出了EpiCoder,这是一个基于特征树的合成框架,通过构建层级化代码特征来增强生成代码的多样性和复杂度,实现从函数级到多文件场景的精确控制,微调后的基础模型在多个基准测试中取得了最先进的性能,在仓库级数据合成方面展现出巨大潜力。
核心贡献
- 论文提出了一种基于特征树的代码合成框架,将代码组织为从高层抽象派生的层级化特征,支持可控的指令数据生成,可调节的复杂度覆盖从函数级到多文件场景。
- 该框架用于合成433,000条指令数据样本用于微调,生成了EpiCoder模型系列;EpiCoder-Qwen-7B在多个函数级和文件级基准测试中取得了同等规模模型中最先进的结果,包括在BigCodeBench-Hard上相比Qwen2.5-Coder-7B-Instruct提升了7.4%。
- 对合成数据的进一步分析从特征视角展示了其在复杂度和多样性方面的优势,实证结果证明了该框架在扩展到仓库级代码合成方面的巨大潜力。
引言
大语言模型(LLMs)在代码理解和生成方面展现出强大的能力,但除非在高品质的指令数据上进行微调,否则其潜在的代码知识仍未得到充分利用,而微调是将模型与用户意图对齐、提升实际可用性的关键步骤。先前合成此类指令数据的方法大多依赖代码片段作为种子数据,但代码片段仅能捕捉特定功能,无法覆盖真实应用中常见的编程结构、模式和交互的全貌。这些片段的刚性也使其难以重新排列或重组为新的组合,限制了生成数据的多样性和复杂度。为突破这些限制,作者提出了一个受抽象语法树(ASTs)启发的基于特征树的代码数据合成框架。该框架提取变量类型、函数结构、控制流等语义代码特征,随后利用层次聚类构建捕捉代码元素间关系的树结构。这些树引导LLM从原始代码中提取结构,作者通过迭代扩展树的宽度和深度来增强特征多样性。这种设计通过调整子树深度和宽度实现可控复杂度,并通过调整代表性不足知识区域的采样概率实现有针对性的学习。作者在Qwen2.5-Coder-7B-Base和DeepSeek-Coder-6.7B-Base模型上训练验证了该方法,生成了EpiCoder系列模型,在同等规模模型的函数级和文件级基准测试中取得了最先进的性能。
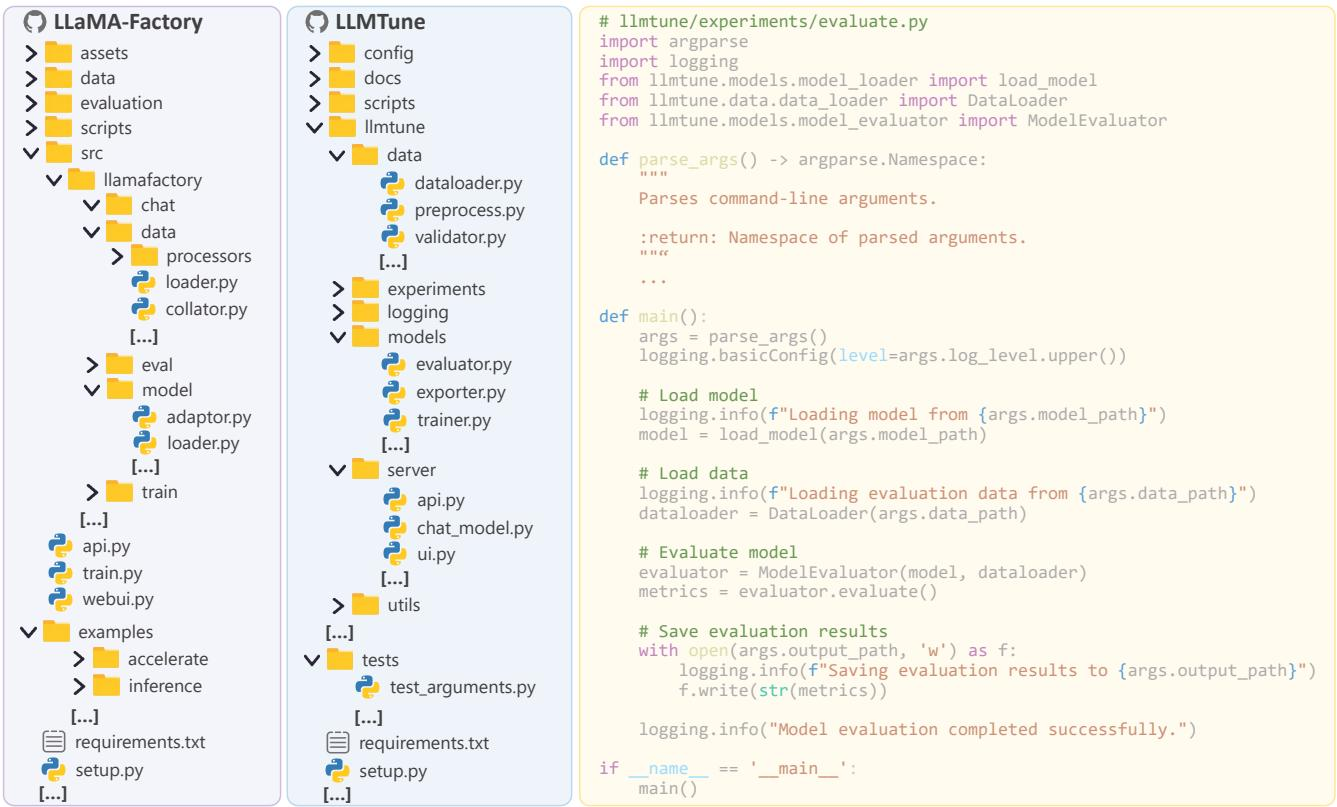
数据集

作者构建了一个数据集,通过从代码中提取层级化特征树,采用结合公共代码语料库、基于嵌入的选择和LLM驱动结构化的流水线。
- 主要来源:种子数据取自The Stack v2,这是一个常用于预训练代码LLM的大规模公共数据集。为确保多样性和覆盖率,作者在由roberta-large-v1编码的代码嵌入上应用KCenterGreedy算法,选择了一组具有代表性的核心样本。
- 树演示构建:使用强大的LLM(具体为GPT-4o)从种子数据中提取特征。由于初始提示对输出质量影响很大,作者提出了一种迭代方法来优化提示中的演示树结构。这分两步进行:
- 特征预提取:使用草稿提示,LLM从种子数据中提取初始的特征关键词集合。
- 迭代演示生成:LLM对特征集的子集执行层次聚类,生成捕捉特征间关系的树结构。该树经过多次迭代优化,确保形成组织良好的层级结构。
- 特征树提取:利用优化后的演示,LLM为每个代码片段提取树状结构化特征表示。然后将这些单独的树合并为一个统一的结构,整合所有样本的特征。合并过程中,作者记录了每个节点的频率,反映种子数据中特征的分布。
- 模型中的应用:由于种子数据来自预训练语料库,记录的节点频率可作为预训练模型中知识分布的近似度量。该频率信息用于指导数据集的应用方式,例如确定训练中的混合比例或加权。作者不仅使用原始代码,还将其转换为基于树的语义表示,捕捉比普通语法树更深的关联。
方法
作者提出了一个基于特征树的代码生成框架,旨在生成多样且复杂的代码指令数据。该框架通过三个阶段流水线运作:特征树提取、特征树演化以及基于特征树的代码生成。参考框架图可直观了解这些组件。
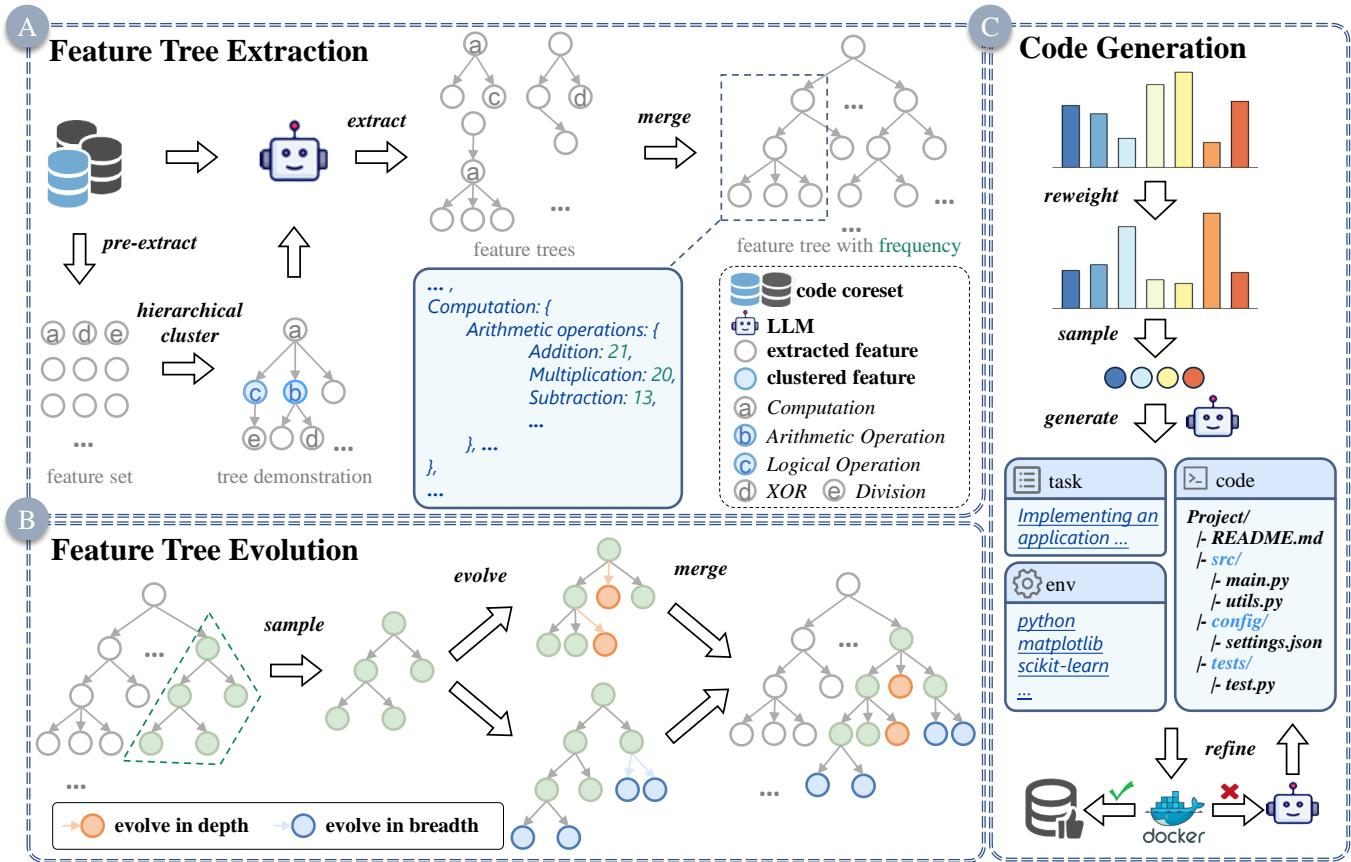
流程始于特征树提取。为确保数据多样性,作者从The Stack v2收集种子数据,并应用KCenterGreedy算法基于代码嵌入选择核心样本集。随后利用LLM提取代码元素的层级化表示。为有效引导LLM,迭代构建树演示。这涉及预提取初始特征集、执行层次聚类将其组织为树结构,并基于该结构优化提示。演示优化后,LLM从种子数据中提取特征树。这些单独的树被合并为一个全面的结构,并记录每个节点的频率以反映特征分布。
接下来,框架采用特征树演化来克服特征多样性和数量方面的局限。每次迭代中,从完整特征树中采样一个子树。该子树由LLM沿两个维度演化:深度和广度。深度演化涉及向现有节点添加更细粒度的子节点,广度演化则在相同层级添加兄弟节点。这些新演化的子树被合并回整体结构。对于新生成的特征,其频率估计为其兄弟节点的平均频率,确保无缝集成到更广泛的特征分布中。
最后,基于特征树的代码生成模块利用演化后的树来合成代码。为防止模型过度关注高频但简单的特征,使用温度参数 t 对节点子特征的概率分布重新加权。子特征 i 的调整后概率 pi′ 计算公式为:
pi′=∑j∈Cexp(logpj/t)exp(logpi/t)其中 pi 是归一化的原始频率,C 是子节点集合。然后基于这些调整后的概率采样子树。LLM利用采样的子树生成任务、相应的代码以及执行环境。生成的代码可以是单个函数到多文件项目。为确保质量,该过程包含一个迭代优化步骤,其中生成测试文件并在隔离环境中执行。执行结果的反馈用于引导LLM优化解决方案代码。
实验
实验评估了在通过特征树方法生成的合成数据上训练的EpiCoder模型,涵盖函数级、文件级和潜在的仓库级代码生成。函数级基准测试显示在同等规模模型中具有最先进的平均性能,而自定义的XFileDep基准测试展示了在跨文件依赖处理方面强大的文件级生成能力。进一步分析显示,合成数据在代码复杂度和特征多样性方面超过了现有数据集,在匹配数据量的比较中证实了演化数据增强策略的质量和泛化优势。
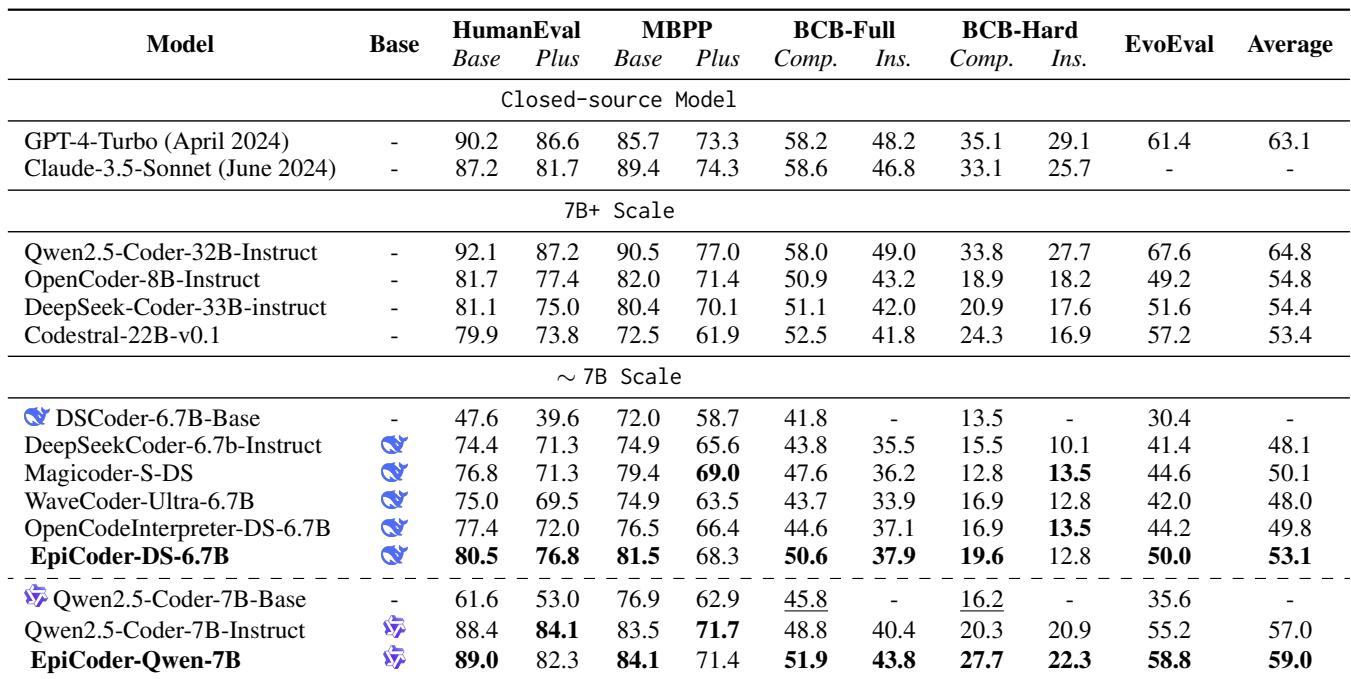
该表格比较了多个编码基准测试中的Pass@1准确率,包括HumanEval、MBPP和BigCodeBench,涵盖闭源和开源LLM。EpiCoder-Qwen-7B在同等规模模型中取得了最先进的平均性能,证明了基于特征树的合成数据在函数级代码生成中的有效性。结果还表明,许多模型在BigCodeBench-Hard等更难的子集上表现低于完整子集。EpiCoder-Qwen-7B在评估的基准测试中平均优于其他同规模模型。GPT-4-Turbo和Claude-3.5-Sonnet等闭源模型表现强劲,但并不始终优于最佳开源模型。所有模型在BigCodeBench的Hard子集上的得分明显低于Full子集,表明任务难度增加。基于特征树的合成数据方法有助于提升复杂编程任务的性能。
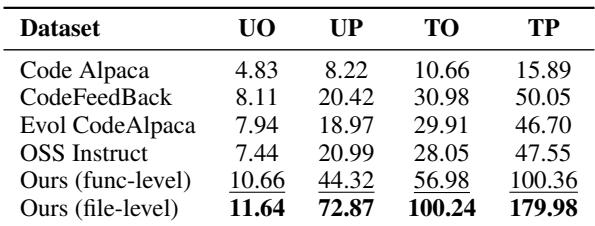
所提出的代码数据集相比现有代码库展现出显著更高的Halstead复杂度,在唯一和总操作符/操作数计数方面都有显著提升。文件级数据进一步放大了这些差异,表明代码合成更加复杂精密。函数级数据在唯一操作符方面超越第二名2.55,在唯一操作数方面超越20.99。文件级指标超过函数级值,在所有Halstead维度上显示出更大的复杂度。所提出数据集的总操作符和操作数计数接近最接近基线的两倍。
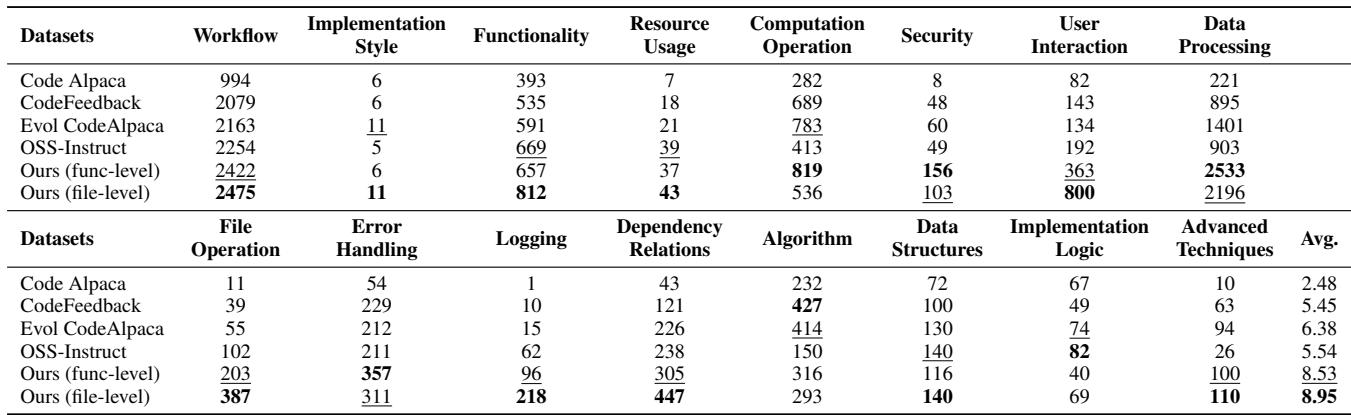
所提出的数据集展现出比现有代码数据集更高的特征多样性,函数级平均唯一特征为8.53,文件级为8.95,以显著优势超越最接近的竞争者。函数级数据在数据处理、错误处理、依赖关系和用户交互等领域表现出特别的优势,计数是其他数据集的2到3倍。函数级和文件级的特征计数均超过所有对比数据集,其中用户交互和数据处理方面的增长最大。错误处理、依赖关系和用户交互特征的出现频率约为现有代码库的2到3倍。文件级数据展现出比函数级数据更强的多样性,尤其在用户交互和数据处理特征方面。
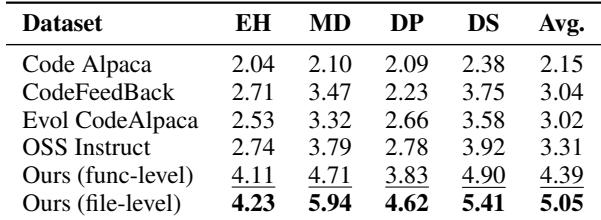
所提出的方法在所有四个评估维度上生成的代码复杂度均显著高于现有数据集,文件级代码取得了最高的平均得分。函数级代码也优于所有基线,在错误处理、模块化、依赖关系和数据结构复杂度方面表现出一致的提升。文件级代码实现了最高的平均复杂度得分,主要得益于模块化和数据结构复杂度方面的大幅提升。函数级代码相比最强基线的平均复杂度提高了32.6%,文件级提高了52.5%。所提出的方法在所有单独维度上相比现有数据集得分最高,包括错误处理和依赖管理。
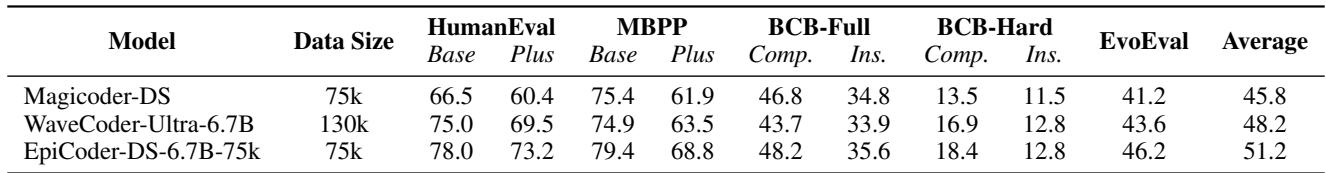
EpiCoder-DS-6.7B-Sample75k在函数级基准测试中展现出优于Magicoder-DS和WaveCoder-Ultra-6.7B的性能,同时使用相同或更少的训练数据。它取得了更高的平均Pass@1得分,在多个任务上表现显著提升。这表明数据质量在数据量之外发挥着关键作用。平均性能比Magicoder-DS和WaveCoder-Ultra-6.7B分别高出5.4%和3.0%。尽管使用75k样本(对比最高达130k),在HumanEval、MBPP和BCB基准测试上仍优于基线。在多个基准测试的补全和指令任务上展现出持续改进。
实验评估了EpiCoder相对于现有模型和数据集的代码生成能力。EpiCoder模型在编码基准测试中取得了同等规模开源模型中最先进的平均Pass@1准确率,但所有模型在更难的子集上仍面临挑战。所提出的合成数据集相比基线展现出显著更高的代码复杂度、特征多样性和整体复杂度,其中文件级数据超越了函数级数据。最后,EpiCoder在使用更少训练数据的情况下在函数级基准测试中优于基线,表明数据质量而非仅仅是数据量驱动着性能提升。