Command Palette
Search for a command to run...
MMLU-CF:一个无污染的多任务语言理解基准
MMLU-CF:一个无污染的多任务语言理解基准
MMLU-CF 无污染多任务语言理解基准数据集
摘要
像大规模多任务语言理解(MMLU)这样的多项选择题(MCQ)数据集广泛用于评估大型语言模型(LLM)的常识、理解和问题解决能力。然而,这些基准的开源性质以及LLM训练数据的广泛来源不可避免地导致了基准污染,从而产生不可靠的评估结果。为缓解这一问题,我们提出了一个无污染且更具挑战性的MCQ基准,称为MMLU-CF。该基准通过避免无意和恶意的数据泄漏,重新评估LLM对世界知识的理解。为避免无意数据泄漏,我们从更广泛的领域获取数据,并设计了三条去污规则。为防止恶意数据泄漏,我们将基准划分为难度和主题分布相似的验证集和测试集。测试集保持闭源以确保结果可靠,而验证集公开可用,以促进透明度并便于独立验证。我们对主流LLM的评估显示,强大的GPT-4o在测试集上仅获得5-shot分数73.4%和0-shot分数71.9%,这表明我们的方法在创建更严格且无污染的评估标准方面的有效性。
一句话总结
微软研究院推出 MMLU-CF,这是一个无污染的多任务语言理解基准,通过更广泛的数据来源、三条去污染规则和闭源测试集,同时缓解无意和恶意的数据泄漏。GPT-4o 在该基准上仅取得 73.4%(5-shot)和 71.9%(0-shot)的成绩,从而建立了更严格、更可靠的评估标准。
核心贡献
- 论文提出了 MMLU-CF,这是一个无污染的多选题基准,区分了无意和恶意的数据泄漏,并通过从更广泛的领域获取题目以及应用三条专门的去污染规则来缓解前者。
- 该基准分为验证集和测试集,两者在难度和主题分布上相匹配,其中测试集保持闭源以防止恶意泄漏,验证集则公开发布以支持透明性和独立验证。
- 评估结果显示,所测最强模型 GPT-4o 在 5-shot 设置下仅达到 73.4% 的准确率,在 0-shot 设置下为 71.9%,远低于其在 MMLU 上的 88.0% 成绩,这表明 MMLU-CF 提供了更严格且更具抗污染能力的评估标准。
引言
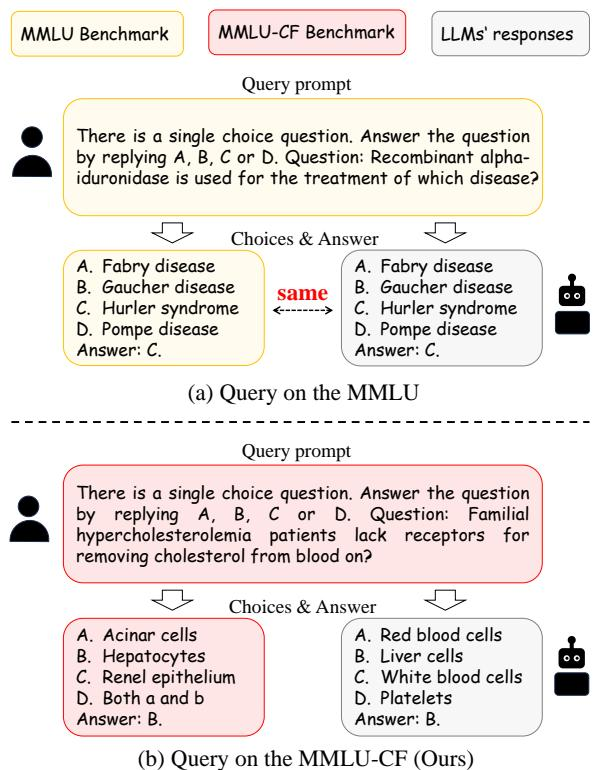
评估大型语言模型(LLM)至关重要,因为 GPT-4、Llama、Gemini 和 Claude-3 等模型的能力不断增强,而 MMLU 已成为衡量跨学科世界知识的标准多选题基准。然而,基准污染削弱了评估的可靠性:模型可能在训练期间遇到测试数据,要么通过公开暴露无意遇到,要么在基准被加入训练集时恶意遇到,导致模型记住题目并直接回忆出确切的选项和答案。作者提出 MMLU-CF,这是一个无污染的多选题基准,通过五个处理步骤构建,包括三条保持语义但对人类可理解的题目改写规则以破坏记忆性回忆,以及一个防止恶意泄漏的闭源测试集和一个用于透明性的开放验证集。他们的结果表明,领先模型在 MMLU-CF 上的得分明显低于在 MMLU 上的得分,GPT-4o 从 88.0% 降至 73.4%,这证实了先前的基准可能高估了模型知识,并凸显了构建公平、无污染评估的挑战。
数据集
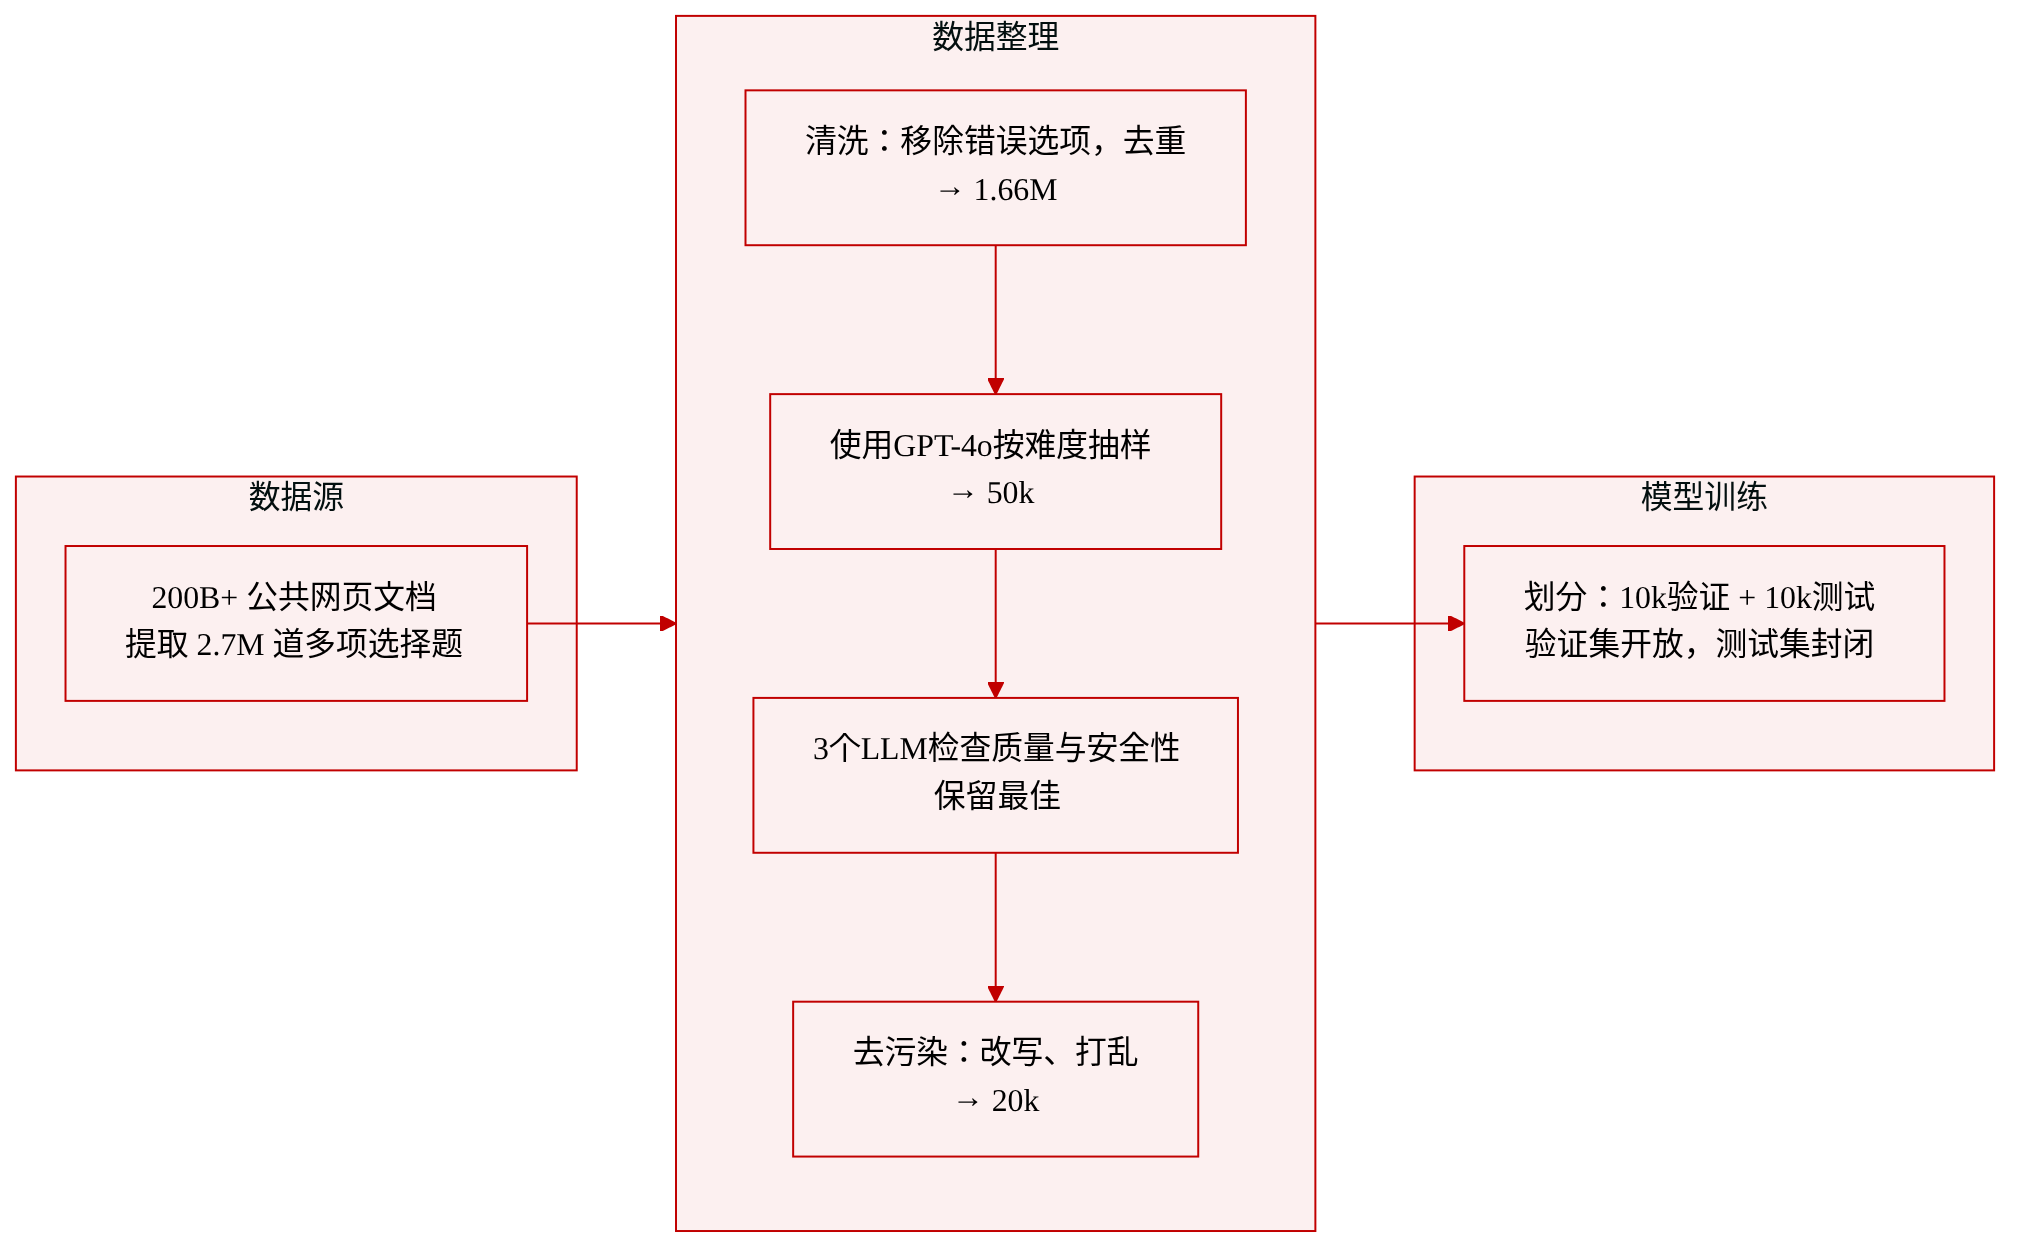
作者从公开网络数据构建了 MMLU-CF 基准。以下是数据集的构建和使用方式:
-
来源与规模:作者筛选了来自公开开放网站的超过 2000 亿份文档。通过基于规则的提取,从超过 3000 个域名收集了 270 万个原始多选题,涵盖 14 个领域(健康、数学、物理、商业、化学、哲学、法律、工程等)。
-
清洗与过滤:收集原始题目后,应用多步骤清洗流程。这包括移除没有恰好四个选项的题目、删除空白选项、将标签标准化为 A/B/C/D、将标签转换为大写、相应调整答案、移除过短的题目(少于 10 个字符)、标准化答案格式、去除编号和罗马数字、移除非英文或小写开头的字符,以及去重。这将数据缩减到 166 万个题目。
-
难度采样:由于 MMLU 等现有基准对前沿模型而言已过于简单,作者使用 GPT-4o 分配难度等级(按一定标准,以 MMLU 题目为参考)。随后从 166 万个清洗后的题目中,以中等难度级别为中心的正态分布进行采样,同时平衡类别分布、最大化领域多样性,并优先选择带解释的题目。这产生了 50,000 个题目。
-
LLM 审查:50,000 个题目由三个不同的 LLM(GPT-4o、Gemini 和 Claude)进行质量(上下文清晰度、逻辑一致性、事实准确性、互斥性、正确答案存在性)和无害性(无不敬内容、性内容、自残或暴力)审查。每个模型按一定标准对题目评分,只有平均得分高于阈值的题目被保留。作者还进行了冗余检测(使用 GPT-4o)以移除语义相同的题目。
-
去污染处理:为防止记忆泄漏,应用三条规则:
- 改写每个题目以减少对训练数据的依赖。
- 打乱选项顺序(如果最后一个选项是"以上都不是"或"以上都正确",仅打乱前三个选项)。
- 以 50% 的概率,随机将一个选项替换为"其他选项都不正确"。如果正确选项被替换,它仍然有效;如果错误选项被替换,它充当干扰项。
-
最终划分与使用:去污染处理后,数据被分为 10,000 个验证题和 10,000 个测试题,两者在难度和类别分布上相似。验证集以开源方式发布以保证透明性,而测试集保持闭源以防止恶意暴露。作者使用这些集合评估 LLM 性能,重点关注推理和理解能力而非记忆能力。
方法
作者提出了一个构建 MMLU-CF 基准的综合流程,旨在缓解数据污染并解决现有基准的难度饱和问题。该流程始于 多选题收集 阶段,团队利用来自公开开源网站的超过 2000 亿份文档提取了 270 万个原始多选题。这一庞大语料库涵盖超过 3000 个域名和 14 个领域,确保了内容的多样性。
接下来,多选题清洗 阶段应用严格的过滤。题目被筛选为恰好有四个选项,移除内容为空或标签不标准(A、B、C、D)的题目。流程标准化格式、强制执行 10 个字符的最小长度、去除冗余编号并去重,将规模缩减至 166 万个题目。
为解决当前基准的难度瓶颈,作者实施了 难度采样 策略。首先使用 GPT-4o 对原始 MMLU 数据的难度进行分类。如难度分布图所示,原始 MMLU 数据包含大量简单题目,这导致了现代 LLM 的高准确率。
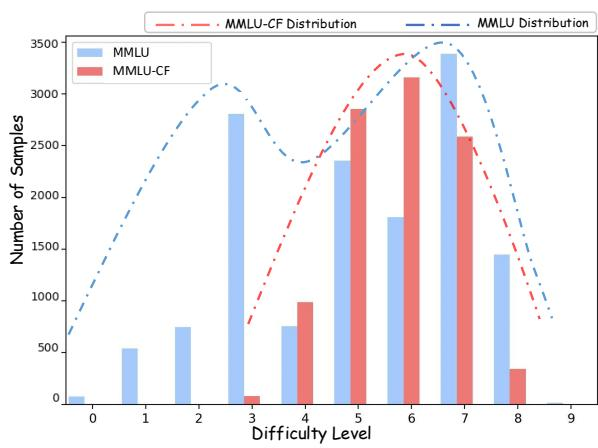
以这些难度等级为参考,作者对 GPT-4o 进行了 5-shot 查询,以对 166 万个清洗后的题目进行难度分类。随后以较高难度级别为中心的正态分布采样题目,以确保基准更具挑战性。这一采样过程还旨在保持领域多样性和类别平衡,将数据集缩减至 50,000 个题目。
采样之后,进行了 LLM 检查 阶段,以确保质量和无害性。使用三个模型(GPT-4o、Gemini 和 Claude)根据上下文清晰度、逻辑一致性、事实准确性和选项互斥性等标准评估题目。此外,还对内容进行了有害元素筛查,包括仇恨言论、性内容、自残和暴力。选择平均质量得分高于阈值的题目。使用 GPT-4o 进行冗余检测以移除语义相同的题目。
最后,为防止因记忆效应导致的性能膨胀,作者实施了 无污染处理 模块。如下图所示,该模块对所选题目应用三条特定的转换规则。
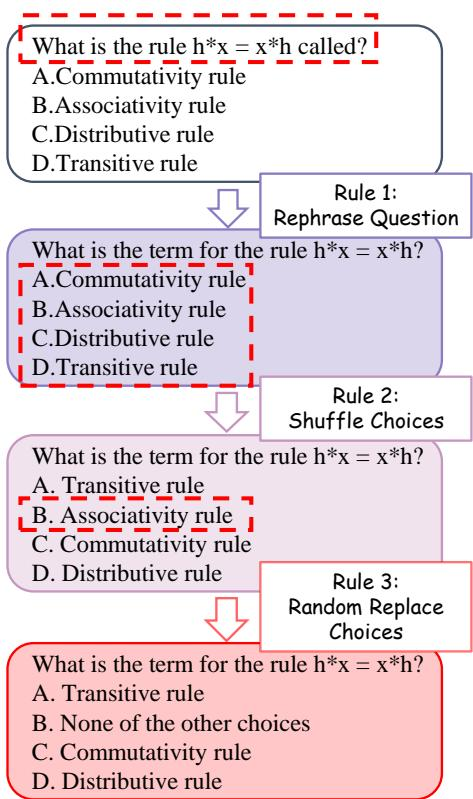
首先,改写题目 规则重写题目主干以减少对先前遇到的训练数据的依赖。其次,打乱选项 规则随机化选项顺序,防止模型依赖记忆的选项序列,同时保留"以上都不是"等选项(如果它们出现在最后)。第三,随机替换选项 规则以 50% 的概率将其中一个选项替换为"其他选项都不正确"。这一修改迫使模型进行更深层次的推理而非简单的模式匹配,因为正确答案必须在新上下文中仍然有效。最终数据集被分为 10,000 个验证题和 10,000 个测试题,测试集保持闭源以防止污染。
实验
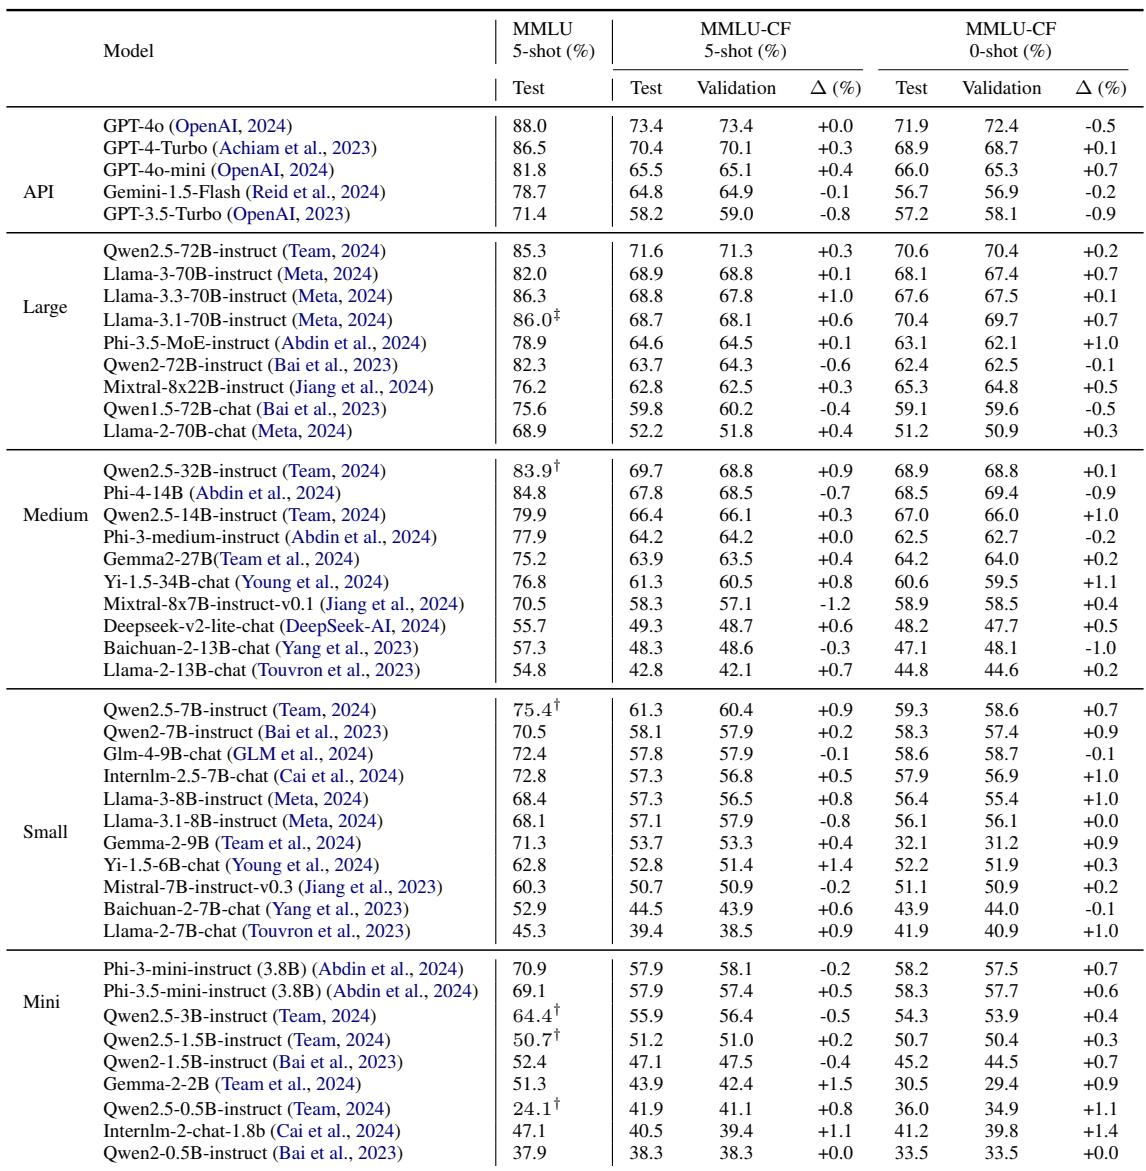
MMLU-CF 基准通过严格的流程构建,包括收集、清洗、难度采样、LLM 检查和去污染处理,产生了多样化的测试和验证题目。对超过 40 个模型的评估显示,GPT-4o 总体领先,而 Qwen2.5 系列变体在各模型规模中表现优异,验证集划分与 delta 得分有效监控了潜在的数据泄漏。对去污染规则的消融研究表明,改写、打乱和替换选项显著降低了模型性能,证实了这些规则在缓解记忆效应和强制执行基于推理的评估方面的成功。
GPT-4o 在 MMLU-CF 测试集上于 5-shot 和 0-shot 设置下均取得最高分,而 Qwen2.5-72B-instruct 在开源权重大型模型中领先。测试和验证结果高度一致,大多数绝对差异低于 0.5 个百分点,表明验证集可靠地反映了模型的泛化能力。GPT-4o 在 MMLU-CF 上超越所有其他模型,在测试集上 5-shot 得分为 73.4%,0-shot 得分为 71.9%。在各类模型中,约 60% 的测试集与验证集绝对得分差异低于 0.5,96% 低于 1.0。Qwen2.5-72B-instruct 是最强的开源权重大型模型,在 5-shot 下达到 71.6%,并显示出轻微的测试-验证正向差异。
对 MMLU-CF 测试集应用去污染规则一致地降低了所有被测试 LLM 的模型性能。随着应用更多规则,性能下降变得更为明显,当三条规则组合应用时下降幅度最大。较小的模型似乎对这些修改更为敏感,表现出相对更大的性能损失。单独改写题目仅在所有模型中引起轻微的性能下降。添加选项打乱和随机替换导致更显著的下降,尤其是当三条规则组合应用时。GPT-3.5-Turbo 和 Llama-3.1-8b 的性能下降更为明显,表明较小的模型受这些去污染规则的影响更大。
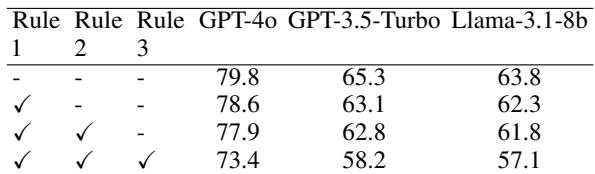
在 MMLU-CF 基准上的评估中,GPT-4o 在 5-shot 和 0-shot 设置下均取得最高准确率,而 Qwen2.5-72B-instruct 在开源权重模型中领先,测试和验证结果高度一致。应用去污染规则一致地降低模型性能,且随着更多规则组合应用效果增强;题目改写仅造成轻微下降,而添加选项打乱和随机替换导致更大下降,尤其是对 GPT-3.5-Turbo 和 Llama-3.1-8b 等较小模型。