Command Palette
Search for a command to run...
迈向混合整数线性规划的基座模型
迈向混合整数线性规划的基座模型
Sirui Li Janardhan Kulkarni Ishai Menache Cathy Wu Beibin Li
MILP-Evolve 混合整数线性规划数据集
摘要
混合整数线性规划(MILP)对于建模复杂决策问题至关重要,但在计算可处理性和可解释性方面面临挑战。当前的深度学习方法针对特定问题类别,且无法泛化到未见过的类别。为解决这一不足,我们采用基座模型训练方法,即在多样化的 MILP 问题上训练单一深度学习模型,以跨问题类别进行泛化。由于现有的 MILP 数据集缺乏多样性和规模,我们引入了 MILP-Evolve,一个基于 LLM 的新型进化框架,能够生成大量多样化的 MILP 类别及无限数量的实例。我们在三个关键学习任务上研究了我们的方法,这些任务涵盖了 MILP 的多个方面:(1)整数间隙预测,(2)学习分支,以及(3)将 MILP 实例与自然语言描述对齐的新任务。我们的实验结果表明,在 MILP-Evolve 生成的数据上训练的模型在未见问题上取得了显著改进,包括 MIPLIB 基准。我们的工作凸显了迈向 MILP 基座模型方法的潜力,该方法能够泛化到广泛的 MILP 问题类别。我们的代码和数据公开发布在 https://github.com/microsoft/OptiGuide。
一句话总结
来自麻省理工学院和微软研究院的研究人员提出了一种用于Mixed Integer Linear Programming(MILP)的基础模型方法,引入了基于LLM的进化框架MILP-Evolve,用于生成多样化的MILP问题类别和实例,并展示了在未见问题(包括MIPLIB基准)上的显著泛化提升,涵盖整数性间隙预测、学习分支和自然语言对齐任务。
核心贡献
- 本文提出了MILP-Evolve,一个基于大语言模型的进化框架,能够生成大量多样化的MILP问题类别,并支持无限数量的实例,直接解决了现有MILP数据集在多样性和规模上的局限。
- 这项工作采用了MILP的基础模型训练方法,在多样化的MILP问题集合上训练单个深度学习模型,以泛化到未见的问题类别,这与以往构建特定类别模型的方法不同。
- 该方法的有效性在三个学习任务上得到验证:整数性间隙预测、学习分支,以及将MILP实例与自然语言描述对齐。结果表明,在未见问题(包括MIPLIB基准)上取得了显著改进。
引言
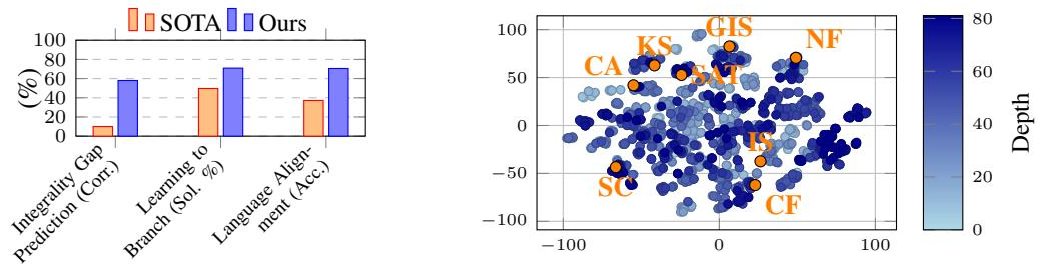
混合整数线性规划(MILP)是一种基础优化框架,广泛应用于医疗、供应链、能源和金融领域。然而,MILP面临两大主要限制:由于NP困难性,求解问题计算强度大;理解其数学公式需要深厚专业知识,限制了可访问性。研究人员尝试应用机器学习来加速求解器,但这些模型通常针对特定问题类别(如集合覆盖或设施选址)进行训练,难以泛化到未见或更复杂的MILP公式。这种泛化能力的缺乏,加上多样化、大规模MILP训练数据的稀缺,与计算机视觉和自然语言处理领域形成鲜明对比,在这些领域中,基于海量数据训练的基础模型能够广泛适应。为了应对这些挑战,作者提出了首个用于MILP的基础模型训练方法。他们引入了MILP-Evolve,这是一个可扩展的数据生成流水线,利用大语言模型从少数种子示例中创建超过一千个多样化的MILP问题类别,并在此广泛类别集合上联合训练单个图神经网络。该框架在三个任务上进行了评估:整数性间隙预测、学习分支,以及一个用于可解释性的新型MILP到文本对齐任务。结果显示,与先前工作相比有显著提升,包括整数性间隙预测的相关系数提高5.8倍,学习分支的求解到最优比率提高1.42倍,同时表明训练数据的多样性比单纯的数据量更为重要。
数据集
数据集组成与来源
-
数据集是MILP问题类别的集合,每个类别表示为模块化的优化代码脚本。每个脚本包含三个核心函数:
- 数据:生成目标函数和约束的系数,通常来自均匀分布或常见图结构。
- 优化建模:定义决策变量、约束和目标函数。
- 参数:指定问题特定参数,如节点数量或图密度。
-
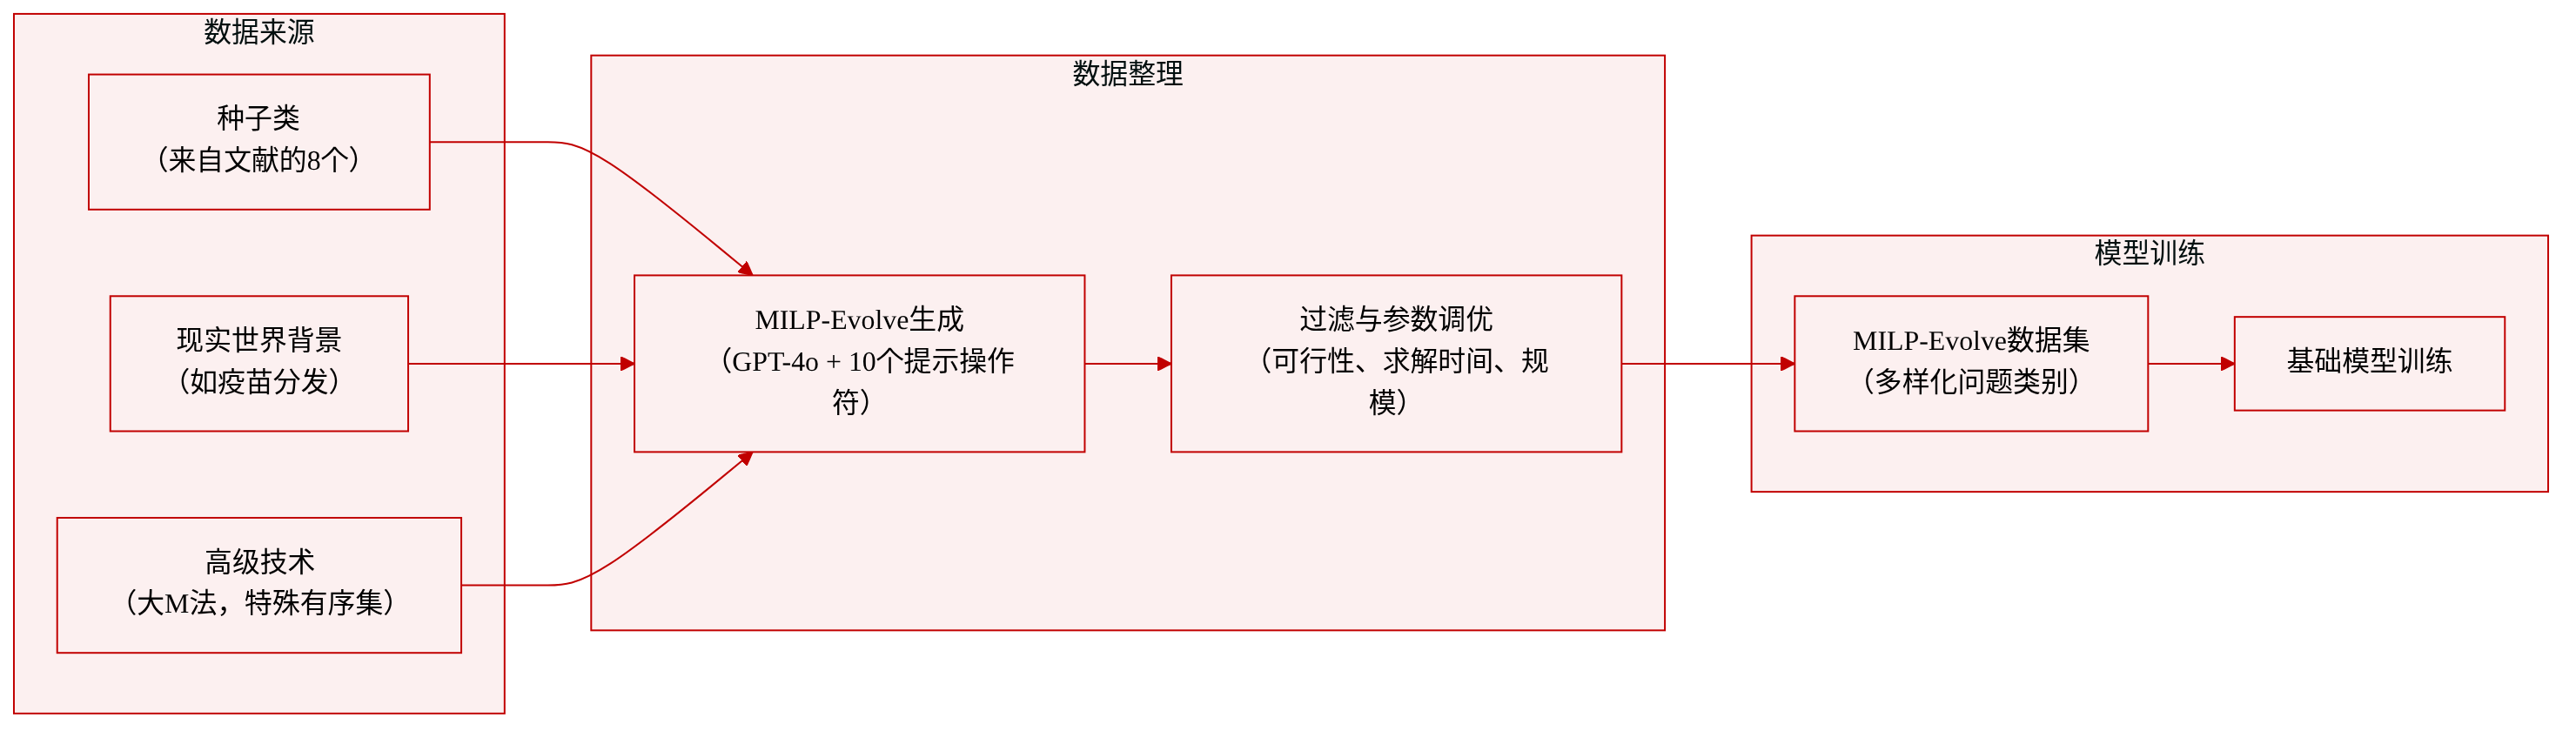
作者从先前文献中精选了8个种子MILP类别作为起点,用于生成更大且更多样化的问题类别集合。
MILP-Evolve生成的类别
- 使用GPT-4o作为LLM,作者应用名为MILP-Evolve的流水线,通过迭代变换生成新类别。该流水线在每次迭代中应用10个思维链提示算子,随机选择子集并依次对先前进化的类别进行调用。
- 提示算子覆盖的操作包括:
- 添加或删除约束、变量或相关数据。
- 交叉两个类别。
- 变异约束和/或目标。
- 创建全新类别。
- 每个提示算子遵循三模块结构:(1)总结给定的MILP类别,(2)根据算子类型描述如何修改,(3)按照表示标准生成新类别。
- 为了提升多样性和现实性,LLM被引导将MILP问题嵌入现实世界背景中,例如“制药公司规划跨国家疫苗分配,包含存储、运输和需求约束”。作者还提示LLM使用高级建模技术,如大M法、特殊有序集和对称性破缺,使生成的实例在技术上具有挑战性。
过滤与质量控制
- 每轮生成后,作者应用过滤步骤以确保生成的类别在数学上可行且实际中有用。模块化表示便于识别和调整关键参数,以实现所需属性,包括可行性、适当的求解时间和合理的问题规模。
数据使用方式
- 生成的类别被添加到MILP-Evolve数据集中,该数据集旨在支持MILP的基础模型方法。数据集的多样性是核心设计目标,超越了先前研究中典型的狭窄类别集合。
- 论文报告称,与早期工作使用的数据集相比,所得数据集显著更多样化。文本未指定生成类别的训练划分或混合比例;重点在于生成流水线和为下游使用准备类别的过滤过程。
方法
作者提出了一个综合框架,将数据合成流水线与多任务学习架构相结合,以增强混合整数线性规划(MILP)求解器。参考框架图
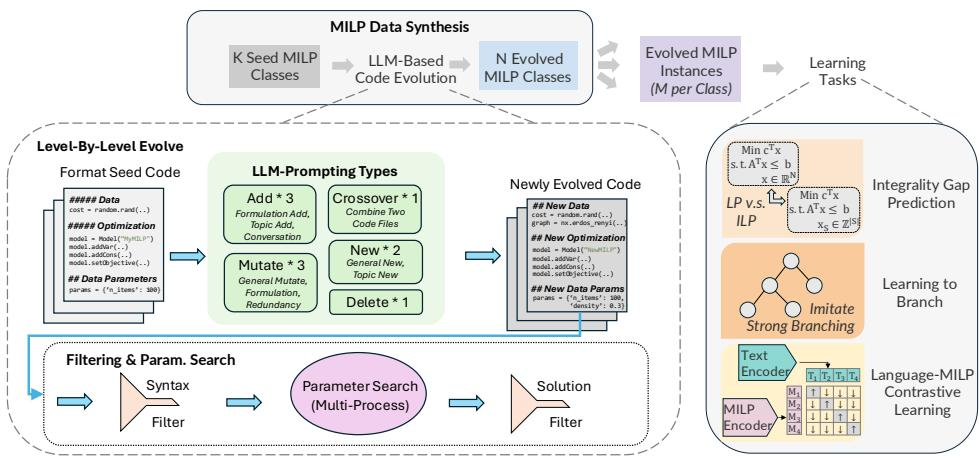
该系统分为两个主要部分:用于生成多样化训练数据的MILP-Evolve流水线,以及针对特定优化任务设计的学习架构。
MILP-Evolve:基于LLM的数据合成 为了解决现有MILP数据集多样性不足的问题,作者引入了MILP-Evolve,一个利用大语言模型(LLMs)生成新问题类别的进化流水线。该过程从一组精选的种子类别开始,通常表示为模块化的优化代码脚本,包含数据生成、优化建模和参数定义。
进化过程使用一组思维链提示算子,顺序应用于种子类别。这些算子包括添加约束或变量、变异目标、交叉不同类别以及创建全新主题。为了确保现实性,LLM被提示整合现实世界背景和高级建模技术。如下图所示:
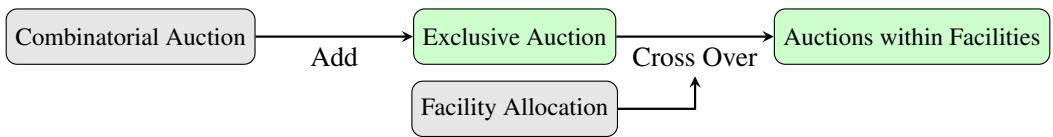
该图展示了一个进化链,初始组合拍卖问题通过添加约束进行修改,然后与设施分配问题交叉,创建一个新的、更复杂的实例。
生成后,严格的过滤过程确保实例的数学可行性和实用性。这包括语法过滤器以检查代码正确性,参数搜索模块以调整问题属性(如密度和大小),以及求解过滤器以验证实例能在合理时间范围内求解。
学习架构与任务 生成的MILP实例作为神经网络的输入,用于从数据中学习。每个MILP实例表示为连接变量节点和约束节点的二部图。
该架构采用图卷积网络(GCN)嵌入这些节点,捕获局部结构模式。为了处理全局依赖关系,对子采样节点集合应用注意力机制,包括聚合嵌入和摘要节点。这种GCN-注意力结构用于整数性间隙预测任务以及语言-MILP对比学习任务中的MILP编码器。对于后者,MILP嵌入与NV-Embed-v1模型生成的文本嵌入通过对称交叉熵损失对齐,类似于CLIP框架。
对于学习分支任务,架构被简化以减少推理时的计算开销。模型直接利用GCN生成的变量嵌入来预测分支定界树每个节点上的最优分支变量,最小化与专家强分支动作的交叉熵损失。
实验
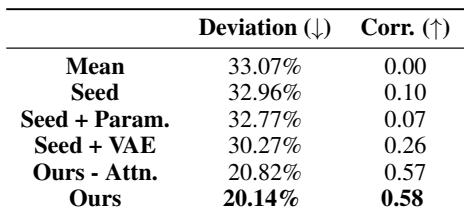
实验在域外设置中评估三个学习任务(整数性间隙预测、学习分支和对比语言对齐),其中单个模型在MILP-Evolve生成的多样化MILP类别上训练,并通过迁移学习在保留的MILP-Evolve类别和MIPLIB上进行测试。在MILP-Evolve上训练的模型始终优于使用较少或增强类别训练的基线,注意力机制显著提升性能,而扩展训练类别数量远比增加实例量更重要。在MIPLIB上,使用MILP-Evolve预训练相比从零开始训练或使用实例增强方法,收敛更快且微调效果更好。学习分支仍然是最具挑战性的任务,特别是在多类别设置中,由于可求解实例过少,在MIPLIB上被省略。
所提出方法在保留的MILP-Evolve测试集上,三个学习任务均始终优于所有基线方法。训练数据中的类别多样性被证明比实例数量更关键,注意力机制对性能提升贡献显著。学习分支任务在此多类别设置中仍然最具挑战性。该方法在所有基线上表现出色,包括基于种子和数据增强的变体。移除注意力机制导致性能明显下降,凸显其重要性。扩展训练类别多样性比增加实例数量对泛化更重要。学习分支任务在不同MILP类别中仍然困难,表明未来工作仍有空间。
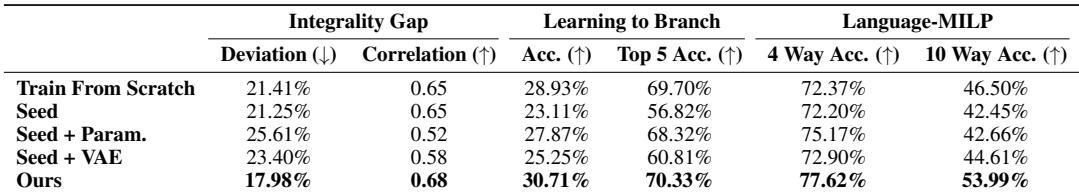
在由六个未见种子类别导出的MILP-Evolve测试集上,使用所提出的预训练模型初始化,在所有评估任务上取得最佳迁移学习性能。该模型始终优于从零开始训练和其他基线,特别是在降低整数性间隙和改进分支预测准确性方面。所提出的预训练方法在未见测试集上实现了最低的整数性间隙和最高的相关系数。在多个指标(包括top-5和10-way准确性)上,分支预测准确性也达到最优。结果强调了多样化预训练类别对于有效泛化到新问题分布的重要性。
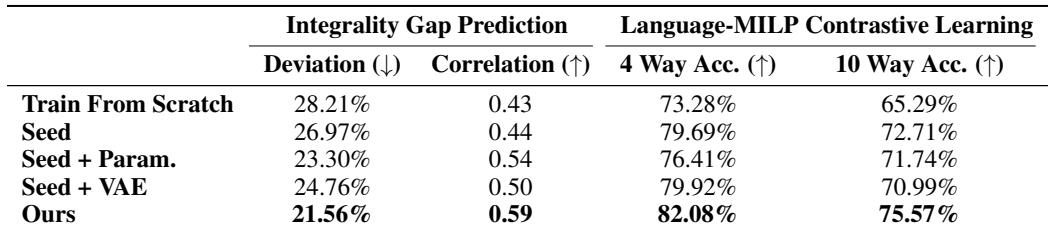
在MIPLIB迁移学习基准上,使用所提出的预训练模型初始化,在间隙预测和对比学习任务上均取得最佳性能。在多样化数据集上预训练始终优于从零开始训练,实例增强方法相比所提出的方法仅提供有限改进。所提出的预训练模型在整数性间隙预测中实现最低偏差,在对比学习中实现最高相关性和准确性。从多样化数据集预训练提高了相对于从零开始训练的迁移性能。VAE和参数搜索等实例增强基线提供增量改进,但仍然不如所提出的方法。
所提出方法在多个MILP基准上始终优于所有基线,在多样化类别上预训练被证明比实例数量或增强更关键。注意力机制至关重要,其移除导致明显性能下降,而学习分支在多样化MILP类别中仍然是最具挑战性的任务。