Command Palette
Search for a command to run...
EUREKA:评估与理解大型基础模型
EUREKA:评估与理解大型基础模型
Vidhisha Balachandran Jingya Chen Neel Joshi Besmira Nushi Hamid Palangi Eduardo Salinas Vibhav Vineet James Woffinden-Luey Safoora Yousefi
Eureka Bench Logs 评测日志数据集
摘要
对大型基础模型进行严谨且可复现的评估,对于评估当前技术水平、指导模型改进的后续步骤以及推动人工智能(AI)的科学进步至关重要。评估对于指导越来越多的基于基础模型构建服务的应用开发者同样重要。然而,由于多种原因,评估过程在实践中已变得具有挑战性,需要社区立即关注,这些原因包括基准饱和、所用测量方法缺乏透明度、为生成任务提取正确测量的发展性挑战,以及更普遍地,为展示模型间全面比较所需考虑的大量能力。此外,尽管存在大量并排能力评估,我们仍缺乏对不同模型在特定能力下何时及如何失败的更深入理解,以及随时间发布的各类模型的失败性质是否相似。我们做出三项贡献以缓解上述挑战。首先,我们提出 EUREKA,一个可重用且开放的评估框架,用于标准化大型基础模型的评估,超越单一分数报告和排名。其次,我们引入 EUREKA-BENCH,一个可扩展的基准集合,测试以下能力:(i)对最先进的基础模型仍具挑战性;(ii)代表语言和视觉模态中完成任务的基本但被忽视的能力。非饱和基准固有的改进空间使我们能够在能力层面发现模型间的有意义差异。第三,利用该框架和 EUREKA-BENCH,我们对 12 个最先进模型进行分析,通过按重要数据子类别分解测量结果,提供对失败理解和模型比较的深入见解。这些见解揭示模型在特定能力上的细微弱点,并可进一步用于更精确地规划哪些领域最有改进潜力。EUREKA 以开源形式提供,以促进透明且可复现的评估实践。与近期评估报告和排行榜中显示绝对排名和声称某模型最佳的潮流相反,我们的分析显示不存在这样的最佳模型。不同模型各有优势,但有些模型在多项能力上更常被列为最佳表现者。尽管观察到许多改进,但显然当前模型仍在一些基本能力上挣扎,包括详细图像理解、在多模态输入可用时充分利用而非完全依赖语言、事实性和信息检索的接地性,以及过度拒绝。
一句话总结
Microsoft Research 推出 EUREKA,一个可复用的开放评估框架,搭配 EUREKA-BENCH,一个可扩展的非饱和语言与视觉基准集合,并通过一项 12-model 分析证明没有任何单一模型普遍最优,同时揭示了在细粒度图像理解、多模态接地、事实性和过度拒答方面的持续弱点。
核心贡献
-
本文提出 EUREKA,一个可复用且开源的评估框架,将大型基础模型的评估标准化,超越单一分数报告和排行榜排名,实现透明且可复现的评估实践。
-
本文引入 EUREKA-BENCH,一个可扩展的基准集合,针对语言和视觉模态中当前最先进模型仍具挑战性的能力,非饱和基准能够发现模型之间有意义的能力水平差异。
-
利用 EUREKA 和 EUREKA-BENCH,本文分析了 12 个最先进的模型,对数据子类别的测量结果进行分解,以揭示细粒度的失败模式和各模型特有的弱点。分析表明,没有任何单一模型在所有能力上表现卓越,同时识别出在细粒度图像理解、多模态输入利用、事实性与接地以及过度拒答方面的持续困难。
引言
评估大型基础模型(LFM)日益困难,因为其生成式、通用性的本质打破了传统的固定指标评估实践。许多常用基准已经饱和,模型准确率超过 85%,几乎没有空间来区分能力或揭示失败模式,因此需要新的、更具挑战性的评估环境。为此,作者引入 EUREKA,一个灵活的框架,用于组合模块化评估流水线,涵盖数据预处理、提示模板、推理和报告,以及 EUREKA-BENCH,一个精选的、当前模型尚未解决的基准集合。他们的主要贡献是一种超越聚合分数的详细评估方法,提供按子类别和实验条件分解的结果、相同运行下模型非确定性的分析,以及模型更新间的向后兼容性检查,并以开源形式提供以保证可复现性。
数据集
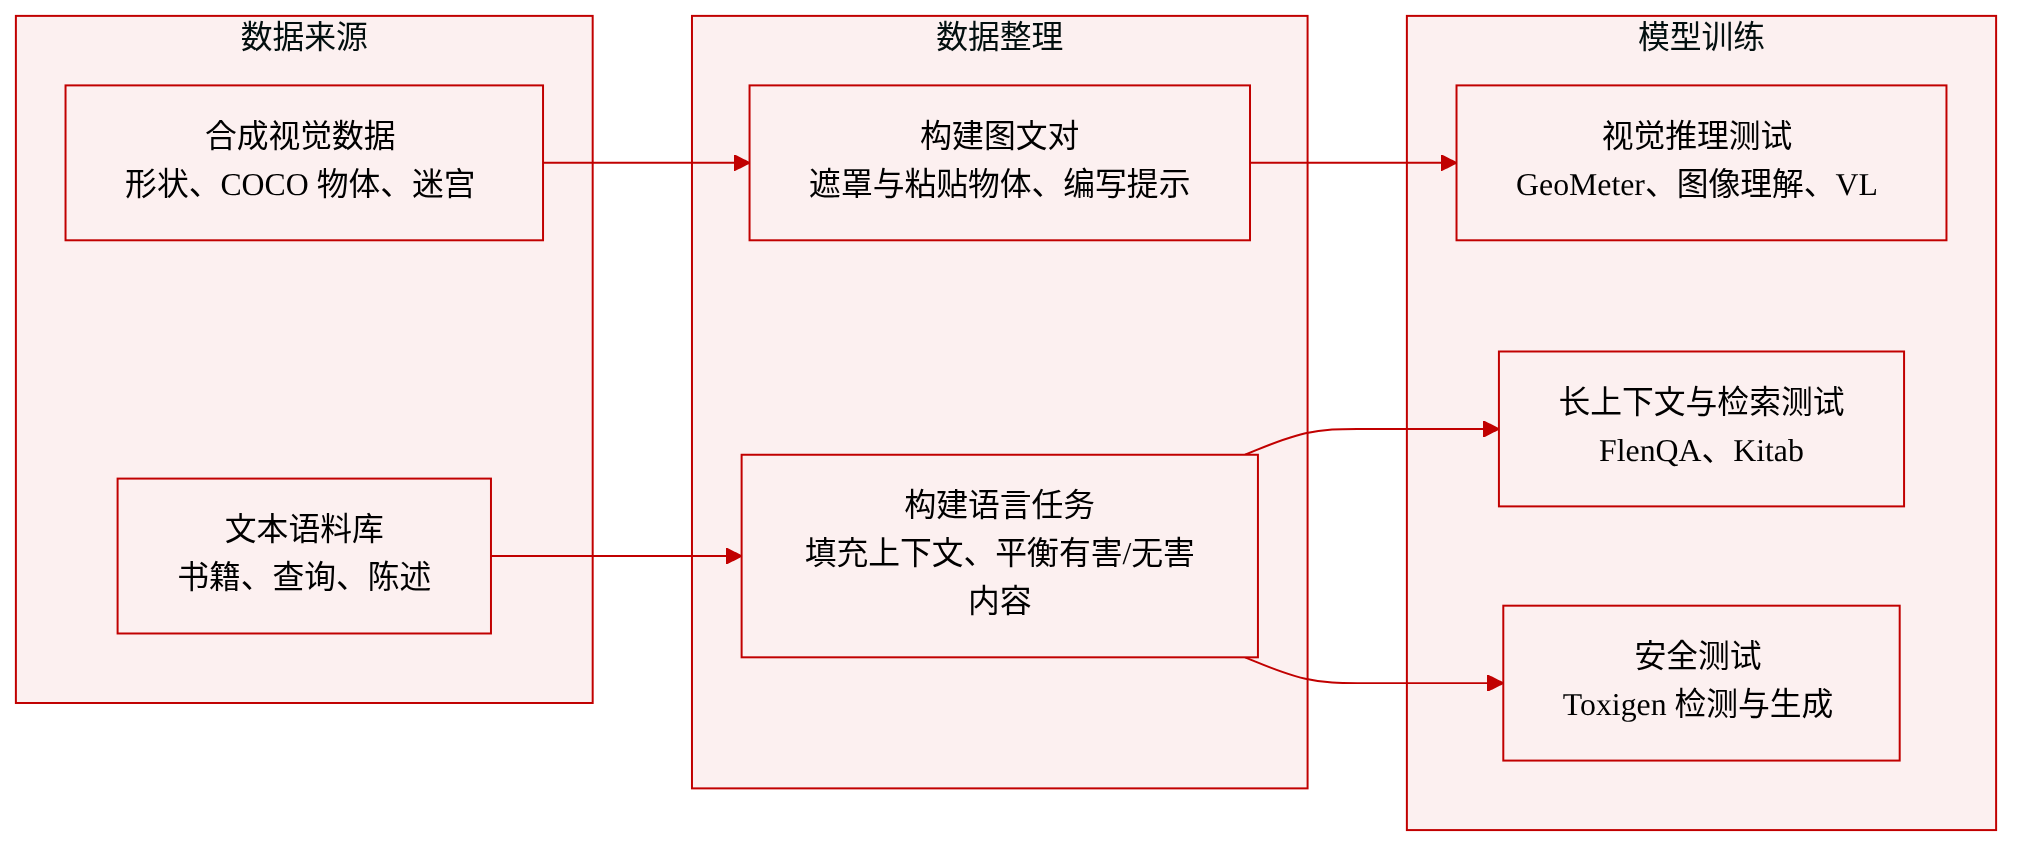
作者在多个数据集上评估模型,每个数据集旨在测试特定能力。以下是每个数据集的组成、构建和使用方式的详细说明。
GeoMeter(几何推理)
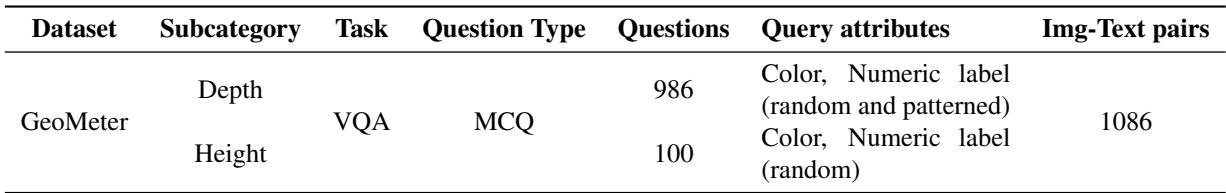
- 包含 1,086 个独特的图像-文本对,分为深度和高度任务。
- 深度子集:986 张图像,包含重叠形状(矩形、三角形、圆形),着色并标注以产生深度错觉;背景为真实世界图像。
- 高度子集:100 张图像,为水平条上的四个矩形构成的塔;包括等高的塔和一个位于升高平台上的塔,每个都按顺序标注。
- 问题通过组合描述提示(场景上下文和查询)与答案格式指令(多项选择选项)生成。
- 查询项使用唯一标识符加形状(如"红色圆形");答案选项通过场景图的深度优先搜索生成并人工检查。
- 多项选择 ground truth 随机放置在打乱的选项中。该数据集用于跨模型的 VQA 式准确率评估,结果按深度和高度子类别分别报告。
图像理解(程序化生成)
- 四个子任务:目标识别、视觉提示、空间推理和目标检测。
- 目标来自 COCO 目标列表,使用 DeepLabV3 掩码,并粘贴到 Places365 的随机背景上。
- 目标放置在四个位置之一(上、左、下、右),具有随机旋转、位置抖动和缩放。
- 两种条件:单目标和目标对。
- 每个测试集使用 20 个目标类别(或 20 对)、四个位置、四个背景类别和四个实例,每种条件和子任务产生 1,280 张图像。
- 提示是任务特定的,包括目标检测的边界框坐标定义。该数据集用于识别、提示和空间推理的准确率评估,以及目标检测的 AP50。
视觉语言理解(程序化合成)
- 三个任务:Spatial-Map(命名对象间的空间关系)、Maze-Nav(带彩色块和 ASCII 文本的导航)和 Spatial-Grid(使用图像或文本的网格计数)。
- 每个任务有三种输入条件:仅文本、仅视觉和视觉-文本。
- 每种条件包含 1,500 个图像-文本对,每个任务共 4,500 个。
- 文本表示足以回答每个问题。作者使用该数据集比较模型在不同模态和任务上的表现。
FlenQA(长上下文)
- 12K 个 True/False 问题,旨在隔离输入长度对推理的影响。
- 输入长度范围为 250 到 3,000 个 token。
- 提示使用来自其他任务实例或 Book Corpus 的段落填充,关键信息置于开头、结尾、中间或随机位置。
- 该任务需要对上下文中的两条信息进行多跳推理。用于评估随上下文长度增加的准确率。
Kitab(信息检索)
- 涵盖 600 多位作者和 13,000 个查询的书籍相关查询。
- 每个查询有固定的作者约束加上可变约束类型:词汇、命名实体和时间。
- 三种实验条件:NO-CONTEXT(仅参数知识)、WITH-CONTEXT(提供完美上下文,RAG 式)和 SELF-CONTEXT(模型通过思维链生成自己的上下文)。
- 指标包括信息无关性、满意率、不满意率、完整性和全正确率。
- 用于评估长形式生成的事实性和约束满足。
Toxigen(毒性检测与安全生成)
- 关于 13 个身份群体的有毒和无害陈述的平衡数据集,侧重于无诽谤语的隐式仇恨言论。
- 两种评估方案:判别式(模型标注毒性,13 个群体共 8,960 个样本)和生成式(模型续写文本,由 GPT-4 1106 Preview 评判,16 个群体共 1,550 个样本)。
- 用于衡量检测准确率和生成语言的安全性。
向后兼容性评估
- 对于语言任务,作者使用 IFEval 和 Kitab(容易波动的长形式生成)。
- 对于多模态任务,使用 MMMU 作为具有挑战性的基准。
所有数据集严格用于评估,不用于训练。其程序化生成防止记忆化和数据泄漏,涵盖几何、空间、长上下文、检索和安全能力。
方法
作者引入 EUREKA,一个旨在统一基准和模型进行评估的软件框架,确保可复现性、可组合性和可复用性。该框架采用模块化设计,实验被定义为由不同组件组成的流水线。这种结构允许用户通过继承流水线定义并仅在必要时实现更改来接入新基准或模型。
该框架目前支持语言和多模态数据,允许为数据处理、推理和评估定义自定义流水线。每个实验使用一组核心组件构建:
- PromptProcessing:该组件为推理准备数据,应用数据操作,并处理复杂的提示模板。
- Inference:该组件对处理后的数据执行模型推理,支持被评估模型和评估者模型。
- DataProcessing:用于后处理模型输出以提取回答,例如使用正则表达式处理多项选择场景或去除训练标签。
- EvalReporting:使用各种指标和聚合促进评估,记录单个提示和聚合分数的结果。
- DataJoin:连接两个数据源,如模型输出和 ground truth 数据。
所有组件将其输出记录到标准化的 JSONL 文件中,以增加透明度并便于错误分析。这些组件利用 DataLoaders、Models、Metrics 和 Aggregators 等工具类,这些工具类可通过相应的 Config 类进行配置。
参考框架图以了解示例实验流水线的概览。
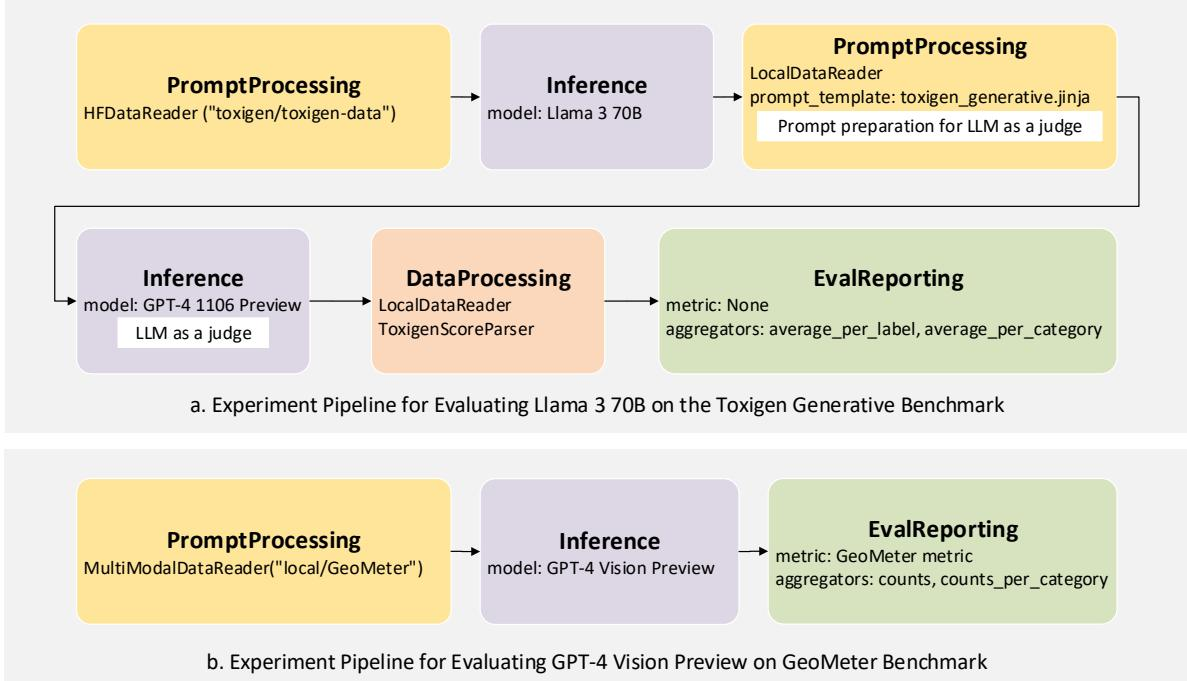
图的顶部展示了 Toxigen 生成式基准的评估流水线。过程从 PromptProcessing 组件开始,该组件从 HuggingFace 读取数据并准备提示。Inference 组件随后评估目标模型,如 Llama 3 70B。接着,PromptProcessing 组件被复用以加载推理结果并使用特定模板为评判模型准备提示。Inference 组件再次被复用以运行评判模型并评分原始结果。最后,DataProcessing 提取分数,EvalReporting 进行聚合。
图的底部展示了 GeoMeter 实验流水线,该流水线处理多模态数据。此流水线的不同之处在于不使用评判模型,而是使用特定的指标类。PromptProcessing 组件被配置为从本地目录读取多模态数据,EvalReporting 组件使用 GeoMeter 指标。尽管存在这些差异,相同组件以最小调整为代价被复用,从而在最大化代码复用的同时实现公平的模型比较。
实验
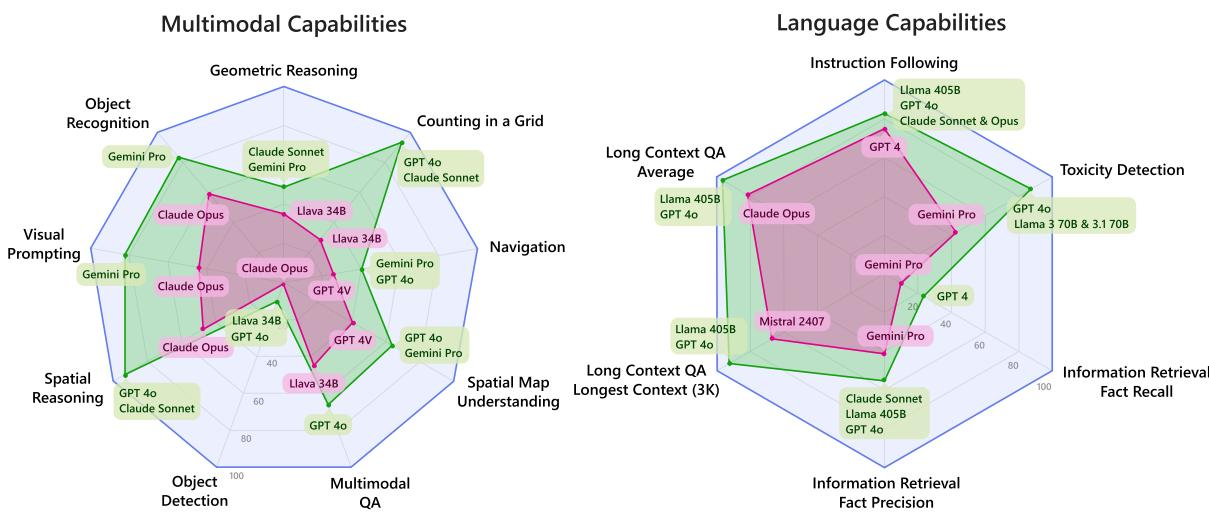
评估揭示了前沿模型之间互补的优势,没有任何单一模型在所有能力上占优,不过 Claude 3.5 Sonnet、GPT-4o 2024-05-13 和 Llama 3.1 405B 持续领先。多模态能力落后于语言能力,模型在高层次图像理解方面表现出色,但在目标检测、几何推理和导航等细粒度感知任务上表现吃力。语言评估显示指令遵循方面有强劲提升,但受约束信息检索的事实性和接地仍然薄弱,且所有模型的表现随上下文长度增长而下降。重复运行之间的显著非确定性和模型系列内部的向后不兼容性也给用户和开发者带来了可靠性方面的担忧。
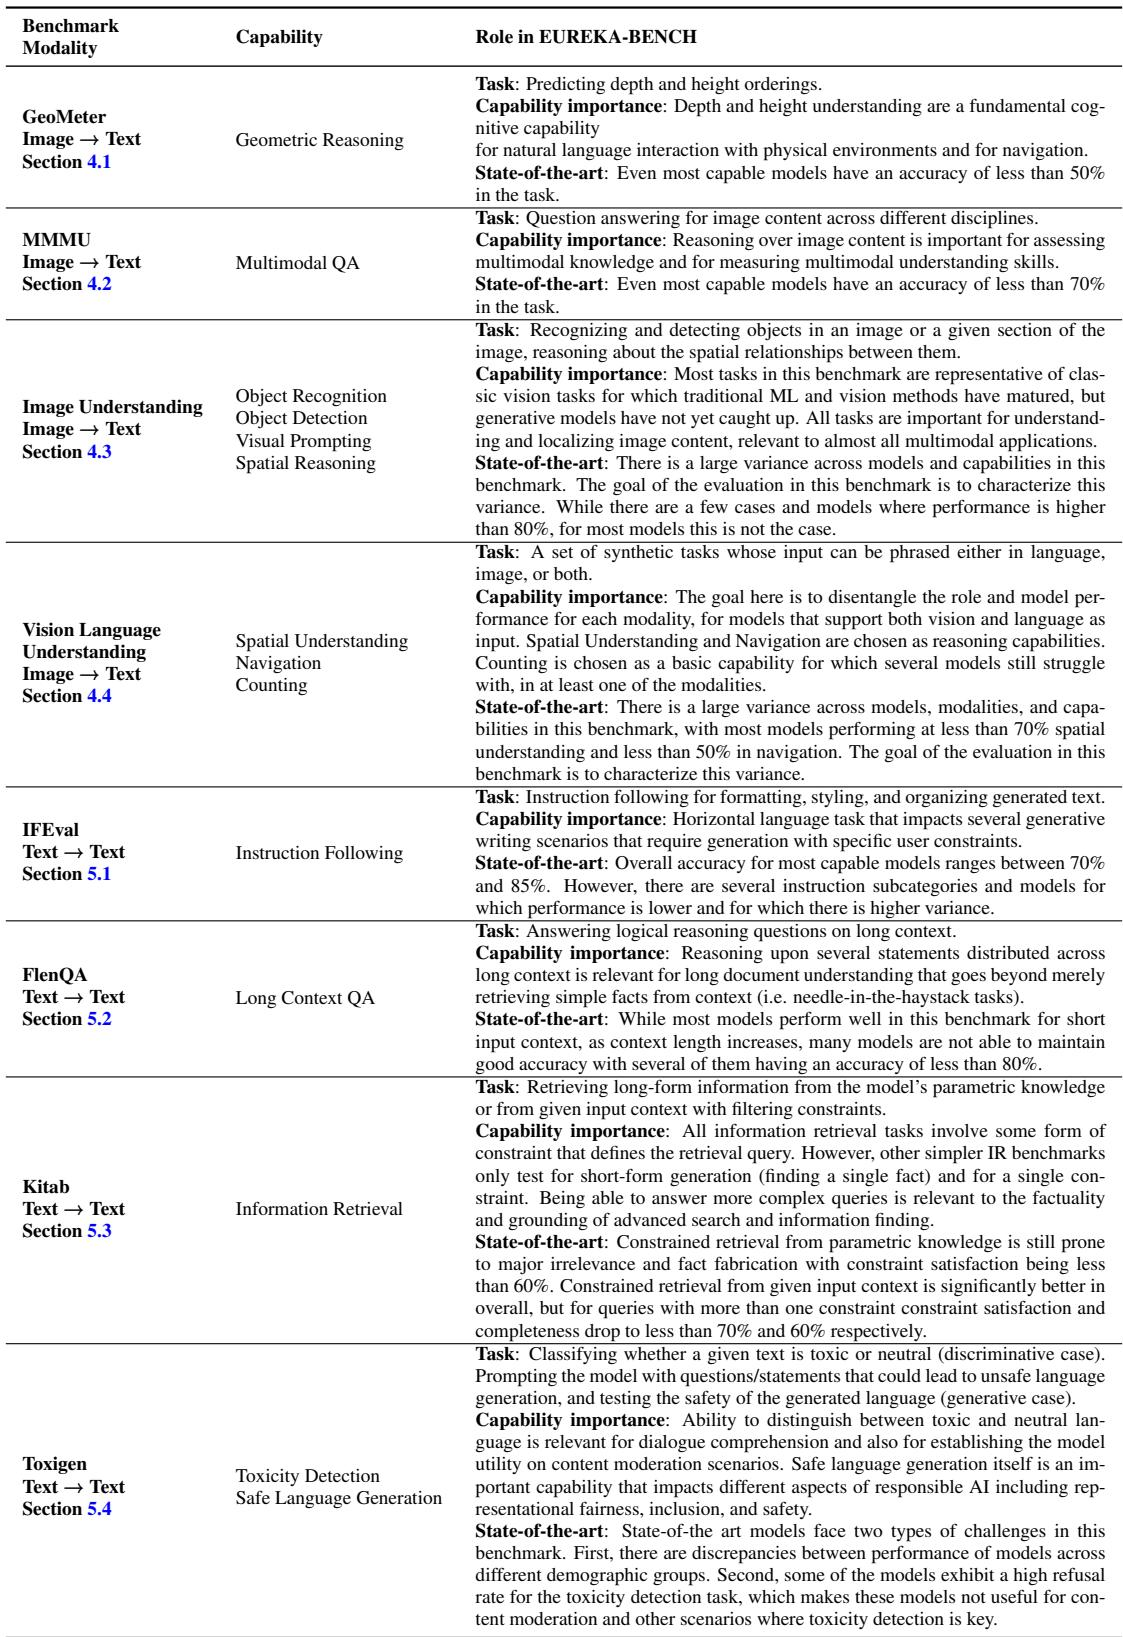
EUREKA-BENCH 包含涵盖图像到文本和文本到文本模态的多样化基准集合,覆盖几何推理、多模态问答、图像理解、长上下文问答和指令遵循等能力。基准的选择使得大多数模型的整体表现或关键实验条件保持在 80% 以下,确保它们未饱和且仍能揭示有意义的差异。某些子条件,如 IFEval 中的长度约束,在各模型系列中始终具有挑战性。基准套件涵盖多种模态和能力,包括几何推理、目标识别、空间推理、长上下文问答和指令遵循。选择标准倾向于那些即使强模型在整个基准或重要实验条件上得分低于 80% 的任务,避免饱和。指令遵循中的长度约束等子集在 Claude、GPT 和 Llama 系列中仍然困难,约 10% 的示例持续失败。
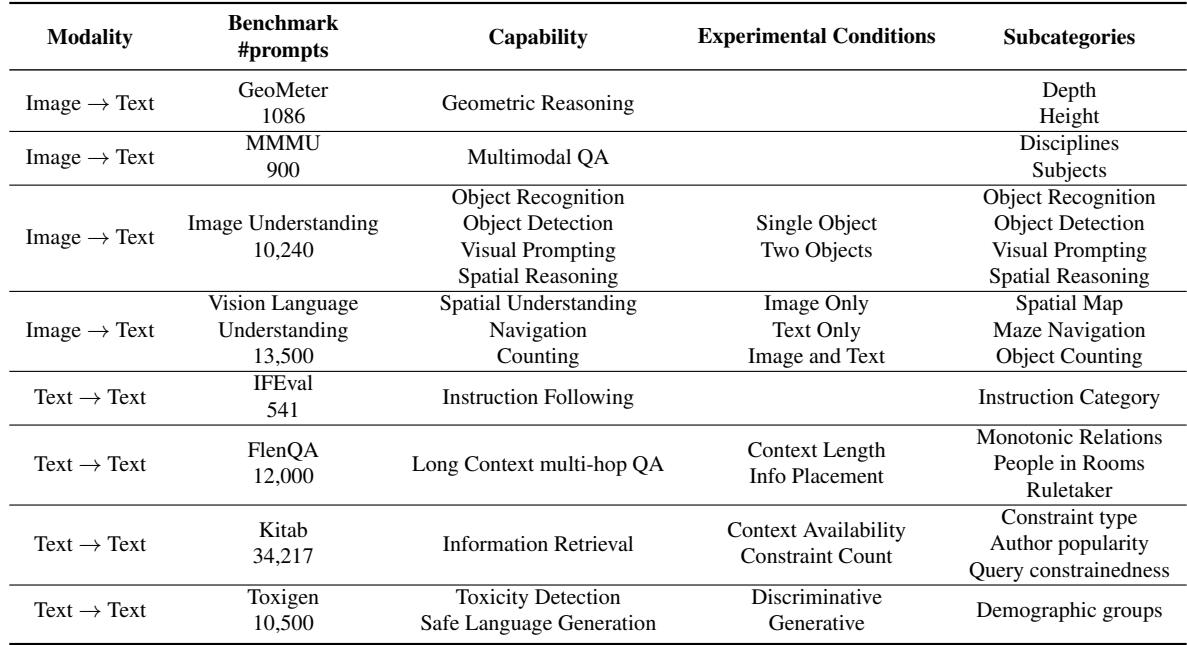
EUREKA-BENCH 表格列出了来自多个系列的具有代表性的基础模型,涵盖语言和多模态能力。该基准旨在包含对即使是最强模型仍然具有挑战性的任务,向后兼容性分析揭示了显著的退化以及模型更新未持续提升性能的情况。基准的选择使得至少半数模型的整体表现或重要条件低于 80%,为有意义的比较留出空间。向后兼容性分析显示,最先进的模型中单个示例上的高退化率表明总体分数可能掩盖逐实例的不一致性。某些指令类型(长度、关键词和大小写更改约束)和 MMMU 子类别在 Claude、GPT 和 Llama 系列中始终具有挑战性。
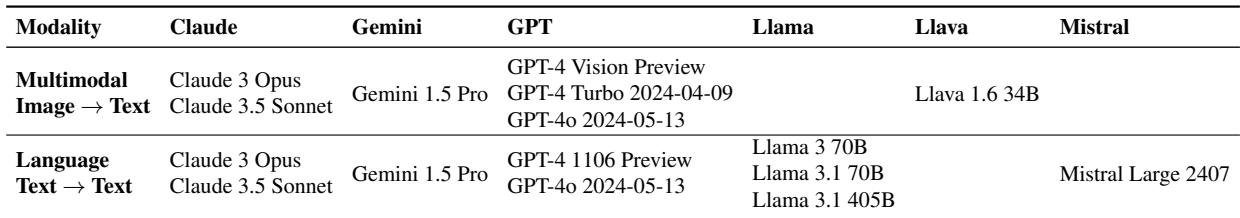
EUREKA-BENCH 包含的基准因其对最先进模型仍具挑战性而被选中,整体表现通常低于 80%。这些基准涵盖广泛的能力,包括几何推理、多模态问答、图像理解、空间推理、指令遵循、长上下文问答和受约束信息检索,模型在这些任务和模态上的表现差异很大。EUREKA-BENCH 中的大多数基准被选择是因为即使顶级模型的得分也低于 80%,确保有足够的空间进行区分和失败分析。几何推理和导航任务特别困难,领先模型的准确率通常低于 50%。参数知识的受约束检索显示约束满足率较低(低于 60%),而较长上下文的问答随着输入长度的增加而退化。图像理解基准揭示了模型之间的巨大性能差异,某些任务超过 80%,但大多数模型未达标。
GeoMeter 是一个几何推理基准,使用合成的 2D 图像来评估视觉语言模型中的深度和高度感知。它包含 1,086 个图像-文本对,大多数问题侧重于深度(986),较少侧重于高度(100),所有问题均为多项选择格式,具有独特的查询属性,如颜色或数字标签。该数据集高度强调深度感知而非高度感知,深度问题大约是高度问题的十倍。所有问题均为多项选择,使用颜色或数字标签作为目标的唯一标识符。使用合成 2D 形状以避免真实世界的偏差并测试真正的几何推理。
该基准评估视觉语言模型在合成深度和高度排序任务上的表现。在所有模型中,高度排序的准确率显著低于深度排序,表明高度感知的难度更大。整体最佳表现由 Claude 3.5 Sonnet 实现,而 GPT-4 Vision Preview 和 Llava 1.6 34B 等模型落后。Claude 3.5 Sonnet 在深度和高度排序上均领先,整体准确率最高。所有模型在高度排序上的表现明显差于深度排序,表明高度推理更具挑战性。GPT-4 变体和 Llava 1.6 34B 的得分低于顶级模型,显示出几何推理方面的显著差距。
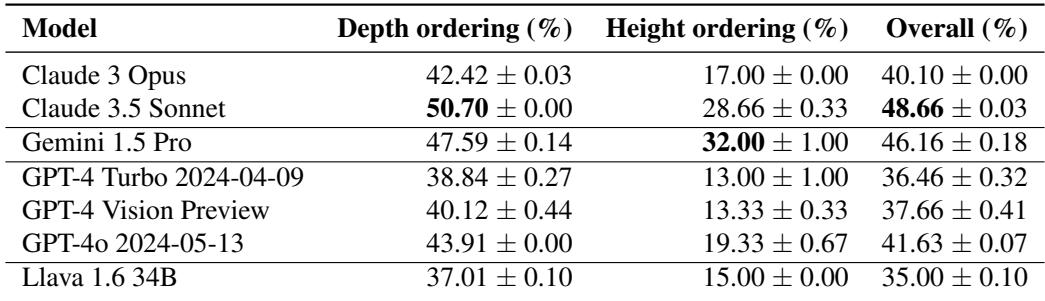
EUREKA-BENCH 涵盖图像到文本和文本到文本任务,涉及几何推理、多模态问答、长上下文问答和指令遵循,基准的选择使得即使顶级模型的得分也低于 80% 以避免饱和。评估显示,总体分数掩盖了最先进模型在版本更新中的大量逐实例退化,某些条件如指令遵循中的长度约束和特定 MMMU 子类别在各模型系列中持续困难。几何推理和导航被证明特别困难,准确率通常低于 50%,参数知识的受约束检索显示约束满足率较低。在 GeoMeter 上,一个包含 1,086 个深度和高度排序问题的合成 2D 基准,所有模型在高度感知上的表现明显差于深度感知,Claude 3.5 Sonnet 总体领先,而 GPT-4 视觉变体和 Llava 1.6 34B 落后。