Command Palette
Search for a command to run...
CHATQA 2:弥合开源 LLM 与专有模型在长上下文和 RAG 能力上的差距
CHATQA 2:弥合开源 LLM 与专有模型在长上下文和 RAG 能力上的差距
Peng Xu Wei Ping Xianchao Wu Chejian Xu Zihan Liu Mohammad Shoeybi Bryan Catanzaro
ChatQA 2 长上下文监督微调数据
摘要
在这项工作中,我们介绍了 ChatQA 2,一个基于 Llama 3.0 的模型,具有 128K 的上下文窗口,旨在弥合开源 LLM 与领先专有模型(如 GPT-4-Turbo-2024-04-09)在长上下文理解和检索增强生成(RAG)能力上的差距。这两种能力相辅相成,对于 LLM 处理无法容纳在单次提示中的大量信息至关重要。我们提供了一个详细的持续训练配方,将 Llama370B-base 的上下文窗口从 8K 扩展到 128K 个 token,并采用三阶段指令微调流程,以增强模型的指令遵循、RAG 性能和长上下文理解能力。我们的结果表明,Llama3-ChatQA-2-70B 模型在超过 100K token 的超长任务以及仅使用 4K 上下文窗口的 RAG 基准测试中,优于大多数现有最先进模型,包括 GPT-4-Turbo-2024-04-09、Qwen2-72B-Instruct 和 Llama3.1-70B-Instruct,显示了在不同序列长度下强大的长上下文能力。我们进一步提供了使用相同最先进长上下文 LLM 的直接长上下文解决方案和 RAG 解决方案之间的广泛比较。有趣的是,我们发现,使用 RAG 的强长上下文 LLM 在检索更多块时性能会提高。使用大量 top-k 块时,RAG 在 32K 和 128K 基准测试上一致优于使用相同最先进长上下文模型(如 Llama3-ChatQA-2-70B 和 Qwen2-72B-Instruct)的直接长上下文解决方案。我们向社区开源了模型权重、训练数据和评估设置:https://chatqa2-project.github.io/
一句话总结
NVIDIA研究人员推出了ChatQA 2,这是一个基于Llama 3.0的模型,具有128K上下文窗口,并提出了一种持续训练方案及三阶段指令微调方法,将上下文从8K扩展到128K tokens。该模型在超长任务和RAG基准测试上取得了优于GPT-4-Turbo-2024-04-09和Qwen2-72B-Instruct的性能,且当检索更多分块时,RAG优于直接长上下文方案。
核心贡献
-
推出了Llama3-ChatQA-2-70B,这是一个具有128K上下文窗口的开源长上下文模型,同时提供可复现的持续训练方案(将Llama 3 70B的上下文从8K扩展到128K tokens)以及三阶段指令微调流程。该模型达到了GPT-4-Turbo-2024-04-09级别的准确率,在超过100K tokens的超长任务以及4K上下文窗口内的ChatRAG基准测试上,优于GPT-4-Turbo-2024-04-09、Qwen2-72B-Instruct和Llama3.1-70B-Instruct。
-
使用相同的先进长上下文LLM,对直接长上下文方案和RAG方案进行了广泛对比,结果表明随着检索到的top-k分块数量增加,RAG准确率持续提升。当top-k足够大时,在相同的底层模型上,RAG在32K和128K基准测试中均优于直接长上下文方案。
-
展示了带有长上下文检索器的RAG对分块大小的变化具有鲁棒性,且准确率随检索token总数增加而提升。作者向研究社区发布了模型权重、训练数据和评估设置。
引言
开源LLM社区已经产出了诸如Llama-3-70B-Instruct和Qwen2-72B-Instruct这样能力较强的开放模型,但它们在许多领域仍落后于GPT-4-Turbo等前沿专有系统。扩展上下文窗口已成为核心趋势,专有模型支持128K到10M tokens,开放模型也达到了200K,但此前的开源尝试面临关键限制:训练数据和复现方案往往不可用,导致复现困难,且评估主要依赖像Needle in a Haystack这样的合成测试而非真实任务。长上下文处理和检索增强生成(RAG)常常被视为竞争性方法,但它们实际上相辅相成:RAG为数十亿tokens上的基于查询的任务提供了效率,而长上下文模型则处理整文档摘要。Xu等人此前的相关工作仅将Llama2扩展到16K和32K tokens,只达到了GPT-3.5-turbo级别的能力。
作者提出了ChatQA 2,将开源长上下文LLM推进到GPT-4-Turbo级别的能力,具有128K上下文窗口,并配备了一个先进的长上下文检索器用于RAG。他们的主要技术贡献是一个两步方案:首先通过在SlimPajama上进行带长序列上采样的持续预训练,将Llama3-70B的上下文从8K扩展到128K,然后应用三阶段指令微调流程,分别增强指令遵循、RAG和长上下文理解能力。由此产生的Llama3-ChatQA-2-70B在超过100K tokens的长上下文任务和4K tokens内的RAG基准测试上,优于GPT-4-Turbo-2024-04-09、Qwen2-72B-Instruct和Llama3.1-70B-Instruct。作者还表明,其RAG准确率对分块大小变化具有鲁棒性,并随检索到的token数量增加而持续提升,同时证明了在给定足够top-k分块的情况下,RAG仍能击败仅使用长上下文的模型。训练数据和完整复现方案已公开释放。
数据集
数据集描述
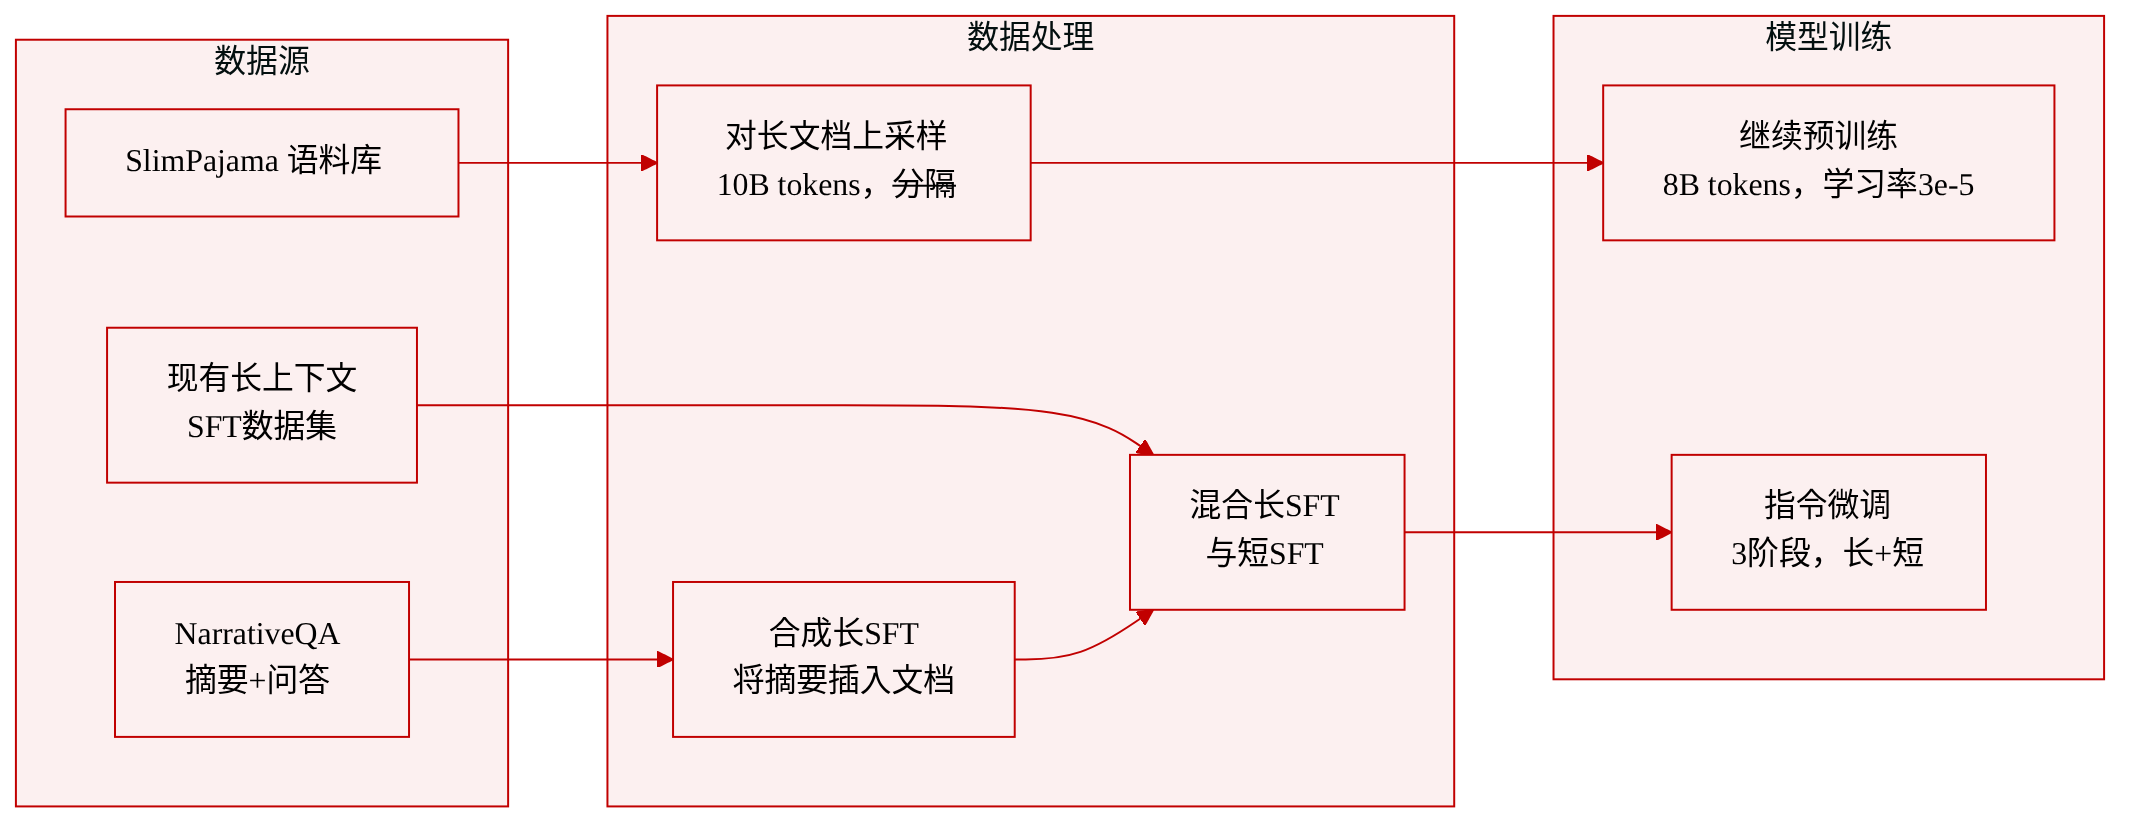
作者构建了一组数据集,将Llama3基础模型的上下文窗口从8K扩展到128K tokens,随后进行三阶段指令微调。数据分为预训练语料库和长上下文监督微调(SFT)数据集两部分。
-
长上下文预训练语料库
- 来源: 从SlimPajama语料库中筛选。
- 组成: 对长上下文文档进行上采样,超参数设置为0.1,构建了100亿tokens的语料库,格式化为128K tokens的序列。
- 处理: 为帮助模型适应更长的输入,作者使用特殊字符
<s>而非保留的<BOS>和<EOS>tokens来分隔不同文档,假设后者会提示模型忽略之前的上下文。 - 用途: 用于持续预训练阶段,批大小为32(400万tokens),学习率为3e-5,共2000步,总计80亿tokens。
-
长上下文指令微调数据集(Long SFT)
- 组成: 基于序列长度,融合了来自两个类别的数据。
- 对于32K以下的序列: 来自现有长上下文数据集,包括LongAlpaca12k、Open Orca中的GPT-4样本和Long Data Collections。
- 对于32K到128K的序列: 从NarrativeQA数据集生成的合成数据,该数据集包含基于长网页源文档的人工生成摘要、问题和答案。
- 处理: 为创建更长的上下文,作者将摘要插入到对应的长网页文档中的随机位置,同时确保句子结构不被破坏。这保持了原始问答对的关联依据。
- 用途: 该长SFT数据集与前两个指令微调阶段的短SFT数据集混合用于训练。作者有意将所有评估基准中的NarrativeQA排除,以防止数据污染。
- 组成: 基于序列长度,融合了来自两个类别的数据。
-
评估基准
- 超长上下文(超过100K): 使用InfiniteBench中的四个任务:En.Sum(ROUGE-L-Sum分数)、En.QA(F1分数)、En.MC(Exact Match分数)和En.Dia(Exact Match分数)。
- 长上下文(32K以内): 使用Xu等人(2024)的六个数据集,排除NarrativeQA。这些包括QMSum(ROUGE分数的几何平均值)、Qasper和MultiFieldQA-en(F1分数)、QuALITY(Exact Match分数)以及HotpotQA和MuSiQue(F1分数)。
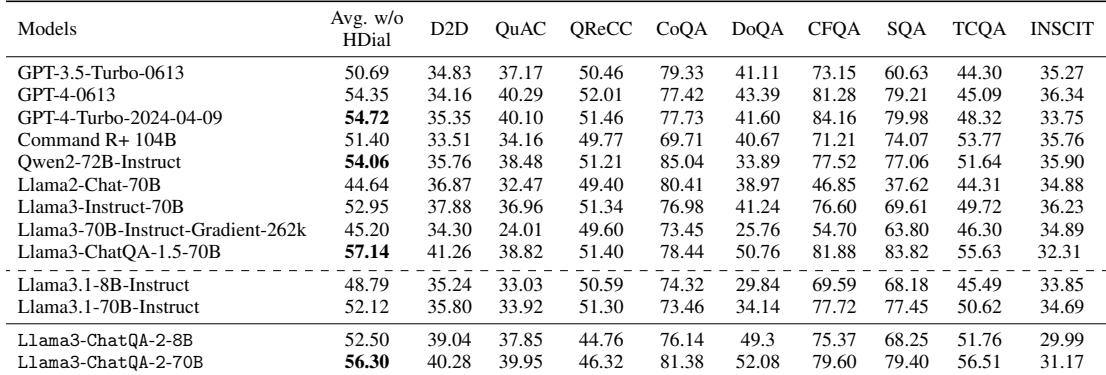
- 短上下文(4K以内): 使用ChatRAG Bench,排除HDial数据集。对于Doc2Dial、QuAC和QReCC,文档被分割为约300词的分块并检索top-5。对于TopiOCQA和INSCIT,检索top-20分块。其余数据集为CoQA、DoQA、ConvFinQA和SQA。报告这些数据集的平均F1分数。
方法
作者提出了一种系统方法,将Llama3适配到长上下文理解和检索增强生成。该方法分为三个阶段:将预训练上下文窗口从8K扩展到128K,使用长上下文监督进行指令微调,并将得到的模型与长上下文检索器配对。
将上下文窗口扩展到128K
为扩展上下文窗口,作者准备了从Slimpajama派生的长上下文预训练语料库。他们使用设为0.1的超参数对长上下文文档进行上采样,生成了100亿tokens、序列长度为128k的数据。由于Llama3预训练时使用的RoPE基频为500,000,远高于Llama2,作者相应地将RoPE基频提高到150M以适应更长的序列。训练使用批大小32,每批400万tokens,学习率为3×10⁻⁵,共2000步,总计80亿tokens。
一个有趣的发现是,使用特殊字符(如"<s>")分隔不同文档,比使用保留的起始和结束tokens <BOS>和<EOS>更为有效。作者假设这些tokens在预训练后会提示模型忽略之前的文本块,这对于将LLM适配到更长上下文输入是不利的。
使用长上下文数据进行指令微调
为同时增强长上下文理解能力和RAG性能,作者实施了三阶段指令微调。前两个阶段遵循ChatQA 1.5,模型首先在高质量的指令遵循数据集上训练,然后在带有上下文的对话问答数据混合集上训练。这些阶段涉及相对较短的上下文,最大序列长度仅为4K tokens。
为增强模型处理长达128K tokens的极长序列的能力,作者收集了涵盖两个类别的长SFT数据集。对于32K以下的序列,他们利用现有长上下文数据集,包括LongAlpaca12k、Open Orca中的GPT-4样本和Long Data Collections。对于32K到128K之间的序列,他们依赖从NarrativeQA构建的合成数据集,该数据集包含摘要段落、问题、答案和源长网页。摘要是基于源网页人工生成的,而问答对是使用摘要人工标注的。为扩展上下文长度,摘要被插入到对应的长网页文档中的随机位置,同时确保句子结构保持完整。该方法在增强后的长文档中保持了问答对的关联依据。由于NarrativeQA用于合成数据生成,因此被有意排除在评估基准之外,以避免潜在的数据污染。完整的长SFT数据集和前两个阶段的短SFT数据集混合用于训练,学习率为3×10⁻⁵,批大小为32。
长上下文检索器遇上长上下文LLM
作者识别了当前RAG流程中的两个问题。首先,top-k逐分块检索在生成准确答案时会引入不可忽视的上下文碎片化,因为此前基于密集嵌入的先进检索器仅支持512 tokens。其次,较小的top-k值(如5或10)通常导致相对较低的召回率,而较大的k值(如100)可能导致更差的生成效果,因为先前的LLM无法有效利用大量分块上下文。为解决这些问题,作者提出使用支持数千tokens的最新长上下文检索器。具体而言,他们采用E5-mistral嵌入模型作为检索器。该模型的输入是由子词token序列表示的文本分块,输出是嵌入向量。长文档或语料库被分块并嵌入为一组密集嵌入向量,在推理时通过k近邻搜索进行索引和检索,其中提示或问题的嵌入作为查询。
实验
评估将Llama3-ChatQA-2模型与先进长上下文LLM(包括GPT-4-Turbo、Qwen2和Llama-3.1)在三个基准类别上进行比较:超过100K tokens的超长上下文、32K以内的长上下文和4K以内的短上下文,RAG基线使用E5-mistral检索器。所提出的模型在Needle In A Haystack测试中达到100%准确率,在超长InfiniteBench任务上优于此前先进水平(尤其是QA任务,由于训练数据有限,摘要能力较弱),并在短上下文ChatRAG Bench上领先,尽管在32K任务上因预训练规模缩减存在轻微差距。消融研究表明,三阶段训练方案优于一次性全部训练,且当使用更多检索分块时,RAG可以优于完整长上下文方案,准确率随token数量增加而提升。
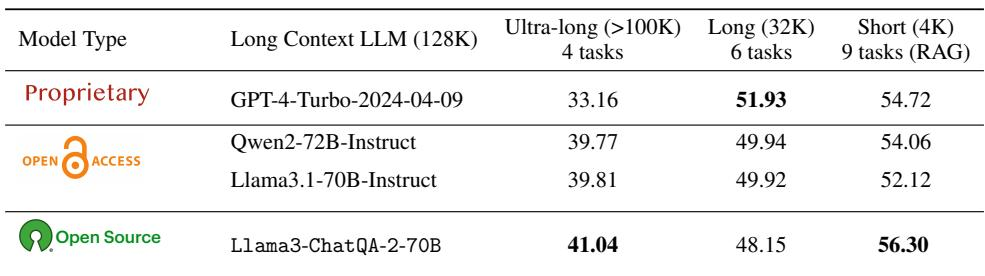
该模型在超长(>100K)和短(4K)上下文任务中均取得了比较模型中的最高平均分数,而在中长(32K)任务上略有落后。它还因开源其训练数据和复现方案而脱颖而出,这些是其他开放访问的128K模型所不具备的。在所有比较模型中,真实世界超长任务(超过100K tokens)的平均分数最高。在短上下文(4K)RAG任务上领先,优于专有和开放访问的同类模型。在32K任务上相对于专有模型和一些开放访问模型表现稍低。不同于其他开放访问模型,开源了将8K上下文基础模型扩展到128K的训练数据和方案。
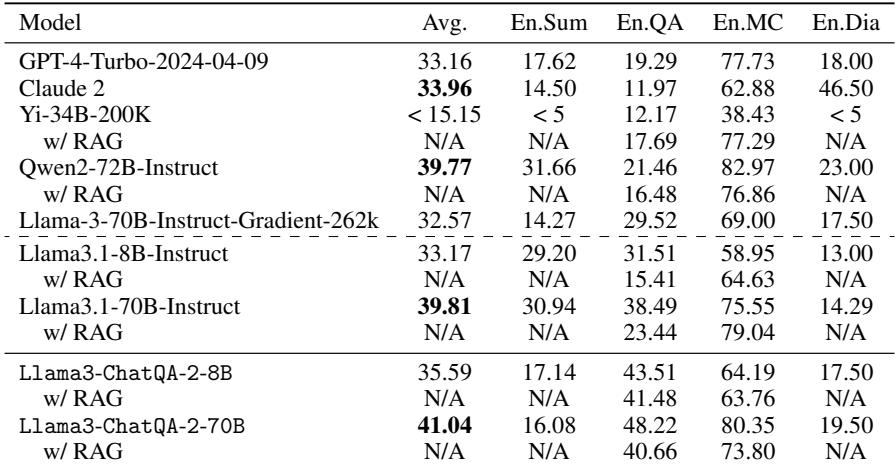
该模型在InfiniteBench任务上取得了高于多个强基线的平均分数,在QA和多项选择任务上表现尤为出色,但摘要分数较低。使用top-5分块的检索增强生成(RAG)效果不如直接处理完整长上下文。平均而言优于GPT-4-Turbo、Claude 2和其他大型长上下文模型。在QA和多项选择任务上表现优异,而摘要分数相对较低,可能是由于训练中摘要数据有限。基于RAG的评估分数低于直接长上下文处理。
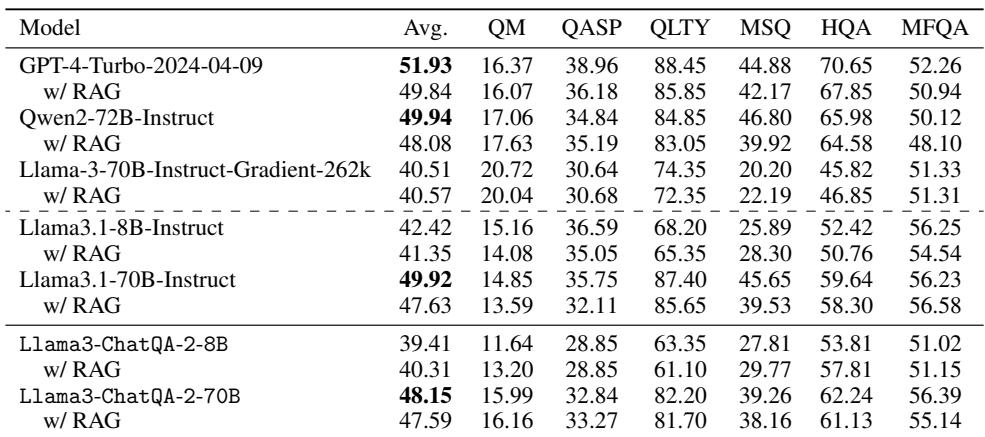
在32K tokens以内的长上下文基准上,GPT-4-Turbo领先所有模型,而所提出的模型表现具有竞争力,但略微落后于另外两个70B模型。默认使用top-5个1200 tokens分块的RAG设置,在所有评估模型上均一致地产生低于直接长上下文处理的平均分数。GPT-4-Turbo取得了最高平均分数,所提出的模型落后于Qwen2-72B-Instruct和Llama3.1-70B-Instruct,但领先于Llama-3-70B-Instruct-Gradient-262k。对每个模型而言,使用默认的top-5个1200 tokens分块的RAG配置产生的平均分数均低于直接长上下文方法。
所提出的模型在CHATRAG BENCH短上下文任务上取得了强劲的平均表现,超越了多个大上下文模型,同时略逊于专门的短上下文模型。这表明将上下文窗口扩展到更长长度时存在权衡。尽管GPT-4-Turbo、Qwen2-72B-Instruct和Llama3.1-70B-Instruct支持128K上下文,该模型在平均分数上仍优于它们。略逊于仅处理4K上下文的Llama3-ChatQA-1.5-70B,表明扩展上下文长度会带来适度的短任务性能成本。
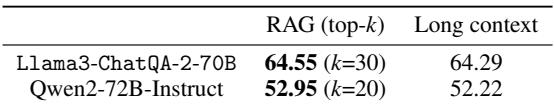
对比表明,对于超过100K tokens的任务,检索增强生成(RAG)在两个测试模型上的平均准确率都略高于直接长上下文评估。这表明即使在很长的上下文长度下,RAG仍然具有竞争力或更好,同时推理成本更低。对于Llama3-ChatQA-2-70B,使用top-k检索的RAG优于直接长上下文评估。这一优势在Qwen2-72B-Instruct上同样成立,RAG也略优于完整长上下文方法。
评估涵盖了超长(>100K)、中长(32K)和短(4K)上下文基准,所提出的模型在超长和短上下文RAG任务中排名最佳,在32K任务上略有落后,并且是唯一开源训练数据和复现方案的模型。它在QA和多项选择任务上表现出色,但摘要能力较弱。在128K上下文中,直接长上下文处理通常优于默认top-5分块设置的RAG,但对于超过100K tokens的任务,RAG略优于直接评估,同时降低了推理成本。扩展上下文长度会带来适度的权衡,该模型在ChatRAG Bench上虽超越多个长上下文同类模型,但仍落后于专门的短上下文模型。